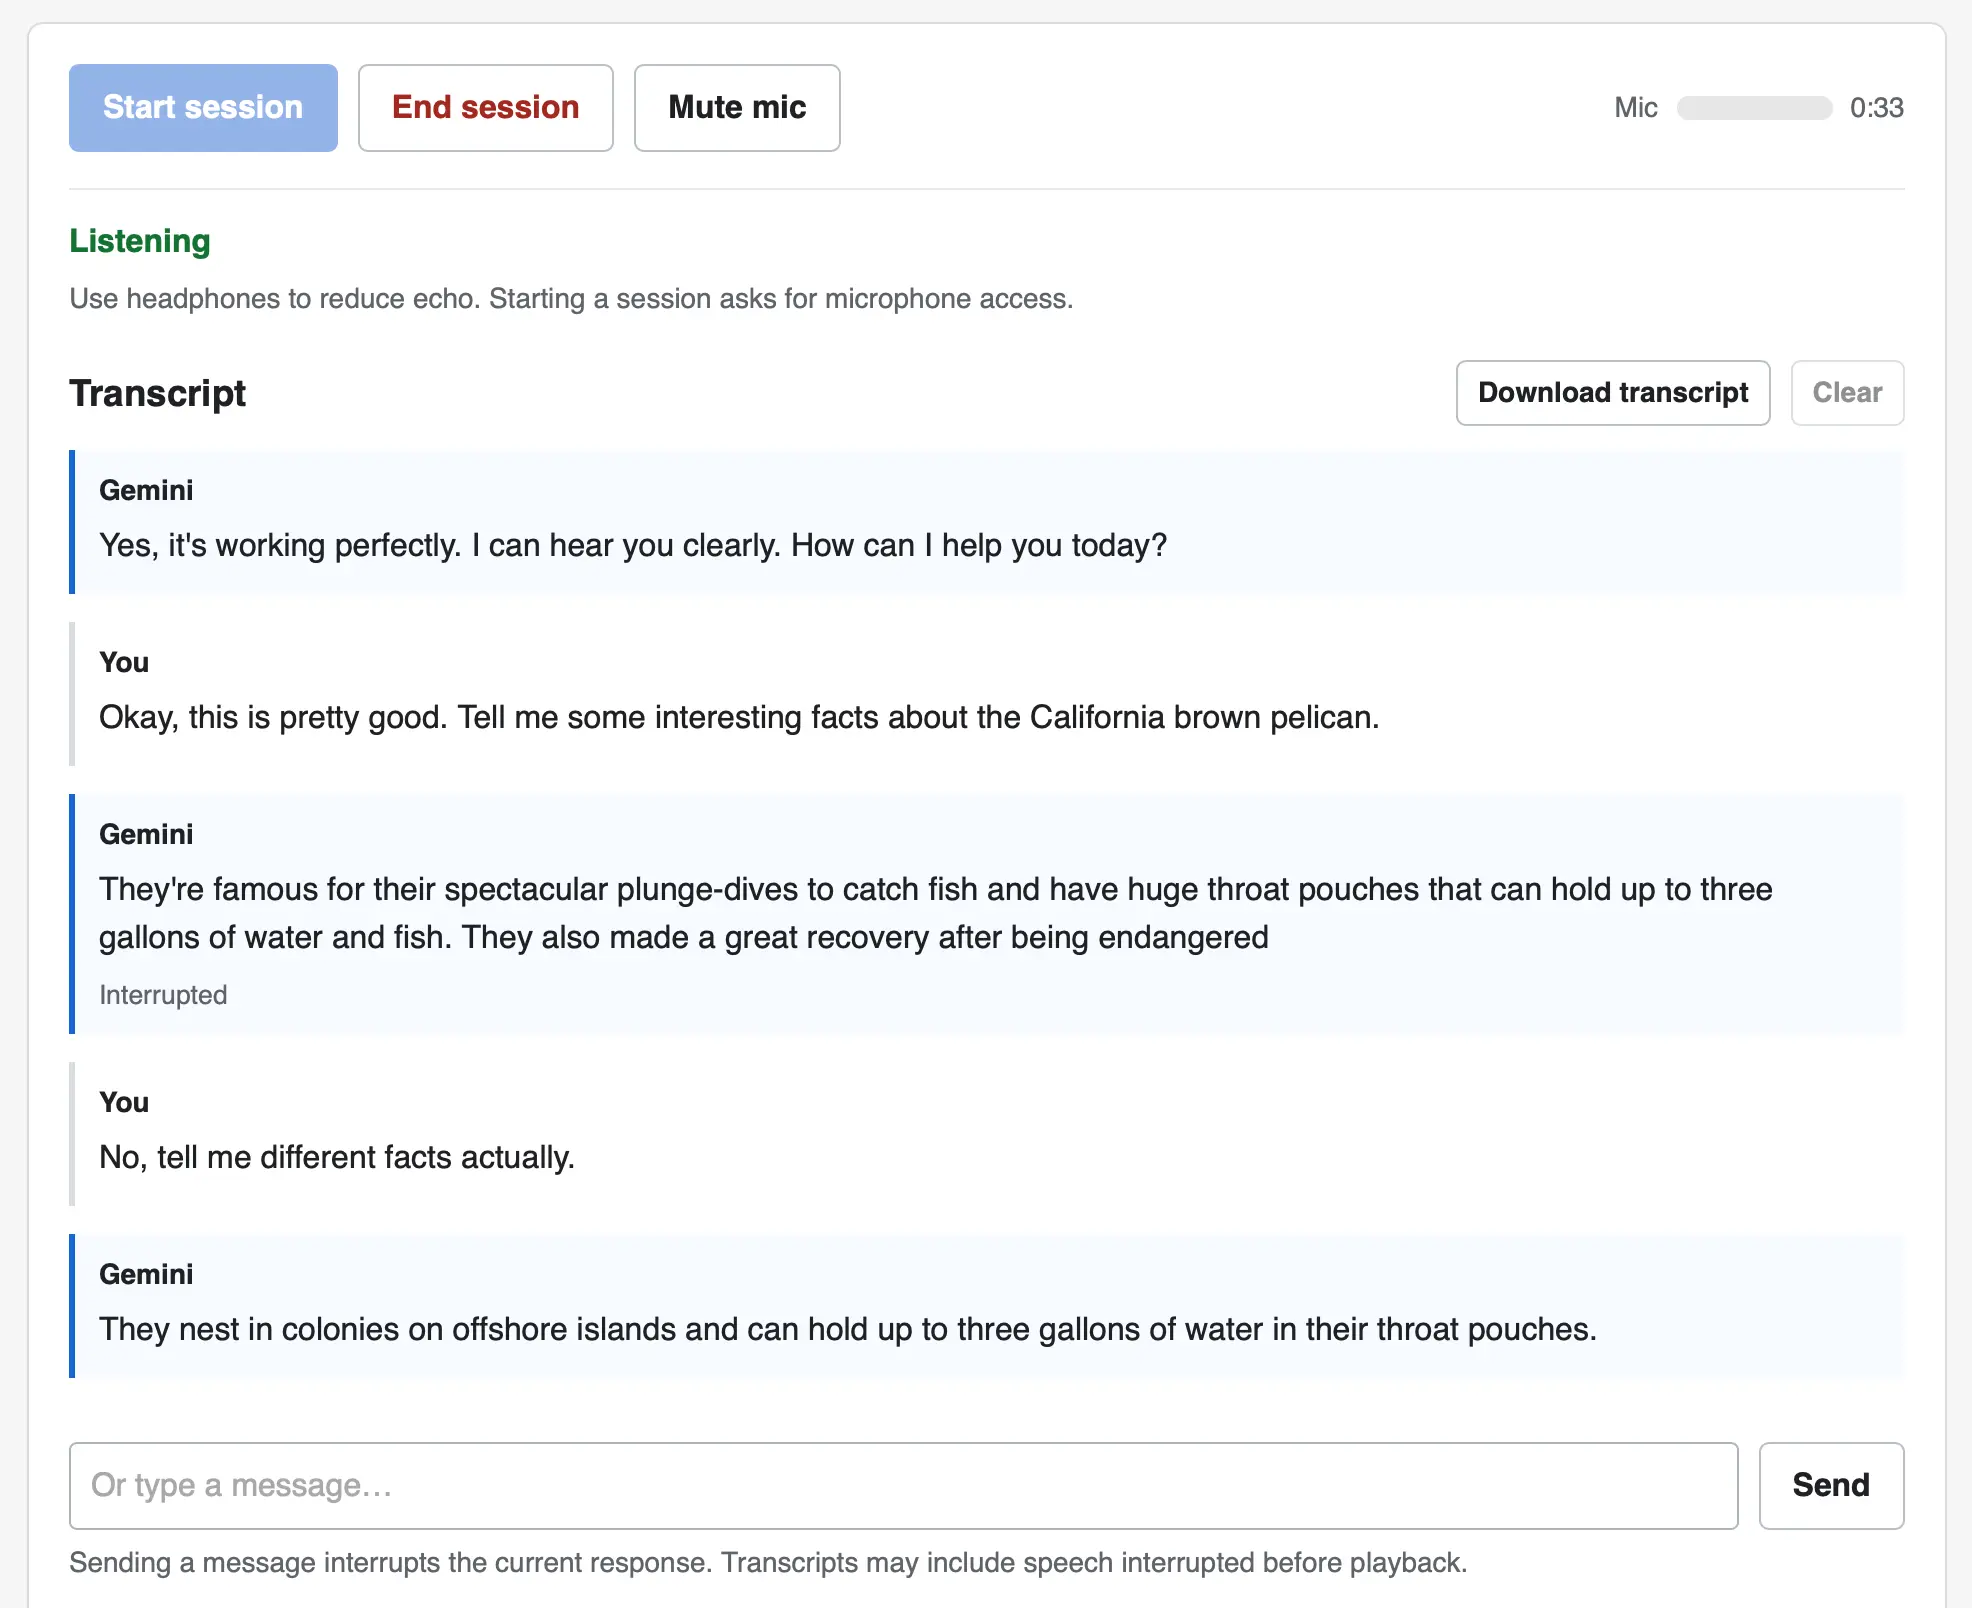
Gemini Live 오디오
요약
Google이 Gemini 3.8 Live와 Extended Thinking을 출시하며, OpenAI의 GPT-Live 계열과 유사한 새로운 음성 대 음성 모델을 선보였습니다. 이 웹 UI는 사용자가 모델과 목소리 프리셋을 선택하고 시스템 프롬프트를 입력하여 브라우저에서 실시간 음성 대화를 경험할 수 있게 합니다. 특히 모델이 말하는 도중에 말을 끊거나 텍스트로 메시지를 보내 응답을 중단시키는 기능이 포함되어 있습니다.
핵심 포인트
- Gemini Live는 OpenAI의 GPT-Live와 유사한 새로운 음성 대 음성 상호작용 모델입니다.
- Web Audio API와 WebSocket 엔드포인트를 사용하여 구현되었으며, 라이브러리 사용은 최소화되었습니다.
- 사용자는 실시간 음성 대화 외에도 텍스트 입력으로 응답을 중단시키는 기능을 활용할 수 있습니다.
2026년 9월 15일
Google은 오늘 Gemini 3.8 Live와 3.8 Live Extended Thinking을 출시했습니다. 이 두 가지는 OpenAI의 GPT-Live 계열과 유사한 형태를 가진 새로운 음성 대 음성 모델입니다.
저는 GPT-6 Astra Extra High에게 문서(documentation)를 지목하여 이 웹 UI를 만들게 했고, 이를 통해 새로운 모델들을 시험해 볼 수 있게 되었습니다. 사용자는 모델과 목소리 프리셋을 선택하고, 선택적인 시스템 프롬프트를 입력한 다음, 브라우저를 통해 음성 대화를 시작할 수 있습니다. 또한, 모델이 말하는 도중에 말을 끊는 기능도 포함되어 있습니다.
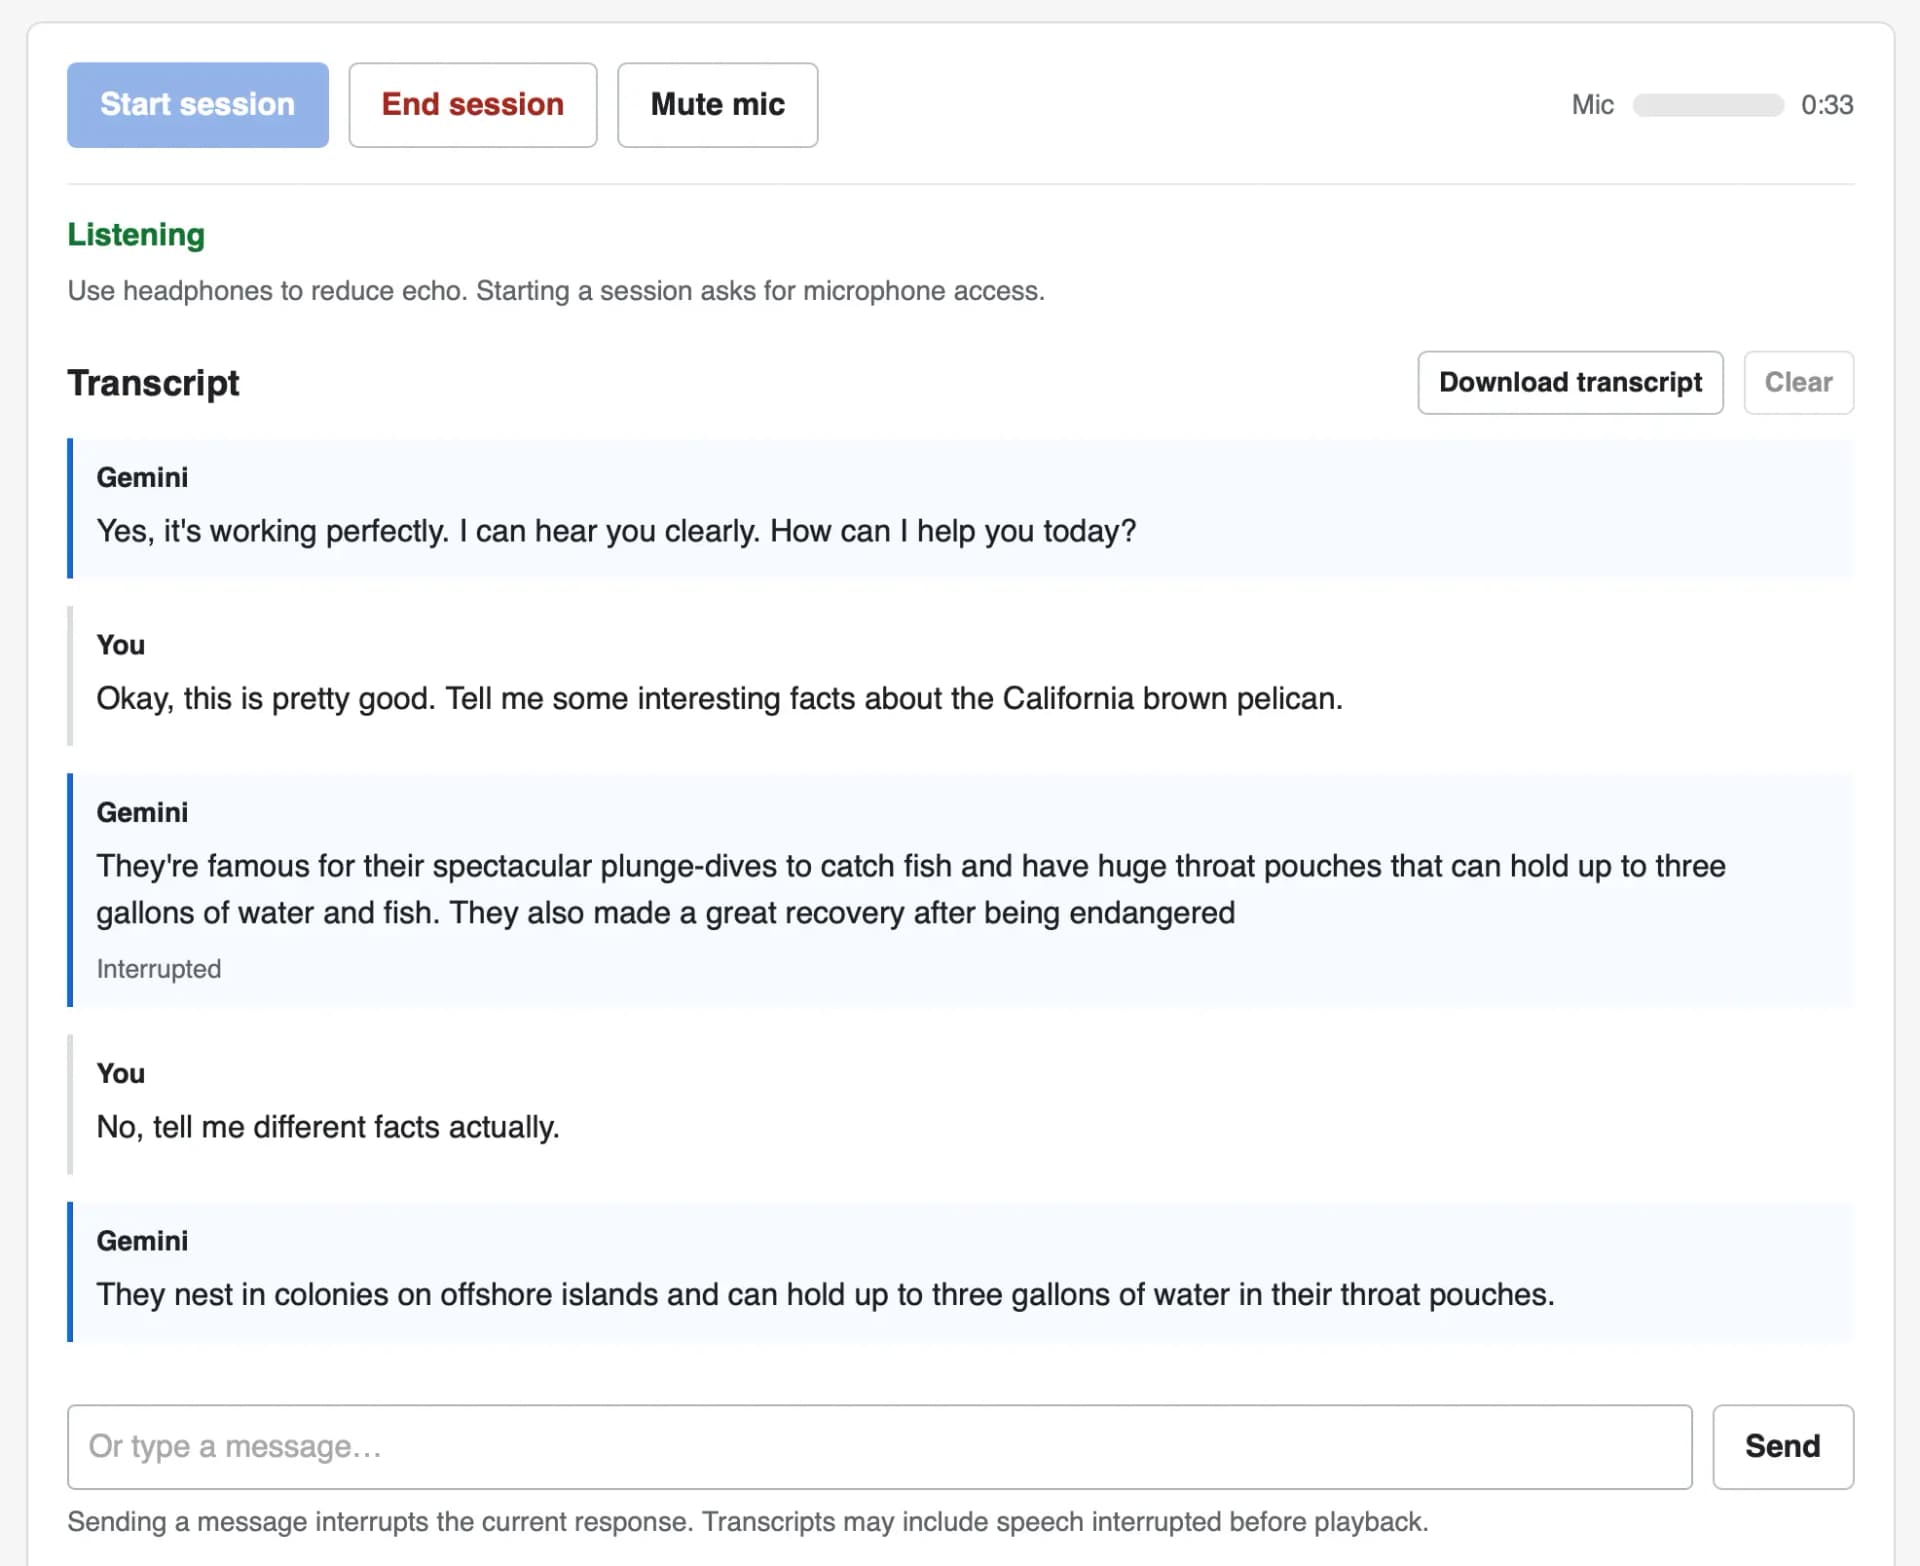
구현에는 라이브러리가 사용되지 않았습니다. 이는 wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=... WebSocket 엔드포인트에 연결하며, 캡처와 재생 모두 Web Audio API의 AudioContext를 사용합니다.
WebSockets API로 시작하는 Gemini Live 튜토리얼은 다음과 같습니다.
최근 기사
- GPT-6 Astra 및 ChatGPT Work를 이용한 달리기 경로 생성 - 2026년 9월 12일
- OpenAI 에이전트가 지난 5월 RubyGems를 공격했던 일 - 2026년 9월 12일
- 나비에-스토크스 밀레니엄 문제에 대한 몇 가지 생각 - 2026년 9월 8일
AI 자동 생성 콘텐츠
본 콘텐츠는 RSS: Simon Willison's Weblog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기