초록
이전 포스팅인 Redwood에서 우리는 주어진 아키텍처를 바탕으로, 우리의 AI 시스템이 기록적인 시간 내에 추론 가속기(inference accelerator)를 구현하고, 검증하며, 배포할 수 있음을 보여주었습니다. 하지만 다른 과학 분야와 마찬가지로, 우리는 올바른 자유도와 안전장치(guardrails)가 주어진다면, AI 시스템이 소프트웨어와 하드웨어를 함께 공동 설계(co-design)하여 스택 전반에 걸쳐 최적화를 수행하고, 이전에 접근할 수 없었던 거대한 설계 공간을 열 수 있다고 믿습니다. 우리는 '우리의 AI 시스템과 도구가 인간이 만든 설계를 근본적으로 능가하는 새로운 하드웨어 발견으로 이어질 수 있을까?'라는 질문에 답하고자 했습니다.
오늘 저희는 처음부터 구축된 새로운 명령어 세트(instruction set)를 가진 범용 CPU인 Frostbite를 소개합니다. Frostbite는 상호작용 네트워크(interaction nets)의 속성, 즉 모든 단계가 국소적이고(local), 모든 의존성이 명시적이며(explicit), 모든 값이 정확히 하나의 소유자(owner)를 갖는다는 점을 활용하여 오랫동안 정체되어 있던 CPU 성능에 단계적인 향상(step-function gain)을 달성했습니다. 최종 평가까지 보류된 15개 워크로드를 포함한 초기 선정된 25개의 워크로드 세트를 기준으로, 우리는 현대의 실리콘으로 검증된 슈퍼스칼라(superscalar) (듀얼 이슈, 인어디렉트(dual-issue, in-order)) CPU 코어와 비교했을 때 와트당 성능(performance-per-watt)에서 4.59배의 성능을 달성했습니다.
저희 AI 시스템은 컴파일러, ISA(Instruction Set Architecture), 아키텍처, 마이크로아키텍처, RTL(Register Transfer Level), 검증(verification), 그리고 최종 GDS(Graphic Design System)에 이르기까지 자율적으로 반복 작업을 수행했습니다. 발견된 아키텍처 원시 요소들을 자세히 살펴보았을 때, 이전에 설계하기 어려웠을 새로운 하드웨어 구현 및 런타임 기능들을 발견하는 데 놀랐습니다. CPU 코어 개선이 정체되었음에도 불구하고, 우리는 워크로드 개념을 최종 GDS까지 끌고 갈 수 있었으며, perf/W와 perf/area 모두에서 단계적인 증가를 입증할 수 있었습니다. 저희는 AI 시스템의 역량이 커짐에 따라, 오늘날 우리가 알고 있는 모든 칩 클래스(데이터센터급 CPU부터 AI 가속기, 네트워킹 스위치 및 NIC까지)가 유사한 근본적인 아키텍처 변화를 겪을 것이라고 믿습니다.
상호작용 네트워크 소개
메인스트림 프로그래밍 언어는 범용 CPU를 위해 컴파일될 때 프로그램 부분들 간의 종속성을 숨깁니다. 코드의 어떤 부분이든 공유되고 가변적인 상태(shared, mutable state)를 통해 임의의 변수를 읽거나 쓸 수 있기 때문에, 현대 CPU 하드웨어는 최악의 경우를 가정하고 런타임에 실제로 어떤 명령어들이 서로 의존하는지 재발견합니다. 게다가, 단일 코어 CPU 성능은 2000년대 초반 이후로 크게 정체되어 왔으며, 이는 사람들이 Intel Xeon, AMD Zen, NVIDIA Vera와 같은 대규모 멀티코어 CPU 쪽으로 이동하게 만들었습니다. 이로 인해 CPU는 모든 코어가 동일한 메모리를 본다는 환상을 유지해야 하며, 그 환상을 일관되고 성능 좋게 유지하는 것은 면적과 전력을 소모하고 확장성이 떨어지는 깊은 캐시 계층 구조와 일관성 프로토콜(coherence protocols)을 필요로 합니다.
상호작용 네트워크(Interaction nets)는 다른 접근 방식을 취합니다. 프로그램은 노드들의 그래프이며, 계산은 포트를 통해 연결된 두 개의 노드 쌍을 재작성함으로써 이루어집니다. 모든 재작성은 그래프의 작고 국소적인 부분만을 건드립니다. 각 노드는 정확히 하나의 주(principal) 포트를 가지고 있기 때문에, 이 활성화된 쌍들 중 어느 두 개도 서로 겹치지 않으며, 따라서 어떤 순서로든 또는 한 번에 모두 재작성될 수 있고 결과는 항상 동일합니다. 상호작용 네트워크는 또한 선형적입니다: 모든 값은 정확히 한 번 사용되므로 하드웨어가 보호해야 할 공유 가변 상태가 없습니다. Vine2compile과 같은 언어들은 평범해 보이는 프로그램을 직접 상호작용 네트워크로 컴파일합니다. 상호작용 네트워크와 이것이 하드웨어에 적합한 이유에 대한 훌륭한 입문 자료로는 Tendrils의 “On Interaction Nets”를 강력히 추천합니다. 3
Fig. 1은 다섯 개의 여왕을 5x5 보드에 배치하는 작은 검색 문제에서 차이를 보여줍니다. 순차적인 프로그램은 한 번에 하나의 후보만 방문합니다. 상호작용 네트워크는 그 독립적인 작업 전체를 노출합니다: 평균적으로 매 단계마다 약 열두 개의 상호작용이 실행 준비가 되어 있습니다. 이 병렬성을 얻기 위해 프로그램의 어떤 부분도 재작성된 것이 아니며, 종속성은 단순히 버려지지 않았을 뿐입니다.
이론적으로 볼 때, 이 아키텍처는 두 가지 큰 장점을 가져야 합니다. 첫 번째는 무료 멀티스레딩(multithreading)입니다. 기존의 거친(coarse) 및 미세(fine) 그레인 병렬성 수준을 변화시키는 대신, 병렬성이 프로그램 자체에서 직접 나옵니다. 스레드, 락(lock), 또는 레이스 컨디션(race condition)이 없으며, 일반적인 코어가 이를 추출하기 위해 사용하는 비순차적 처리 장치(out-of-order machinery)도 없습니다.
두 번째는 모든 값이 하나의 소유자(owner)를 가지고 있고 모든 단계가 지역적(local)이기 때문에, 데이터가 사용되는 곳 근처의 작은 지역 메모리(local memories)에 존재할 수 있다는 점입니다. 이는 기존 칩이 대규모 캐싱 서브시스템(caching subsystems)에 사용하는 많은 면적과 전력을 줄여주며, 해당 캐시들의 일관성 유지(coherence)와 관련된 시스템 레벨 복잡성을 크게 감소시킵니다.
프로세스 (Process)
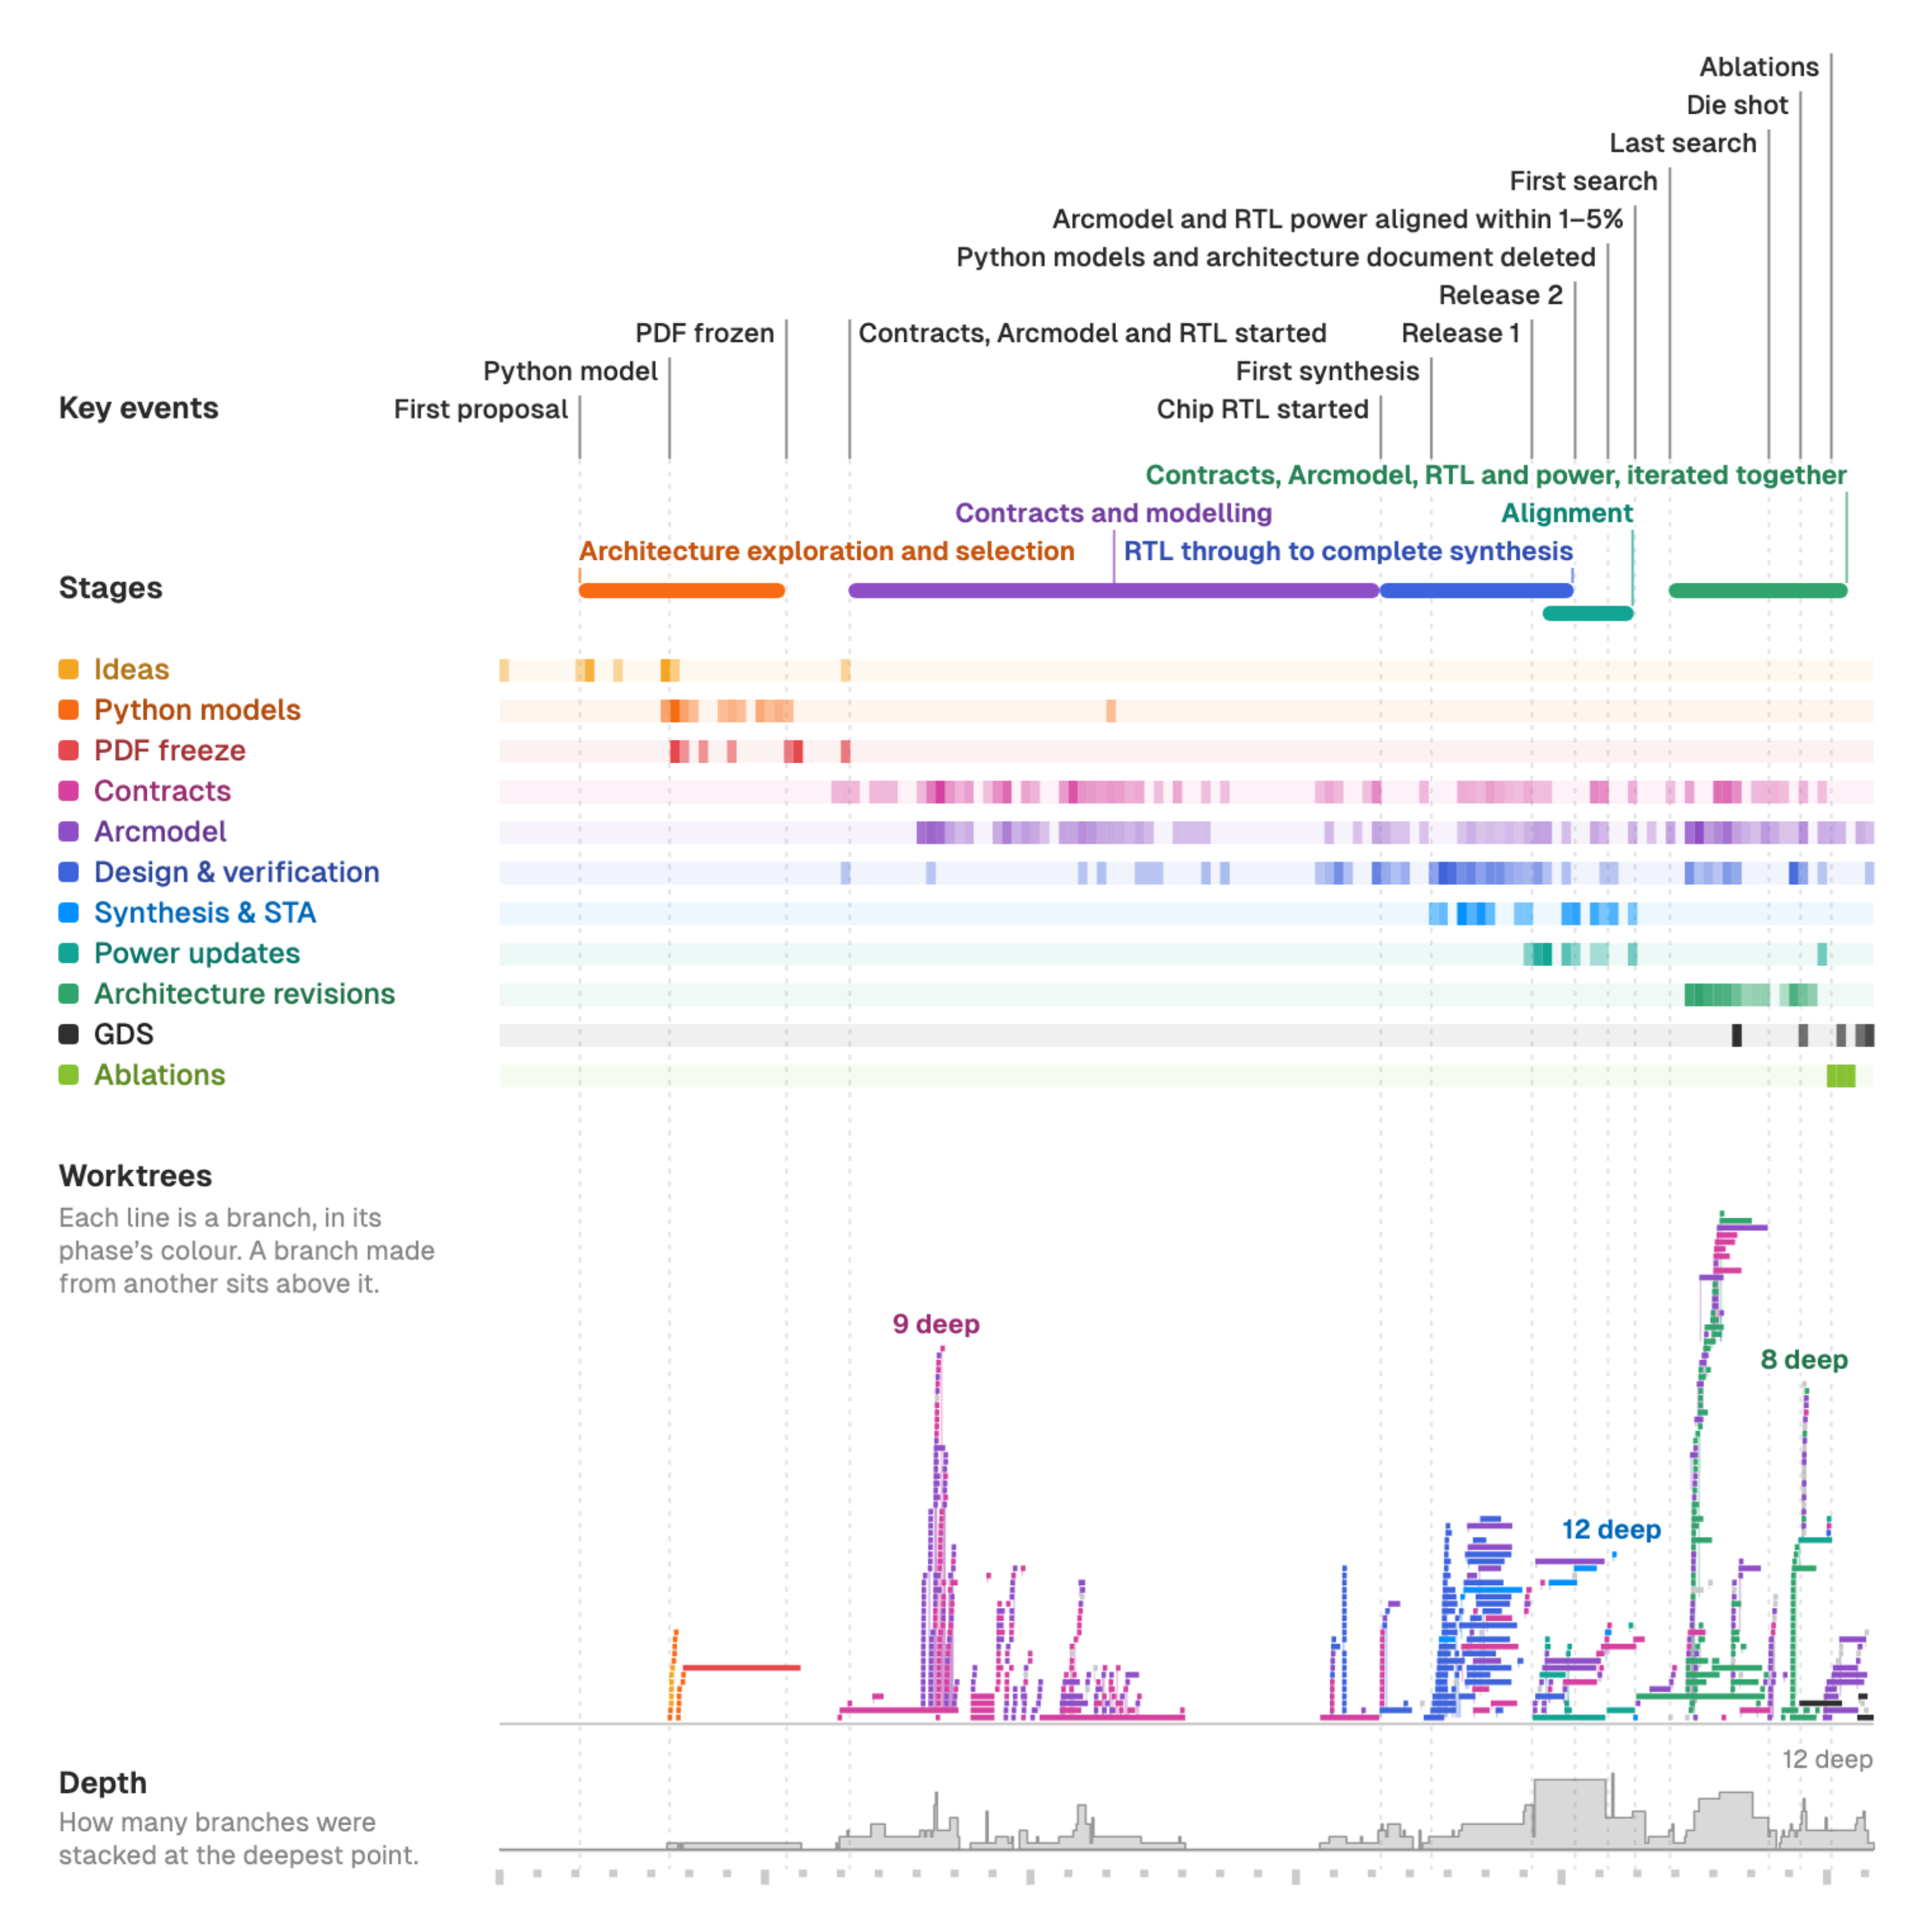
Frostbite는 아키텍처 사전 지식(architectural priors) 없이 설계되었습니다. 우리는 아래의 과정을 따랐으며, 이 과정에서 여러 에이전트 스웜(agent swarms)을 활용했습니다.
Timeline of the Frostbite program showing key events, stages from architecture exploration through alignment and iteration, and the agent worktrees created in each stage.
아키텍처 탐색 및 선택 (Architecture exploration and selection)
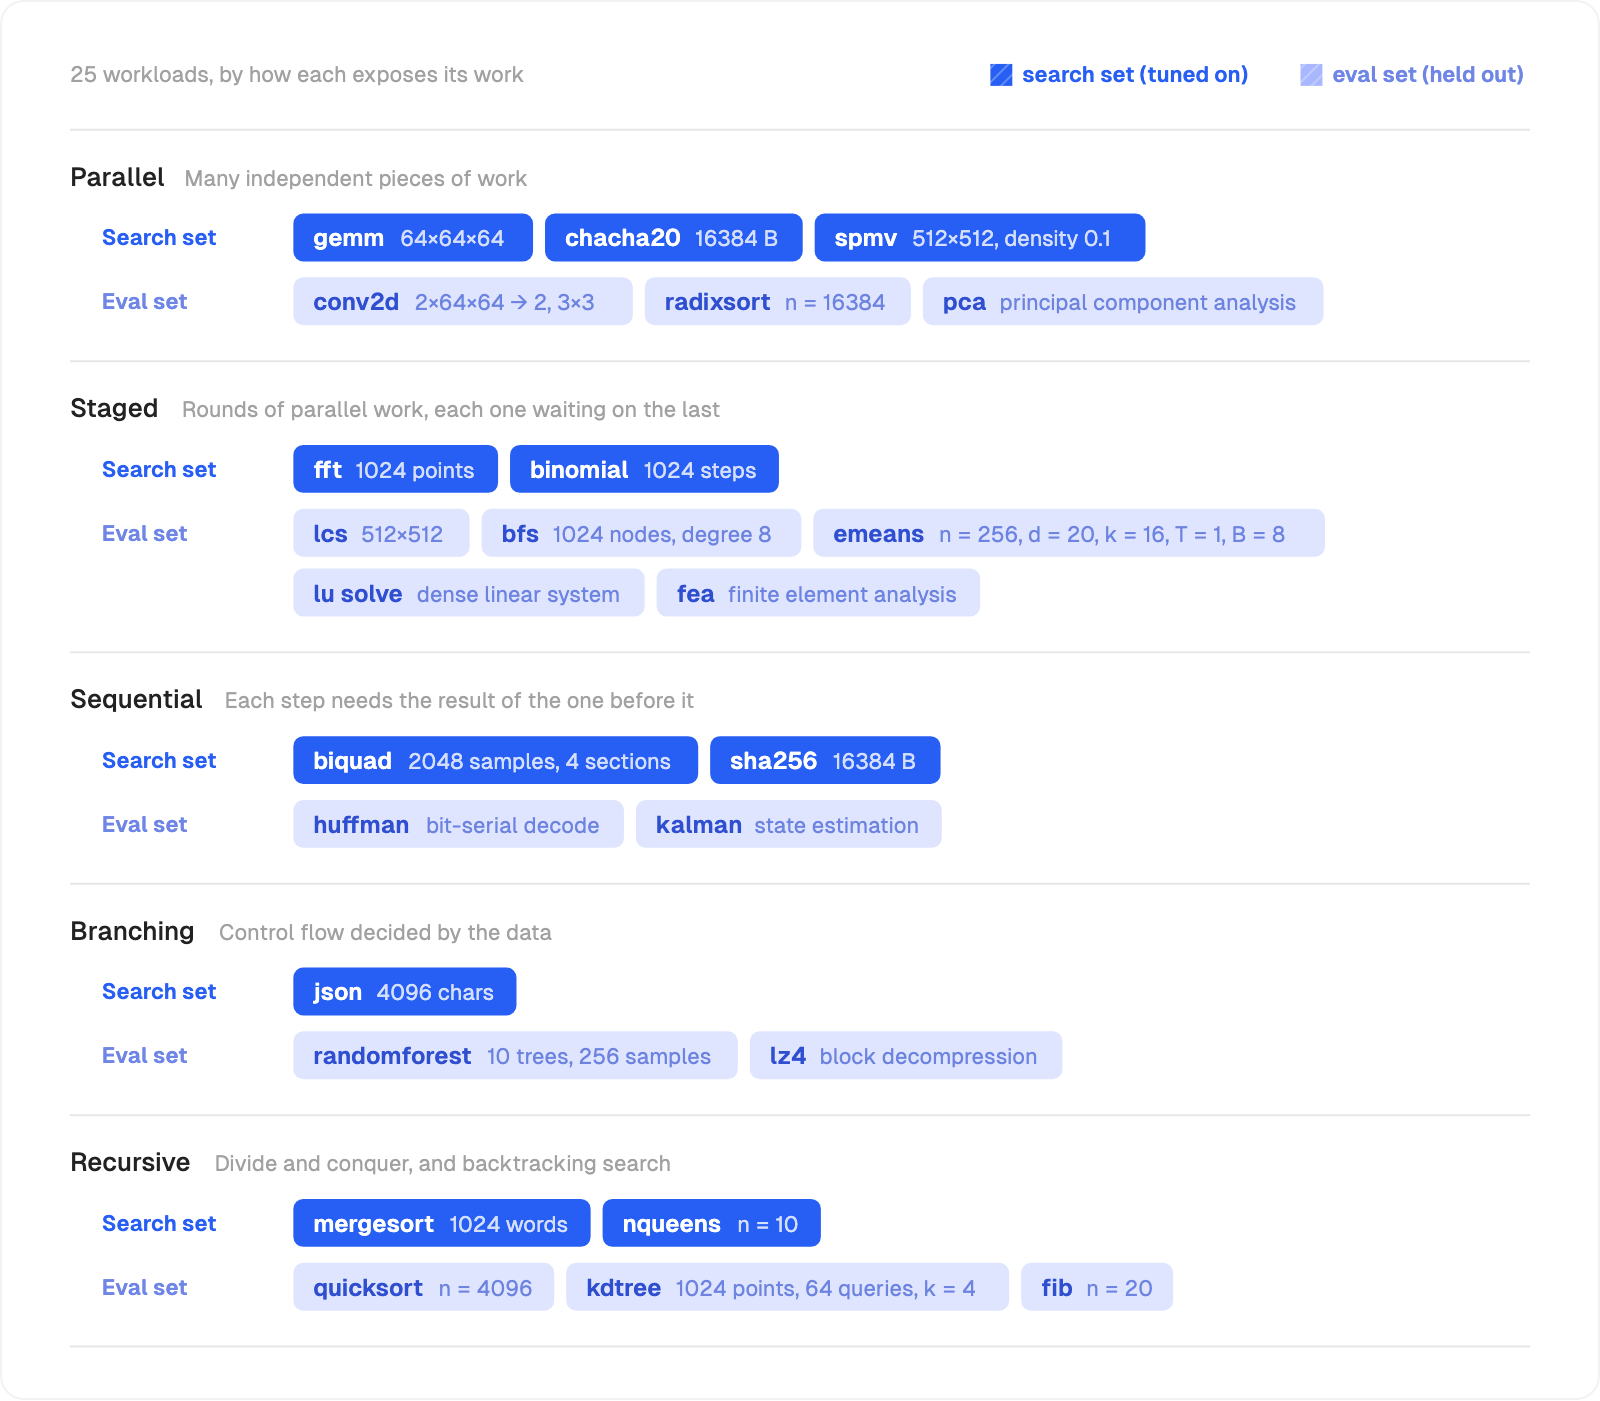
아키텍처 탐색을 시작하기 위해, Frostbite가 매우 잘 수행해야 하는 워크로드 세트를 확립해야 했습니다. 우리는 프로그램이 작업을 노출할 수 있는 다양한 방식, 즉 한 번에 많은 독립적인 조각들, 병렬 작업 라운드, 긴 순차적 체인(sequential chains), 데이터 의존성 분기(data-dependent branches), 그리고 재귀를 살펴보기로 결정했습니다. 각 카테고리별로 검색 세트(search set)와 보류 평가 세트(held-out eval set)를 생성하여 최종 Frostbite를 평가했으며, 이를 통해 설계가 한 번도 튜닝되지 않은 프로그램에도 일반화됨을 확인했습니다. FFT, radixsort, 그리고 LU에 대한 커널은 SPLASH-2 벤치마크의 구현을 따르지만, 정규 크기에서는 탐색 작업에 적합하지 않아 64분의 1 크기로 적용되었습니다.
나중에 보류 세트에 다섯 가지 실용적인 워크로드를 추가했습니다: 칼만 필터(Kalman filter), PCA, 유한 요소 분석(finite element analysis), LU 해법(LU solve), 그리고 LZ4 압축 해제입니다.
Table of 25 workloads in five groups, each split into search set and eval set. Parallel: gemm, chacha20 and spmv in the search set; conv2d, radixsort and pca in the eval set. Staged: fft and binomial in the search set; lcs, bfs, emeans, lu solve and fea in the eval set. Sequential: biquad and sha256 in the search set; huffman and kalman in the eval set. Branching: json in the search set; randomforest and lz4 in the eval set. Recursive: mergesort and nqueens in the search set; quicksort, kdtree and fib in the eval set.
에이전트들은 연구 논문과 기존 벤치마크를 종합하고, 고수준 아키텍처 아이디어를 서로 비교하는 파이썬 모델을 구축한 후, 단일 아키텍처 개념으로 좁혀 나갔습니다. 이 탐색의 결과물은 제안된 프로그래밍 모델, 런타임, 그리고 칩의 고수준 블록을 다루는 141페이지 분량의 PDF였습니다. 이것은 최종 아키텍처와는 거리가 멀었으며, 이전의 모든 발견 사항, 고수준 요구사항, 제약 조건, 실험 및 런타임 특성이 설명된 시작점일 뿐이었습니다. 첫 번째 아키텍처 반복(첫 RTL 생성)이 완료되자마자 이것은 삭제되었는데, 그 이유는 제시된 많은 수치와 추정치가 물리적으로 가능한 범위에서 크게 벗어났기 때문입니다.
아키텍처 후보가 선택된 후, 저희 시스템은 칩의 전체 소프트웨어 모델을 구축하는 단계로 넘어갔습니다. 소프트웨어 모델을 구축하는 것은 아키텍처 공간을 탐색할 때 필수적입니다. 왜냐하면 워크로드(workloads), 명령어 집합 구조(ISA), 그리고 추상화된 하드웨어 뷰 사이의 빠른 반복(iteration)이 가능하게 하기 때문입니다. 우리가 CPU, GPU, NPU 또는 네트워킹 스위치를 구축하든 관계없이, 이 반복 루프를 숙달하는 것은 유한한 시간 내에 설계 공간을 가장 빠르게 탐색할 수 있게 해줍니다. 이를 반복적으로 수행하기 위해, 저희는 새로운 사내 명세 언어인 ASL을 설계하고 그 안에 Frostbite의 시스템 모델인 "Arcmodel"을 작성했습니다. ASL은 형식적으로 뒷받침되는 명세(specification)를 기반으로 RTL, 시스템 모델, UVM, SVA 등 간의 기계 검증 가능한 번역 및 정제 작업을 지원합니다. 이 언어는 전력 및 성능 추정치가 1~5% 오차 범위 내에서 정확하며, RTL 시뮬레이션보다 약 200배 빠르게 실행되고, "계약(contracts)"을 통해 형식적으로 검증 가능합니다.
지금까지 개발된 모든 실리콘 프로그램에서, 인간 아키텍트들은 구현 팀과 검증 팀에게 인계하기 전에 수많은 영어 PDF 문서를 작성해 왔습니다. 하지만 자연어는 구현에 필요한 모든 세부 사항을 정확하고 모호하지 않게 포착할 수 없으며, ASIC(Application-Specific Integrated Circuit)이 설계되고 검증되는 동안 발생하는 모든 에이전트의 환각(hallucination)을 잡아낼 것이라고 보장할 수도 없습니다. 자연어는 이런 목적으로 만들어진 적이 없으며, AI가 사양을 작성하는 세상에서는 대신 형식적이고 기계가 검사 가능한 사양 언어를 채택합니다.
ASL은 순서 뒤바뀜 처리(out-of-order handling), CSR 프로그래밍, 메모리 순서 지정(memory ordering), 일관성(coherency)과 같은 고수준의 프로토콜 유사 동작뿐만 아니라, 파이프라인(pipelines), 중재 메커니즘(arbitration mechanisms), 컴퓨트 전송 함수(compute transfer functions)와 같은 저수준 세부 사항까지 형식적으로 기술할 수 있습니다. 이를 통해 모델은 유용성이 있는 부분에서는 사양을 개방형으로 남겨두고, 정확한 동작이 요구되는 곳에만 제약 조건을 걸 수 있습니다. ASL은 또한 Lean,4로 네이티브하게 번역되며, 우리는 이 언어를 사용하여 RTL, UVM, C, SVA 등 전반의 AI 출력을 검사할 때 모든 정리 증명(theorem proving)에 사용합니다. ASL에 대해서는 다음 게시물에서 더 자세히 논의하겠습니다.
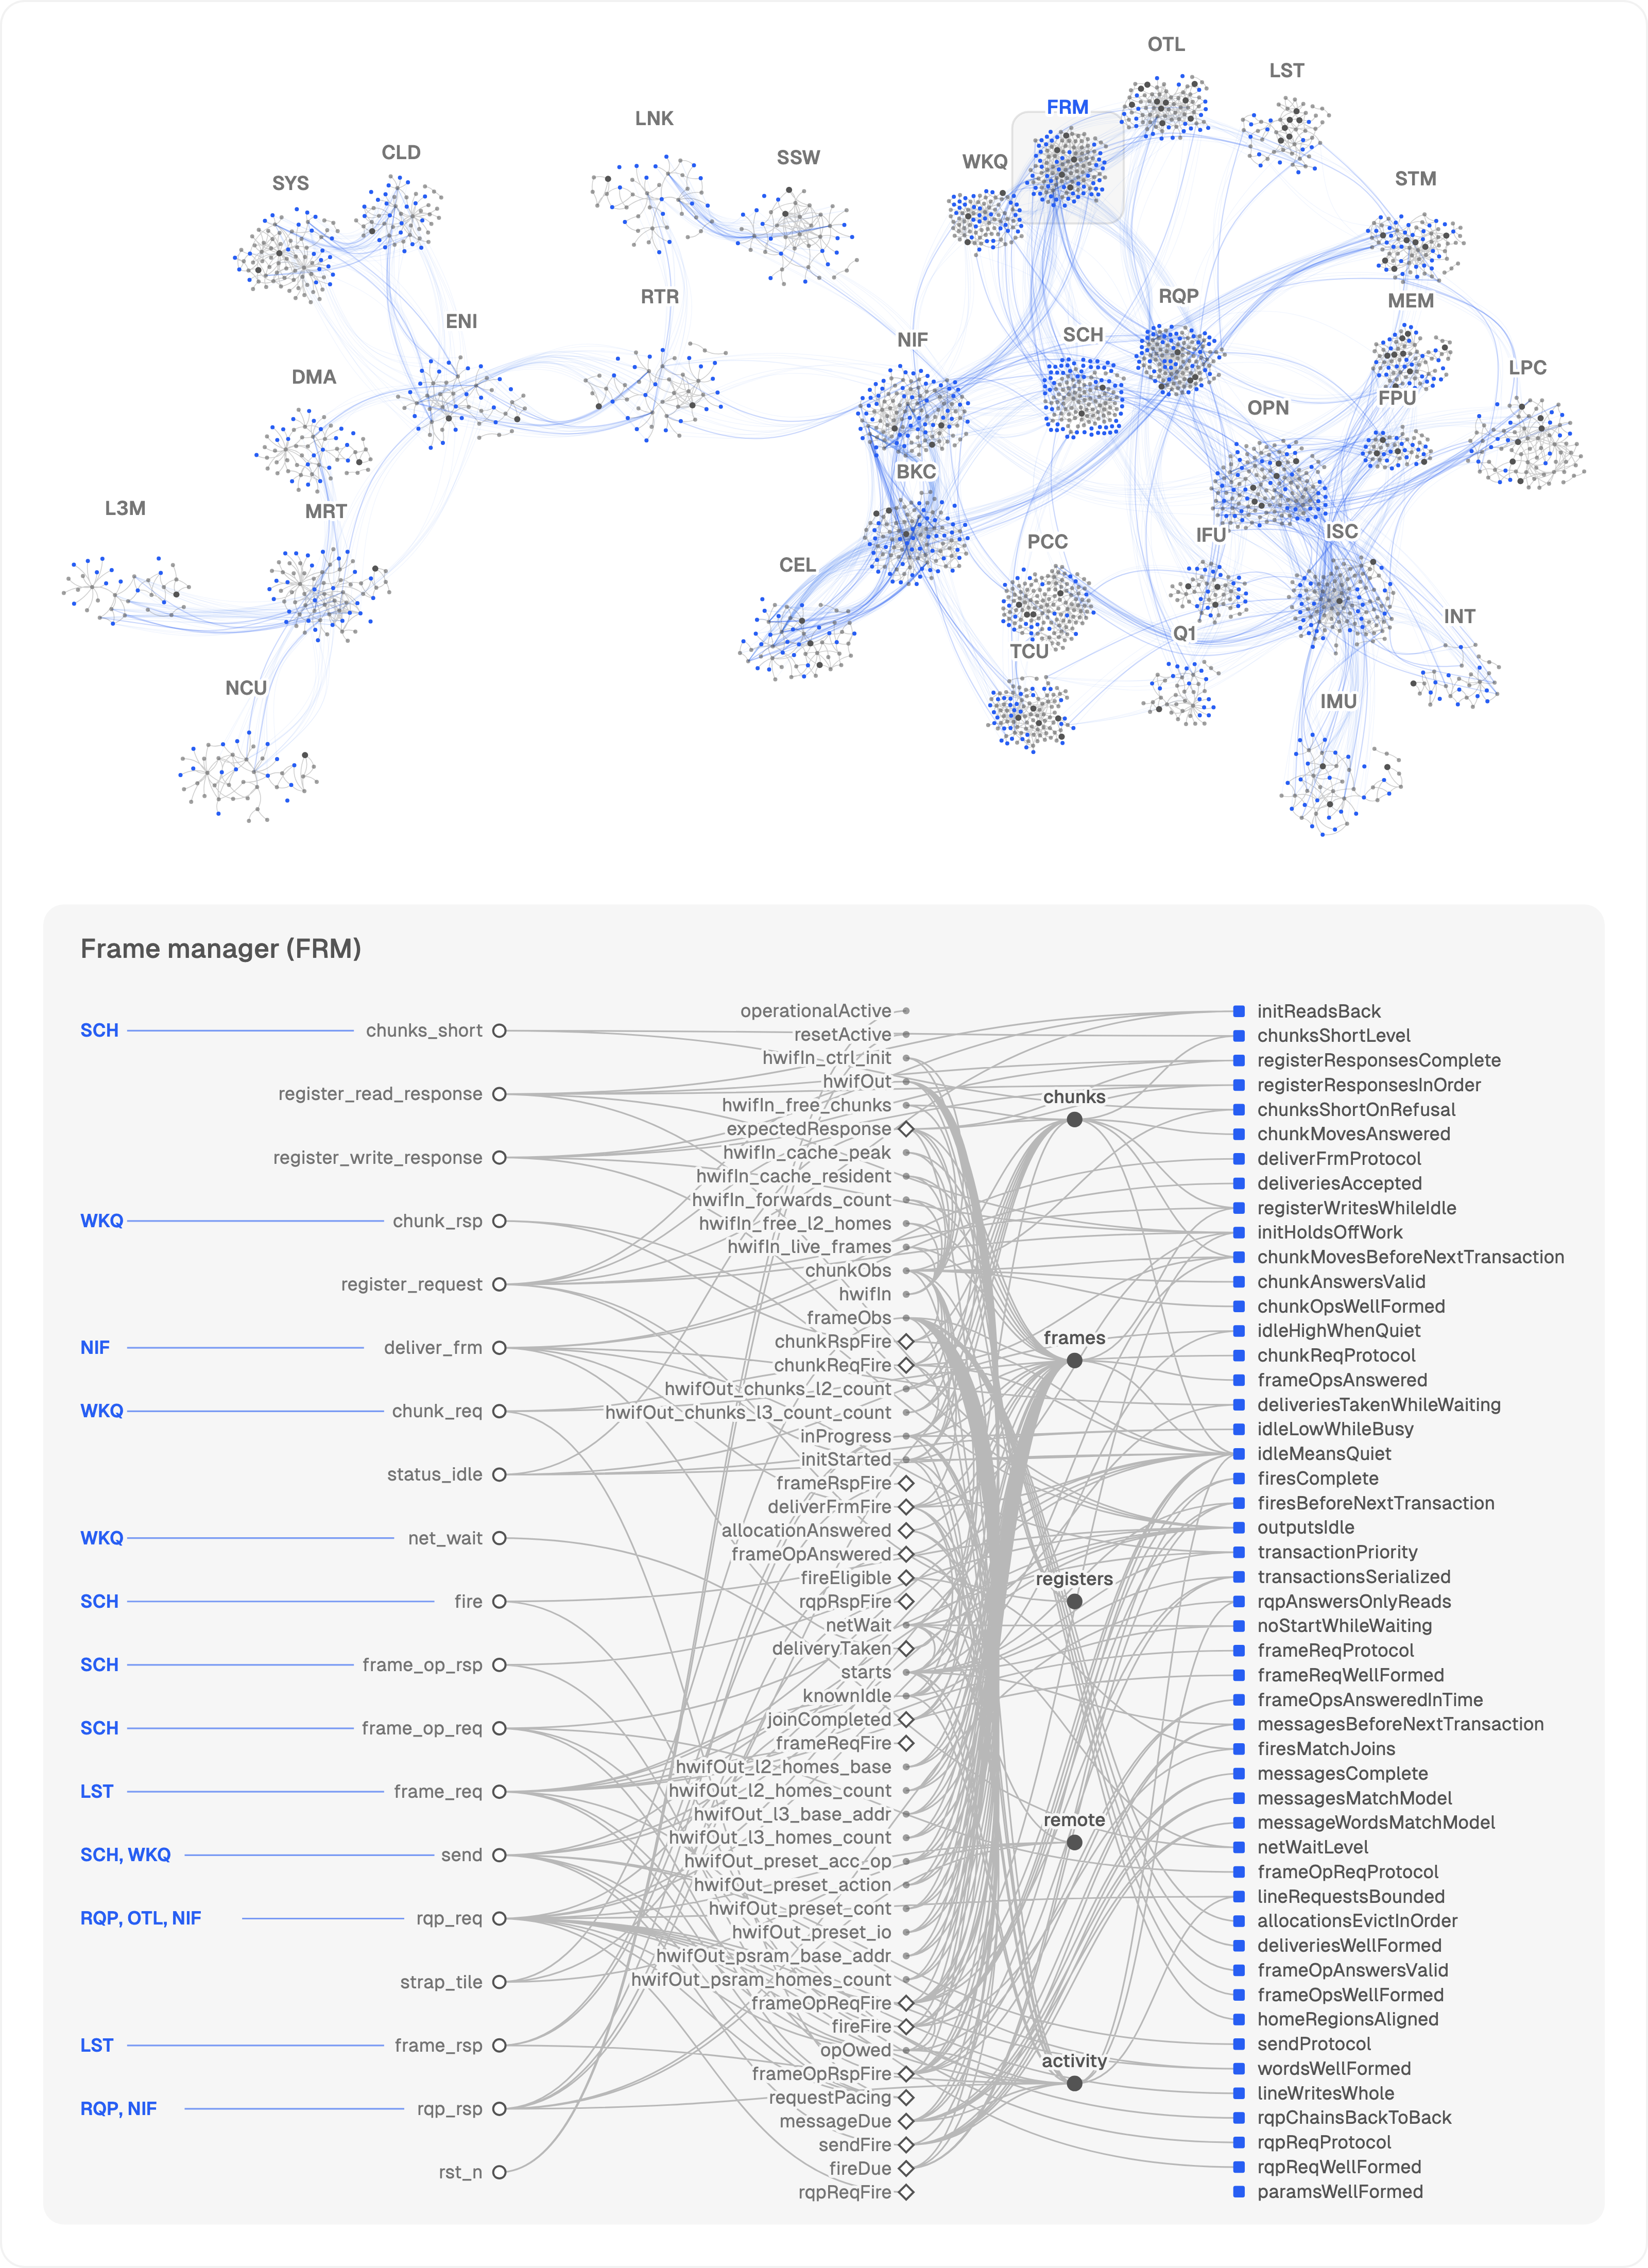
Frostbite 개발 과정 전체에 걸쳐, 저희 AI는 ASL 계약을 진실의 원천으로 유지하며 Frostbite ISA, Arcmodel, 설계(Design), 검증(Verification)을 긴밀하게 반복적으로 개선합니다. 우리는 단일하고 증명 가능한 진실의 원천을 갖는 것이 대규모 에이전트 군집을 배포할 때 발생하는 광범위한 버그, 사소한 실수, 그리고 보상 해킹(reward-hacking) 사례를 방지한다는 것을 발견했습니다. 궁극적으로 이 공통 언어는 모델들이 워크로드에서 최종 하드웨어까지 전파되는 변화를 반영하며 스택 전체에 걸쳐 민첩하게 작동할 수 있도록 합니다. 끝날 무렵, 저희의 Frostbite ASL은 80만 줄 이상의 Lean 코드로 축소되었습니다.
A web of 31 clusters, one per block of the chip, each made of the signals, events, state and clauses its Lean contract names, linked by blue curves where blocks share signals; below, the frame manager's contract drawn out, with its signals on the left feeding events, state and 49 clauses on the right.
RTL 및 정렬(alignment)
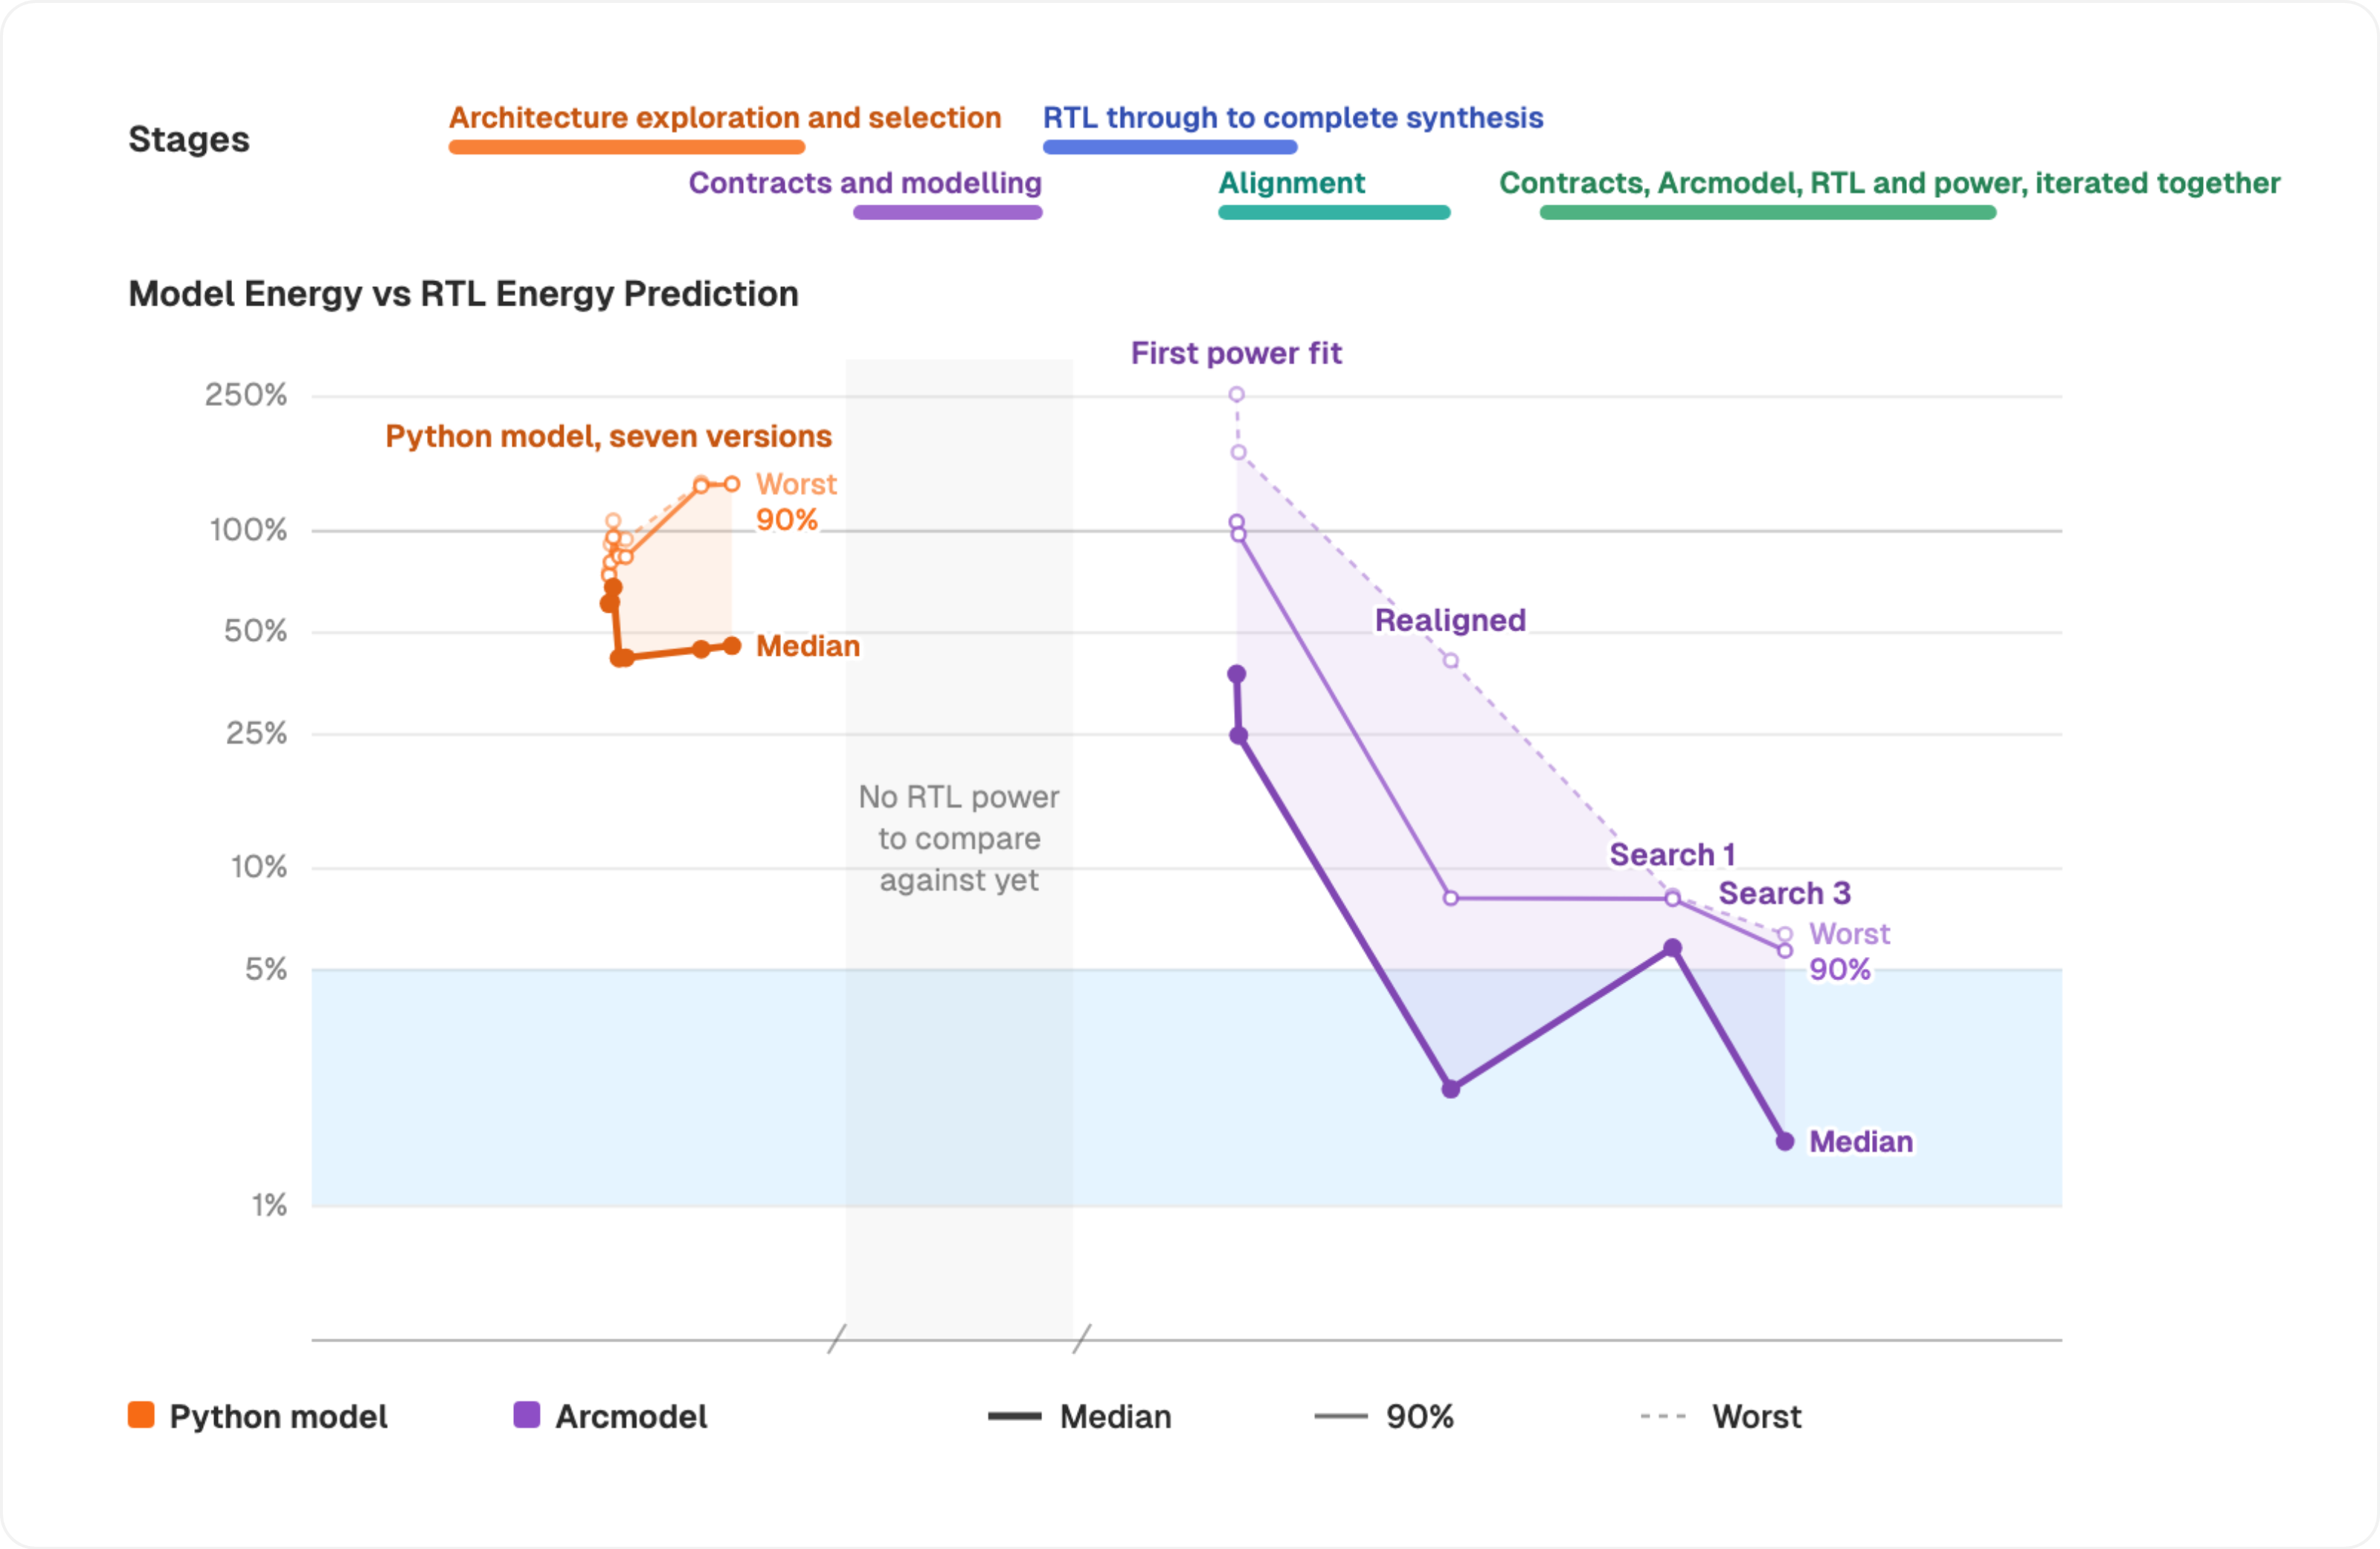
ASL은 형식적으로 보장된 사양(formally backed specification)이므로, 이를 기반으로 파생되는 RTL을 설계하고 검증하는 것이 전체 Frostbite 프로세스에서 가장 빠른 부분입니다. 하지만 Arcmodel은 물리적 인식이 없기 때문에, 초기에는 전력 및 성능 추정치가 타이밍이 수렴되고 합성(synthesis)-클린한 RTL의 실제 수치와 최악의 경우 거의 250%까지 차이가 납니다.
ASL 자동 검색을 계속하기 전에, 저희 시스템 중 하나가 Arcmodel을 RTL에 맞춰 재보정합니다. 이는 완전히 자율적인 파이프라인입니다. 이 시스템은 먼저 RTL에서 전력 집중 지점(power hotspots)을 식별하고, 이를 형식 사양의 주요 카운터(예: SRAM 읽기 및 쓰기, 연산 횟수, 송수신 플릿(flits), 크레딧 반환, 프레임 누락 등)까지 추적합니다. 그런 다음 모델은 이러한 카운터에 대해 전력을 예측하는 임의의 스칼라 Python 함수를 작성할 수 있으며, RTL과 Arcmodel이 5% 이내로 일치할 때까지 이 과정을 반복합니다.
저희는 이러한 방식의 비(非)경사 학습(non-gradient learning)이 매우 강력하다는 것을 발견했습니다. 이 첫 번째 물리적 정렬이 적용된 후에는 이후 반복 작업들이 훨씬 빨라집니다. 물론, 이것들은 여전히 실리콘 제작 전(pre-silicon)의 전력 수치이며, 여러 번의 테이프아웃 루프를 거치면서 ASL 모델은 실제 실리콘 제작 후(post-silicon), 생산 전력 수치와 상관관계를 가질 수 있습니다.
Chart of model energy versus RTL energy prediction error over time, showing the Python model at 40–130% error and Arcmodel falling from 250% worst-case error after the first power fit to under 6% worst-case and about 1.5% median after searching.
Arcmodel과 RTL을 매우 가깝게 정렬함으로써, 지속적인 탐색 시스템(swarms)은 훨씬 빠르게 탐색하고 활용할 수 있었습니다. 전체 Arcmodel 칩 시뮬레이션은 RTL보다 훨씬 빠르며 (660배 빠름), 이는 많은 교차 스택 최적화로 이어졌습니다. 예를 들어, 저희 AI 시스템은 매우 세밀한 클럭 게이팅(clock gating) 트릭을 발견했고, 몇 시간 만에 이를 수용하도록 소프트웨어 런타임을 조정했습니다. 이러한 종류의 교차 스택 최적화는 전통적인 ASIC 흐름에서는 수행하기 거의 불가능합니다.
계약(Contracts), Arcmodel, RTL, 그리고 전력의 반복적 통합