
FADU, 파일 시스템을 SSD 플래시 내부에 구현하여 호스트 CPU 우회
요약
SSD 컨트롤러 설계 업체 FADU가 파일 시스템 자체를 SSD 플래시 내부에 구현한 File-Semantic SSD(FS-SSD)를 발표했습니다. 이 기술은 GPU, DPU 등이 호스트 CPU나 블록 계층을 우회하여 파일을 직접 읽고 쓸 수 있게 함으로써 데이터 처리 경로의 효율성을 극대화합니다. FS-SSD는 특히 멀티 코어 환경에서 단일 코어로 다운그레이드될 때도 높은 성능을 유지하는 것이 강점입니다.
핵심 포인트
- 파일 시스템을 SSD 내부에 구현하여 호스트 CPU 우회 가능
- GPU, DPU 등 가속기가 스토리지 서버 CPU 없이 파일 접근
- 단일 코어 환경에서도 높은 원격 파일 처리량(460,000 ops/s) 유지
- 기존 NFS-over-RDMA 대비 압도적인 성능 향상 기대
SSD 컨트롤러 설계 업체 FADU가 2026 OCP Global Summit에서 새로운 File-Semantic SSD (FS-SSD)를 발표했습니다. 이 신규 장치는 파일 시스템 자체를 SSD 내부로 이동시키는 것을 목표로 합니다. a white paper에 자세히 설명된 바와 같이, 이를 통해 GPU, DPU 및 NIC가 “호스트 파일 시스템, 블록 계층, 스토리지 서버 CPU 없이” 파일을 열고 읽을 수 있게 됩니다. FADU는 _Tom’s Hardware Premium_과의 인터뷰에서 2027년 3분기까지 파트너 샘플이 나올 것으로 예상한다고 밝혔습니다.
FADU는 대한민국 서울에 본사를 둔 fabless SSD 컨트롤러 설계 업체입니다. 이 회사의 FS-SSD 기술은 데이터 경로가 이미 수년 전 가속기(accelerators) 쪽으로 이동했기 때문에, 제어 경로(control path)를 처리하고 개선하도록 설계되었습니다. FADU의 측정 결과에 따르면, 파일 시스템과 블록 계층이 포함된 경우 GPUDirect Storage (GDS) 랜덤 읽기 워크로드에서 CPU 사이클의 약 30%를 소비하는 것으로 나타났습니다. 또한, bypass 옵션을 이용할 경우 파일 자체를 우회하게 되며, 이 회사는 자사의 솔루션이 두 가지 장점(best of both worlds)을 모두 제공한다고 주장합니다.
FADU가 자체적으로 수행한 NVMe 기반 네트워크 파일 시스템 (NFS) 테스트에서, PCIe 5.0 호스트의 FC6161 Gen6 컨트롤러를 탑재한 드라이브를 사용했을 때 원격 파일 처리량(remote file throughput)은 서버가 FADU가 명명한 16 코어에서 단일 코어로 다운그레이드되었음에도 불구하고 약 460,000 ops/s 수준을 유지했습니다.
NFSv3 작업은 표준 NVMe 명령 내에서 수행되며, 드라이브가 경로 조회(path lookup), 접근 제어(access control), 파일-플래시 매핑을 처리합니다. FS-SSD의 성능은 리눅스 NFS-over-RDMA와 비교했을 때 매우 뛰어나서, 후자가 16개 코어에서 ops/s를 달성하는 것이 겨우 3분의 1 수준이고 단일 코어에서는 40K ops/s에 불과했습니다. 이 기술은 여전히 “활발히 개발 중”이며, FADU는 _Tom’s Hardware Premium_을 통해 2027년 1분기까지 Gen6-host 결과를 기대하며, 파트너 샘플은 2027년 3분기에 공개할 것이라고 밝혔습니다.
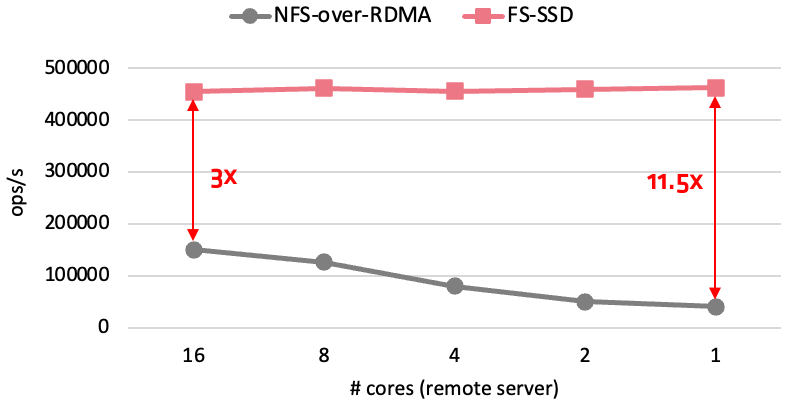
FS-SSD는 16개 서버 코어에서 약 460,000 ops/s를 유지하다 단일 코어까지 떨어지는 반면, NFS over RDMA는 약 150,000에서 40,000 ops/s로 하락합니다 (이미지 출처: FADU)
FADU가 NFSv3를 선택한 이유는 “작고(21개의 작업), OS 및 파일 시스템에 구애받지 않으며(agnostic), 상태 비저장형(stateless)이고” 펌웨어 오버헤드가 낮기 때문입니다. FS-SSD는 현재 PCIe를 지원하며, 새로운 전송 계층이 필요 없이 RDMA 및 TCP over NVMe-oF를 사용할 수 있습니다. 기존 프로토콜을 재사용하는 것은 저희 관점에서 현명한 움직임입니다. 내부적으로는 파일 시스템과 플래시 변환 계층(flash translation layer)이 F2FS에서 파생된 파일 계층과 병합됩니다. 노드와 데이터 블록은 자연스러운 플래시 페이지에 맞게 정렬되며, 섹션은 해당 지우기 단위(erase units)에 위치하여 F2FS 노드 테이블이 노드 ID를 물리적 플래시 주소로 가리키는 “파일 맵(File Map)” 역할을 하게 됩니다.
한 가지 큰 장점은 DRAM 매핑 메타데이터 오버헤드가 상당히 작다는 것입니다. 표준 SSD와 동일한 양의 DRAM, 즉 NAND 용량의 약 0.1%(TB당 약 1GB)만을 사용하는데, 이는 일반적인 SSD가 매핑 테이블로 거의 전체를 채우는 것과 대조적입니다. 여기서는 그 DRAM의 대부분인 약 95%를 핫패스 노드 캐시(hot-path node cache)로 활용할 수 있습니다.
한 가지 가비지 컬렉터(garbage collector)가 두 가지를 대체하여, 파일 시스템 정리와 드라이브 자체의 가비지 컬렉션이 서로 증폭되는 현상인 FADU가 말하는 호스트 F2FS의 “더블 GC(double GC)”를 피합니다. 또한, 회사는 FADU의 연구 프로토타입을 사용했을 때 혼합된 순차 및 랜덤 워크로드에서 쓰기 증폭(Write amplification)이 호스트 F2FS 솔루션 대비 63% 낮다고 밝혔습니다. FADU는 _Tom's Hardware Premium_에 이 프로토타입이 서울대학교의 오픈 소스 소프트웨어 SSD 에뮬레이터인 NVMeVirt를 사용하여 합성 fio 워크로드를 구동하므로 하드웨어 결과가 아니라고 전했습니다.
이 방식에서 가장 중요한 점은 호스트가 필요 없다는 것입니다. GPU는 자체 메모리(HBM 포함 가능)에 NFS-over-NVMe 명령을 큐 형태로 구축할 수 있습니다. 또는 원격 SmartNIC나 DPU가 NVMe-oF 타겟 오프로드를 통해 드라이브의 제출 큐(submission queue)에 명령을 넣을 수 있습니다. 데이터는 PCIe 피어투피어 DMA를 거쳐 SSD에서 NIC로 이동하며, RDMA 쓰기 형태로 나옵니다. FADU가 명시적으로 언급한 사용 사례로는 GPU 파일 읽기 및 체크포인트, DPU 제공 HTTP 콘텐츠 전송, 그리고 JBoF(just a bunch of flash) 파일 서버 등이 있습니다.
FADU의 내부 테스트 수치는 클라이언트와 서버 Intel Core i5-13600K (20 스레드, 최대 5.1 GHz 클럭 속도, DDR5 128GB), 그리고 Mellanox ConnectX-6 100 Gbps NIC를 사용했습니다. 합성 테스트는 블록 펌웨어의 기준선 F2FS 및 Ext4와 커널 클라이언트 및 SPDK 사용자 공간 클라이언트를 통한 FS-SSD를 사용하여 비교되었습니다. 순차 테스트는 스레드 1개, 큐 깊이(QD) 128, 블록 크기 128KB로 진행되었으며, 랜덤 테스트는 스레드 4개, 동일한 QD 128이지만 블록 크기는 4KB였습니다.
이 블록 크기들은 저희 경험상 클라이언트 워크로드에 일반적이기 때문에 적절한 측정치이며, 자세한 예비 결과는 아래 표에서 확인할 수 있습니다. raw 드라이브의 SPDK 성능과 비교했을 때, FS-SSD의 SPDK 클라이언트는 fio를 통해 4K 랜덤 읽기에서 약 93%, 4K 랜덤 쓰기에서 53%의 성능을 유지하며, 인드라이브 파일 계층(in-drive file layer)에 대해 각각 약 7%와 47%의 비용이 발생합니다. 비록 raw 드라이브의 13,240 MB/s 랜덤 쓰기가 NAND 프로그램 대역폭인 ~12 GB/s보다 높지만, 해당 테스트는 안정 상태(steady state)에서 수행되지 않았을 가능성이 높습니다. Filebench 결과가 특히 흥미로운데, 이는 SPDK 랜덤 성능 향상이 일반 블록 장치에도 적용되기 때문입니다.
이것은 기술에 가장 유리한 워크로드일 것입니다. 왜냐하면 Filebench 파일 서버는 메타데이터(metadata) 처리가 많고 호스트 오버헤드(host overhead)가 상대적으로 높기 때문입니다. FADU에 따르면, 이 서버는 10,000개의 파일을 다단계 트리(multi-level tree)로 사용하며, 평균 디렉터리 너비는 20이고, 평균 파일 크기는 128KB이며, 클라이언트 스레드는 50개입니다.
FADU의 예비 fio 결과: PCIe 5.0 호스트에 탑재된 Gen6 컨트롤러, 직접 I/O(direct I/O)
|
설정 (Setup) |
순차 읽기 (MB/s) |
순차 쓰기 (MB/s) |
4KB 랜덤 읽기 (MB/s) |
4KB 랜덤 쓰기 (MB/s) |
| --- | --- | --- | --- | --- |
| F2FS | 14,120 | 4,510 | 7,850 | 3,980 |
| Ext4 | 14,130 | 7,050 | 9,120 | 4,560 |
| FS-SSD (커널 클라이언트) | 14,140 | 11,940 | 8,070 | 4,320 |
| FS-SSD (SPDK 클라이언트) | 보고되지 않음 (Not reported) | 보고되지 않음 (Not reported) | 13,000 | 7,030 |
| Raw 블록 (SPDK) | 보고되지 않음 (Not reported) | 보고되지 않음 (Not reported) | 13,990 | 13,240 |
기억해야 할 중요한 점은 이 테스트가 Gen6 드라이브에서 수행되었지만, 테스트 결과는 PCIe 5.0 호스트에서 나왔다는 것입니다. 따라서 모든 순차 읽기 구성은 약 14.1 GB/s로 최고치를 기록하며, 이는 대략 링크 제한치에 해당합니다. 이 테스트베드는 소비자급 데스크톱 CPU를 사용했으며, 단일 코어 NFS 서버는 보여주는 예시입니다. 커널 클라이언트는 무작위 읽기에서 Ext4보다 11.5% 뒤처지고, 무작위 쓰기에서는 5.3% 뒤처졌습니다. 이 역시 저희 계산에 의한 수치입니다.
일반적으로 더 어려운 질문의 한 예는 다음과 같습니다. 동시 GPU, DPU 및 호스트 라이터들은 어떻게 조정할까요? 커널 마운트의 페이지 캐시는 GPU 접근과 어떻게 일관성을 유지할까요? NFSv3 스토리지 장치는 pNFS Flexible File Layout 사양(RFC 8435)에 따라 “항상 느슨하게 결합된 것으로 취급”되며, 이는 “필수 바이트 범위 잠금(Mandatory byte-range locking)을 지원할 수 없음”을 의미합니다.
NVMe 명령을 타고 이동하는 자격 증명(Credentials) 또한 보안 문제를 겪을 수 있습니다. 느슨하게 결합된 장치는 클라이언트가 보내는 사용자 및 그룹 ID를 서버가 신뢰하는 NFS의 기본 방식인 AUTH_SYS와 동등한 수준의 “보안 수준”만을 얻기 때문입니다. FADU가 발표한 자료에는 스냅샷, 암호화 처리, 쿼터(quotas), ACLs, 충돌 처리 등과 관련된 기능은 설명되어 있지 않습니다. 무상태성(Statelessness)이 작동하게 만드는 요소이지만, 모든 문제를 해결하는 것은 아니므로 신뢰 요인은 다른 곳으로 이동합니다.
질문이 이어지자 FADU는 NFS의 잠금 관리자가 구현되어 있지 않기 때문에 크로스 호스트(cross-host) 잠금은 없다고 답했다. 드라이브는 모든 쓰기 작업을 순서대로 처리한다. 만약 두 개의 쓰기가 같은 위치에 도달하면, 나중에 온 것이 승리하는 방식이다. 이는 'last-writer-wins' 방식을 따른다. 조정은 클라이언트에 달려 있다: 커널 마운트된 클라이언트들은 그들 사이에서 일반적인 자문(advisory) 잠금을 사용하고, GPU 및 SPDK 클라이언트들은 애플리케이션 내에서 조정하며, 대규모 환경에서는 pNFS 메타데이터 서버가 조정을 담당한다. 캐싱 역시 일반 NFS와 같이 커널 클라이언트를 통해 처리되거나, GPU 및 SPDK 클라이언트의 경우 아예 수행되지 않는다. 이는 기본(stock) NFSv3 동작 방식이다.
드라이브는 사용자/그룹 ID를 파일 권한과 비교하여 자체적으로 확인해야 한다. 이러한 ID가 명령어 내에 포함되기 때문에 클라이언트는 이를 위조할 수 있지만, FADU는 능력 기반 인증(capability-based authentication)을 통해 이 문제를 해결한다고 말한다. 각 명령어는 외부 인증 서버에서 발급된 능력(capability)과, 해당 서버와 드라이브만 공유하는 키로 계산된 코드를 함께 전달한다. 이는 공개된 자료에는 자세히 설명되어 있지 않다. FADU에 따르면 Kerberos 인증 프로토콜 지원도 계획 중이다. 네트워크 연결 드라이브의 경우, 사전 승인된 호스트만을 허용하는 표준 NVMe-oF 보호 기능을 사용한다. 이 드라이브는 모든 NVMe 드라이브와 마찬가지로 단일 호스트의 커널을 신뢰한다.
하지만 FADU가 설명했듯이, 현재 릴리스 버전에서는 암호화를 제외한 ACL(Access Control List) 및 기타 기능들이 누락되어 있다. 여기서 암호화는 FC6161의 표준 TCG Opal 자체 암호화 드라이브 지원을 통해 처리된다. 전원 손실 역시 일반적으로 커패시터를 사용하여 메타데이터, 쓰기 버퍼, 그리고 진행 중인 작업(in-flight operations) 로그를 플러시함으로써 처리된다. 재시작 시, 드라이브는 미완료된 작업을 재생하고, 드라이브가 이를 승인하면 모든 쓰기는 영구적(durable)이다.
FADU는 서버가 앞에 필요 없는 JBoF(Just a Bunch of Flash) 스토리지 솔루션, 즉 FS-SSD, PCIe 스위치, 그리고 NVMe-oF 처리를 위한 DPU 또는 NIC를 하드웨어로 구현하는 데 초점을 맞추고 있습니다. FADU의 모델은 전력 소모를 약 42% 낮추고, 16개 드라이브 서버당 비용을 약 57% 절감하며, 훨씬 낮은 5년간 총소유비용(TCO)으로 더 높은 랙 밀도를 제공합니다. 이 드라이브들은 기존 pNFS 메타데이터 서버 뒤에 장착될 수 있으며 확장성이 있습니다. FADU의 컨트롤러는 이미 Western Digital이 출시하고 SanDisk가 판매하는 SN861과 같은 드라이브와 함께 출하되지만, 이번 계획은 제공할 수 있는 옵션과 솔루션을 확장할 것입니다.
FADU의 FS-SSD 로드맵
| 마일스톤 | 시기 (FADU 기준) | 세부 내용 |
|---|---|---|
| Gen6-host 결과물 | 2027년 1분기까지 | PCIe 6.0 호스트에서 FS-SSD 테스트; 하드웨어 쓰기 증폭 수치도 함께 제공 예정 |
| 파트너 샘플 | 2027년 3분기 | OEM/ODM 논의는 초기 단계; 샘플 출하 후 활발한 협력 기대 |
| Hostless JBoF | 2027년 말까지 | Xsight Labs E1 DPU를 기반으로 한 레퍼런스 디자인을 구축하여 OEM/ODM 파트너에게 제공 예정 |
| GPU 접근성 | 현재, GPUDirect Storage를 통해 | 커널 클라이언트를 통해 GDS와 연동됩니다. FADU는 Nvidia가 cuFile을 오픈소스로 공개한 Accelerated IO SIG(xio-sig)에 참여할 계획이며, Nvidia와 직접적인 협력은 없습니다. |
| 표준화 | 아직 제출된 것 없음 | FADU는 NVM Express 및 OCP Storage에서 파일 의미론적 명령어 세트(file-semantic command set) 논의를 시작할 계획입니다. 샘플과 클라이언트 코드가 먼저 나올 예정입니다. |
내년에는 실제 수치와 샘플이 등장할 것으로 예상되며, JBoF 레퍼런스 디자인도 기대됩니다. 파일 의미론적 명령어 세트를 위해 NVM Express 또는 OCP Storage 제안이 추후 있을 수 있으며, 이는 접근 방식을 더욱 공고히 하고 성숙하게 만들 것입니다. FADU는 좋은 아이디어를 가지고 있으며, 기존 프레임워크를 기반으로 구축하고 있고, Gen6 컨트롤러에서 결과물과 하드웨어 경로가 확보된 테스트베드를 보유하고 있으며 신뢰 모델을 염두에 두고 있습니다. 회사의 주장을 뒷받침하기 위해서는 현재 Gen6-host 실행이 필요합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기