오늘, 저희는 통합 추론 프레임워크와 배포 도구와 함께 Edge0-145B 및 Edge0-120B를 오픈 소스화합니다. Edge0-145B는 1,450억 개의 파라미터를 가진 세계 최초의 온디바이스(on-device) 오픈 소스 AI 모델입니다. 이 모델은 코딩, 추론, 에이전트 기능을 제공하며 최첨단 클라우드 모델에 필적하는 성능을 사용자의 개인 컴퓨터로 가져옵니다.
온디바이스 AI는 오랫동안 모델 역량과 하드웨어가 구동할 수 있는 능력 사이의 상충 관계를 강요해 왔습니다. 더 큰 모델은 더 많은 메모리, 대역폭(bandwidth), 전력을 요구하며, 작은 모델은 복잡한 작업에서 어려움을 겪을 수 있습니다. 이러한 작업을 클라우드로 옮기는 것은 모델 제공업체 비용, 데이터 처리 제약, 그리고 연결성에 대한 의존성을 추가합니다.
이번 릴리스는 네 가지 방식으로 이러한 제약을 해결합니다:
| 제약 사항 | Edge0-145B가 가능하게 하는 것 |
|---|
| 개인 하드웨어에서 대규모 모델을 실행하기 어려움. | 호환 가능한 노트북에서 145B 모델이 로컬로 구동되며, 보고된 최대 메모리는 29GB이고 디코딩 속도는 초당 80 토큰 이상입니다. |
| 작은 온디바이스 모델은 까다로운 작업에서 성능이 부족할 수 있음. | 아래 비교에서 볼 수 있듯이, 코딩, 추론 및 지침 따르기 결과는 특정 최첨단 클라우드 모델과 경쟁할 만합니다. |
| ... | |
| 저희는 개발자들이 결과를 재현하고, 모델을 평가하거나 미세 조정(fine-tune)하며, 이를 자체 제품에 통합할 수 있도록 전체 스택을 공개합니다. | |
모델 가중치를 받거나, 추론 프레임워크를 탐색하거나, Edge0 App을 사용해 보세요.
100B 이상의 파라미터 AI를 개인 컴퓨터에서 구동하는 방법
Edge0-145B 노트북 성능: 메모리, 속도 및 전력
Edge0-145B는 1,450억 개의 파라미터를 가진 모델을 개인 노트북에서 사용 가능하게 만듭니다. 유용한 로컬 모델은 메모리에 적합해야 하며, 프롬프트를 신속하게 처리하고, 사용할 만큼 충분히 빠르게 생성하며, 전력 소비를 제어하는 것을 유지해야 합니다. 또한 더 긴 작업을 지속적으로 수행할 수 있어야 합니다.
Edge0-145B 성능 분석
| 요구 사항 | 보고된 Edge0-145B 결과 | 가능하게 하는 것 |
|---|
| 메모리 (Memory) | 29GB 피크 메모리 (peak memory) | 서버 없이 MacBook Pro와 같은 호환 개인 노트북에서 실행 가능. |
| 프롬프트 처리 (Prompt processing) | 1,100+ tokens/s 프리필 (prefill) | 생성 시작 전에 수십 페이지 분량의 코드를 포함한 긴 프롬프트를 처리함. |
| 생성 (Generation) | 80+ tokens/s 디코드 (decode) | 사람이 읽는 속도보다 빠르게 생성함. |
| 전력 (Power) | 약 120W 일반 전력 (typical power) | 보고된 설정에서 스로틀링 없이 작동을 유지함. |
| 장기 작업 (Long tasks) | 128K–256K 컨텍스트 (context) | 긴 입력에서도 거의 동일한 속도를 유지하여 확장된 작업을 지원함. |
이전 Edge0-35B 휴대폰 버전은 피크 메모리가 2.5GB 미만인 것으로 보고되었습니다. iPhone 18 Pro Max에서 Edge0-35B는 약 2.5GB의 메모리를 사용하여 37+ tokens/s를 제공합니다. Edge0-145B는 매개변수(parameters)가 대략 네 배 많으며, 노트북 비교에서는 80+ tokens/s와 28GB 피크 메모리를 보고했습니다. 이러한 측정값은 서로 다른 모델과 하드웨어에 적용됩니다.
Image
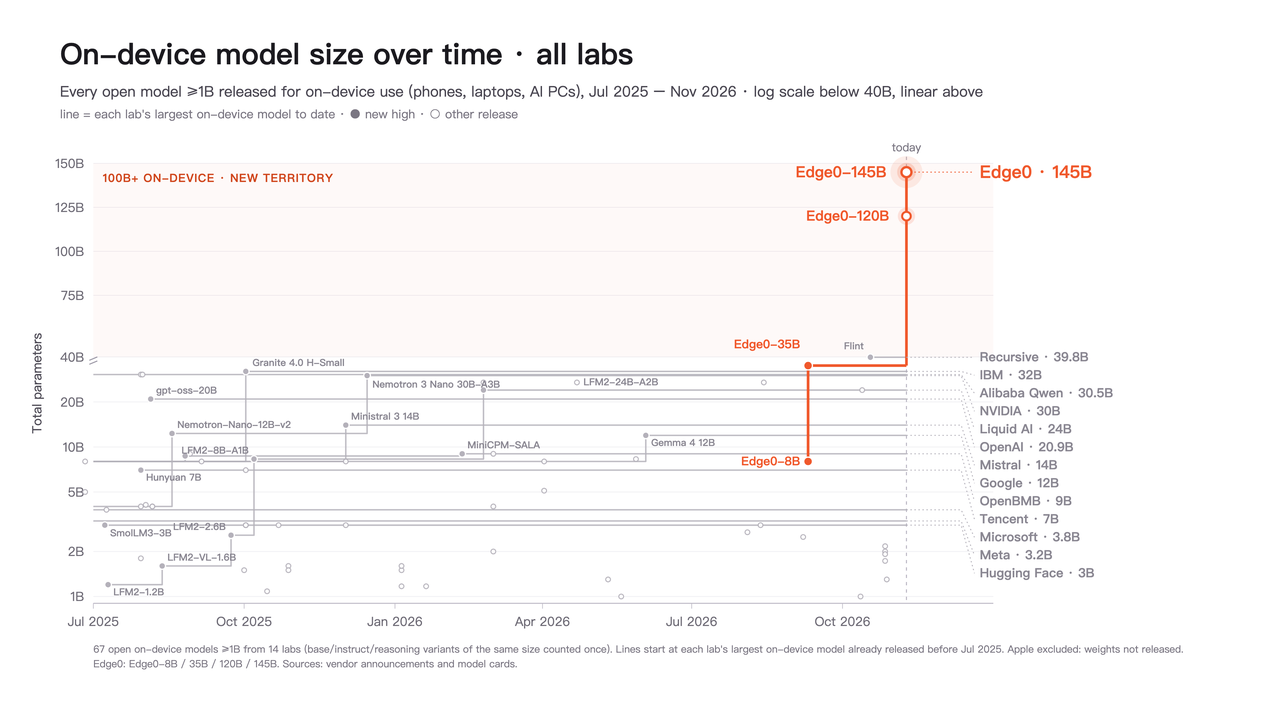
시간 경과에 따른 온디바이스 모델 규모. 이 차트는 휴대폰, 노트북 및 AI PC용으로 설계된 14개 연구소의 최소 1B 매개변수를 가진 67개 오픈 모델을 다룹니다. 동일 크기의 베이스(base), 인스트럭트(instruct), 추론(reasoning) 변형은 한 번만 계산됩니다. 각 라인은 2025년 7월 이전 출시된 것을 포함하여 연구소의 가장 큰 모델을 추적합니다. 채워진 점은 새로운 최고치를 나타내고 빈 점은 다른 출시를 나타냅니다. 규모는 40B 미만에서는 로그 스케일, 그 이상에서는 선형 스케일입니다. Apple은 가중치(weights)가 공개되지 않았기 때문에 제외되었습니다. 출처: 공급업체 발표 및 모델 카드.
온디바이스 모델이 작게 유지된 이유
2026년 9월 이전까지 메모리 한계로 인해 대부분의 온디바이스 모델은 10B 매개변수 미만으로 머물렀습니다. Apple Intelligence의 온디바이스 파운데이션 모델(foundation model)은 약 3B 매개변수를 가졌으며, Google의 Gemini Nano는 1.8B 및 3.25B 버전이 나왔습니다. 심지어 7B 모델조차도 약 4GB의 메모리를 소비할 수 있었습니다.
대규모 모델은 메모리 벽(memory wall)에 직면했습니다. 모델 가중치(Model weights)는 저장 공간을 차지하며, 생성 과정 동안 읽혀야 하므로 운영 체제와 다른 앱들과 제한된 메모리와 대역폭을 두고 경쟁합니다. 공격적으로 압축한 35B 모델조차도 약 20GB의 메모리가 필요할 수 있으며, 이는 휴대폰이 제공할 수 있는 용량보다 훨씬 많습니다.
컴퓨팅(Compute), 대역폭(bandwidth), 전력(power)은 서로 경쟁하는 제약 조건들을 만들었습니다. 더 큰 모델들은 더 많은 기능을 제공했지만, 메모리 용량, 생성 속도, 배터리 수명에 부담을 주었습니다. 모델을 작게 만드는 것은 적합하게 만드는 데 도움이 되었지만, 종종 기능성(capability)을 희생해야 했습니다.
개인 정보 보호만으로는 그 격차를 메울 수 없었습니다. Apple Intelligence는 사용자 데이터를 보호했지만, Apple은 자체 온디바이스(on-device) 모델이 일반적인 세계 지식(general world knowledge)을 요구하는 에이전트형 애플리케이션(agentic applications)에 맞춰 설계되지 않았음을 인정했습니다. 당시의 일반적인 가정은 온디바이스 인텔리전스(intelligence)가 클라우드 수준과 맞설 수 없다는 것이었습니다.
Edge0의 작동 원리: 모델 및 추론 설계의 네 가지 계층
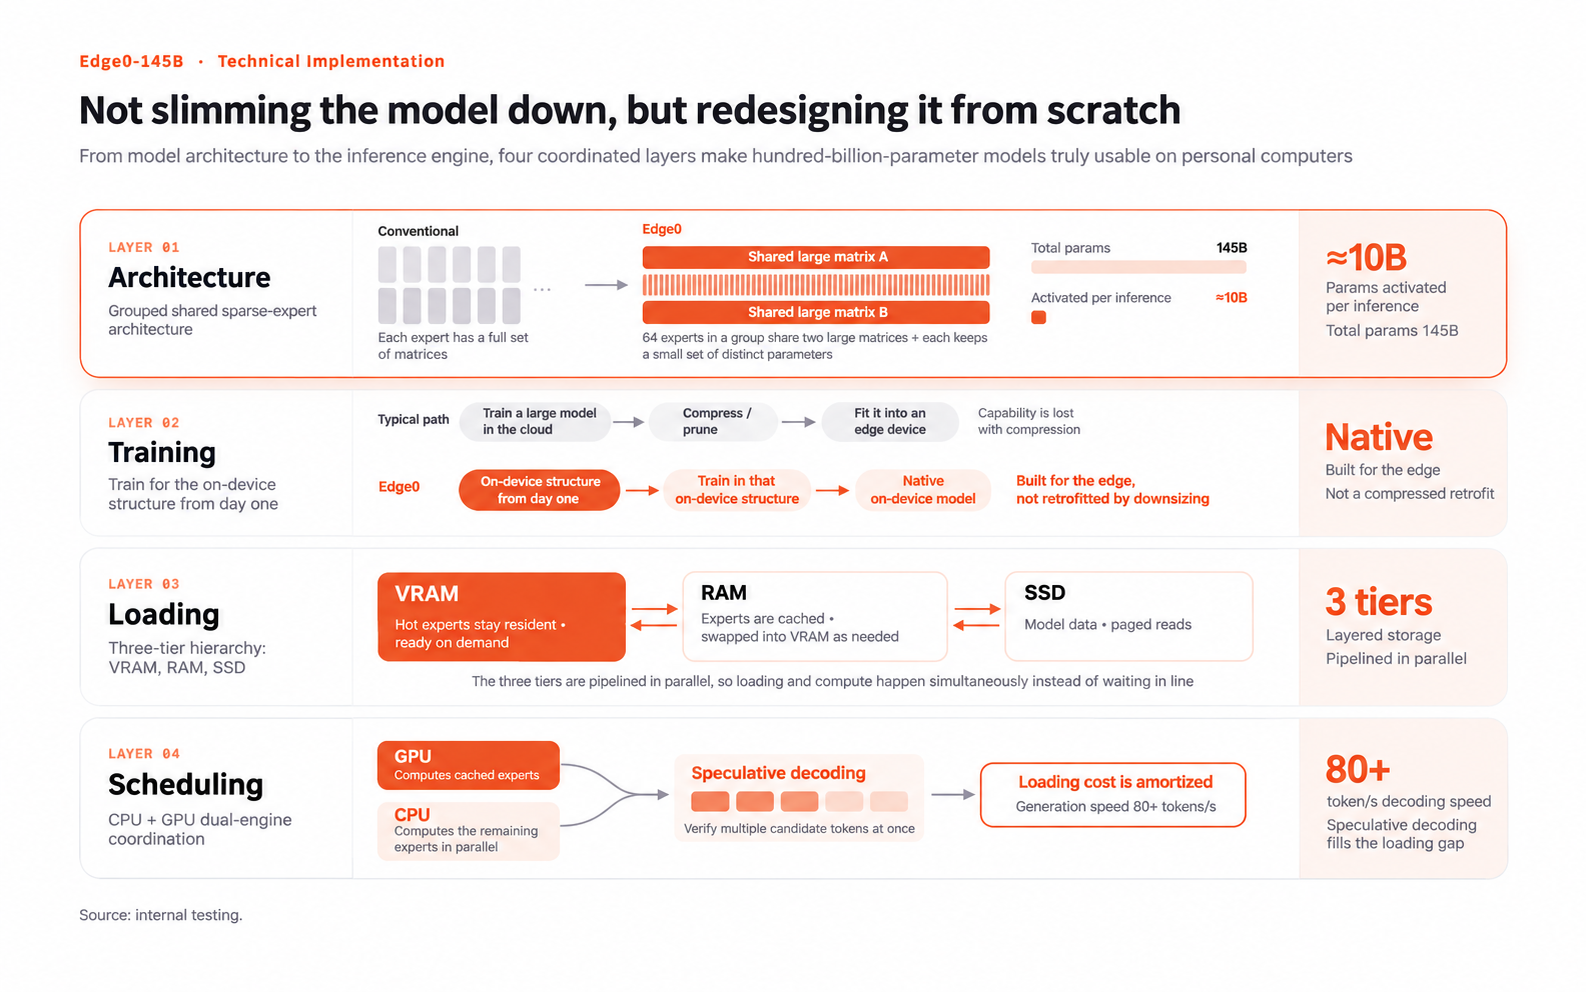
우리는 대규모 모델을 로컬에서 실행하기 어렵게 만드는 메모리 및 데이터 이동량을 줄이기 위해 Edge0-145B와 그 추론 엔진(inference engine)을 함께 설계했습니다. 이 설계는 아키텍처(architecture), 훈련(training), 로딩(loading), 스케줄링(scheduling) 전반에 걸쳐 적용됩니다.
아키텍처: 희소 전문가(sparse experts) 간 대규모 행렬 공유. 행렬을 공유하면 전문가 수를 변경하지 않으면서도 저장하고 이동해야 하는 가중치(weights)를 크게 줄일 수 있습니다. 각 64개 전문가 그룹은 두 개의 대규모 행렬을 공유하며, 각 전문가는 자신만의 차이점을 포착하는 작은 매개변수 세트(parameters)를 유지합니다. 이전에는 모든 전문가가 완전한 세트의 행렬을 저장했습니다. 모델의 총 145B 매개변수 중, 각 추론 단계에서 계산에 참여하는 것은 약 10B에 불과합니다.
훈련: 처음부터 로컬 실행을 염두에 두고 구축. 우리는 배포 제약 조건(deployment constraints)이 설계에 내장된 온디바이스 아키텍처에서 모델을 처음부터 훈련합니다. 이는 클라우드 모델을 훈련한 후 로컬 배포를 압축(compression) 또는 가지치기(pruning) 단계로 취급하는 것을 방지합니다.
로딩(Loading): 파이프라인 GPU 메모리, 시스템 메모리 및 SSD 접근. 세 가지 스토리지 계층에 걸쳐 읽기 및 계산이 중첩되어 직렬 대기를 방지합니다. 자주 사용되는 “핫 전문가(hot experts)”는 GPU 메모리에 유지됩니다. 약 40GB의 전문가 라이브러리가 시스템 메모리에 위치하며, 필요에 따라 전문가들이 GPU 메모리로 로드됩니다. 약 48GB의 어휘 데이터가 SSD에 저장되어 요청 시 읽힙니다.
스케줄링(Scheduling): CPU와 GPU를 함께 사용. GPU는 캐시된 전문가를 계산하는 동안, CPU는 나머지 작업을 병렬로 처리합니다. 추측 디코딩(Speculative decoding)은 여러 후보 토큰을 한 번에 검증하여 가중치 읽기 비용을 더 많은 출력 토큰에 분산시킵니다. 이러한 선택들은 보고된 80+ 토큰/초의 디코딩 속도를 지원합니다.
Image
모델과 추론 엔진 설계가 협력하여 개인 컴퓨터에서 100B 이상의 파라미터 추론을 실용적으로 만듭니다. 출처: 내부 테스트.
이러한 변화들은 메모리 사용량, 전력 소비, 지연 시간의 비례적 증가 없이 파라미터 수를 수십억 개에서 1천억 개 이상으로 늘릴 수 있게 합니다.
Edge0가 할 수 있는 것: 컴퓨터에서 채팅부터 복잡한 작업까지 모든 것
Edge0-145B는 복잡한 작업을 사용 가능한 결과물까지 수행할 수 있습니다. 이 모델의 코딩 및 추론 능력은 계획(planning), 도구 사용(tool use), 실행(execution), 디버깅(debugging), 시각적 확인(visual checks)을 결합한 로컬 워크플로우를 지원합니다. 벤치마크는 이 모델의 능력을 확립하며, 데모는 이를 실제로 어떻게 활용하는지 보여줍니다.
최첨단 클라우드 모델에 필적하는 코딩 및 추론 능력
Edge0-145B는 코딩, 추론, 지식, 명령어 따르기 측면에서 특정 최첨단 클라우드 모델과 경쟁할 수 있습니다:
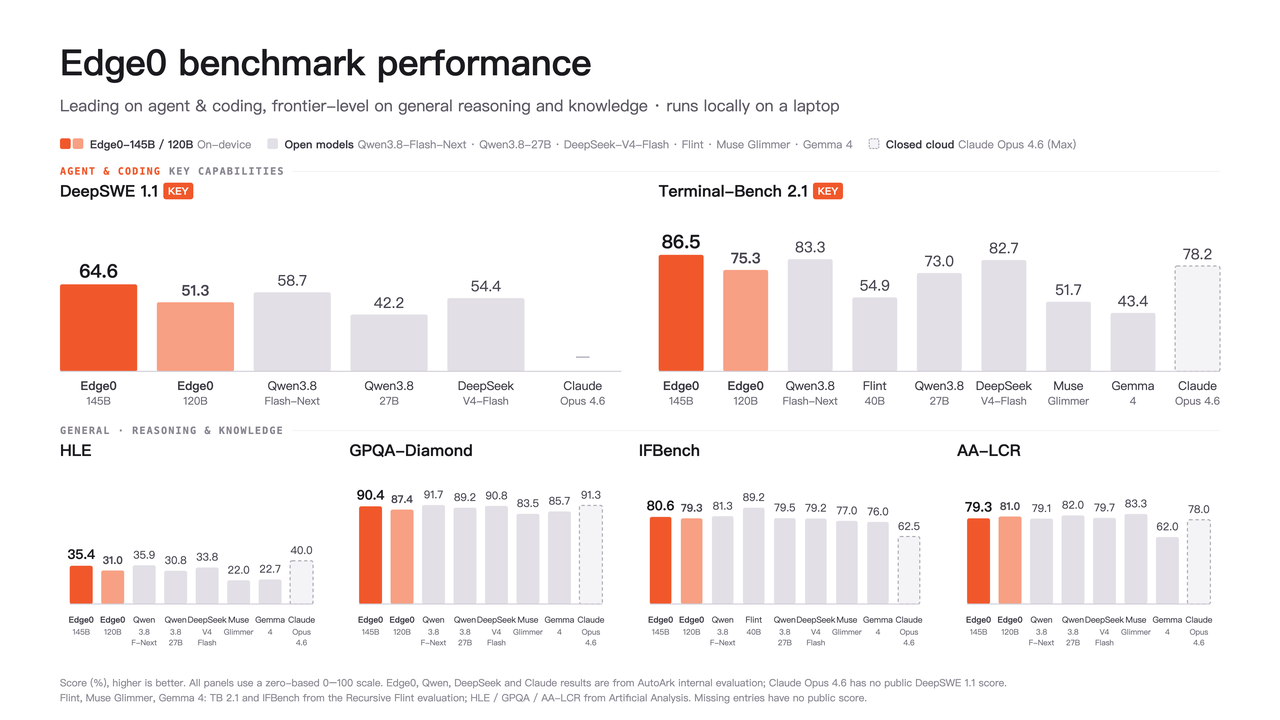
코딩: DeepSWE 1.1에서 64.6점을 기록하여 Qwen3.8-Flash-Next의 58.7점과 DeepSeek-V4-Flash-0731의 54.4점보다 앞섭니다.
추론 및 지식: GPQA-Diamond에서 90.4점을 기록하며, DeepSeek-V4-Flash-0731의 90.8점과 Claude-Opus-4.6 (Max)의 91.3점에 근접합니다.
명령어 따르기: IFBench에서 80.6점을 기록하여 DeepSeek-V4-Flash-0731의 79.2점과 Claude-Opus-4.6 (Max)의 62.5점보다 앞섭니다.
Terminal-Bench 2.1에서 기록한 86.52점은 Qwen3.8-Flash-Next의 83.3점, DeepSeek-V4-Flash-0731의 82.7점, Claude의 78.2점을 능가합니다. AA-LCR에서는 Edge0-145B가 79.3점을 기록하여 Claude의 78.0점보다 높습니다. 이 비교는 언급된 모델과 평가에 적용됩니다.
| Model | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.52 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 53.6 | 81.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| ... |
점수는 백분율이며, 높을수록 좋습니다. 대시(-)는 0점을 의미하는 것이 아니라 공개된 점수가 없음을 의미합니다.
Edge0, Qwen, DeepSeek, 그리고 Claude의 결과는 Edge0의 내부 평가에서 나온 것입니다. Claude-Opus-4.6은 공개된 DeepSWE 1.1 점수가 없습니다. Flint, Muse Glimmer, 그리고 Gemma 4에 대해서는 Terminal-Bench 2.1 및 IFBench 결과가 Recursive Flint 평가에서 나왔으며, HLE, GPQA, AA-LCR 결과는 Artificial Analysis에서 나온 것입니다.
주류 온디바이스 모델 기준선인 Qwen3.8-27B 대비 가장 큰 향상은 에이전트 및 코딩 작업에서 나타납니다: Terminal-Bench에서는 18.5%, **DeepSWE에서는 53.1%**의 향상입니다. HLE, GPQA, IFBench에서의 상대적 향상은 각각 14.9%, 1.3%, 1.4%입니다.
DeepSWE 1.1과 Terminal-Bench 2.1은 에이전트 및 코딩 작업을 평가합니다. HLE, GPQA-Diamond, 그리고 IFBench는 추론(reasoning), 지식(knowledge), 그리고 명령어 준수(instruction following)를 다룹니다. 전체 평가 설정, 하드웨어 환경, 재현 지침은 기술 보고서와 함께 공개될 예정입니다.
Image
더 작은 메모리 사용량으로 구현한 경쟁력
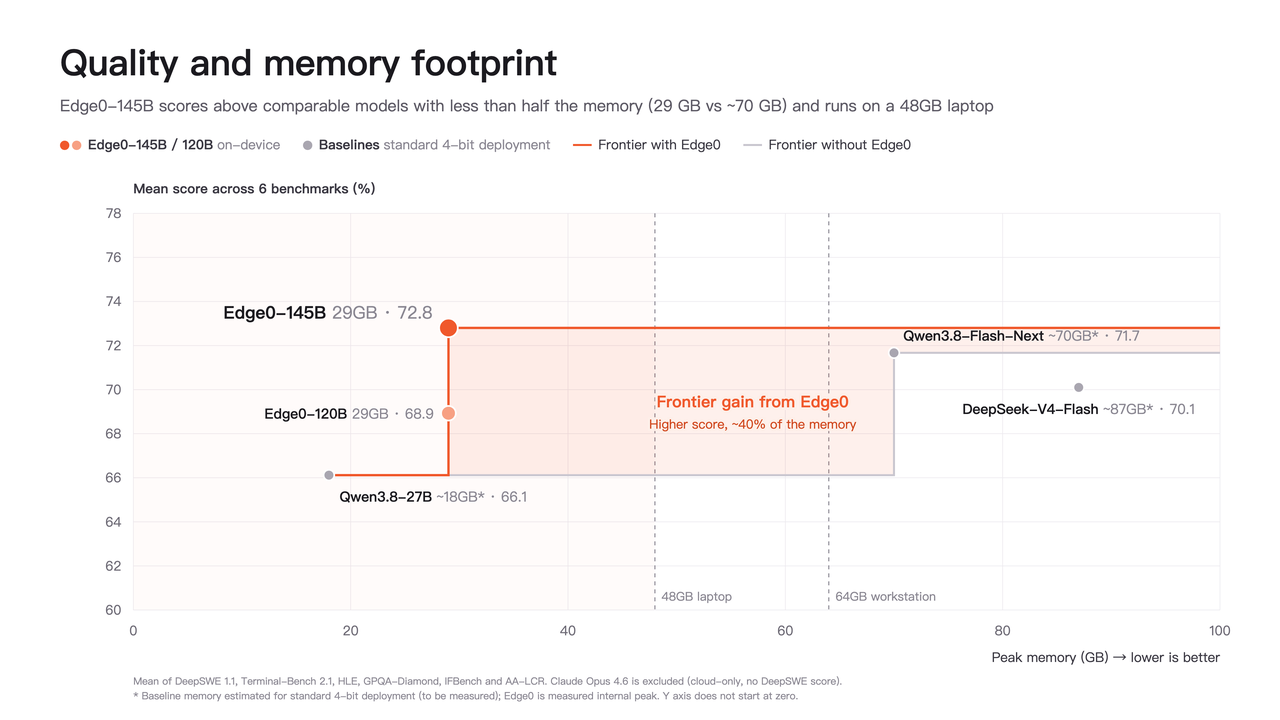
Edge0-145B는 6개 벤치마크 평균 점수 72.8점과 측정된 최대 메모리 29GB를 결합했습니다. Qwen3.8-Flash-Next는 평균 71.7점을 기록하며, 표준 4비트 배포 기준으로 추정되는 메모리 사용량은 70GB입니다. 이는 Edge0-145B가 추정 기준선 메모리의 약 40%에 불과한 수준에서 유사하거나 더 높은 성능을 제공하여, 48GB 노트북에서의 로컬 사용을 가능하게 함을 의미합니다.
모델별 성능 비교
| Model | 6개 벤치마크 평균 점수 | 메모리 사용량 (측정 또는 추정) |
|---|
| Edge0-145B | 72.8 | 29GB |
| Edge0-120B | 68.9 | 29GB |
| Qwen3.8-27B | 66.1 | 약 18GB* |
| Qwen3.8-Flash-Next | 71.7 | 약 70GB* |
| DeepSeek-V4-Flash-0731 | 70.1 | 약 87GB* |
평균 점수는 DeepSWE 1.1, Terminal-Bench 2.1, HLE, GPQA-Diamond, IFBench, AA-LCR을 포괄합니다. Edge0의 메모리 수치는 내부 최대 피크(internal peaks)를 측정하여 산출되었습니다. 별표(*)가 표시된 기준선 수치는 표준 4비트 배포에 대한 추정치이며 아직 측정이 이루어지지 않았습니다. Claude는 클라우드 전용 모델이고 DeepSWE 점수가 없기 때문에 제외되었습니다.
Image
[그림: 품질 대 최대 메모리 사용량 (Quality versus peak memory). 48GB 노트북 및 64GB 워크스테이션 용량이 표시되어 있습니다. 메모리가 낮고 점수가 높을수록 좋으며, 차트의 수직축은 0에서 시작하지 않습니다.]
계획하고, 코딩하고, 실행하며, 결과물을 확인하는 로컬 에이전트들
단 하나의 자연어 요청만으로도 전체적인 로컬 워크플로우를 시작할 수 있습니다. Edge0-145B는 요구사항을 세분화하고(break down), 단계를 계획하며, 코드를 작성하고, 도구를 호출하여 실행합니다. 무언가 실패하면 디버깅하고 코드를 수정합니다. 이후 스크린샷을 찍어 결과를 검사하고 작업이 완료될 때까지 반복적으로 개선해 나갑니다.
이러한 프로젝트들은 종종 수십 차례의 계획, 실행 및 검토 과정을 거칩니다. 로컬 추론(Local inference)은 이러한 추가적인 대화, 코드 수정, 시각적 분석 과정에서 해당되는 클라우드 모델 토큰이나 API 비용을 발생시키지 않는다는 의미입니다. 코드와 데이터는 컴퓨터에 보관될 수 있으며, 핵심 모델 기능은 오프라인에서도 작동합니다.
비디오 제작: 한 시간 내에 테슬라 로드스터 설명 영상 생성하기
Edge0-145B는 로드스터가 어떻게 비행할 수 있는지에 대한 설명을 제작하면서 기술 연구, 스크립트 작성, 에셋 생성 및 편집을 모두 처리했습니다. 우리는 이 모델에게 원리를 일반 대중도 이해할 수 있도록 만들어 달라고 요청했습니다. 이 모델은 클라우드 모델 호출이나 클라우드 토큰 소비 없이 로컬에서 실행되어 추론 과정에서의 네트워크 왕복(network round trips)이 필요 없었습니다.
영상은 한 시간 이내에 생성되었습니다. 유사한 결과물을 수동으로 제작하려면 감독, 각본가, 3D 모델러, 편집자, 물리학 전문가 등에게 한 달이 걸렸을 것입니다. AI 비디오 워크플로우는 이전에는 수백 달러 이상의 비용이 들 수 있었지만, 로컬 추론(local inference)을 사용하면 해당 클라우드 모델 토큰 및 API 수수료가 사라집니다.
3D 모델링: Blender를 사용한 맨해튼 도시 장면
Edge0-145B는 한 시간 이내에 맨해튼의 3D 장면을 구축했습니다. 텍스트와 참고 이미지를 사용하여 Blender에서 작업하며, 장면을 구성하고(constructed), 재질과 조명(materials and lighting)을 조정했으며, 렌더링된 결과물에 대해 반복적으로 개선했습니다(iterated).