
Deep Agents와 4배 향상된 유지율로 Harmonic의 Scout를 재구축하다
요약
Harmonic은 VC 소싱 도구인 Scout를 Deep Agents와 LangSmith를 활용하여 재구축했습니다. 이로써 제품 반복 주기가 단축되었으며, Scout는 단순한 검색 기능을 넘어 신뢰할 수 있는 자문가처럼 진화했습니다. 새로운 아키텍처는 글로벌 데이터 레이어와 기업별 컨텍스트에 접근하는 프론티어 모델을 통해 복잡하고 장기적인 작업을 수행합니다.
핵심 포인트
- Deep Agents 활용으로 제품 반복 주기가 몇 달에서 며칠로 단축됨.
- Scout V2는 단순 검색이 아닌, 투자 논제 기반의 자문가 역할 수행.
- 새 아키텍처는 글로벌 데이터와 개별 기업 컨텍스트를 통합 조회함.
- 에이전트 UX의 간극을 메우기 위해 시각적 결과물과 직관적인 채팅창 결합에 집중.
스타트업을 찾거나 조사해야 한다면 Harmonic이 적합한 곳입니다. 벤처 캐피탈(VC) 회사를 위한 소싱 도구로 설립된 이 플랫폼은 현재 사모 시장에서 발생하는 상황을 추적하는 다양한 투자자들을 지원합니다.
*Scout은 Harmonic의 AI입니다. 사용자들은 창립 팀의 배경 이해부터 특정 기술 분야의 펀딩 트렌드 분석에 이르기까지, Harmonic의 데이터를 질의할 수 있는 대화형 인터페이스입니다. Deep Agents와 LangSmith를 활용하여 Scout를 재구축한 결과, 제품 반복 주기가 몇 달에서 며칠로 단축되었고, 팀은 사용자에게
"이전에는 저희가 경직된 구조를 만들고, 평가(evals)를 작성하며, 모든 노드에 대해 지루하게 반복하는 데 많은 시간을 썼습니다. 이번 버전에서는 '최고의 가장 똑똑한 모델을 사용하고, 우리 데이터와 상호작용할 수 있는 사려 깊은 도구들에 접근하도록 하고, Deep Agents가 어떻게 작동하는지 보자'라고 생각했습니다. 그리고 즉시 놀라운 개선을 확인했습니다."
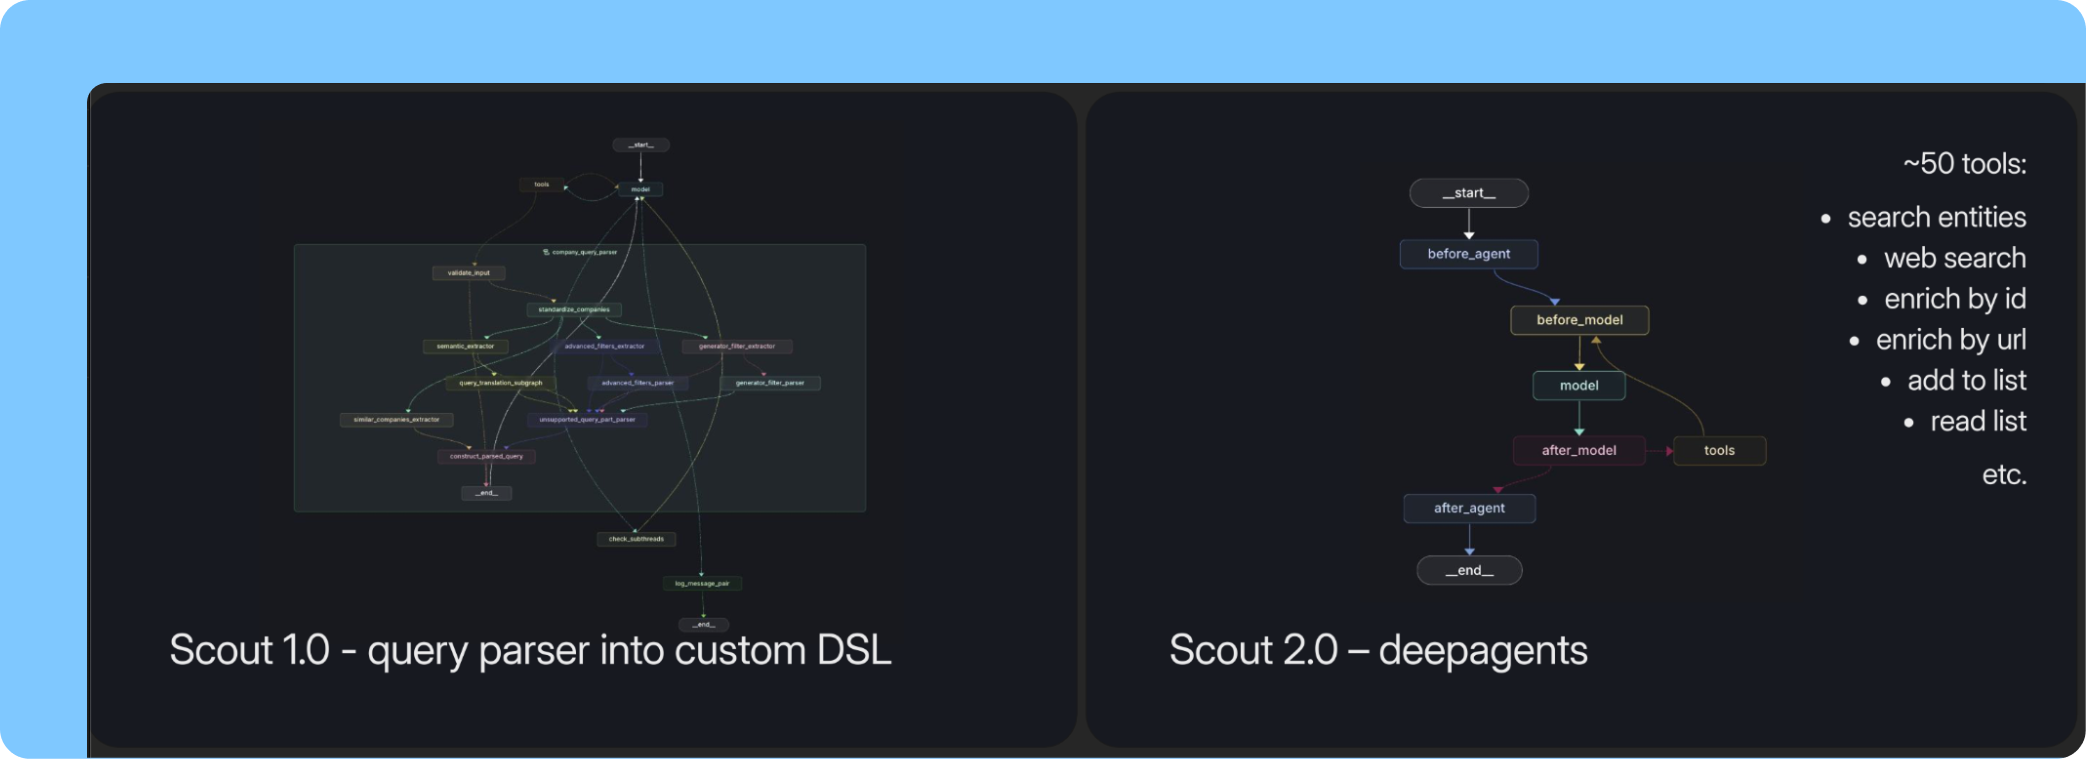
새로운 아키텍처는 의도적으로 단순합니다. Deep Agents 하네스 내의 단일 프론티어 모델이 두 가지 범주의 도구에 접근할 수 있습니다. 한 세트는 Harmonic의 글로벌 데이터 레이어(4,000만 개 회사, 2억 명 사람, 23만 개 투자자)를 조회합니다. 다른 세트는 파이프라인 목록, CRM 메모, 이전 이메일 및 LinkedIn 연결을 포함한 기업별 특정 컨텍스트에 접근합니다.
Deep Agents 하네스는 장기 지평(long-horizon) 작업 실행과 컨텍스트 창 관리(context window management)를 기본적으로 처리합니다. V1의 다중 그래프 파이프라인과 비교했을 때, 복잡도가 훨씬 낮습니다.
"모델은 막다른 길에 부딪히지 않을 수 있는 에이전시(agency)를 가지고 있습니다. 저희는 그래프가 가능한 한 단순하게 유지되도록 항상 스스로 점검합니다."라고 Harmonic의 프로덕트 매니저인 Seth Wieder가 강조했습니다.
팀은 이전에 80%의 좋은 Scout 결과율을 목표로 하는 내부 OKR을 유지했었습니다. 그 'Scoutcome' 지표는 더 이상 적극적으로 논의되지 않으며, 일관된 품질이 이제 기본값입니다.
UX: 검색 도구에서 신뢰할 수 있는 자문가로
Scout V1은 대부분의 데이터 도구가 작동하는 방식대로 작동했습니다. 사용자는 검색어를 입력하고, 목록을 검토하며, 다듬고, 반복했습니다. Scout V2는 검색 상자라기보다는 신뢰할 수 있는 자문가처럼 기능합니다. 투자 논제(investment thesis)를 전달하고 그것과 일치하는 다섯 개 회사를 선택해달라고 요청할 수 있습니다. "10분 후에 이 창업가를 만납니다. 제가 알아야 할 모든 것을 말해주세요"라고 말하면, Scout는 사용자의 CRM, 이전 이메일, LinkedIn 연결 및 회사의 공개 프로필에서 정보를 가져와 전체 기록 시스템(system of record)에 걸쳐 종합합니다.
Scout V2는 에이전트 사용자 경험(UX)의 핵심적인 긴장 관계를 해결했습니다. Austin이 말했듯이, "에이전트는 코드로 느껴지는 것을 좋아하지만, 사용자는 코드로 느껴지는 것을 싫어합니다." 프론티어 모델(frontier model)이 시각적 결과물로 자연스럽게 출력하는 것은 구조화되고 기술적입니다 (예: SVG, HTML, JSON). 하지만 사용자들은 풍부하고 직관적인 요소가 담긴 깔끔한 채팅창을 기대합니다. 이 둘 사이의 간극을 메우려면, Scout가 생성하는 모든 결과물에 대해 그것이 어디에 위치해야 하는지, 누가 볼 수 있는지, 그리고 모델이 사용자가 무엇을 보고 있는지 계속 인지할 수 있도록 어떻게 해야 할지를 결정해야 합니다.
팀의 디자인 규칙은 다음과 같았습니다. 사용자가 보는 모든 것은 모델이 발견할 수 있어야 한다. 그렇지 않으면 에이전트는 사용자가 후속 질문을 하는 순간 맥락을 잃게 됩니다.
예를 들어, 시각화와 회사 검색을 살펴보겠습니다.
시각화 (Visualizations)
테스트 초기에 한 사용자가 Scout에게 시각적인 시장 지도를 요청했고, 팀은 이 요청이 거부될 것이라고 예상했습니다. 하지만 Scout는 프론트엔드가 직접 렌더링할 수 없는 SVG 코드를 반환했습니다. 팀은 이것을 실패 모드(failure mode)가 아닌 의도적인 기능으로 전환하는 방법을 알아내는 데 집중했습니다.
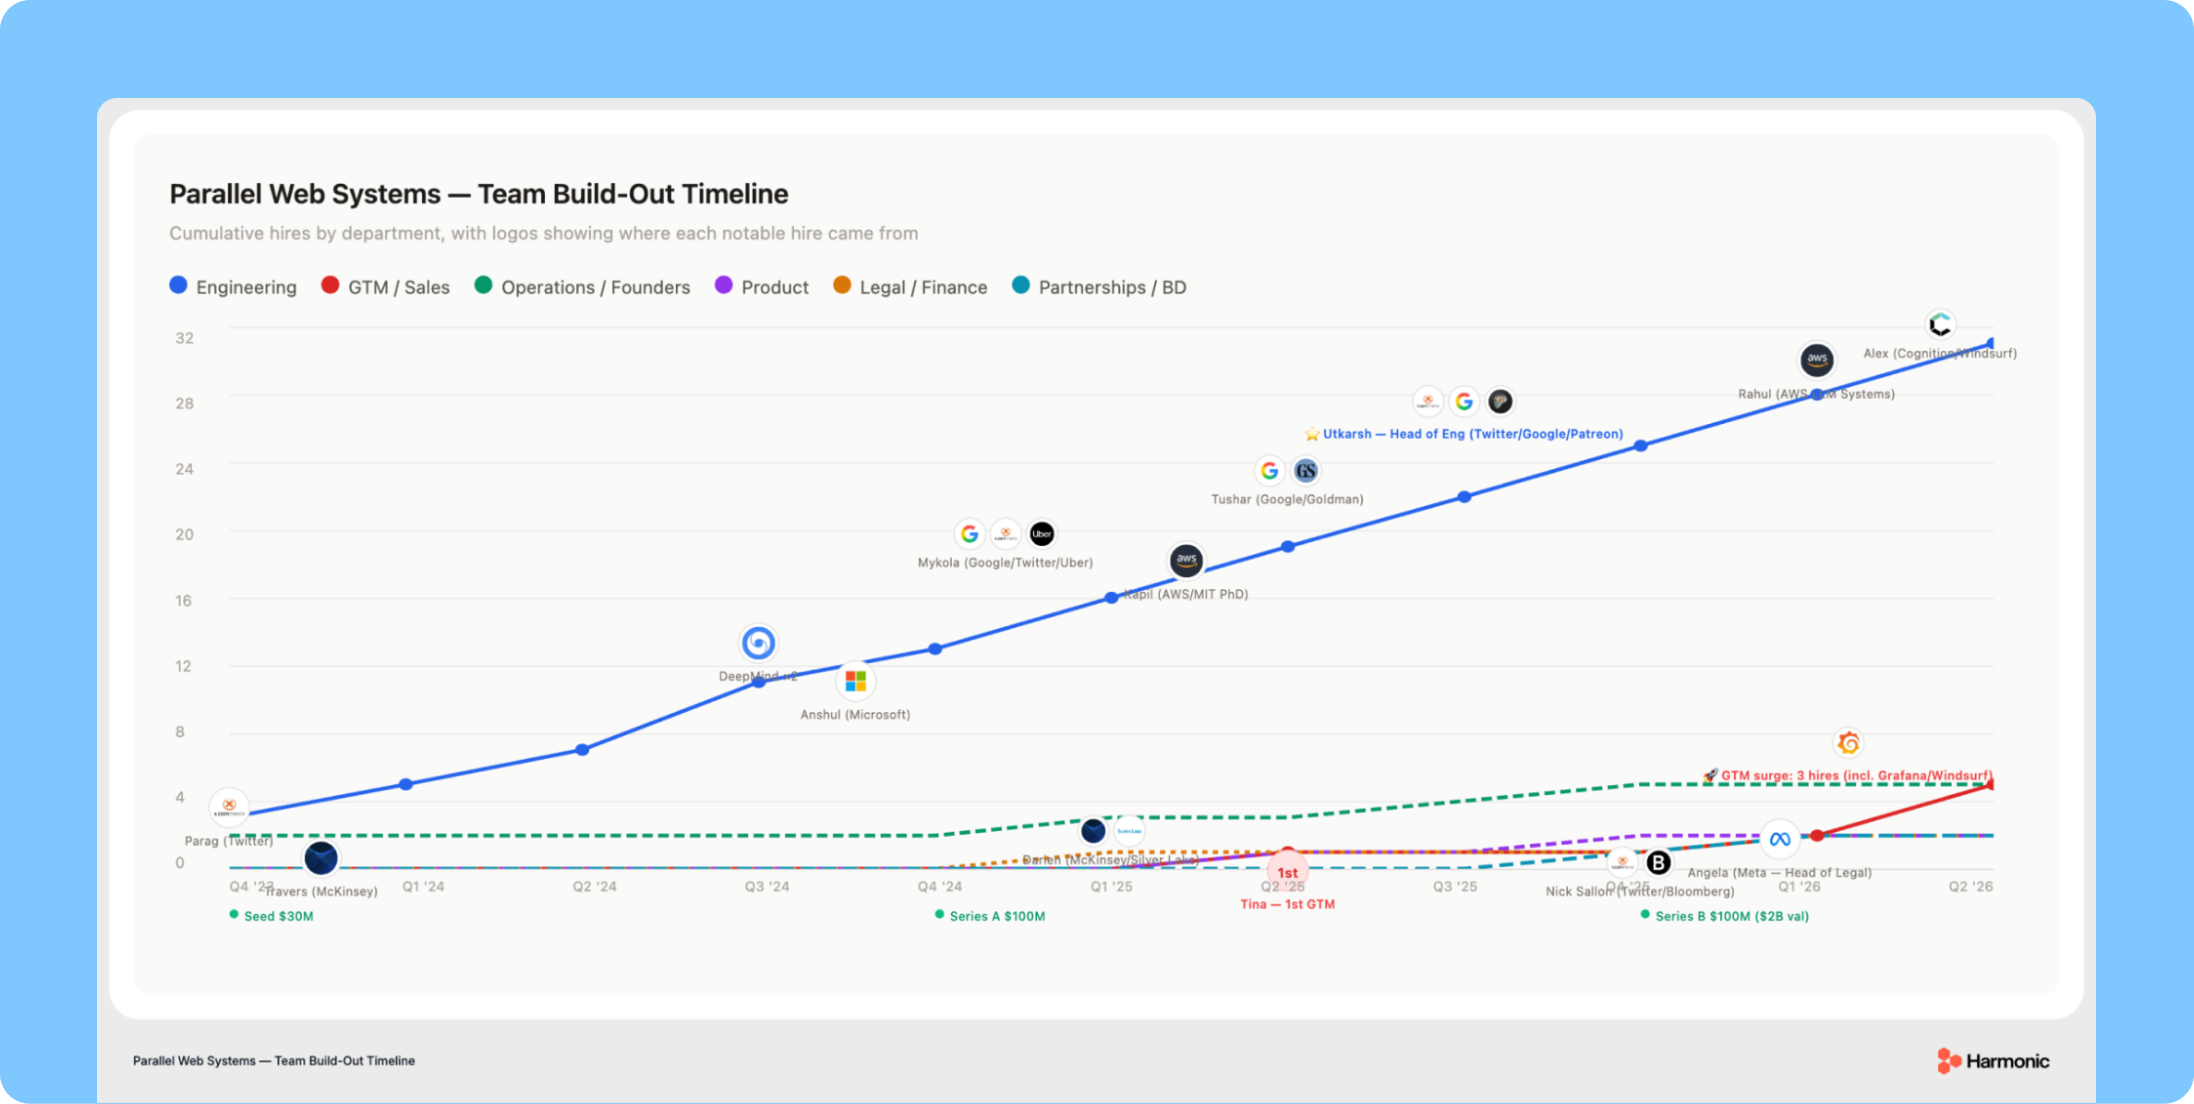
이제 시각화는 Scout 대화에서 일급 원시 요소(first-class primitive)가 되었습니다. 모델이 메시지의 일부로 시각화를 인라인으로 작성하고, 프론트엔드가 그 자리에 렌더링합니다. 모델과 사용자 모두 동일한 결과물을 같은 대화에서 보게 됩니다. 팀은 차트 기능이나 타임라인 기능, 또는 시장 지도 기능을 따로 설계할 필요가 없었습니다. (회의 준비, 리서치 보고서, 팀 구축 타임라인)라는 패턴이 반복되는 이유는 에이전트와 UX가 하나의 진실 공급원(source of truth)을 공유하기 때문입니다.
회사 검색
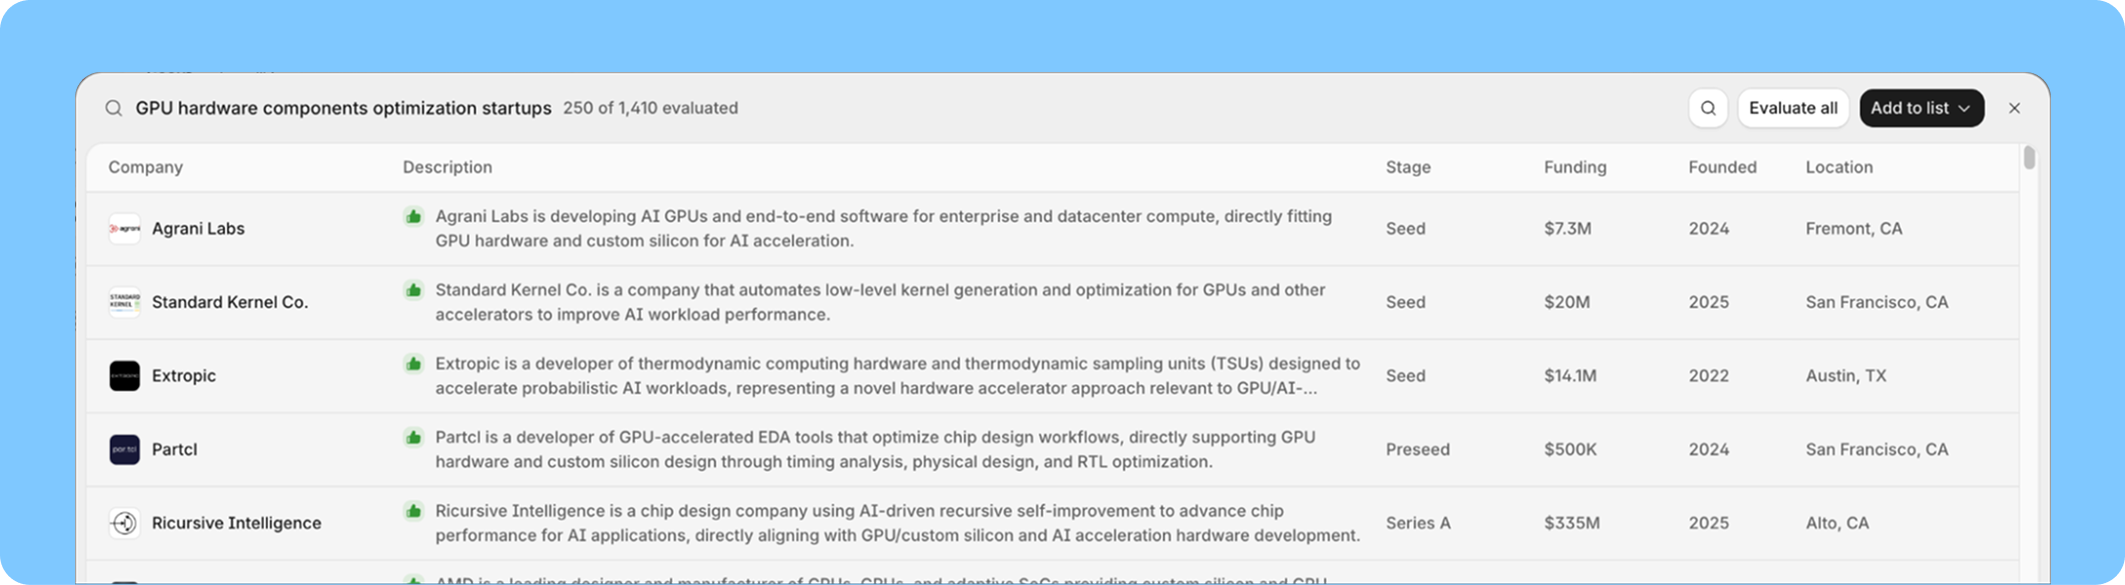
사용자들은 Scout가 한 번에 수천 개의 회사에서 검색하기를 원합니다. 이는 채팅 메시지로 스트리밍할 수 있는 양보다 훨씬 많습니다. 이전에 Scout가 검색을 실행하고, 결과를 사이드 패널에 렌더링한 다음 넘어가는 방식은 사용자가 '맨 위에 있는 세 곳은 왜 그런가요?'라고 물어보는 순간 무너집니다. 모델은 결과 집합(result set) 자체를 본 적이 없기 때문에 답변할 수 없습니다. Scout는 이 문제를 해결하기 위해 결과를 에이전트가 필요할 때 읽을 수 있는 공유 파일 시스템에 작성하고, 사용자가 보고 있는 것과 동일한 데이터를 페이지 넘길 수 있게 해주는 도구와 결합했습니다. 프론트엔드는 결과가 도착하는 대로 행(row)을 렌더링합니다. 모델은 대화에서 필요로 할 때 그중 어떤 것이든 다시 살펴볼 수 있습니다.
공유 파일 시스템 디자인을 사용함으로써, Scout는 모든 사용 사례에 대해 맞춤형 워크플로우를 구축할 필요가 없습니다. Austin은 '모든 개별 사용 사례나 고객을 위해 고유한 워크플로우 경험을 구축할 필요가 없다는 것은 엄청난 돌파구입니다'라고 언급했습니다.
제품 개발 시사점과 관련하여 Seth는 다음과 같이 덧붙였습니다:
"Scout 이전에는 우리가 사용자들이 제품과 상호작용하는 방식을 예상해서 구축했습니다. 우리는 기능 요청을 받고, 우선순위를 정하고, 트레이드오프를 했습니다. 이제 이 에이전트 모델에서는 사용자에게 원하는 방식으로 데이터와 상호작용할 수 있는 능력을 부여하고, 그들이 어떻게 사용하는지 관찰합니다. 매일 새롭게 발생하는 사용 사례(emergent use cases)를 발견합니다."
LangSmith 배포 환경에서 Scout 운영하기 (Running Scout in Production on LangSmith Deployment)
Scout을 만든 팀은 규모가 작고 제품에 집중하고 있습니다. LangSmith Deployment는 지속적인 스레드 실행(durable thread execution)을 위한 플랫폼 계층, 사용량 증가에 따라 무한히 확장 가능한 안정적인 배포, 그리고 관측 가능성(observability)을 관리합니다. Austin은 이를 '설정 후 잊어버릴 수 있는(set and forget)' 것이라 설명하며, 팀이 Harmonic의 제품을 차별화하는 요소(글로벌 회사 및 인물 데이터와 귀사의 컨텍스트 및 연결 정보 결합)를 위한 인터페이스 구축에 집중할 수 있게 해준다고 말했습니다.
반복 작업을 위해 팀은 전체 대화 추적(conversation traces)을 표시하는 내부 대시보드를 구축하여 엔지니어들이 사용자가 본 모든 것, 생성된 아티팩트(artifacts)를 포함하여 정확히 무엇을 보는지 확인할 수 있게 했습니다. 그들은 또한 AI 코딩 도구와 함께 LangSmith MCP를 사용합니다:
"LangSmith 추적을 가져와서 그것이 실행되는 코드와 어떻게 상호작용하는지 보고, 실제로 무슨 일이 일어나고 있는지에 근거하여 변경 사항을 만들 수 있습니다. 느슨한 자기 개선 루프가 존재합니다: 변경 사항을 만들고, 그래프를 실행하고, 추적을 확인하고, 그 추적을 다시 가져옵니다."
LangSmith Engine의 초기 도입자로서, 팀은 또한 Engine이 실패 모드(failure modes)를 식별하고 클러스터링하며, 현장에서 코드 개선 및 평가(evals)를 제안함으로써 더욱 명시적인 자기 개선 루프의 이점을 얻습니다:
"저희 Deep Agents 추적에는 수십 개 또는 수백 개의 턴이 포함될 수 있어 검토하고 패턴을 식별하는 것이 지루합니다. LangSmith Engine은 단순히 나타나는 실패 모드를 식별할 뿐만 아니라, 이를 신속하게 해결하기 위한 평가 및 코드 변경 사항을 사전에 제안함으로써 저희 팀의 몇 시간을 절약해 줍니다."라고 Austin이 말했습니다.
Deep Agents로 전환하여 유지율 4배 향상
사용자들의 반응은 비범했습니다. 투자자들은 Scout를 "믿을 수 없을 만큼 도움이 된다," "천국 같다," 그리고 "게임 체인저"라고 설명합니다. 더욱 의미심장한 것은 한 초기 단계 파트너가 다른 회사들과 비교하며 관찰한 내용인데, "모두의 비밀 병기가 Scout가 되어가고 있다"는 것이며, 투자자들은 동료들과 필수 기능을 논의할 때 Scout가 업계 표준이 되어가고 있음을 인식하고 있습니다.
이러한 입소문 피드백은 사용량 지표에 반영되었습니다: Scout 사용자들의 주차별 유지율(week-one to week-four retention)이 V1일 때보다 4배 증가했습니다. 또한, 사용자들이 일회성 회사 검색 대신 더 길고 다단계의 대화를 진행함에 따라 Scout 사용자의 평균 세션 지속 시간은 10배* *증가했습니다.
다음 단계: 더 큰 TAM
Scout이 제공하는 가치는 이제 Harmonic이 신흥 시장으로 확장할 수 있게 합니다. Scout은 독특한 스타트업 데이터베이스 덕분에 스타트업에 관한 모든 질문에 답할 수 있으며, 이는 투자 외의 사용 사례를 열어줍니다. 혁신 및 기업 개발팀(Innovation and Corporate Development teams), 인재팀(talent teams), 리크루터, 그리고 스타트업을 대상으로 판매하는 GTM팀은 Scout을 사용하여 최신 정보를 파악하고 있습니다. 또한 Harmonic 팀은 스타트업에 기회를 제공하겠다는 사명에 대해 여전히 큰 기대감을 가지고 있습니다.
자체 독점 데이터 계층(proprietary data layer) 위에 프로덕션 에이전트를 구축하고 싶으신가요? Deep Agents에 대해 알아보거나 문서를 읽어보세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기