
Cerebras, 'Nexus' CS-4에 탑재할 WSE-3 웨이퍼스케일 엔진 오버클럭 공개
요약
Cerebras Systems가 최신 시스템 'Nexus' CS-4를 출시하며 WSE-3 웨이퍼스케일 엔진의 오버클럭 버전을 탑재합니다. 이 새로운 'WSE-3 Turbo'는 이전보다 두 배의 작업을 수행할 수 있으며, 2.8 GHz까지 클럭 속도가 증가했습니다. 전력 및 냉각 기술 향상 덕분에 컴퓨팅 성능을 크게 끌어올렸습니다.
핵심 포인트
- CS-4 시스템은 WSE-3 엔진의 오버클럭 버전인 'WSE-3 Turbo'를 탑재합니다.
- 새로운 터보 엔진은 이전 대비 두 배의 작업 처리 능력을 갖추고 있습니다.
- 2.8 GHz까지 클럭 속도가 증가했으며, 이는 전력 및 냉각 기술 발전에 기인합니다.
- 웨이퍼 규모의 컴퓨팅 아키텍처가 여전히 최첨단 모델 추론에 중요함을 강조했습니다.
COMPUTE
Cerebras가 'Nexus' CS-4의 추론 성능을 높이기 위해 WSE-3 웨이퍼스케일 엔진 오버클럭 적용
오랫동안 Nvidia와 AI 컴퓨팅 분야에서 경쟁하기 위해 노력해 온 2세대 AI 하드웨어 스타트업 중 하나인 Cerebras Systems가 최신 시스템인 CS-4를 이번 여름에 출시할 것이라는 기대를 받아왔습니다.
저는 2025년 10월, 회사가 상장하기 전이었고 Cerebras가 2026년에 상장할지조차 불분명했을 때 보유했던 11억 달러 규모의 자금 조달 라운드를 고려하며 CS-4 발표를 2026년 8월로 예측했었습니다. 예측을 하고 맞히는 것은 언제나 기분이 좋습니다.
Cerebras가 새로운 시스템과 이를 감싸는 새로운 랙 디자인인 CS-4 시스템, 코드명 'Nexus'를 출시하는 것은 맞지만, 예상하셨거나 제가 지난 10월에 Cerebras 로드맵에서 나올 것이라 생각했던 것처럼 새로운 WSE-4 컴퓨팅 엔진을 출시하는 것은 아닙니다.
알려진 바에 따르면, CS-4 머신에는 현재의 WSE-3 웨이퍼스케일 컴퓨팅 엔진의 오버클럭 버전이 탑재되며, 코어 수는 정확히 90만 개, 온-웨이퍼 SRAM 용량은 정확히 44GB로 유지됩니다. 또한 대만 반도체 제조사(Taiwan Semiconductor Manufacturing Co.)의 동일한 5나노미터 공정으로 제작되었습니다. 사실 저는 이 프로세스 노드가 Cerebras가 WSE-3 엔진을 처음 제공했던 2024년 3월보다 2026년에 훨씬 성숙했기 때문에, TSMC가 N5 계열 칩 식각의 향상된 버전을 사용하고 있다고 추측합니다. 이는 Cerebras와 고객들에게 좋은 소식입니다.
마찬가지로, 새로운 컴퓨팅 엔진인 'WSE-3 Turbo'가 오버클럭되었으며, 이 엔진은 이전 버전보다 두 배의 작업을 수행할 수 있는 능력을 갖추고 있습니다. 이는 2년 이상 전에 Cerebras가 웨이퍼의 코어와 SRAM을 오버클럭하지 않은 이유에 대한 의문을 제기합니다. 제가 추측하기로는, 현재 WSE-3 일반 엔진에서 사용된 1.4 GHz에서 두 배로 증가한 2.8 GHz까지 이 클럭 속도를 구동하는 전력 및 냉각 기술이 아직 갖춰지지 않았기 때문인 것 같습니다.
CS-4 시스템의 경우, 컴퓨팅 웨이퍼 자체는 본질적으로 동일하지만, 웨이퍼 패키징을 통해 두 배의 전력이 공급되고, 2배의 클럭 속도 증가를 구동하고 웨이퍼에서 마법 같은 푸른 연기가 나오는 것을 막기 위해 그보다 약간 더 많은 냉각이 이루어집니다.
다음은 네 세대에 걸친 CS 시스템의 성능과 속도입니다:
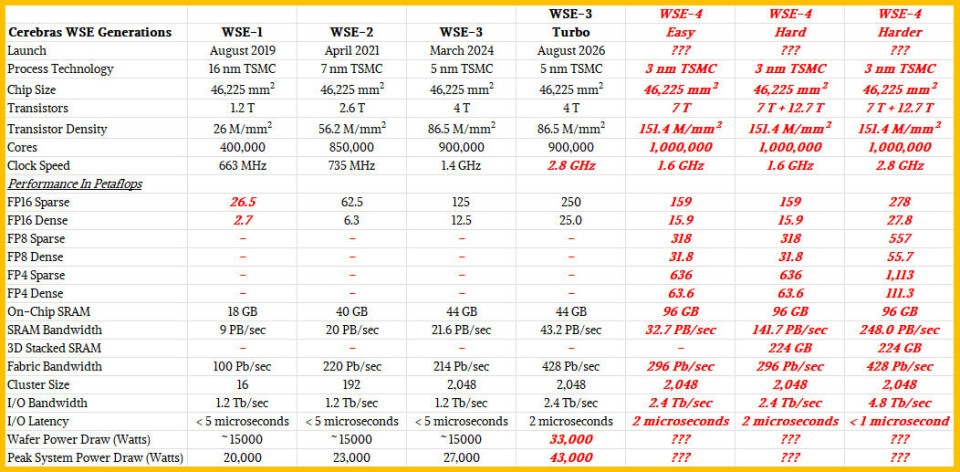
재미로 작년에 이 CS-4 시스템에 사용될 미래의 WSE-4 컴퓨팅 엔진이 어떻게 보일지 추측해 봤습니다. CS-4 Plus 또는 CS-5는 실제로는 WSE-3나 WSE-3T와 다른 WSE-4 엔진을 탑재할 것 같습니다. 저는 작년 가을에 제시했던 기본적인 전제, 즉 웨이퍼 규모의 엔진은 SRAM 용량에 의해 제한된다는 주장을 고수합니다. 이것이 바로 최첨단 모델 추론(inference)을 실행하기 위해 여러 대의 CS-2와 CS-3가 필요했던 이유입니다. 이제는 수십 대의 CS 머신, 어쩌면 그 이상이 필요할 것입니다. 이번에는 WSE-4 Harder 옵션을 추가하여 클럭을 WSE-3 Turbo가 작동하는 것으로 생각하는 2.8 GHz까지 끌어올리고, I/O 서브시스템의 대역폭도 두 배로 늘려 100만 개의 코어를 320 GB의 SRAM과 더 잘 균형 있게 맞추었습니다. 이는 컴퓨팅 장치에서 멀리 떨어진 320 GB의 HBM 메모리보다 훨씬 나은 성능이며, 총합적으로 248 PB/sec의 대역폭을 제공합니다.
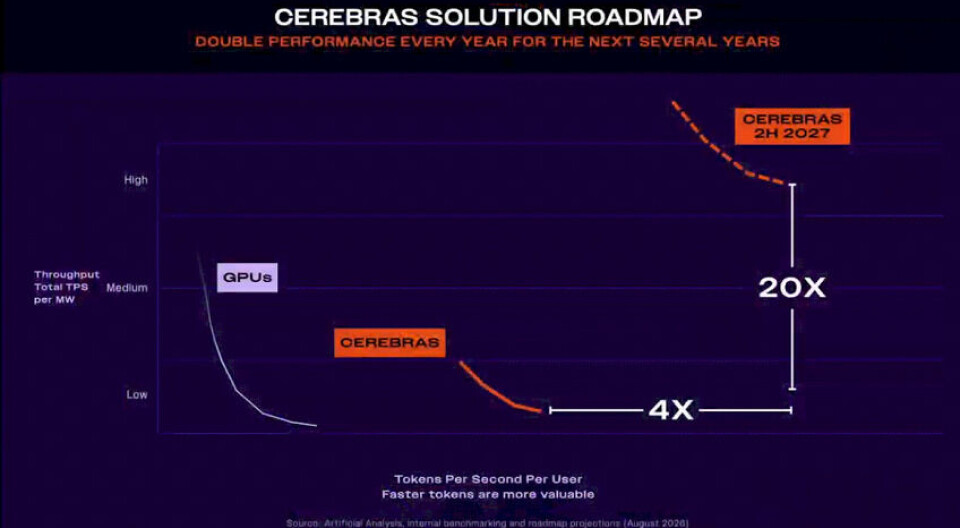
저는 Cerebras에 대해 높은 기대를 가지고 있습니다. 물론 그 고객들과 회사의 엔지니어들, 그리고 이러한 차트를 제시한 최고 경영진 역시 마찬가지입니다. 이 차트들은 느슨하게 로드맵이라고 불릴 수 있습니다. 첫 번째는 회사 공동 창립자이자 최고 경영 책임자인 Andrew Feldman이 발표했습니다:
그리고 공동 창립자이자 최고 기술 책임자인 Sean Lie가 발표한 내용입니다:
Nexus 랙은 백팩 컴퓨트 노드 디자인을 채택하여 최소 세 세대에 걸쳐 사용될 것이며, Cerebras는 지금부터 2029년까지 매년 해당 시스템의 처리량(throughput)을 2배로 높일 것을 약속할 것입니다. 이는 무어의 법칙 개선보다 상당히 빠른 속도입니다. 저는 그들이 최고 성능(peak performance)을 의미하는지 아니면 실효 성능(effective performance)을 의미하는지 궁금합니다.
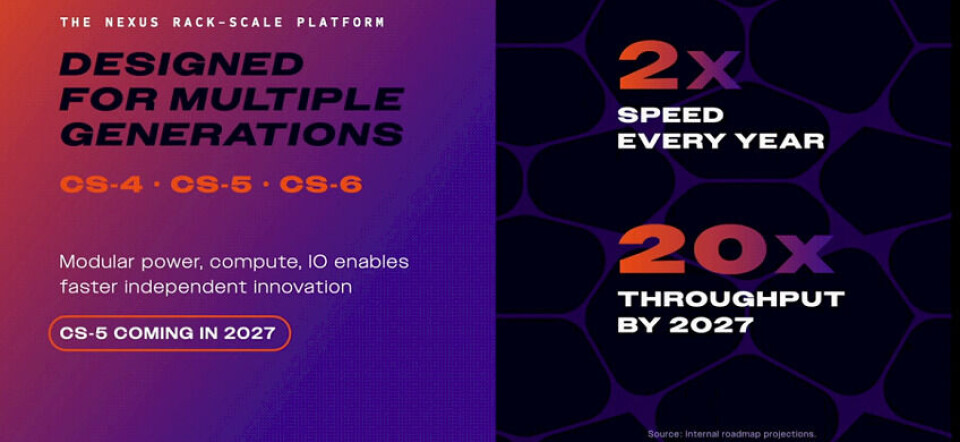
후자가 더 가능성이 높습니다. 예를 들어, SRAM 용량을 컴퓨팅 대비 늘려 코어들이 현재 할 수 있는 것보다 훨씬 많은 작업을 수행하도록 만드는 것입니다. 왜냐하면 이 코어들은 GPU처럼 용량 부족(starving for capacity)을 겪고 있기 때문입니다. 저는 WSE-3 코어가 SRAM의 대역폭(bandwidth)을 포화시키기에는 전혀 근접하지 못했다고 강력히 의심하며, WSE-3 Turbo로 두 배가 되었을 때도 마찬가지입니다. 결국 Cerebras는 컴퓨팅에 최소한 맞는 용량을 확보하기 위해 3D SRAM 스태킹으로 가야 할 것입니다. 코어 수를 줄이고 SRAM 용량은 그대로 두거나 웨이퍼 단위로 늘리는 것은 마케팅 관점에서 받아들이기 어렵습니다. 이는 기본적으로 더 많은 장치를 판매하기 위해 메모리 용량을 과소평가했고 그것을 알고 있었다는 것을 인정하는 것과 같습니다. (Nvidia와 AMD GPU 가속기의 경우와 같습니다.)
Nexus 랙스케일 시스템, 분해 분석
새로운 Nexus 랙이야말로 CS-4 시스템에서 정말 흥미롭고 혁신적인 부분이며, Cerebras가 클럭을 높이는 것만으로 웨이퍼 컴퓨트 엔진에서 2배의 작업을 얻어낼 수 있다면 괜찮습니다. 한 번은요. 그 이후부터는 이 새로운 상한선 이하로 클럭 속도를 낮추기가 어려울 것입니다.
Nexus 노드 설계가 컴퓨팅 웨이퍼와 호스트 CPU(AMD의 Epyc CPU)를 전원 공급 장치 은행 및 네트워크 인터페이스에서 분리한 데에는 여러 이유가 있을 수 있지만, 가장 큰 이유는 이제 시스템의 이 세 가지 다른 부분을 독립적으로 업그레이드할 수 있다는 것입니다. NIC 모듈성은 Cerebras가 파트너인 OpenAI와 Amazon Web Services에게 WSE 엔진에 자체 선택한 NIC를 부착하여 추론 과정의 prefill 부분뿐만 아니라 GenAI 모델 훈련을 위해 사용하는 GPU 및 XPU와 연결할 수 있도록 허용할 것입니다.
Nexus 랙은 다음과 같습니다:
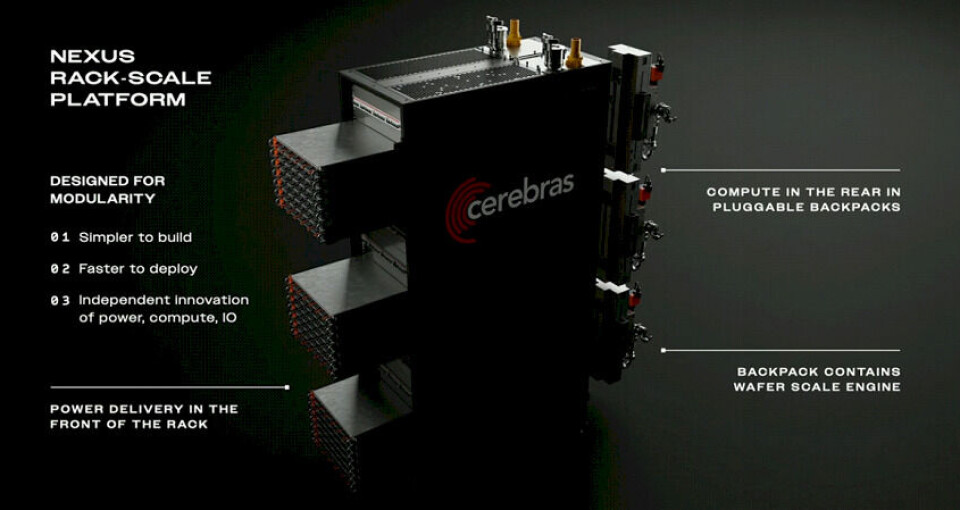
Nexus 랙에는 전면에 세 개의 파워 쉘프(power shelves)와 후면에 파워 쉘프에 플러그인되는 세 개의 CS-4 컴퓨트 백팩이 있습니다. 이 백팩은 수직으로 배치된 모듈형 서버이며, Cerebras에 따르면 이 장비의 설계는 제조 자동화가 60% 더 높습니다. Nexus 랙은 이전 시스템인 CS-1부터 CS-3 머신(각 랙당 하나의 16U 섀시에 WSE와 호스트가 포함됨)보다 랙당 컴퓨팅 성능이 세 배에 달합니다. 이론적으로는 스케일 아웃 네트워킹 및 스토리지를 위한 공간을 두고 두 개를 랙에 배치할 수 있습니다만, 냉각이 가능하다는 전제 하에 말입니다.
Lie의 말에 따르면 중요한 점은 Nexus 랙이 대규모 클러스터에 최적화되어 있으며 구성 요소가 50% 적고 이전 Cerebras 시스템보다 최대 3배 빠르게 배포될 수 있다는 것입니다.
Nexus 랙 후면에서 분리된 백팩 이미지는 다음과 같습니다:
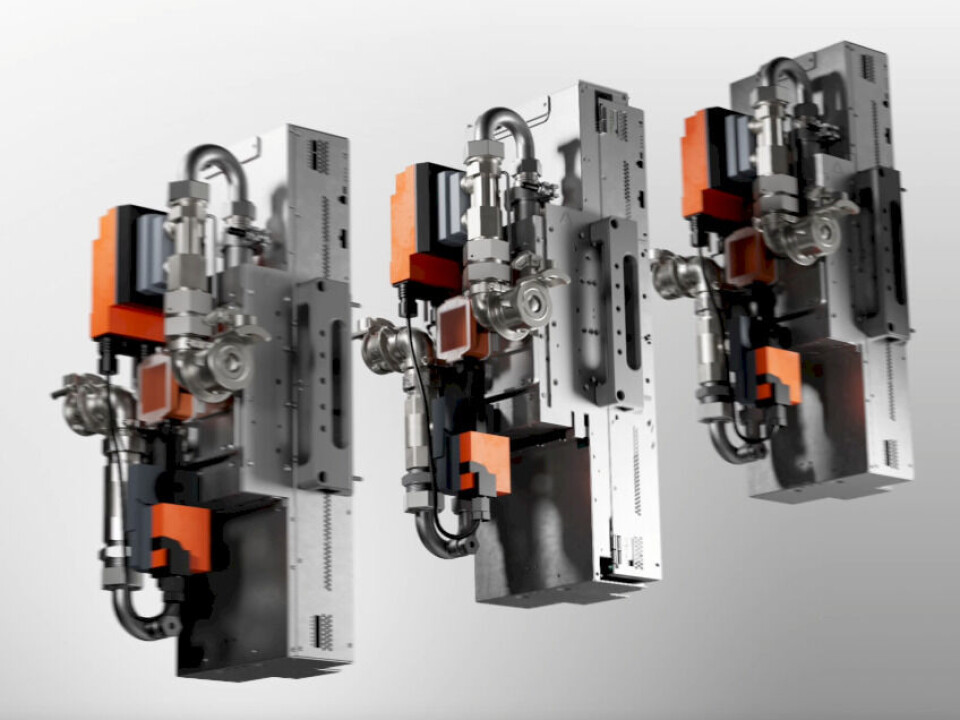
참고: 이들은 스프링 장착되어 있지 않으며, 무게가 대략 100파운드에 달하는 서버 컴퓨트 복합체가 랙에서 갑자기 튀어나오지는 않을 것입니다.
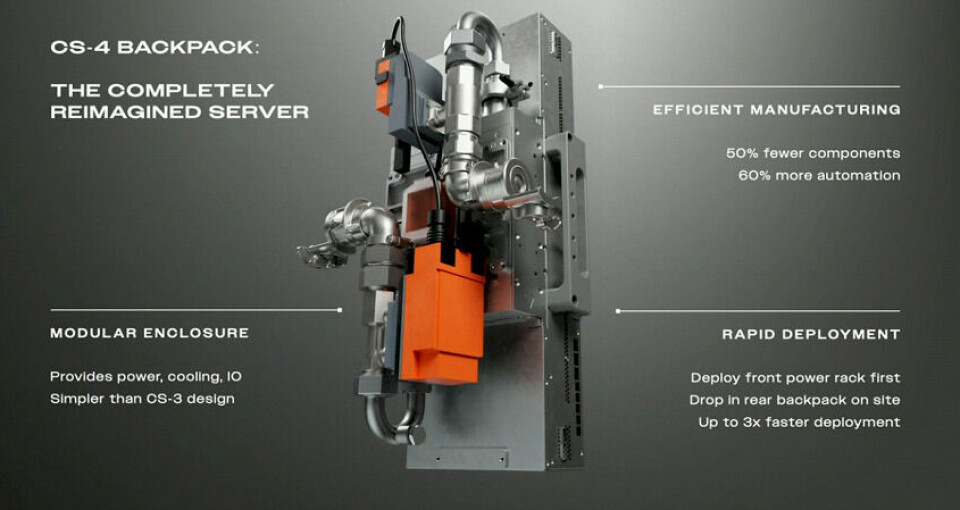
Lie는 백팩의 아이디어 배경에 대해 설명하며, Cerebras가 Nexus 랙과 전원 선반을 가져와 고객에게 배송하고, 모든 것이 준비되면 SWE 백팩을 별도로 배송할 수 있다고 말했습니다. 어떤 이유에서인지 이것이 시간을 절약해 주는 것 같습니다. 이는 확실히 들어오는 공급망 부품과 고객에게 나가는 출하물 사이에 Cerebras에 어느 정도의 유연성을 제공합니다.
다음은 CS-4 백팩의 분해도입니다:
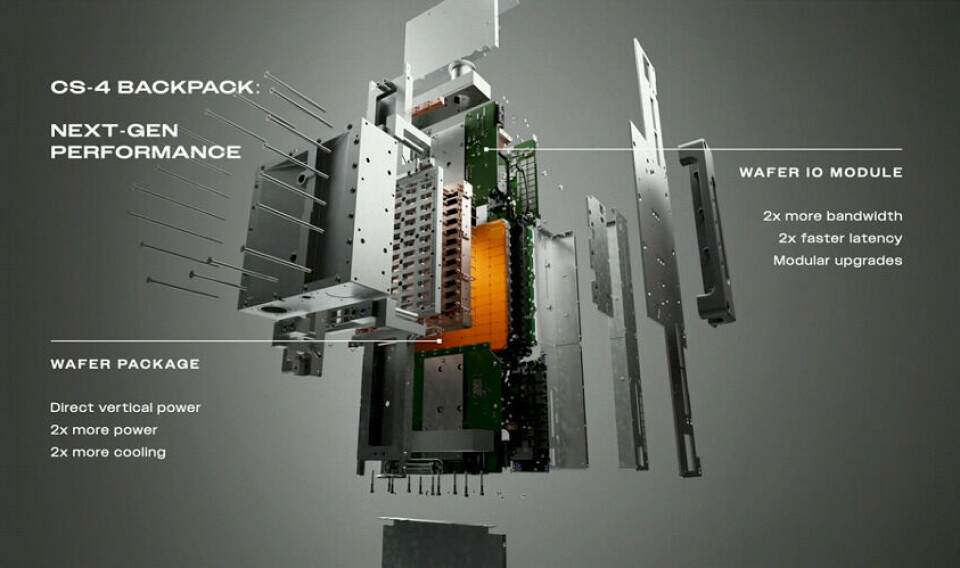
이 이미지의 뒷부분에는 전원 모듈이 있고, 그 위에 WSE-3 Turbo 모듈이 놓여 있으며, 여기에 일련의 나사들이 복합체를 모두 고정하는 냉각 플레이트가 있습니다.
백팩 위에서 네트워크 인터페이스 카드(NIC) 두 개를 볼 수 있는데, 하나는 상단에, 다른 하나는 하단에 있습니다. “새롭고 더 높은 속도의 웨이퍼 링크”라고 명시된 사양을 바탕으로 볼 때, 이 웨이퍼 I/O 모듈은 200 Gb/sec로 작동하는 여섯 개의 이더넷 포트를 가지고 있는 것 같습니다. 이는 이전 CS-1부터 CS-3 시스템에서 사용되던 100 Gb/sec I/O 모듈의 포트당 대역폭보다 두 배 높은 수치입니다. 이전 시스템은 단 하나의 이더넷 I/O 패브릭 인터페이스만 가졌거나, 아예 두 개를 가지고 있었을 수도 있습니다. 사양서와 발표 자료에서는 이 부분에 대해 명확하지 않았습니다.
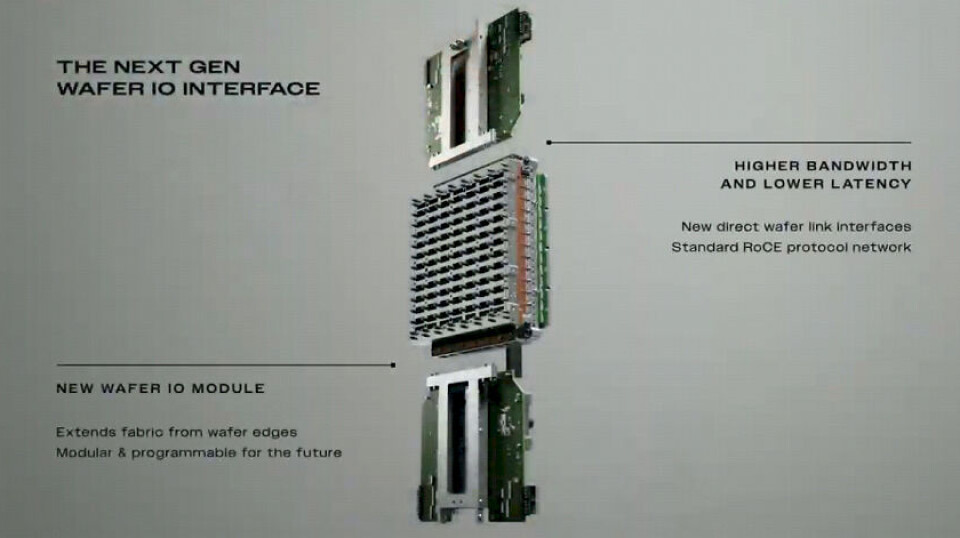
NIC에서 2배의 radix 증가가 있다면, 이는 Cerebras가 단일한 데이터 병렬 클러스터 내에서 CS-4 시스템 간 네트워킹을 2,048 노드라는 상한선을 넘어 확장할 수 있음을 의미해야 합니다. 하지만 저희는 토폴로지나 NIC의 radix와 상관없이 Cerebras가 2,048 노드를 초과하여 지원하지 않을 것이라고 생각합니다.
저희는 이러한 네트워크 세부 사항들을 확인하기 위해 Cerebras 측에 여러 번 문의했지만 아직 답변을 받지 못했습니다.
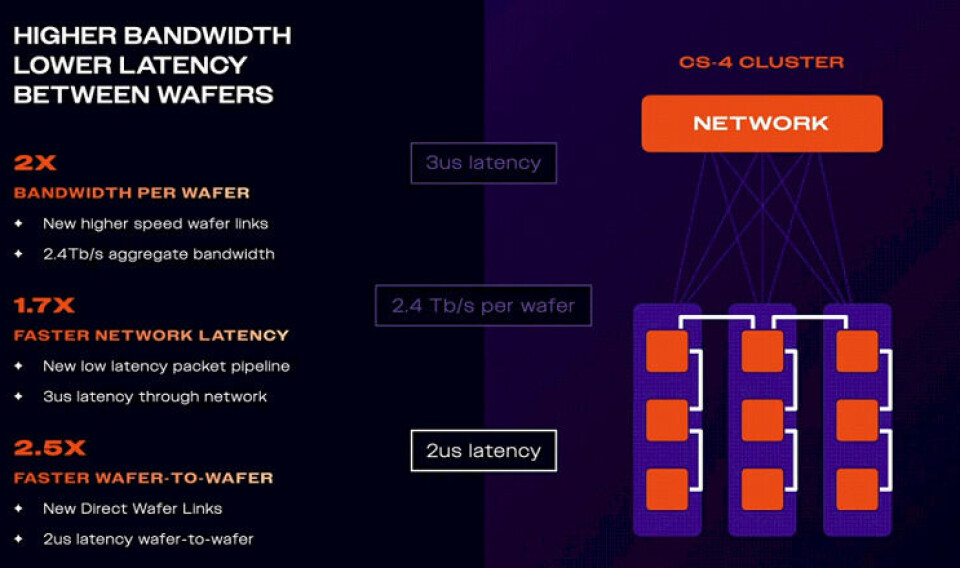
업데이트된 네트워킹 하드웨어는 프로그래밍 가능하고 낮은 지연 시간의 패킷 파이프라인을 지원하며, 웨이퍼 간 직접 연결(direct wafer-to-wafer links)도 지원합니다. 몇 개의 포트를 사용하여 웨이퍼들을 상호 연결하는 측면에서 얼마나 구성 가능한지는 명확하지 않습니다.
Arista Networks라는 이더넷 스위치 제조사와의 파트너십을 통해 CS-4 클러스터를 더 크게 확장하거나 사용자 및 스토리지에 연결되는 프론트 엔드 네트워크를 구축할 수 있습니다.
일부 고객은 현재 CS-4 시스템에 조기 접근할 수 있으며, 일반적인 구매 가능 시점(general availability)은 올해 3분기 중으로 예정되어 있습니다.
CS-4 머신의 성능 주장에 대해서는 별도의 기사에서 자세히 다루겠습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기