
Candidly가 LangSmith에서 상태 인식 에이전트 하네스를 구축한 방법
요약
Candidly는 LangSmith를 활용하여 상태 인식 에이전트 하네스를 구축하는 방법을 공유했습니다. 기존의 사후 평가 방식에서 벗어나, 대화 턴 단위로 사용자의 현재 상태와 응답 특징을 추론함으로써 에이전트의 실시간 제어(Live Steering) 능력을 확보했습니다. 이 시스템은 금융 플래너 Cait의 실제 대화 트레이스를 기반으로 구축되었습니다.
핵심 포인트
- LangSmith를 활용하여 상태 인식 에이전트 하네스 구현
- 사후 평가 대신 턴 단위의 실시간 제어(Live Steering) 필요성 강조
- LLM-as-judge와 결정론적 규칙을 결합한 하이브리드 라벨링 파이프라인 구축
- Q/A 정렬, 토픽 연속성 등 다양한 특징으로 해결 여부 예측 모델 훈련
Ben Levine과 Patrick Hendershott(Candidly)의 게스트 포스팅
사후 평가(Ex-Post Evaluations)에서 실시간 제어(Live Steering)로
대부분의 대화형 비서(conversational assistants)는 대화가 끝난 후에, 즉 어떻게 끝났는지에 따라 평가됩니다. 사용자가 답변을 얻었는가? 작업을 완료했는가? 돌아와 클릭했거나 다음 단계를 취했는가?
이러한 레이블들은 목표를 정의하지만, 비서가 턴(turn) 단위로 행동하는 동안 마지막에만 관찰됩니다. 대화 중 해결책을 최적화하려면, 에이전트 하네스는 상호작용이 어디에 있는지, 그리고 어떤 응답 레버(response levers)가 이를 앞으로 나아가게 할 수 있는지에 대한 턴 수준의 시야를 필요로 합니다. 우리는 부분적인 추적(partial trace)을 읽고, 사용자의 현재 상태를 추론하며, 과거에 유사한 대화가 어떻게 변화했는지에 기반하여 응답 특징(response features)을 선택함으로써 그 시야를 구축합니다.
Candidly는 사람들이 부채 상환, 저축, 은퇴, 복리후생 및 교육 비용과 관련된 고위험 금융 결정을 내릴 수 있도록 돕습니다. Cait은 우리의 AI 재무 플래너로, 저축 전략 비교, 상환 옵션 이해, 마감일 파악, 트레이드오프 평가, 그리고 다음에 무엇을 할지 결정하는 데 도움을 주는 대화형 에이전트입니다. 예를 들면 다음과 같습니다:
- “미래를 위해 저축하는 것과 부채를 갚는 것을 어떻게 균형 있게 맞출 수 있나요?”
- “예산에 더 많은 여유 공간을 만들려면 어떻게 할 수 있나요? 은퇴를 희생하지 않고 아이의 대학 학비를 감당할 수 있나요?”
- “학생 대출금을 더 빨리 갚기 위해 401(k) 기여금 납입을 중단해야 하나요?”
이 포스팅은 공식 연구 논문과 다중 개월 동안의 프로덕션 Cait 대화 분석에 기반합니다. 목표는 고립된 연구 아티팩트를 생산하는 것이 아니라, 대화 분석을 Cait 하네스가 실제로 구현할 수 있는 정책 표면(policy surface)으로 전환하는 것이었습니다. 우리의 첫 번째 질문은 회고적이었습니다: Cait 대화가 끝난 후, 사용자의 질문이 해결되었는지 아니면 포기되었는지를 알 수 있을까요?
대화가 어떻게 끝날지 예측할 수 있을까?
대규모로 대화 수준의 결과를 평가하기 위해, 우리는 실제 Cait 트레이스(trace)를 기반으로 하이브리드 라벨링 파이프라인을 구축하고 LangSmith에서 그 결과 레이블들을 추적했습니다. 결정론적 규칙(Deterministic rules)은 명시적인 좌절감, Cait의 첫 메시지 이후 답장이 없는 경우, 또는 계정 연결이나 저축 플랜 시작과 같은 제품 후속 조치와 같은 명확한 사례를 처리했습니다.
모호한 사례는 대화 패턴에 따라 라우팅되는 LLM-as-judge 평가자들에게 전달되었습니다. 각 판결(verdict)은 피드백으로 해당 스레드에 첨부됩니다. 우리는 이 파이프라인을 사람이 라벨링한 LangSmith 데이터셋과 보정하여 92.3%의 일치율에 도달했습니다.
그런 다음, 트레이스에서 직접 계산된 특징(feature)들로부터 해당 레이블을 예측하도록 모델을 훈련했습니다. 이 특징들의 몇 가지 예시는 Cait가 무엇을 했는지와 사용자가 어떻게 응답했는지로 나뉩니다:
Cait의 행동
Q/A 정렬(alignment): Cait의 응답과 그 앞에 있던 사용자 프롬프트 사이의 어휘적 중첩 정도입니다. 높은 정렬도는 저희 데이터에서 해결(resolution)을 예측하는 가장 강력한 지표 중 하나이며, 낮은 정렬도는 실패 상태를 정의하는 특징적인 신호입니다.토픽 연속성(Topic continuity): Cait 자체 응답의 의미론적 지속성입니다. 턴 t에서의 Cait 응답 $a_t$가 이전 응답 $a_{t-1}$와 얼마나 유사한지 측정합니다.*궤적 전반에 걸친 연속성과 일관성은 해결을 강력하게 예측합니다.
사용자의 행동
메시지 길이(Message length): 긴 메시지는 해결을 예측하며, 짧거나 한 단어짜리 답장은 사용자가 떠나고 있음을 예측합니다.대문자 비율(Caps ratio): 대문자로 된 사용자 메시지의 비율입니다 (포기(abandonment)를 예측하는 좌절 신호).
저희의 모든 특징들은 런타임에서 가볍고 결정론적이며, 턴당 몇 번의 문자열 및 임베딩 연산으로 밀리초 단위로 계산됩니다.
이러한 특징들로 훈련된 그래디언트 부스팅 모델(gradient-boosted model)은 0.90 AUC (0.5는 우연, 1.0은 완벽함)에서 해결된 대화와 포기된 대화를 분리했습니다. 트레이스 내의 신호들만으로도 해결 여부와 포기 여부를 예측할 수 있었습니다.
다음 단계는 대화가 끝나기 전에 Cait이 사용할 수 있는 형태로 이러한 신호들을 표현하는 것이었습니다. 즉, 매 턴마다 업데이트되는 턴 레벨 상태 추론(turn-level state inference)과 이를 변화시킬 수 있는 제어 가능한 응답 특징(controllable response features)을 결합한 방식입니다. 이 글의 나머지 부분에서는 트레이스에서 상태로, 상태에서 정책으로, 그리고 정책에서 실험으로 이 루프를 Cait의 에이전트 하네스에 어떻게 구축했는지 설명합니다.
트레이스를 상태 모델로 변환하기
우리는 사용자, 에이전트, 대화 컨텍스트 간의 복잡한 상호작용을 모델링하는 것에 관심을 기울입니다. 예측 결과는 대화 결과가 트레이스로부터 학습 가능하다는 것을 알려주었습니다. Cait이 여전히 사용자와 대화하고 있는 동안 이 신호를 유용하게 만들기 위해서는, 어떻게 대화가 전개되는지에 대한 모델이 필요합니다. 여기에는 다음 내용이 포함됩니다: 관측 가능한 신호들이 턴을 거치며 어떻게 축적되는지, 어떤 패턴들이 반복되는 경향이 있는지, 그리고 Cait의 행동 중 어느 부분이 해결(resolution) 방향으로 움직이는 것과 관련되어 있는지를 파악하는 것입니다. 우리는 이러한 특징들을 트레이스로부터 결정론적으로 밀리초 단위로 계산한 다음, 이를 LangSmith에 사용자 메시지, Cait의 응답, 추론된 상태와 함께 저장하고, 대화가 완료되면 대화 결과를 추가합니다.
유용한 모델은 세 가지 일을 해야 합니다:
- 대화를 해석하고 행동할 수 있는 순서가 있는 궤적(ordered trajectory)으로 표현하는 것.
- 사용자 측 신호와 에이전트 측 특징을 분리하는 것. 왜냐하면 이들이 서로 다른 역할을 수행하기 때문입니다. 사용자 행동은 대화가 어떤 상태에 있는지 알려주지만, 에이전트 행동은 시스템이 움직일 수 있는 레버리지(lever)이기 때문입니다.
- 데이터 자체로부터 신호에서 상태로의 매핑을 학습하는 것. 따라서 상태는 우리가 미리 부과하는 범주가 아니라 실제로 나타나는 패턴들을 반영해야 합니다.
이러한 속성을 가진 모델은 단순한 사후 점수(retrospective score) 이상의 것을 제공합니다. 부분적인 트레이스를 읽고, 대화가 어디에 있는지를 요약하며, 그 판독 결과를 Cait이 제어하는 응답 특징과 연결할 수 있습니다. 이것이 바로 이 모델을 작동 가능하게 만드는 요소입니다. 결과가 실현되기 전에 에이전트가 사용할 수 있는 무언가를 생성하기 때문입니다.
입력-출력 은닉 마르코프 모델(Input-Output Hidden Markov Model)이 세 가지 요구 사항을 모두 충족합니다. RNN이나 트레이스 트랜스포머와 같은 더 무거운 대안들은 해석 가능성과 명확한 실시간 개입 경로를 희생합니다.
IO-HMM 내부 구조
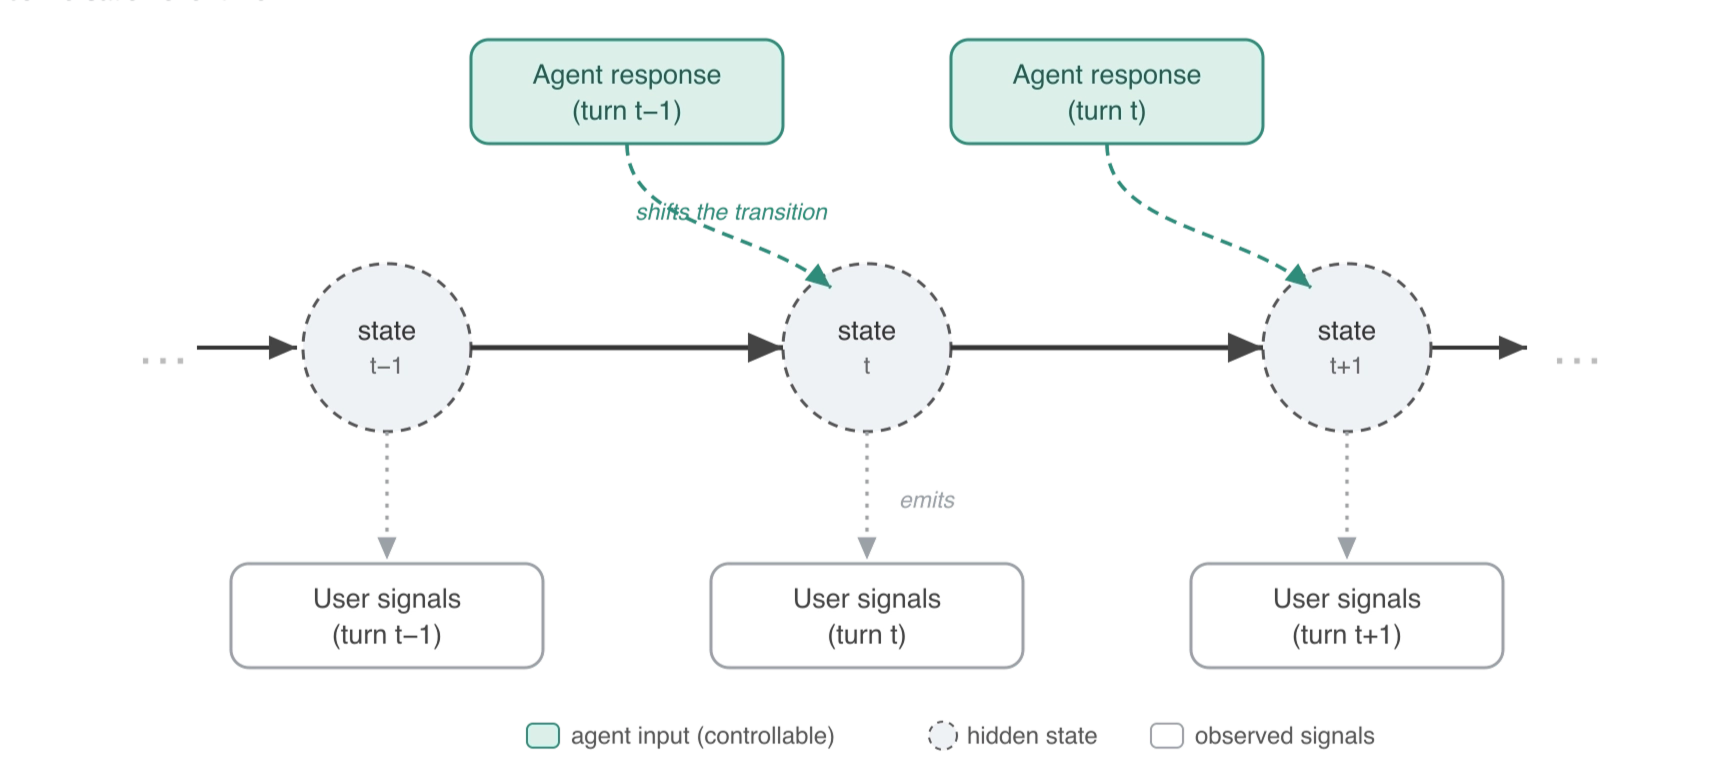
IO-HMM은 각 턴을 두 가지 조각으로 분리합니다:
**사용자 측 신호(User-side signals)**는 방출물(emissions)입니다. 이는 사용자의 현재 참여 상태를 추론하는 데 사용하는 관찰 가능한 행동입니다.**에이전트 측 특징(Agent-side features)**은 전이 입력(transition inputs)입니다. 이는 대화가 다음에 어디로 이동할지 조건화하는 제어 가능한 응답 특성입니다.
이 모델은 현재의 위치와 에이전트가 방금 어떻게 응답했는지를 바탕으로 대화가 다음에 어느 곳으로 이동할 가능성이 높은지를 추정합니다.
모델은 기대-최대화(expectation-maximization)를 사용하여 수천 개의 대화를 통해 적합됩니다. 이 과정에서 모델은 두 가지를 동시에 학습합니다. 1.) 참여 상태 자체 (대화 전반에 걸친 사용자 행동의 반복 패턴)와 2.) 전이 함수 (에이전트 측 특징이 상태 간 이동과 어떻게 연관되는지)입니다. 우리는 가장 좋은 홀드아웃 적합(held-out fit), BIC, 그리고 안정적인 해석 가능성을 위해 네 가지 상태를 선택했습니다.
더 작은 모델들은 개별 참여 패턴을 붕괴시켰고, 다섯 가지 상태 모델은 일관되고 사용 가능한 체제를 복구하지 못했습니다.
중요한 설계 선택은 분리입니다. 사용자 행동은 대화의 상태를 읽는 데 사용됩니다. 에이전트 행동은 상태 간 전이를 추정하는 데 사용됩니다. 이러한 분리는 트레이스를 '무슨 일이 일어났는지에 대한 기록'에서 '대화를 이끌고 있는 동인(driving force)에 대한 모델'로 변모시킵니다.
네 가지 참여 상태, 그리고 평균이 이를 숨기는 이유
모델은 해석 가능한 네 가지 참여 상태를 복구했습니다:
상태들은 행동과 결과 모두에서 차이를 보입니다. 이들은 사용자가 질문을 해결하는지, 제품 탐색을 계속하는지, 아니면 대화를 포기하는지에 매핑됩니다. 해결률은 가장 참여도가 높은 상태에서는 약 78%에 달하지만, 참여도가 낮은 상태에서는 약 30% 수준입니다.
상태별로 에이전트의 행동에 다르게 반응합니다. 주제 연속성을 유지하는 것은 참여도가 높은 사용자를 올바른 궤도에 머물게 하지만, 참여도가 낮은 사용자는 가장 낮은 해상도의 상태에 가두어 버릴 수 있습니다. 시각적 아티팩트를 제시하는 것은 상세한 사용자(Detailed)를 앞으로 나아가게 할 수 있지만, 참여도가 낮은 사용자에게는 회복을 더 어렵게 만듭니다. 이것이 바로 대화 수준의 평균이 흐릿하게 만드는 부분입니다. 모든 대화에 걸쳐 이러한 행동을 풀링하면 한 상태에서의 이득이 다른 상태에서의 손실을 상쇄시키므로, 순 효과는 편향된 추정치가 됩니다. 이제 상태(state)를 조건으로 삼으면 정책 신호가 눈에 보이게 됩니다.
이는 모델을 일종의 정책 표면(policy surface)으로 만듭니다... 즉, 대화가 어떤 지점에 있는지에서 가장 높은 확률로 그것을 더 나은 곳으로 이동시킬 응답 변화를 보여주는 지도와 같습니다. 예를 들어, 행동 유도 문구(call to action)를 추가하면 상세한 대화가 참여도가 낮은 상태로 미끄러지는 것을 막아주고, 사용자의 기능어 패턴(function-word patterns)을 반영하는 것은 참여도가 낮은 대화를 참여도가 높은 상태 쪽으로 회복시키는 데 도움을 줍니다.
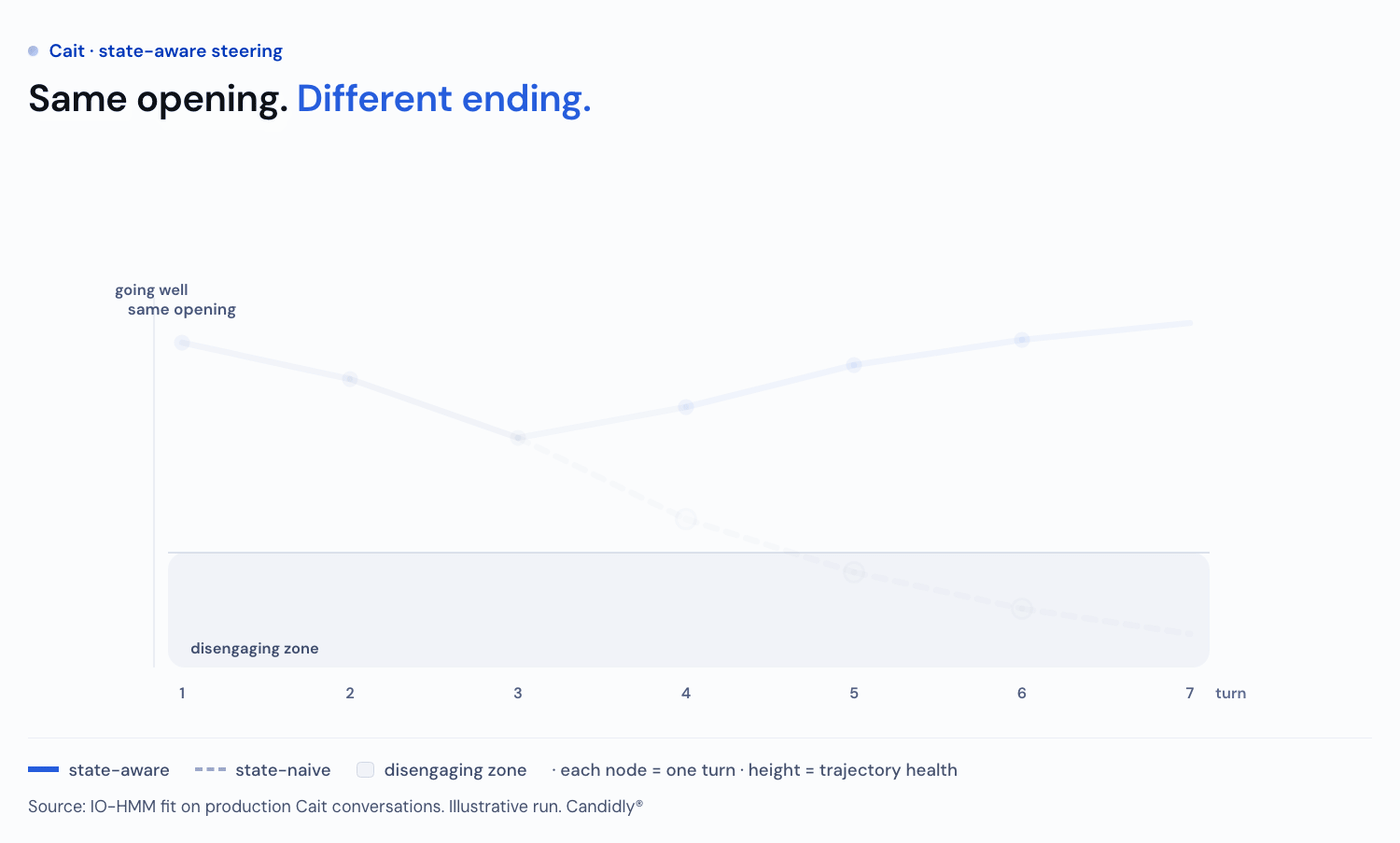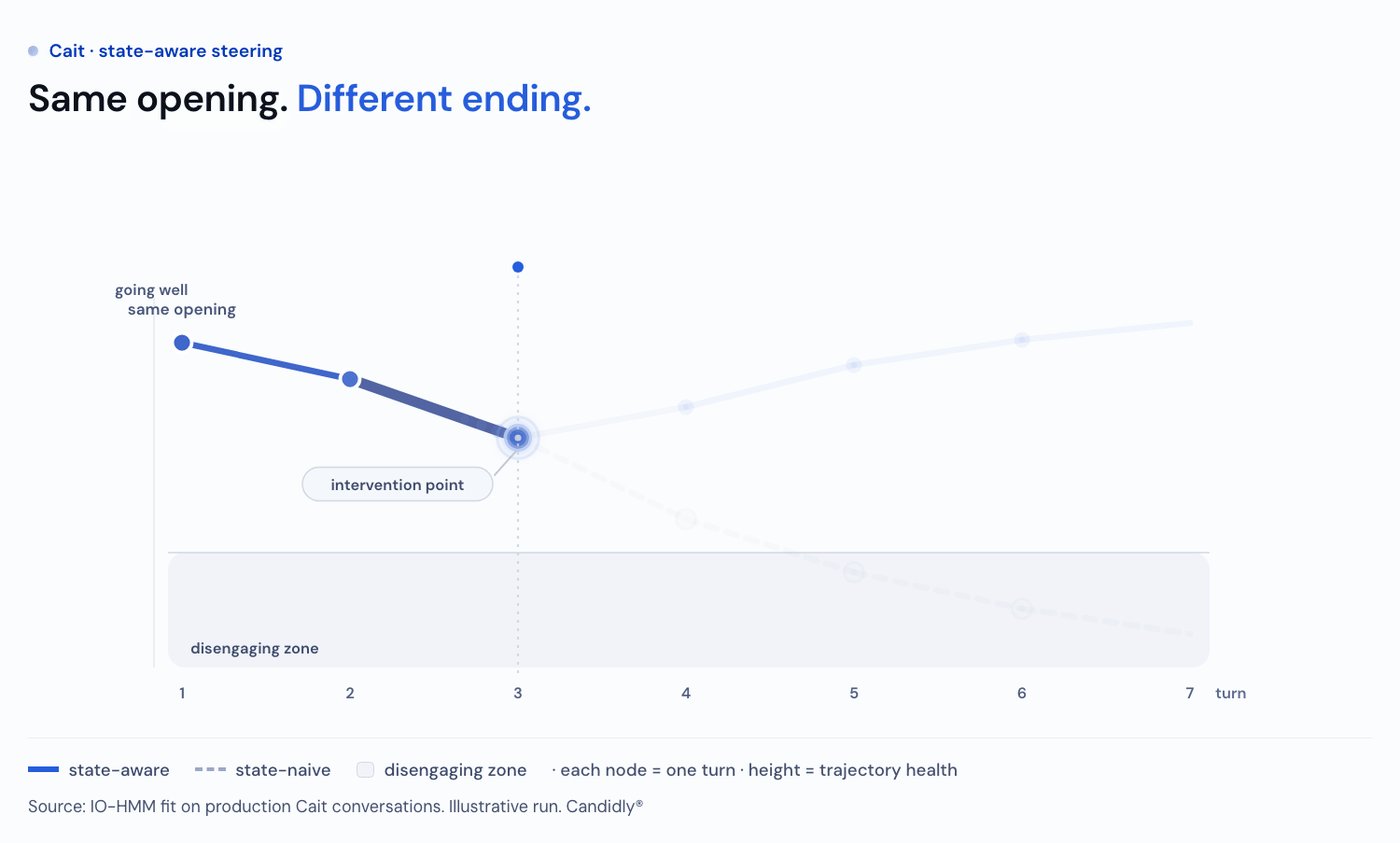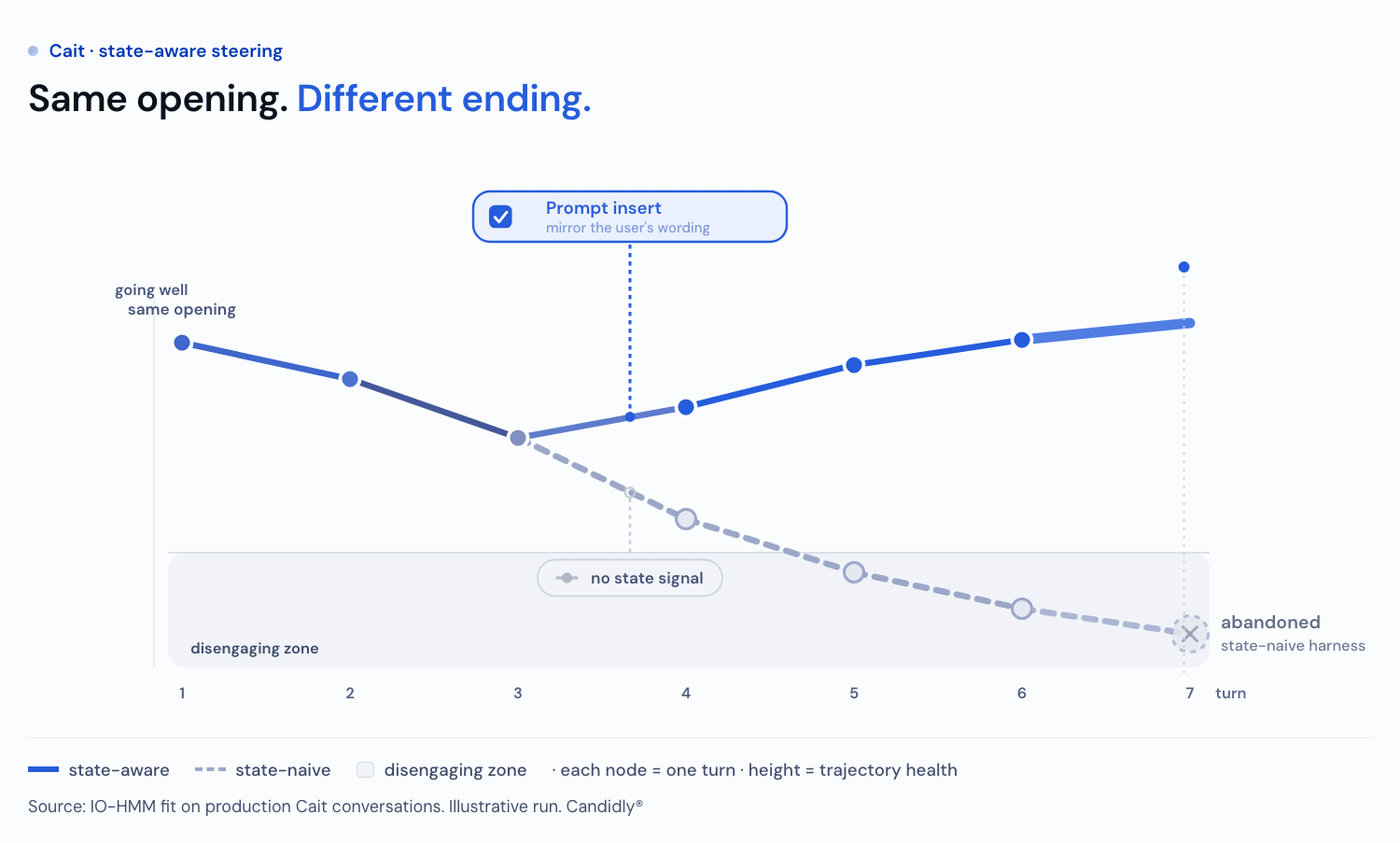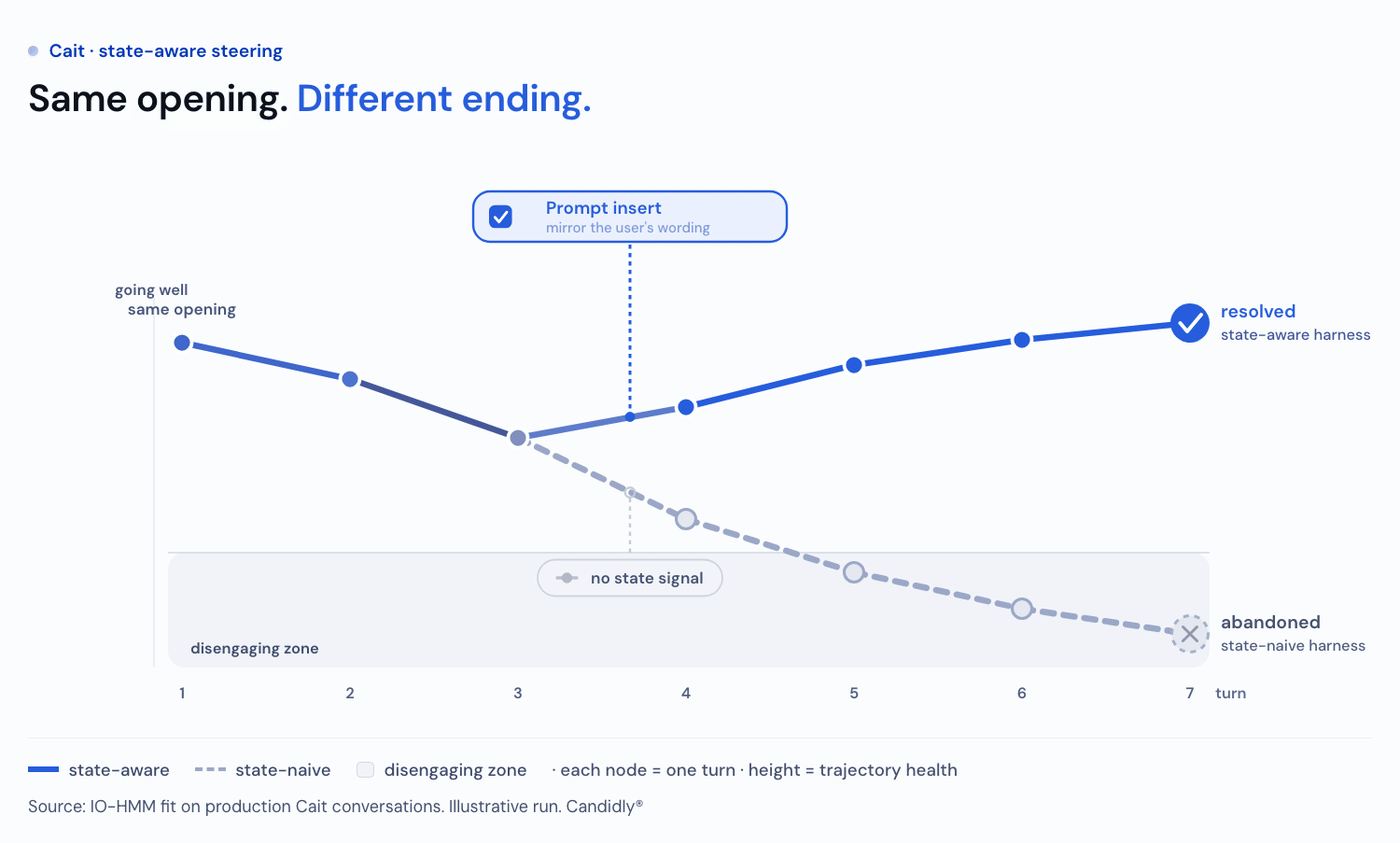
우리가 제안하는 정책은 대화 중 해결 확률을 최대화하는 것을 목표로 합니다. 상태들이 해상도 면에서 얼마나 떨어져 있는지 고려할 때, 이 정책은 명확하게 도출됩니다. 즉, 대화를 고해상도 상태에 유지하고 저해상도 상태를 벗어나게 하는 것입니다. 모델은 정확히 이를 수행할 수 있는 정책을 제공하여, 참여도가 낮은 상태에서의 사용자 턴 비율(23%에서 11%로)을 절반으로 줄이고, 그 대부분을 참여도가 높은 상태(53%에서 64%로)로 유도합니다.
정책을 하네스에 연결하기 (Wiring the Policy into the Harness)
적합된 모델이 아직 정책은 아닙니다. 이를 실행하려면, 모델이 하네스 내부에서 작동해야 하고, 그것이 주도하는 모든 변화는 기록되어야 하며, 출시 전에 그 효과가 검증되고 나중에 측정되어야 합니다.
요청 경로에서의 상태 추론(State inference in the request path). 모델은 매 턴마다 실행되며, 다음 응답을 형성하기에 충분히 빨라야 합니다. 우리는 적합된 파라미터들을 고정하고, 이미 트레이스에 있는 신호들로부터 사용자의 현재 상태를 계산한 후, 단일 답변의 지연 시간 예산(latency budget) 내에서 그 상태를 메타데이터로 다시 트레이스에 기록합니다.
상태별 버전 관리 변경 (A versioned change per state). 추론된 상태를 프롬프트 삽입(prompt insert), 도구 선택(tool choice) 또는 다른 템플릿과 같은 다른 응답으로 전환해야 합니다. 각각은 LangSmith 내에서 버전 관리 정책 체제(versioned policy regime)로 존재하며, 발동된 버전이 해당 턴에 기록되므로 어떤 변경 사항이 적용되었는지 항상 알 수 있습니다.
오프라인 검증 (Offline verification). 각 상태 인식 정책 변경은 Cait의 프롬프트 지침에 동적으로 추가되어 사용자를 더 나은 상태로 유도합니다. 배포 전에, 우리는 보류된 LangSmith 데이터셋에서 이를 재실행하고, 새로운 프롬프트 하에서 Cait의 응답을 재생성한 다음, 평가자(evaluators)를 사용하여 점수를 매겨 의도한 변화가 발생하는지 확인하며 나머지 응답에는 영향을 주지 않습니다. 통과하는 프롬프트만이 실험 팔(experiment arm)이 됩니다.
무작위 할당 (Randomized assignment). Cait의 응답은 무작위로 할당되지 않습니다. 이미 사용자의 메시지와 지금까지의 대화에 의존하기 때문에, 모델은 응답 자체가 궤적을 바꾸는지 여부보다는 어떤 상태가 어떤 응답을 요구하는지 학습할 수 있습니다. 무작위 실험은 누락된 외생 변동(exogenous variation)을 제공합니다. 각 사용자는 기존 행동 또는 상태 인식 정책에 할당되며, 할당은 안정적으로 유지되고 모든 트레이스에 태그됩니다. LangSmith는 두 팔이 실행되는 동안 이를 모니터링할 수 있게 하여, 전체 결과가 나오기 전에 상태 점유율(state occupancy)과 해결(resolution)이 어떻게 분기하는지 관찰할 수 있도록 합니다.
전체 루프를 위한 단일 기록 (One record for the whole loop). 추론된 상태, 프롬프트 버전, 실험 팔, 결과, 해결, 그리고 제품 활성화가 모두 동일한 트레이스에 위치합니다.
LangSmith는 이 루프를 완성합니다. 트레이스는 상태 인식 평가 데이터(state-aware eval data)가 되고, 평가 데이터는 프롬프트-정책 실험이 되며, 프로덕션 모니터링은 정책이 궤적을 변경했는지 여부를 알려줍니다.
에이전트 개선하기: 제어 신호로서의 평가 (Building Better Agents: Evaluation as a Control Signal)
저희 모델은 에이전트에게 사후 성공 점수(post-hoc success score)가 결코 줄 수 없는 것을 제공합니다. 바로 상호작용이 어디에 있는지 턴 수준에서 파악할 수 있는 능력이며, 이는 에이전트가 여전히 행동을 취할 수 있는 동안 이용 가능하여 평가를 단순한 등급이 아닌 제어 신호(control signal)로 변화시킵니다.
이것은 금융 대화에 국한된 것이 아니며, 모든 대화에 국한된 것도 아닙니다. 이 방법론에는 세 가지 재료가 필요합니다. 1.) 마지막에만 관찰되는 결과(outcome), 2.) 트레이스에서 계산 가능한 턴 레벨 신호(turn-level signals), 그리고 3.) 에이전트가 제어하는 행동입니다. 목표를 가진 모든 다중 턴(multi-turn) 에이전트는 이 세 가지 요소를 모두 갖추고 있습니다.
코딩 에이전트를 예로 들어보겠습니다. 그 결과물—병합된 PR(Pull Request), 통과한 테스트 스위트—은 마지막에 도착하지만, 트레이스에는 매 턴마다 잠재 상태(latent state)의 방출물이 담겨 있습니다: 각 패치 후에 새 방식으로 실패하는 테스트들 대 항상 같은 방식으로 실패하는 테스트들, 문제를 줄이지 않고 동일한 파일들을 반복적으로 수정하는 편집 내용들, 점점 더 짧고 교정적인 검토 코멘트들. 나쁜 상태에 빠진 코딩 세션의 에이전트는 또 다른 패치를 밀어붙이기보다는 멈추거나, 재계획하거나, 질문을 해야 합니다. 오늘날 대부분의 코딩 에이전트들은 어느 쪽이든 같은 루프를 실행합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기