
Cadence, 특수화된 칩 설계 에이전트를 구동하도록 구축된 미세 조정 AI 모델 'Maestro' 공개, 2026년 4분기 일부 고객 대상
요약
EDA 분야의 Cadence가 칩 설계 에이전트를 위한 도메인 특화 AI 모델 포트폴리오 'Maestro'를 공개했습니다. Maestro는 디자인 의도를 해석하고 작업을 분해하며, 강화학습(RL)을 통해 공학적 목표에 맞춰 최적의 결정을 내립니다. 이 시스템은 초기에는 일부 고객에게 2026년 4분기부터 제공될 예정입니다.
핵심 포인트
- Maestro는 일반 모델 대비 최대 30% 품질 향상 및 5배 토큰 효율성을 주장합니다.
- AI 슈퍼 에이전트가 디자인 의도 해석, 작업 분해, 최신 모델 오케스트레이션을 수행합니다.
- RL을 활용하여 공학 목표와 제약 조건에 따라 출력을 평가하고 개선에 사용됩니다.
- 고객의 독점 데이터로 추가 학습이 가능하며, 2026년 4분기부터 일부 고객에게 제공됩니다.
전자 설계 자동화(EDA) 분야의 주요 기업 중 하나인 Cadence가 금번 실적 발표 직전에 보낸 보도 자료를 통해 자체 칩 설계 에이전트를 위해 맞춤 제작된 도메인 특화 AI 모델 포트폴리오 'Maestro'를 공개했습니다. Cadence는 일반 목적 AI 모델과 비교했을 때, 초기 결과에서 최대 30%의 결과 품질 향상을 주장하며, Maestro가 동일한 작업을 수행하는 데 더 적은 토큰을 사용하고 최대 5배의 토큰 효율성을 가진다고 밝혔습니다. 첫 번째 모델들은 '일부 초기 접근 고객'에게 2026년 4분기에 제공될 예정이며, 고객들은 Cadence의 클라우드, 퍼블릭 클라우드 또는 고객이 통제하는 온프레미스 환경에서 이 모델들을 실행하고 자체적인 '독점 데이터(proprietary data), 설계 및 워크플로우'로 추가 학습시킬 수 있습니다. Maestro에 대해 더 자세히 알아보기 위해, 저희는 Cadence의 임원 두 명인 Rob Knoth(전략 및 신규 벤처 선임 그룹 디렉터)와 Paul Cunningham(선임 부사장 겸 총괄 매니저)과 대화를 나누었습니다.
이 접근 방식은 고객 데이터를 모델 학습에 사용하지 않고 OpenAI가 호스팅하는 인프라에서 실행될 전문화된 AI 모델인 Synopsys의 자체 모델 'GPT-Synopsys'와는 구별됩니다. 한 달도 채 안 되는 간격으로 발표된 두 EDA 거인의 모델들은 이제 고객 설계 데이터가 어디로 가야 하는지에 대해 의견이 갈리고 있습니다. 차이가 없을 수도 있는 부분은 그 이유입니다. Cadence의 Paul Cunningham 선임 부사장 겸 총괄 매니저는 _Tom’s Hardware Premium_과의 인터뷰에서 에이전트 비용이 “정말로 폭발적으로 증가하기 시작했다”고 말하며, “그리고 세상도 그것을 깨달았다고 생각합니다.”라 덧붙였습니다. 그는 따라서 에이전트의 반복 과정을 모델 자체의 '가중치(weights)' 안으로 더 많이 이동시키는 것이 자연스러운 단계라고 말했습니다.
(이미지 출처: Cadence)
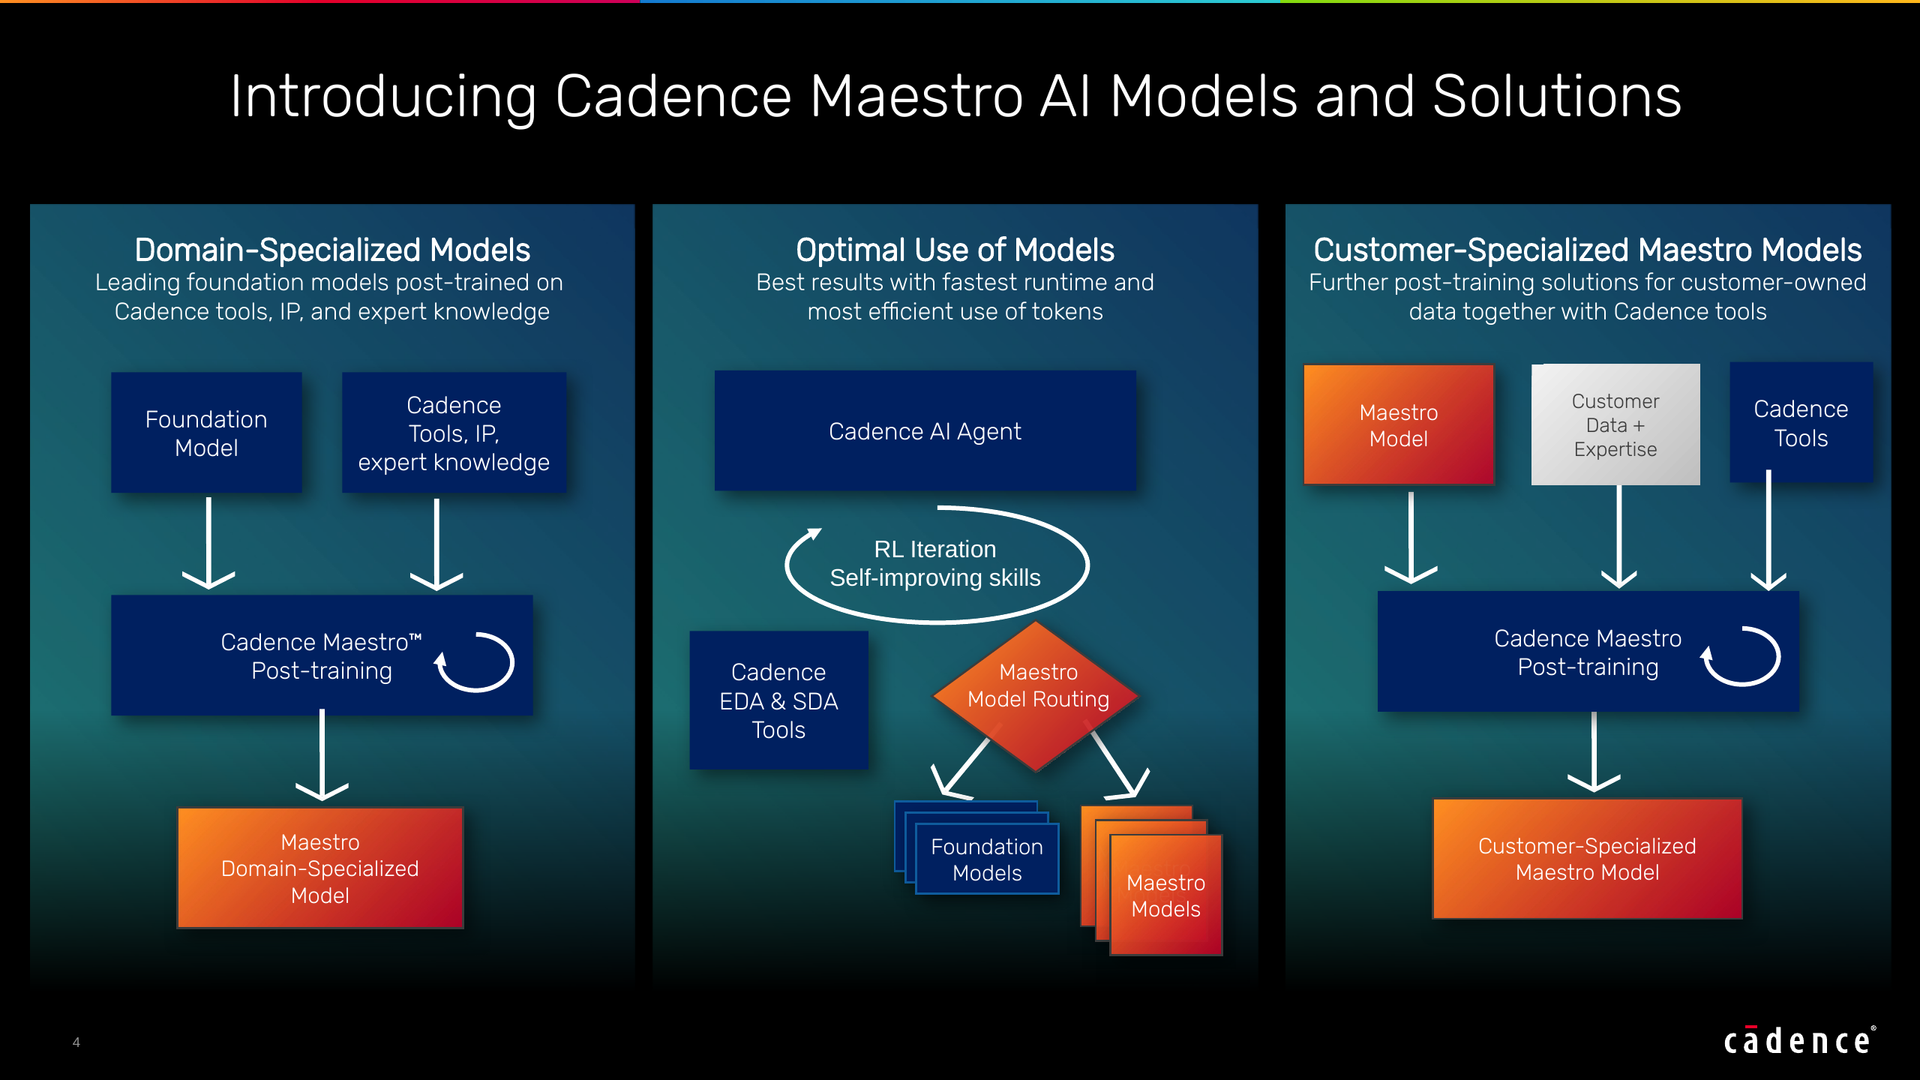
Maestro는 Cadence의 AI 슈퍼 에이전트를 통해 이러한 단계를 수행합니다. 이 에이전트는 “설계 의도를 해석하고(interpret design intent), 작업을 분해하며(decompose tasks),” 그리고 “다른 선도적인 최신(frontier) 및 오픈 웨이트 모델들과 Maestro 포트폴리오를 오케스트레이션하여(orchestrate the Maestro portfolio with other leading frontier and open-weight models),” 도메인 전문 지식을 활용하여 트레이드오프를 평가하고 의사 결정을 안내합니다. 또한, 강화학습 (RL)을 사용하는데, 이 과정에서 Cadence의 “결정론적 솔버(deterministic solvers)가 공학 목표, 제약 조건 및 실제 값(ground truth)과 비교하여 출력을 평가하며,” 가장 중요한 점은 그 결과가 모델 개선을 위해 다시 피드백된다는 것입니다.
이러한 모델에는 Nvidia의 Nemotron이 포함되어 있으며, 고객들은 Cadence의 미세 조정 하니스(fine-tuning harness)를 사용하여 자체적으로 고객 데이터 훈련 단계를 수행할 수 있어 잠재적으로 “자체 GPU와 자체 네트워크에서” 작업할 수 있다고 Cunningham은 말했습니다. 그는 특히 Nemotron이 “매우 견고한 결과를 보여주고 실제로 매우 빠르게 개선되고 있다”고 덧붙였습니다.
에이전트 기반 EDA(agentic EDA) 분야에서 지속적으로 언급되는 한 가지는 숫자가 실제로 무엇을 측정하는지 명확히 하는 필요성입니다. 칩 설계에서 결과의 품질은 일반적으로 디자인의 전력(power), 성능(performance), 면적(area)을 의미하지만, Cadence는 자사의 30% 수치가 무엇을 측정하는지는 구체적으로 밝히지 않았습니다. 이 30% 수치와 5배 토큰 효율성 수치는 모두 “범용 파운데이션 모델(general-purpose foundation model)”을 기준으로 측정되었으며, 이는 Cadence가 Maestro의 훈련 전 출발점이었던 오픈 소스 모델이라고 설명했습니다. 회사는 Maestro가 파생된 기반 AI 모델의 이름을 밝히지는 않았지만, 이것이 “상업적 최신 모델들과 매우 경쟁력이 있는 선도적인 오픈 소스 모델 중 하나”라고 언급했습니다.
Cadence는 토큰 절감의 원인을 EDA(Electronic Design Automation)와 SDA(System Design Automation) 도구 호출과 LLM(Large Language Model) 호출 간의 균형을 맞추는 데서 찾고 있습니다. Cunningham은 비유를 들며 “제트 엔진으로 Safeway까지 운전할 필요가 없다”고 말했고, “적절한 시점에 적절한 작업에 맞는 올바른 모델을 사용하고 싶다”고 덧붙였습니다.
실행 시간(Runtime) 역시 중요합니다. Cadence의 선임 그룹 디렉터인 Rob Knoth는 _Tom’s Hardware Premium_과의 인터뷰에서, 도구 호출이 값을 반환하는 데 몇 시간에서 며칠까지 걸릴 수 있는 반면, AI 산업의 학습 루프는 “분 단위”에 익숙하다고 말했습니다. Cunningham은 효율성이 비용을 낮출 수도 있다고 언급했는데, Maestro 사용량이 Cadence의 에이전트 가격 책정에 포함되기 때문입니다. 이 가격 책정은 소비 허용량(consumption allowance)과 초과 사용에 대한 요금으로 구성됩니다. 그는 토큰 절감이 고객 청구서에서 얼마나 할인되는지는 밝히지 않았습니다.
고객에게 유연성을 제공하는 것이 모든 솔루션의 핵심 요소이며, Cadence의 경쟁사인 Synopsys는 this lies in Autopilot에서 이를 보여주고 있습니다. Synopsys에 따르면, 이 플랫폼은 고객이 클라우드 또는 온프레미스 인프라를 통해 “상용(commercial), 오픈 소스(open-source), 미세 조정된 언어 모델” 중에서 선택할 수 있게 합니다. 에이전트 보안의 경우, 샌드박싱(sandboxing)과 같은 기능에 대해 Cadence는 Nvidia가 지난주 출시한 OpenShell Reference Architecture와 통합하기 위해 Nvidia와 협력하고 있다고 밝히며, 이 과정에서 Cadence와 Synopsys 모두 이름을 올렸습니다. 이러한 옵션들은 고객 지적 재산(IP)을 보호하는 데 도움이 될 수 있습니다.
Cadence Maestro vs. GPT-Synopsys
| Cadence Maestro | GPT-Synopsys | |
|---|---|---|
| 공개일 | 2026년 10월 26일 | 2026년 9월 30일 |
| 정의 | Cadence의 AI Super Agents를 위한 도메인 특화 AI 모델 포트폴리오 | Synopsys의 도구를 직접 구동하는 전문 모델 |
| 모델 파트너 |
경쟁사 비교 분석
| 구분 | Nvidia (Nemotron, OpenShell) | OpenAI |
|---|---|---|
| 모델 | 사후 훈련된 대규모 언어 모델(Post-trained LLMs), 학습된 의사 결정 모델 및 에이전트 스킬을 최첨단(frontier) 및 오픈 가중치 모델(open-weight models)과 혼합한 Nemotron 포함 | |
| OpenAI | OpenAI의 최첨단 모델들 | |
| 구동 환경 | Cadence 클라우드, 퍼블릭 클라우드 또는 고객 통제 온프레미스 환경 | |
| OpenAI 호스팅 인프라 | ||
| 고객 데이터 처리 | Cadence의 미세 조정 도구를 사용하여 자체 데이터, 설계 및 워크플로우에 사후 훈련 가능. (고객 데이터는 모델 학습에 사용되지 않음) | 고객 데이터는 모델 학습에 사용되지 않음 |
| 주장된 결과 | 비공개 오픈 소스 모델 Maestro가 시작한 지점(초기 결과; 측정 기준 미명시) 대비 최대 30% 높은 결과 품질 및 최대 5배의 토큰 효율성 | |
| 해당 없음 | None disclosed | |
| 가용성 | 2026년 4분기에 선정된 초기 접근 고객 대상 첫 모델 제공 | |
| 날짜 미정; 초기 기술 협력 진행 중 | ||
| 언급된 고객사 | Socionext, Silicon Labs (Nvidia 파트너) | |
| 없음 | None | |
| 가격 책정 | 사용량 할당량을 포함한 구독료 후 사용량에 따라 청구 | |
| 공개되지 않음; Synopsys와 OpenAI가 계약에 따라 수익 공유 |
Cadence는 고객사 및 에이전트 모두에게 바쁜 12개월을 보냈습니다. Cadence의 7월 실적 발표 컨퍼런스 콜에서 CEO Anirudh Devgan은 설계 및 검증 에이전트인 ChipStack이 “20개 이상의 고객 참여”를 가졌으며, 커스텀 및 아날로그 에이전트인 ViraStack은 “25개 이상의 고객 참여”를 가졌다고 말했습니다. Socionext는 지난주에 InnoStack을 적용하고 있다고 밝혔습니다. Silicon Labs 역시 ChipStack이 디버깅 속도를 높이는 데 기여했다고 언급했으며, 두 회사 모두 Maestro의 향후 동향을 주시하고 있다고 전했습니다.
Cadence의 에이전트적 통합(agentic consolidation)은 2025년 11월 ChipStack을 인수하면서 시작되었습니다. 2026년 6월, 이 회사는 자사의 에이전트가 레벨 5 수준의 자율성(Level 5 autonomy)에 도달했다고 주장했으며, 이는 저희가 자세히 탐구한 내용에서 확인할 수 있습니다. 9월에 Knoth는 GPT-Synopsys 발표 이틀 전, _Tom's Hardware Premium_을 통해 Maestro의 구성 요소들을 한 달 일찍 공개했습니다: “강화학습 루프(reinforcement learning loops), 도메인 특화 후처리 학습된 오픈 가중치 모델(domain-specific post-training of open-weight models), 모델 라우팅(model routing).” 현재 Maestro는 네 가지 슈퍼 에이전트 아래에 자리 잡고 있으며, Synopsys의 Autopilot과 유사한 연말 목표 시기를 겨냥하고 있습니다. 전체 타임라인은 아래 표를 참고하십시오.
Cadence의 에이전트 AI 로드맵
| 시기 | 제품명 | 카덴스의 주장 | 현황 및 예정 사항 |
|---|---|---|---|
| 2025년 11월 | ChipStack 인수 (에이전트 기반 검증 스타트업) | — | 완료; 공동 창립자 Kartik Hegde가 현재 Cadence의 핵심 AI 연구 그룹을 이끌고 있음 |
| 2026년 2월 | ChipStack AI 슈퍼 에이전트 | 설계 및 테스트벤치, 테스트 계획, 회귀 분석 및 디버깅에서 최대 10배 생산성 향상 | 출시 이후 조기 접근(early access) 가능 |
| 2026년 4월 | ViraStack (커스텀 및 아날로그), InnoStack (디지털 구현) 및 AgentStack (헤드 에이전트) | — | Socionext가 InnoStack을 프로덕션에 배포 중; 기타는 명시되지 않음 |
| 2026년 6월 | Nvidia의 Nemotron 및 OpenShell을 갖춘 Level 5 ChipStack | Nvidia 배포에서 RTL 검증 주기 최대 40배 단축 | 레벨 5와 AgentStack은 2026년 하반기 조기 접근 고객 대상 예정 |
| 2026년 7월 | AuraStack (PCB 및 첨단 패키징) | 시장 출시 시간 최대 2배 단축 및 생산성 15배 향상 | Cadence의 Millennium M2000 슈퍼컴퓨터에서 사용 가능; Nokia가 배포 중 (10. 21.) |
| 2026년 9월 | ChipStack RTL 생성 에이전트 |
초기 평가에서 순수 파운데이션 모델 코드 대비 평균 면적 24% 감소 및 전력 18% 감소
|
2026년 4분기 선정된 초기 접근 고객 대상; 혼다 R&D와의 초기 협업
|
|
2026년 10월 26일
|
Maestro AI 모델 포트폴리오
|
초기 결과에서 범용 파운데이션 모델 대비 최대 30% 높은 결과 품질 및 최대 5배 토큰 효율성
|
첫 번째 모델은 2026년 4분기 선정된 초기 접근 고객에게 제공될 예정; 약 12건의 참여(engagement)
이러한 빠른 진전 속도는 초기 접근과 일반 사용 가능성 사이에 명확한 구분이 필요함을 의미합니다. Cadence와 Synopsys 모두 고객 참여 사례를 제시할 수 있으며, 특히 후자의 AgentEngineer 포트폴리오 및 Autopilot 플랫폼의 경우, 일반 사용 가능성은 연말까지 목표로 하고 있습니다. 하지만 Cadence는 Maestro에 대한 일반 사용 가능 날짜를 공개하지 않았습니다. 반면, GPT-Synopsys의 경우 파트너들에 따르면 “초기 기술 참여가 진행 중”이라고만 밝혔습니다. 이들 플랫폼과 에이전트는 여전히 개발 중인(works in progress) 상태입니다.
Cunningham은 4분기까지 “더 많은 사례 연구와 더 정량화된 이점”을 기대하고 있습니다. 그가 적절하게 표현했듯이, 핵심 이야기는 “우리가 우리의 수직 분야에 에이전트와 agentic AI를 네이티브로 가져갈 것이지, 우리의 수직 분야가 범용 에이전트에 내장될 것이 아니라는 점”입니다. Cadence의 30% 수치를 검증할 것은 실제 워크플로우 상의 고객 결과만이겠지만, 두 회사 모두 지금까지 보여준 바에 따르면 그들 자체의 초기 수치는 EDA 산업에 매우 유망하고 흥미진진합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기