x86 CPU 플랫폼에서 DGEMM을 최적화하는 방법
일반 행렬 곱셈(General matrix/matrix multiplication, GEMM)은 많은 인기 알고리즘의 핵심 루틴입니다. 계층적 메모리 아키텍처를 갖춘 현대 컴퓨팅 플랫폼에서는 일반적으로 GEMM에 대해 거의 최적에 가까운 성능을 달성하는 것이 가능합니다. 예를 들어, 대부분의 x86 CPU에서 Intel MKL뿐만 아니라 OpenBLAS 및 BLIS를 포함한 다른 잘 알려진 BLAS(Basic Linear Algebra Subprograms) 구현체들은 GEMM에 대해 90% 이상의 최고 성능을 제공할 수 있습니다. GPU 측면에서는 NVIDIA가 제공하는 cuBLAS 역시 GEMM에 대해 거의 최적의 성능을 제공할 수 있습니다.
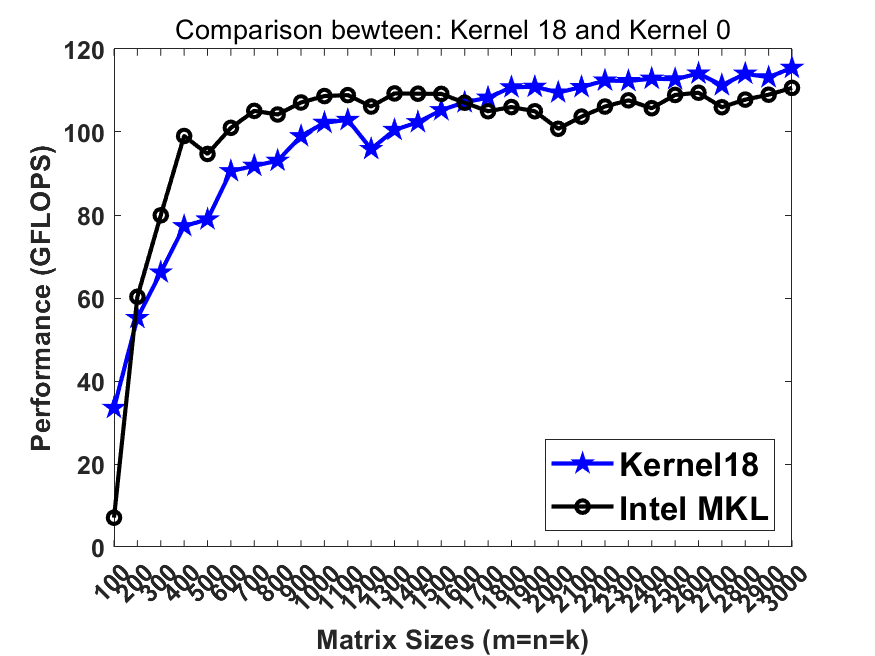
비록 x86 플랫폼에서 GEMM의 직렬(serial) 구현을 최적화하는 것이 결코 새로운 주제는 아니지만, AVX512 명령어를 사용하여 x86 플랫폼에서 GEMM을 최적화하는 방법을 다루는 튜토리얼은 기존 온라인 학습 자료 중 부족한 부분입니다. 게다가, AVX512와 그 이전 버전인 AVX2, AVX, SSE4 등 사이의 데이터 폭(data width) 증가에 따라, 최고 계산 능력과 메모리 대역폭 간의 격차는 계속 커지고 있습니다. 이는 동시에 프로그래머들에게 메모리 지연 시간(memory latency)을 숨기기 위해 더욱 정교한 프리페칭(prefetching) 스킴을 설계해야 할 필요성을 제기합니다. 기존 튜토리얼들과 비교했을 때, 본 자료는 AVX512 명령어를 활용하는 구현에만 초점을 맞추지 않고, 프리페칭 전략과 함께 단계별 최적화를 제공한다는 점에서 최초의 시도입니다. 궁극적으로 DGEMM 구현은 Intel MKL과 비교할 만한 성능에 도달합니다.
Q & A
질문이나 토론은 풀 리퀘스트(pull requests) 또는 제 개인 이메일 주소 [email protected]을 통해 환영합니다.
하드웨어 플랫폼 및 소프트웨어 구성
- 이 튜토리얼의 모든 테스트 케이스를 실행하려면
avx512f CPU 플래그가 있는 CPU가 필요합니다. 이는 터미널에서 다음 명령어를 사용하여 확인할 수 있습니다: lscpu | grep "avx512f".
- 제시된 실험 데이터는 Intel Xeon W-2255 CPU(AVX512 유닛 2개, 기본 주파수 3.7 GHz, 단일 코어에서 AVX512 명령어 실행 시 터보 부스트 주파수: 4.0 GHz)에서 수집되었습니다. 이 워크스테이션은 2933 GHz의 4x8GB=32GB DRAM을 갖추고 있습니다. 단일 코어의 이론적 최대 성능은 다음과 같습니다: 2(FMA) * 2(AVX512 유닛) * 512(데이터 너비)/(fp64 숫자의 비트 수인 64)/4 GHz = 128 GFLOPS.
- 우리는 Ubuntu 18.04.5 LTS 환경에서
gcc 7.3.0을 사용하여 프로그램을 컴파일했습니다.
- Intel MKL 버전: oneMKL 2021.1 beta.
실행 방법 (How to run)
단 세 단계만 거치면 됩니다.
- 첫째,
Makefile에서 MKL의 경로를 수정합니다.
- 둘째, 컴파일을 위해
make를 입력합니다. 이로써 바이너리 실행 파일인 dgemm_x86이 생성됩니다.
- 셋째,
./dgemm_x86 [커널 번호]를 사용하여 바이너리를 실행합니다. 여기서 커널 번호는 벤치마크에 사용할 커널을 선택합니다. 0은 Intel MKL을 나타내고, 1-19는 최적화 전략을 보여주는 19개의 커널을 나타냅니다. 여기서 kernel18은 최고의 직렬(serial) 버전이며, kernel19는 최고의 병렬(parallel) 버전입니다. 이 두 커널 모두 최신 Intel CPU에서 Intel MKL에 필적하거나 더 빠른 성능을 달성합니다.
단계별 최적화 (Step-wise Optimizations)
여기서는 DGEMM의 열 우선(column-major) 구현을 사용합니다.
커널 1 (Naive 버전)
소스 코드
커널 1은 DGEMM의 가장 기본적인(naive) 구현입니다.
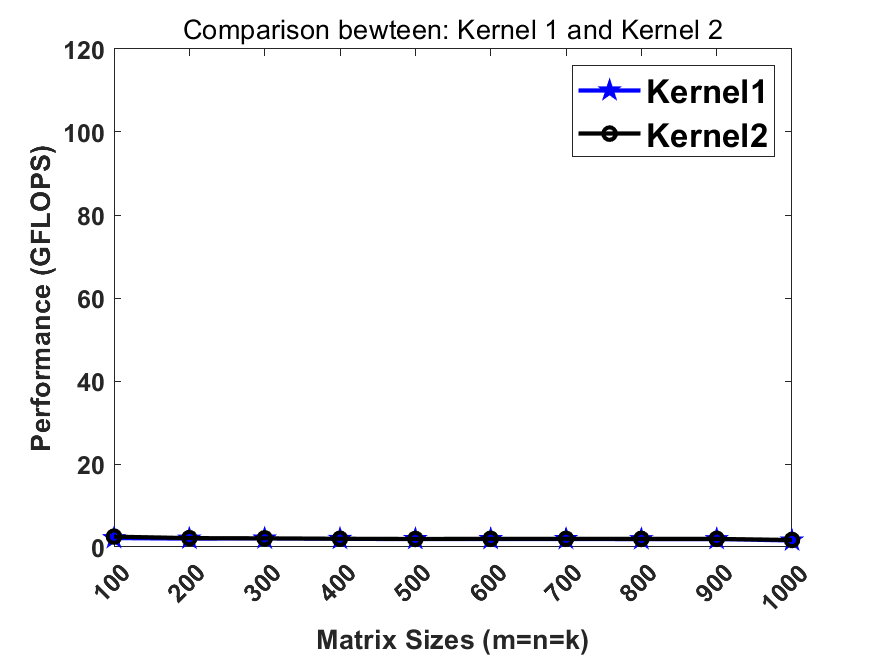
커널 2 (레지스터 재사용, register re-use)
소스 코드
kernel1의 가장 안쪽 루프를 관찰하면, C(i,j)는 가장 안쪽 루프 인덱스 k와 무관하므로, 불필요한 메모리 접근을 피하기 위해 k-루프에 진입하기 전에 레지스터에 로드할 수 있습니다.
image
Kernel 3 (2x2 register blocking)
source code
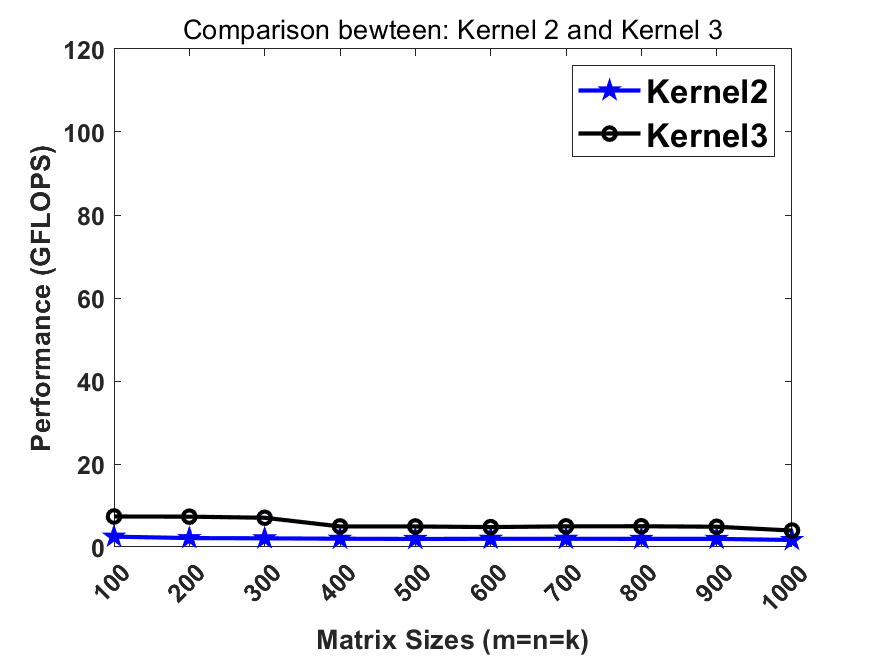
행렬 곱셈은 복잡도 순서가 N^3인 알고리즘이므로, 성능 향상을 위해 기본적으로 레지스터/캐시 수준에서 데이터를 재사용해야 합니다. [kernel2]에서는 C 요소 하나를 레지스터에 캐싱했지만, 행렬 A와 B의 데이터는 레지스터 수준에서 재사용하는 데 실패했습니다. 이제 우리는 A의 2x1 슬라이스와 B의 1x2 슬라이스를 로드하여 C 행렬 전체 2x2 블록을 업데이트합니다. 그런 다음 2x2 C 블록에 외적(outer-product) 순위-1 업데이트를 수행합니다. 이는 이전 단계와 비교하여 성능을 크게 향상시킵니다.
image
Kernel 4 (4x4 register blocking)
source code
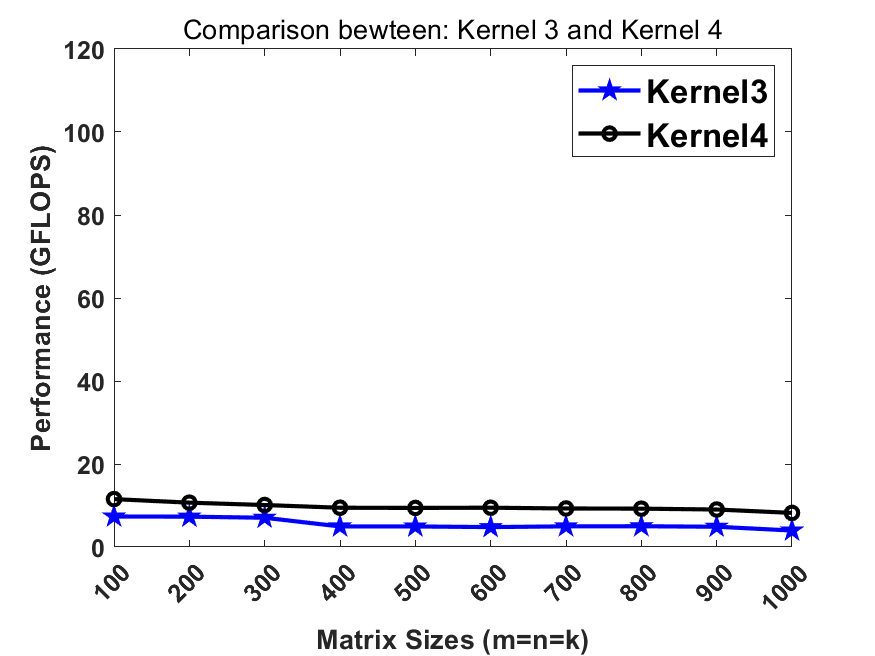
이제 우리는 레지스터 블로킹 전략을 더욱 적극적으로 활용합니다. 매번 4x4 C 블록에 대해 업데이트를 수행합니다. 성능이 더욱 향상됩니다.
image
Kernel 5 (Kernel 4 + AVX2)
source code
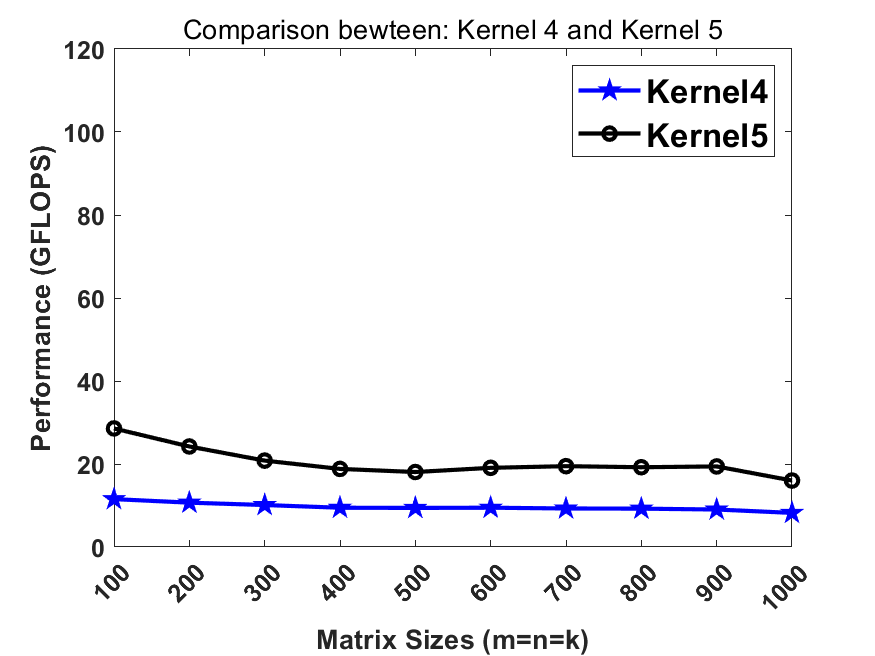
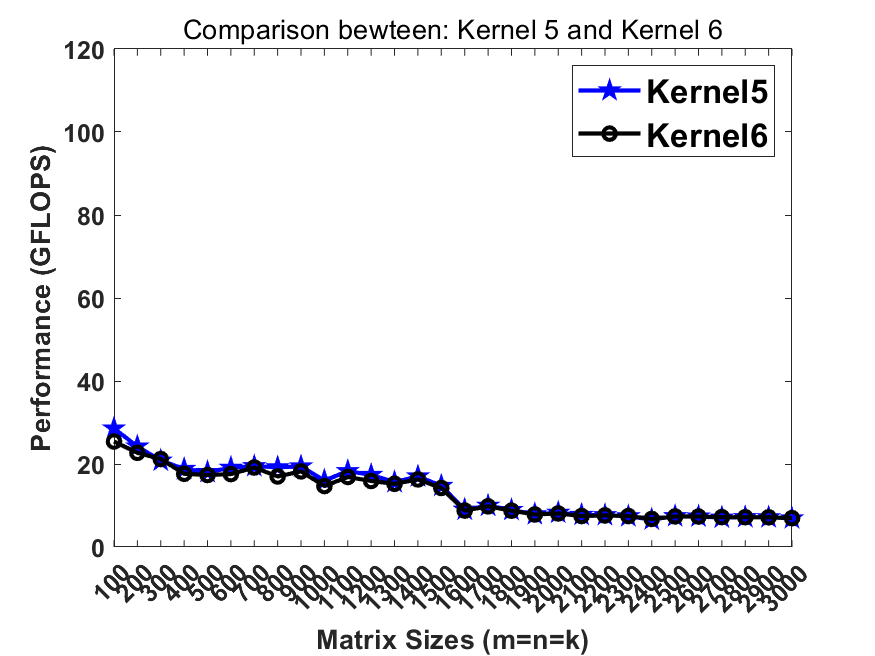
스칼라 명령어(scalar instructions)로 데이터를 처리하는 대신, 이제 우리는 Single Instruction Multiple Data (SIMD) 명령어를 사용하여 데이터를 처리합니다. 데이터 폭이 256비트인 AVX2 명령어는 레인당 4개의 fp64 요소를 처리할 수 있습니다.
image
Kernel 6 (Kernel 5 + loop unrolling x 4)
source code
우리는 루프를 4배(folds)로 언롤링(unrolling)합니다. 이 단계는 성능을 약간 향상시킵니다.
image
Kernel 7 (8x4 kernel + AVX2 + loop unrolling x 4)
source code
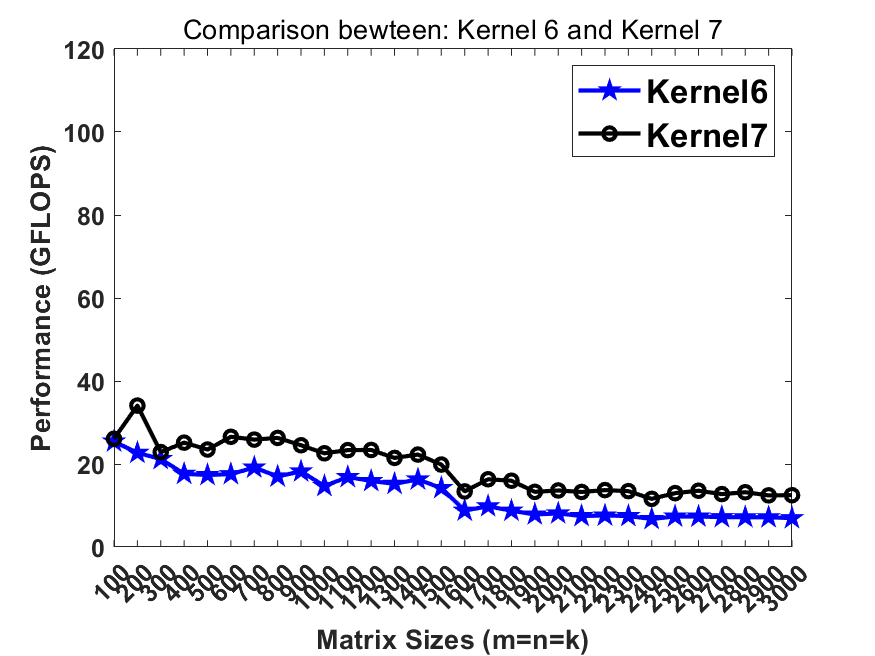
이전 kernel을 4x4에서 현재의 8x4로 변경하여 모든 256비트 YMM 레지스터(SNB/HSW/BRW에서는 16개의 YMM, SKL/CSL에서는 32개의 YMM/ZMM)에서 더 나은 활용률을 얻도록 했습니다.
image
Kernel 8 (Kernel 7 + 캐시 블로킹)
source code
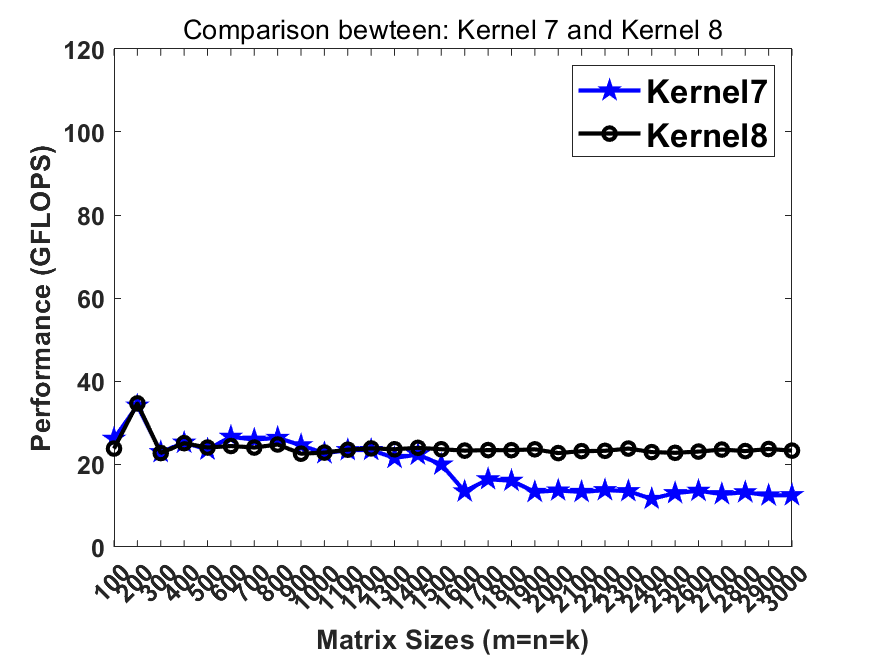
데이터가 캐시에 유지되지 않을 경우 약 30 GFLOPS의 성능을 유지할 수 없다는 것을 확인했습니다. 따라서 행렬 크기가 작을 때도 좋은 성능을 유지하기 위해 캐시 블로킹(cache blocking)을 도입했습니다.
image
Kernel 9 (Kernel 8 + 패킹)
source code
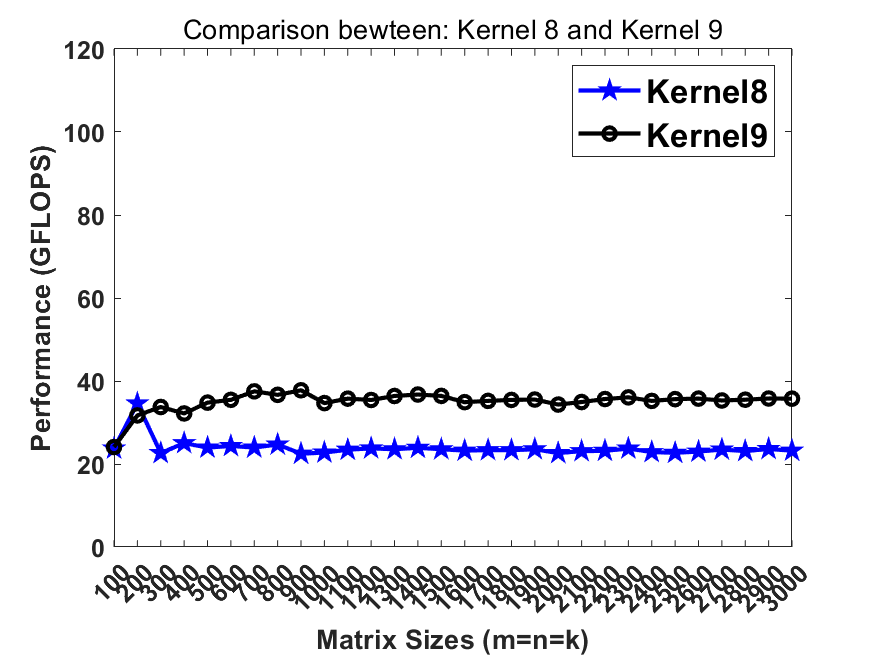
캐시 블록에 접근할 때 발생하는 TLB 미스(TLB miss)를 방지하기 위해 데이터를 로드하기 전에 데이터 블록을 연속적인 메모리 공간으로 패킹(pack)합니다. 이 전략은 성능을 향상시킵니다.
image
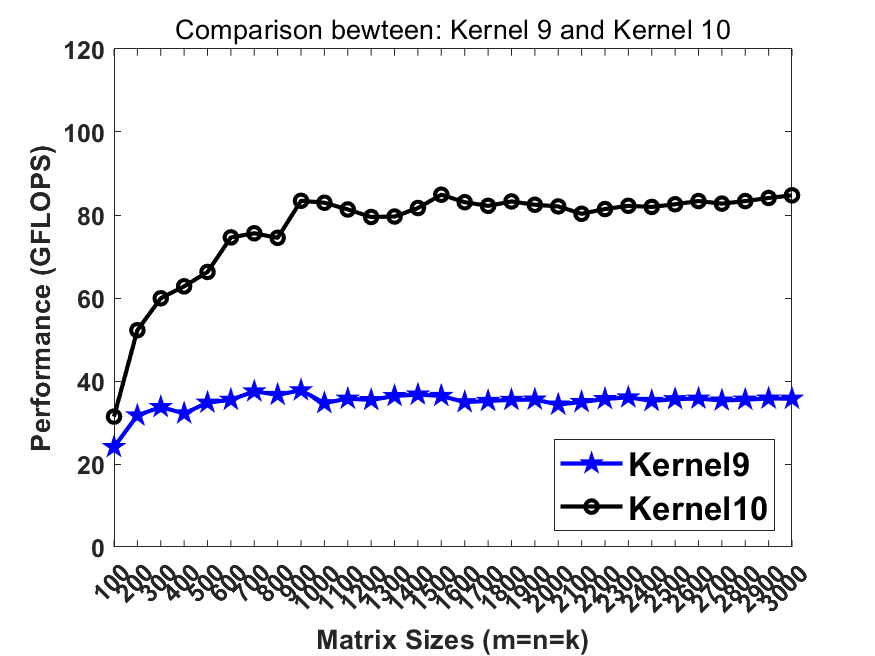
Kernel 10 (24x8 커널 + AVX512 + 블로킹 + 패킹)
source code
더 큰 마이크로 커널(8x4 대신 24x8)과 더 넓은 데이터 폭(AVX2 대신 AVX512)을 사용하여 kernel9를 업데이트했습니다. 다른 모든 전략은 유지됩니다.
image
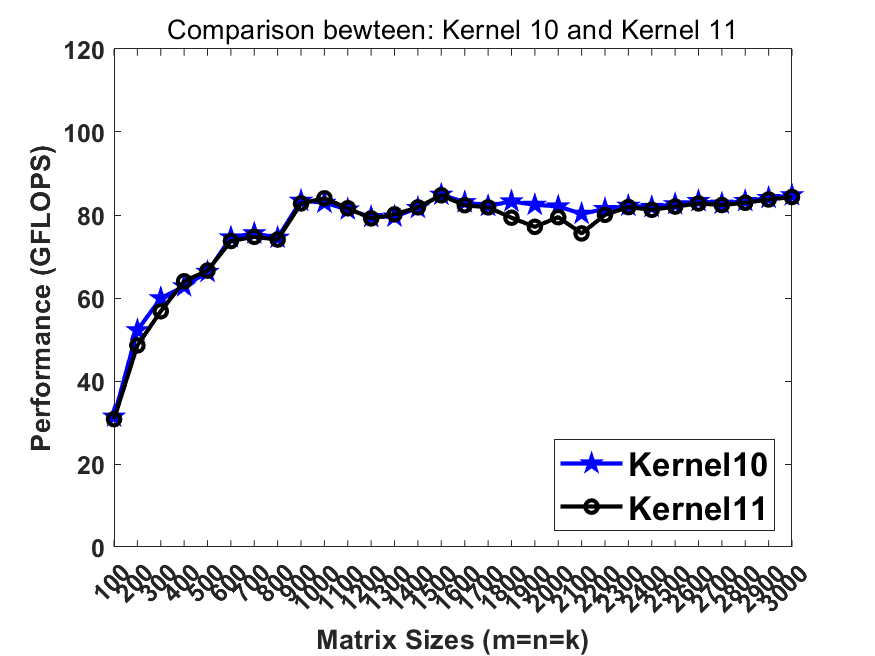
Kernel 11 (Kernel 10 + B에 대한 비연속 패킹)
source code
이전에 kernel10에서는 행렬 B를 완전히 연속적인 메모리 공간으로 패킹했습니다. L2 캐시가 여러 개의 캐시 라인 버퍼(cache line buffers)를 포함하고 있어 L2 하드웨어 프리페처(hardware prefetcher)가 더 낮은 메모리 계층에서 데이터를 미리 가져올 수 있다는 점을 상기할 때, 이 단계에서는 B의 연속적인 메모리 접근을 끊는 것이 L2 하드웨어 프리페처에 도움이 되어 메모리 지연 시간(memory latency)을 추가적으로 숨길 수 있습니다.
image
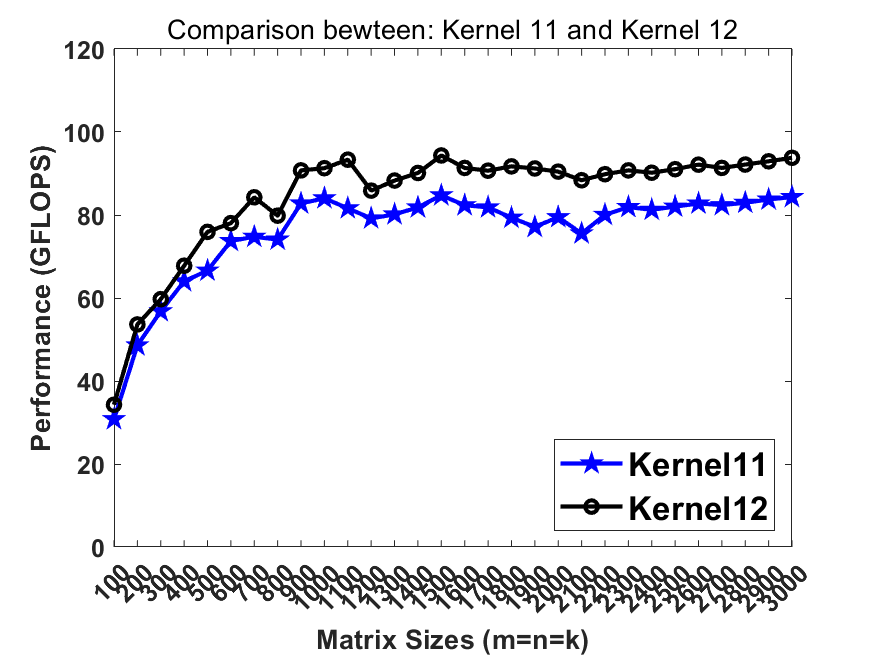
Kernel 12 (Kernel 11: 인트린직스에서 인라인 ASM으로)
source code
image
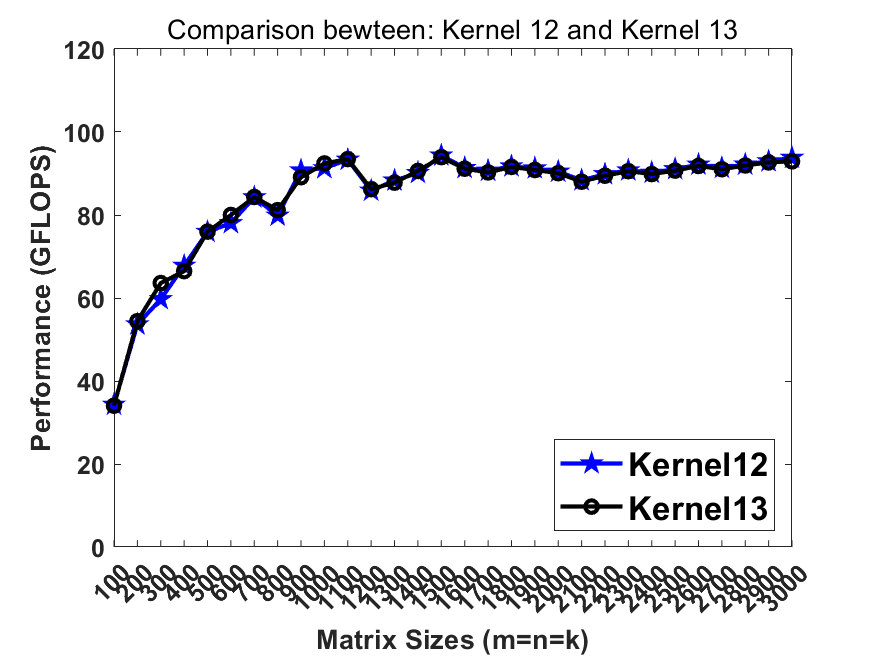
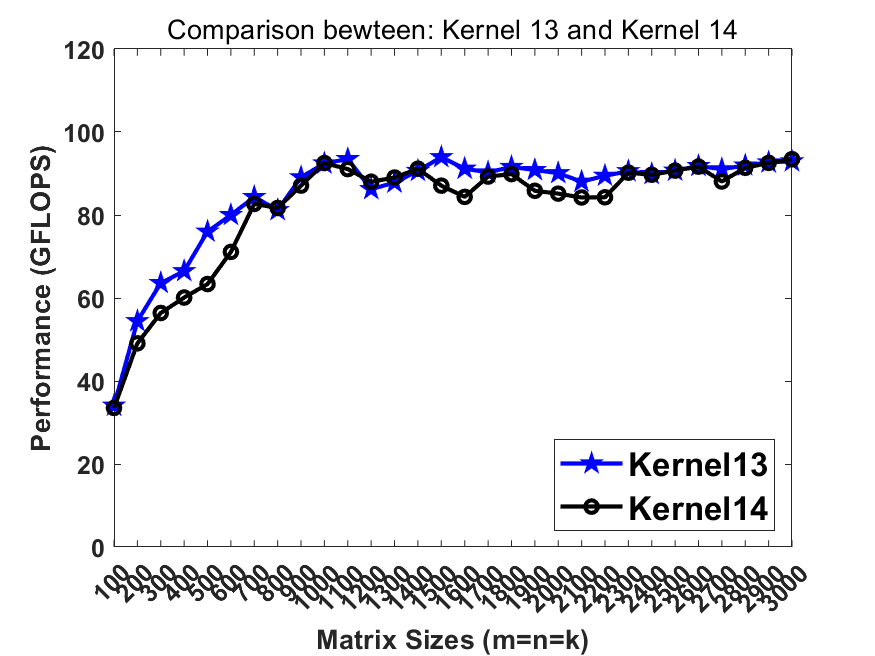
Kernel 13 (Kernel 12 + 전체 매크로 커널을 인라인 ASM으로 변경)
source code
image
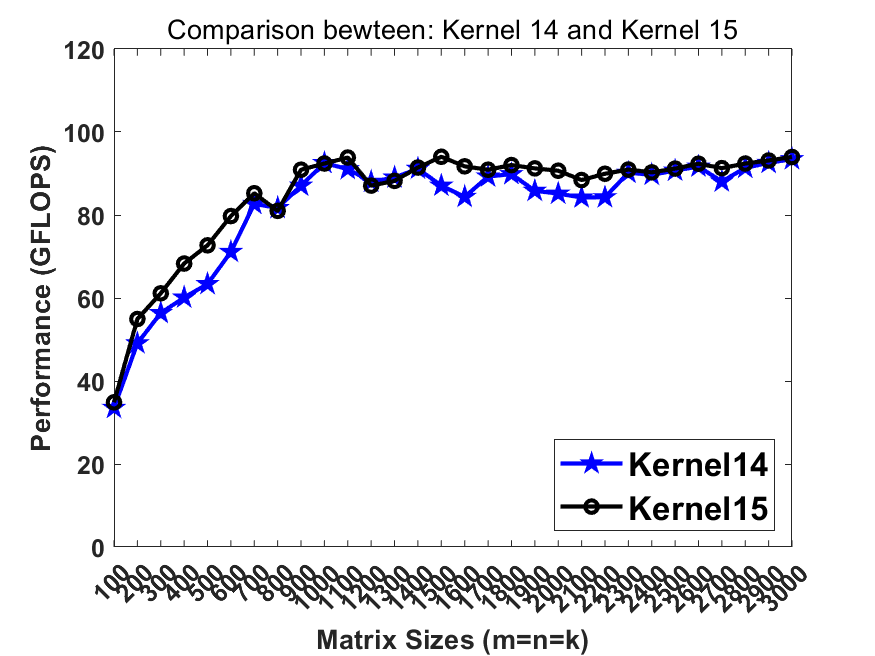
Kernel 14 (Kernel 13에 A에서의 소프트웨어 프리페칭 추가)
source code
image
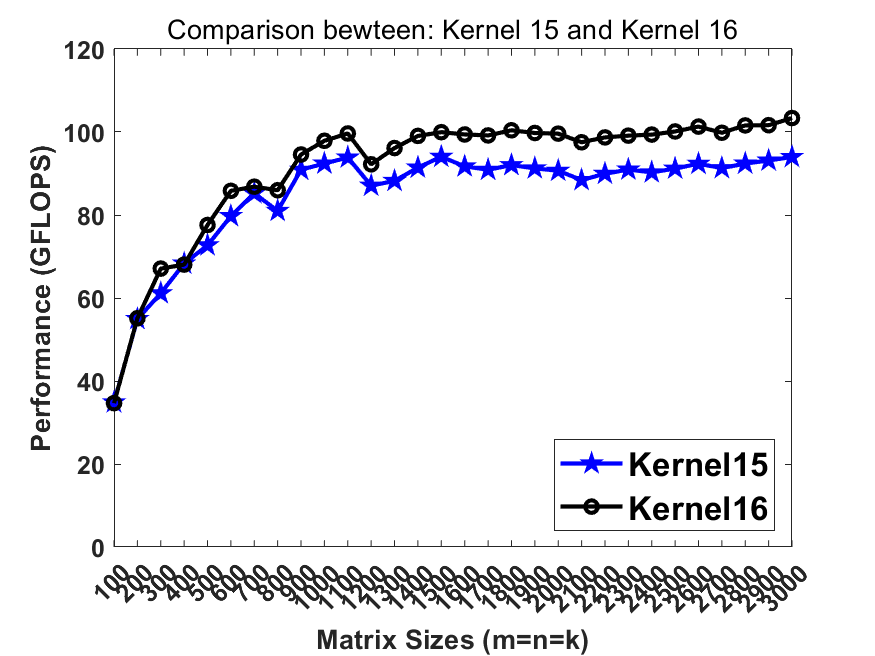
Kernel 15 (Kernel 14에 B에서의 소프트웨어 프리페칭 추가)
source code
image
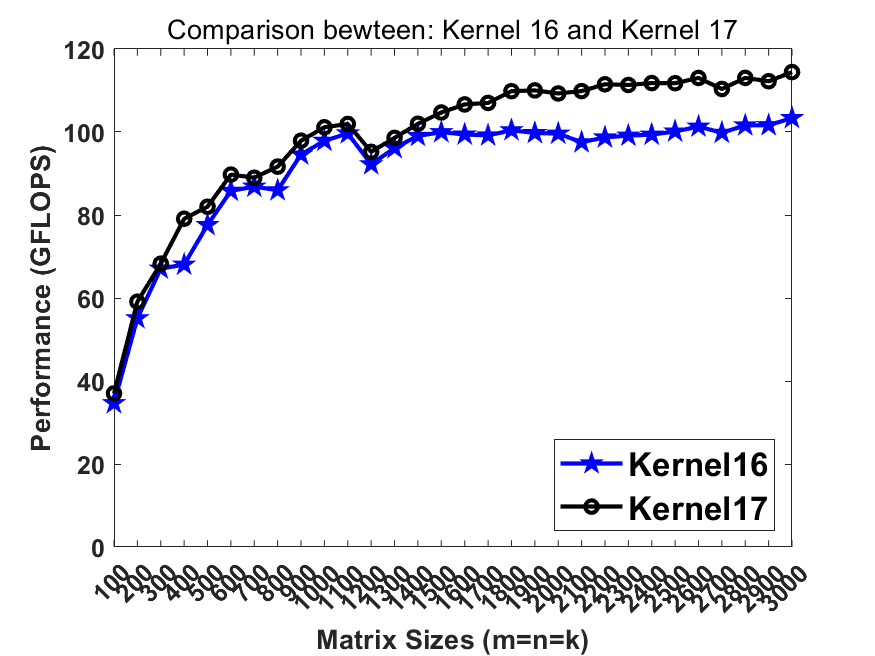
Kernel 16 (Kernel 15에 C에서의 소프트웨어 프리페칭 추가)
source code
image
Kernel 17 (Kernel 16에 C에서의 미세 조정된 행렬 스케일링 루틴 추가)
source code
image
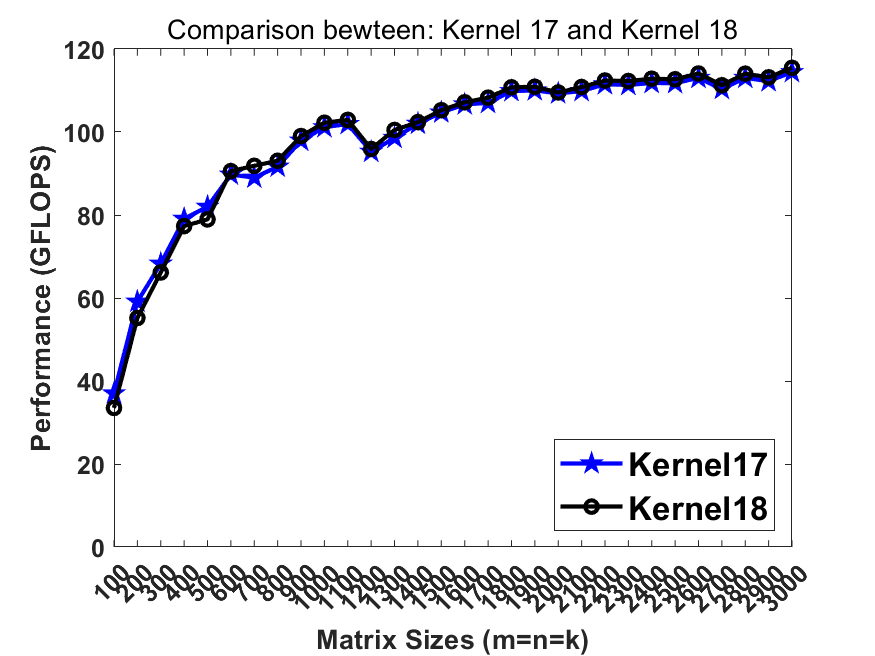
Kernel 18 (Kernel 17에 CPU 주파수 부스팅을 활용하기 위한 B에서의 세밀한 패킹 적용)
source code
image
Intel MKL 대비 Kernel 18 비교
image