
Apple 연구원들이 유휴 Mac을 활용해 가상 GPU 클라우드 'Minions' 구축
요약
Apple 연구원들이 유휴 Mac을 활용하여 'Minions'라는 가상 GPU 클라우드를 구축했습니다. 이 시스템은 AI 추론 작업을 네트워크상의 Mac으로 분산 처리하여, 기존의 긴 대기 시간을 획기적으로 단축시킵니다. Minion Server와 Executor를 통해 풀 기반 실행 모델로 작동하며, Apple Silicon에 최적화되어 있습니다.
핵심 포인트
- 유휴 Mac을 활용한 가상 GPU 클라우드 'Minions' 구축
- AI 추론 작업의 대기 시간을 몇 분 단위로 단축시키는 효율성 제공
- 풀 기반(pull-based) 실행 모델로 중앙 스케줄러 없이 분산 처리
- Apple Silicon에 특화되어 Hugging Face 및 Ollama 활용 가능
Apple은 자체적으로 ‘Minions’라는 시스템을 사용하고 있는데, 이는 유휴(idle) Mac들로 구성된 ‘가상 GPU 클라우드’입니다. 이 시스템은 Apple 연구원들이 발표한 최근 arXiv 논문에 설명되어 있습니다. 이 시스템은 AI 작업이 중단되는 경우(stalled AI jobs), 과거에는 10시간 이상의 회사 GPU 대기열을 거쳐야 했던 작업을 네트워크상의 Mac으로 분산 처리하여, 결과적으로 대기 시간을 몇 분까지 단축시키는 데 도움을 줍니다. 회사의 Slack에서 사용자가 요청하는 것만으로도 작업이 시작될 수 있지만, 연구원들은 팀의 데이터가 그룹 외부 장치에서 실행되는 것에 대한 일반적인 우려를 관찰했습니다.
Apple의 Machine Learning Research 사이트에서도 공유된 이 논문은 해당 시스템에 ‘Minion Server’, ‘Minion Executor’, 그리고 ‘Minion Watchdog’가 있다고 설명합니다. 이 시스템은 AI 추론(inference) 작업만을 위해 Apple Silicon에 특화되어 작동합니다. 처리되는 작업에는 오픈 소스 Hugging Face 트랜스포머 모델을 사용한 임베딩(embeddings)과, 각 참여 Mac에 설치된 Ollama를 통한 대규모 언어 모델(large language models)의 텍스트 생성 작업이 있습니다.
Minion Server는 제출된 작업을 서브태스크(subtasks)로 분할하고 이를 PostgreSQL 데이터베이스에 저장하는 방식으로 작동합니다. 그런 다음, 각 Mac에서 Minion Executor가 실행되어 REST API를 통해 다음 서브태스크를 가져옵니다. 이 ‘풀 기반 실행 모델(pull-based execution model)’에는 중앙 스케줄러가 없습니다. Mac은 Amazon S3에서 입력을 읽고, 필요한 경우 모델을 가져와 자체 GPU에서 서브태스크를 실행한 후, 결과를 다시 S3로 반환합니다.
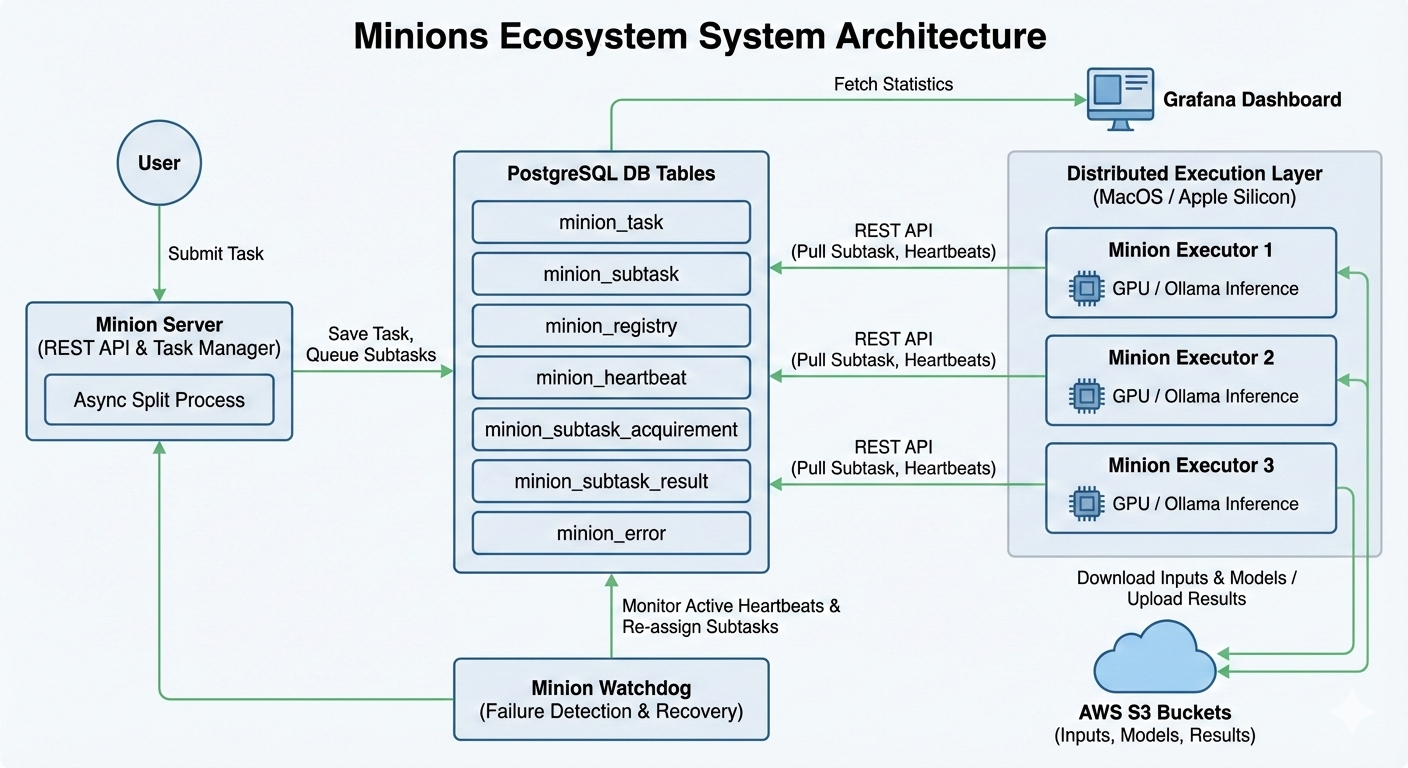
(이미지 출처: Apple (AI 생성))
작동 중 발생하는 오류는 Minion Watchdog이 포착합니다. 이 Watchdog은 작업 수행 Mac들이 5분마다 보내는 하트비트(heartbeats)를 추적합니다. 예를 들어, Mac이 절전 모드로 들어가거나, 네트워크에서 연결이 끊기거나, 전원이 꺼지거나, 사용자가 장치를 다시 제어하기 위해 실행기를 중단하는 경우, 완료되지 않은 서브태스크는 대기열로 되돌아갑니다. 소유자는 ‘동적 작업 바인딩(dynamic task binding)’을 통해 특정 팀이나 프로젝트의 작업을 우선시하도록 Mac이 어떤 작업을 먼저 처리할지 결정하거나, 기본 순서인 선입선출(first-in, first-out) 방식을 신뢰할 수 있습니다.
우리가 이해하기로는 각 Mac이 자체 작업량으로 전체 모델을 구동하며, 논문은 단일 모델이 여러 Mac에 분할되어 실행된다고 제안하지 않습니다. 통합 메모리(unified memory)를 가진 하나의 Mac 하드웨어에서 모델을 완전히 구동하는 것은 자신의 홈 랩(home lab)에서 같은 작업을 수행하는 OpenClaw 애호가들에게는 놀라운 일이 아닐 것입니다. 자원봉사 컴퓨팅(volunteer computing) 측면 역시 새로운 것이 아니며, 논문에서 설명된 아키텍처를 기반으로 SETI@home이나 Folding@home의 작은 청크 분배 모델을 연상시킵니다.
GPU 대기 시간 감소 외에도, 이 논문은 Minions를 사용한 요청이 새로운 GPU 요청을 필요로 하지 않으며, 인프라 비용이 0으로 처리되고, 확장 노력이 수동(manual)에서 유기적(organic)으로 바뀐다고 언급합니다. 여기에는 전력 비용이나 하드웨어 마모는 포함되지 않습니다.
참여는 비공식적으로 이루어지며, 팀원들은 예를 들어 “Slack 메시지를 보내 다른 사람들에게 Minion Executor를 일시적으로 실행하고 특정 프로젝트나 작업을 목표로 할 것을 요청”할 수 있습니다. 기밀성은 내부 작업에서도 여전히 우려 사항이며, Apple은 자체 데이터베이스와 별도의 Mac 풀을 이용한 팀 및 조직 범위 배포(team- and organization-scoped deployments)로 이를 완화하는 것을 목표로 합니다.
이 새로운 논문은 컴퓨팅 자원이 AI 관련 워크로드에 점점 더 병목 현상을 일으키는 시점에 나왔습니다. Apple은 지난 7월 분기 보고서에서 이에 대해 인정하며, “제한된 공급, 연장된 리드 타임, 증가하는 비용을 가진 생태계 내 충분한 컴퓨팅 자원에 대한 접근성”에 달려 있다고 말했습니다. 자체 데이터 센터와 서드파티 클라우드 제공업체를 이용하더라도 “충분한 용량을 확보하지 못할 수 있다”는 위험은 Minions 접근 방식을 더욱 실용적으로 보이게 합니다.
Apple의 Private Cloud Compute는 복잡한 요청을 위한 Apple Intelligence의 서버 측 기능을 담당하며, 지난 6월 WWDC에서 처음 발표된 이후 이제 Nvidia GPU를 사용하는 Google Cloud에서도 구동됩니다 [링크]. 이는 현 CEO 팀 쿡이 지난 4월 Mac mini와 Mac Studio 공급이 [몇 달 동안 부족할 수 있다]고 언급한 후, 로컬 AI에 대한 갑작스럽고 높은 수요가 발생했기 때문입니다 [링크]. 또한, 7월 실적 발표에서 논의된 기기 공급 관련 내용에서는 [첨단 공정 제약 및 증가하는 메모리 비용]도 언급되었습니다 [링크].
저자들은 향후 작업에서 Minions가 분산 모델 학습으로 확장될 것이라고 말합니다. 더 광범위하게는, 조직 전반 또는 잠재적으로 글로벌 커뮤니티에 걸쳐 유휴 Mac을 “안전하게 연합(federated)”할 수 있다면, 이들이 공유 GPU 풀을 형성할 수 있다고 그들은 작성했습니다. 현재로서는 Mac이 Apple 내부에서만 초과 AI 용량으로 작용합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기