AMD의 EPYC 'Venice' CPU는 새로운 Zen 6 아키텍처를 처음으로 선보이며, 지난 몇 주 동안 이 범위에서 나온 두 개의 칩을 테스트하여 Nvidia의 Vera와 비교하고, 더 넓게는 내년 출시가 예상되는 소비자 중심의 Olympic Ridge 대비 Zen 6 아키텍처가 어떻게 발전했는지 확인했습니다. Zen 5는 AMD의 오랜 역사를 지닌 Zen 코어의 처음부터 다시 설계된 것이었으며, Zen 6은 그 기반을 가져와 거의 모든 면에서 확장했습니다.
Zen 6은 TSMC의 N2P 노드를 사용하지만, 내부적으로도 상당한 아키텍처 변경 사항이 있습니다. 코어 내에서는 재설계된 벡터 엔진(vector engine)이 AMD의 SIMD 성능을 더욱 높이며, 이제 전체 32비트 정밀도와 함께 하프-프리시전 FP16 명령어까지 네이티브로 지원합니다. 또한 실행 엔진(execution engine) 내에서 정수 스케줄러(integer schedulers)를 분할하여 코어를 통해 더 많은 인스트럭션(instructions in flight)을 처리할 수 있게 했습니다.
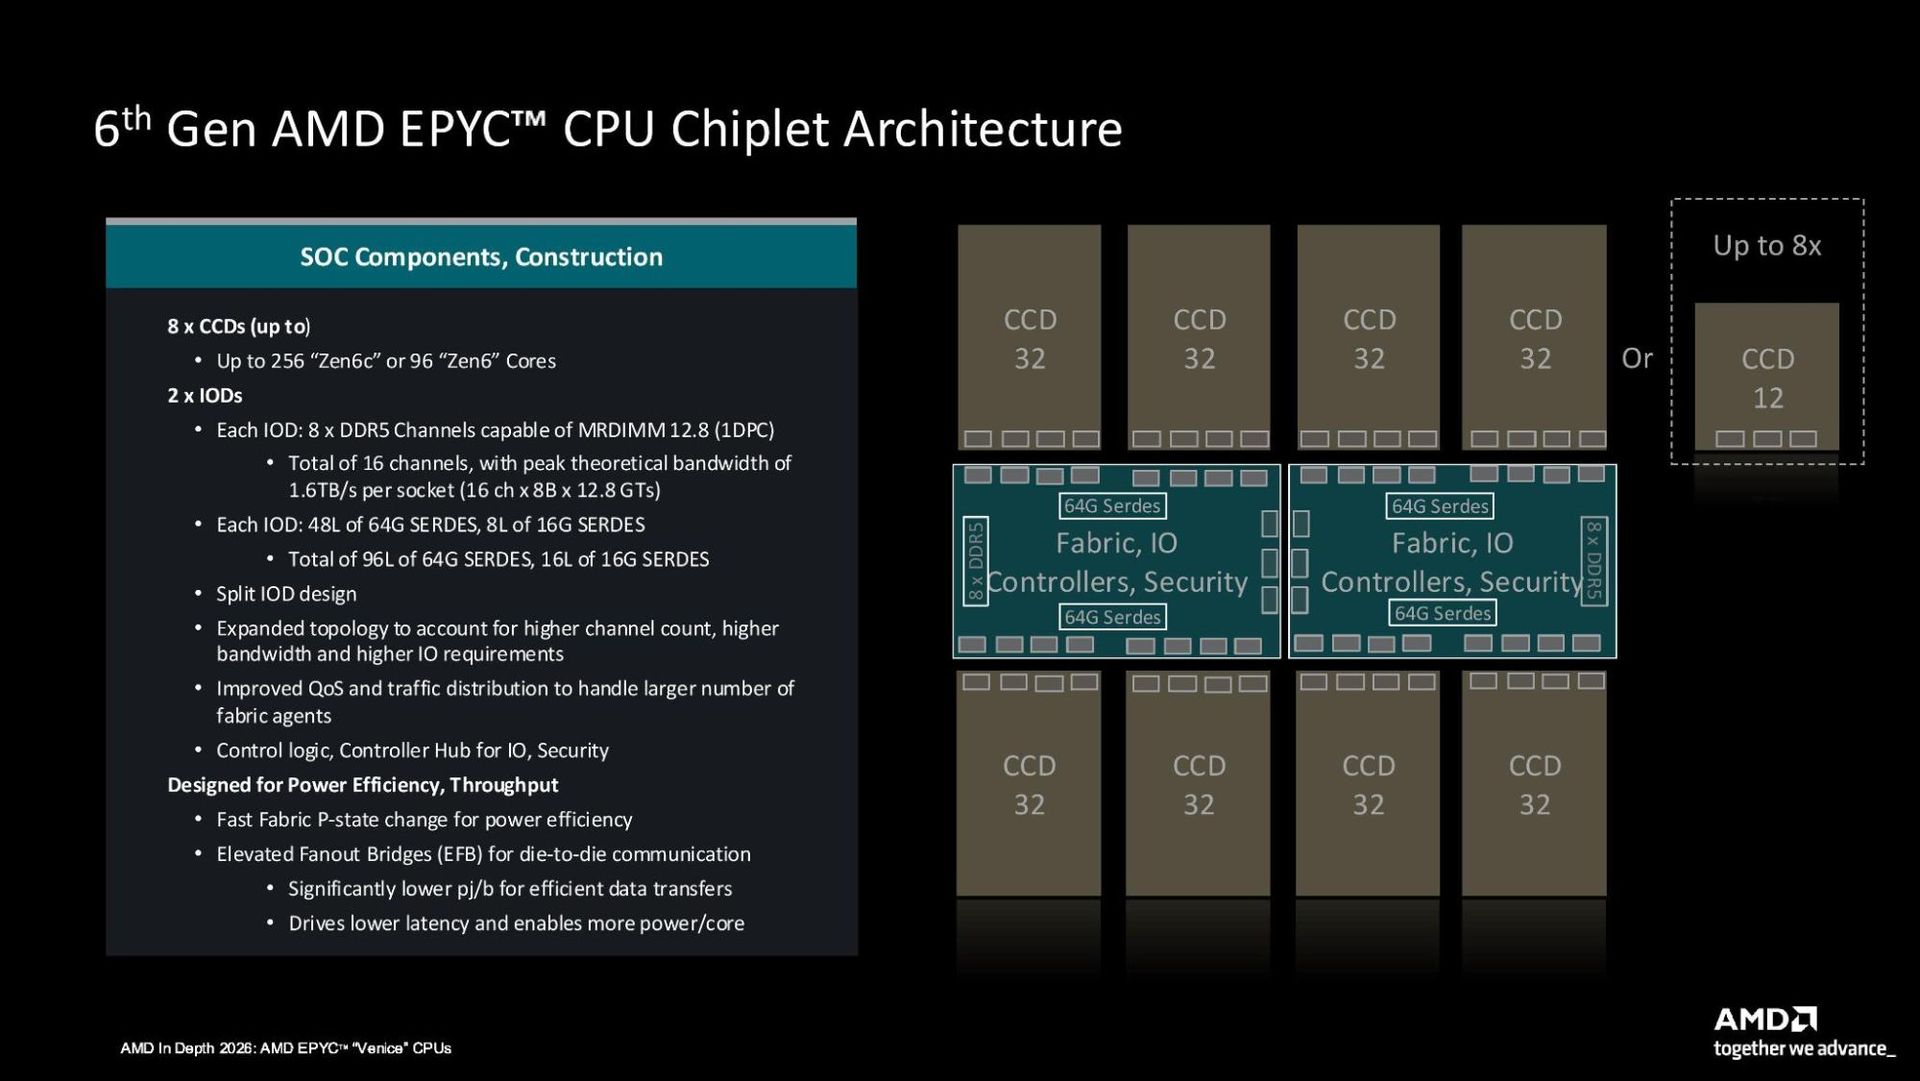
다이 전반에 걸쳐 AMD는 다른 중요한 변경 사항들을 적용했습니다. 이전 세대의 단일 IOD(Input/Output Die)가 이제 두 개의 IOD로 분할되어, SP7 플랫폼에 16개의 메모리 채널 접근성을 제공합니다 (물론 이는 이전 세대 및 SP8 플랫폼 대비 PCIe 6.0 레인 수의 감소라는 대가를 치렀습니다).
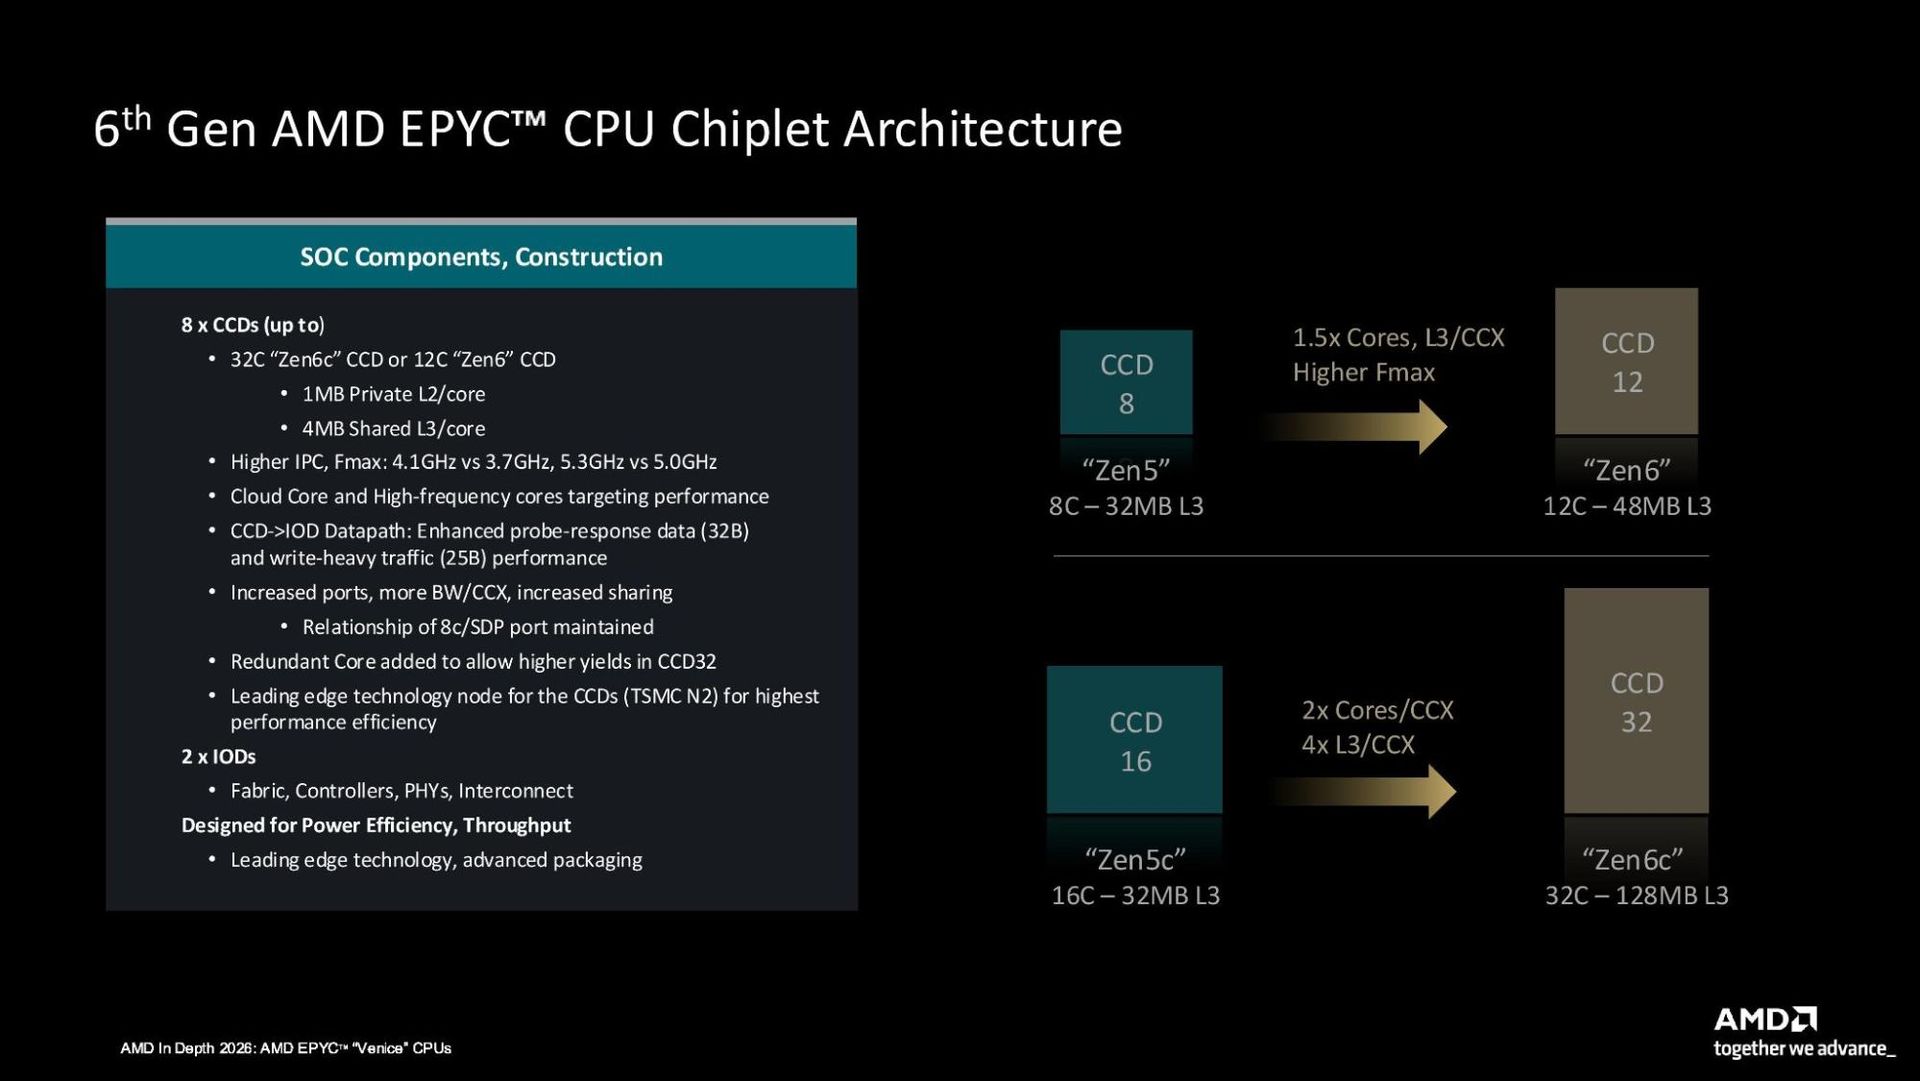
CCD(Core Compute Die) 역시 Zen 3 이후 처음으로 업그레이드되었습니다. 표준 Zen 6 CCD는 이제 최대 12코어까지 확장할 수 있으며, Zen 6c는 32코어를 탑재합니다. Zen 5와 5c의 경우, CCD는 각각 최대 8코어와 16코어에 머물렀습니다. Zen 6c CCD의 경우, AMD는 또한 코어당 공유 L3 메모리 양을 두 배로 늘렸는데, 이는 CCD가 두 배의 코어를 탑재하기 때문에 Zen 5c 대비 실질적으로 L3를 네 배로 증가시킨 것입니다.
흥미롭게도, Zen 6은 Zen 5에 대한 사소한 최적화도 아니며, 완전한 아키텍처 재설계도 아닙니다. 되돌아보면, AMD는 접근 가능한 모든 다이얼을 최고 수준으로 밀어붙인 것처럼 보이며, 이는 성능 면에서 입증되고 있습니다.
256코어 EPYC 9996은 2P 구성에서 1,024 스레드를 제공하며, 이는 우리가 SPEC CPU 2026의 intrate throughput 테스트에서 검증한 768스레드 2P EPYC 9965 서버보다 93% 앞선 수치입니다. 주파수 최적화된 EPYC 9686F는 과학 컴퓨팅 및 HPC(고성능 컴퓨팅) 워크로드 등 다른 분야에서 탁월하며, 적어도 AMD의 LPDDR 기반 Verano 플랫폼이 내년에 출시되기 전까지는 Vera에 대한 경쟁력을 갖추고 있습니다.
AMD는 Venice가 근본적으로 경쟁사보다 한 세대 앞서 있다고 믿으며, 만약 데이터로 뒷받침되지 않는다면 가치가 없는 주장이 될 것이라고 말합니다. Intel의 Granite Rapids-AP는 논의에서 거의 언급되지 않지만, [Vera가 일부 경쟁적 위치를 유지하고 있음]에도 불구하고 Venice는 종종 앞서 나가며—때로는 수 배에 달하는 격차를 보입니다.
Intel의 Diamond Rapids는 내년에 출시될 예정이며, 이는 균형을 맞추는 데 도움이 될 것입니다. 하지만 AMD는 Venice로 믿을 수 없을 정도로 높은 기준을 설정했으며, [Venice-X]와 [내년 Verano]가 등장함에 따라 일부 워크로드에서는 이 기준을 더욱 높일 가능성이 큽니다.
여기에는 다룰 내용이 매우 많습니다. Zen 6 마이크로아키텍처에 대한 전체 심층 분석, 칩 자체에 대한 광범위한 검토, AMD가 이번 세대에 출시하는 플랫폼들, 그리고 물론 Python 성능부터 HPC까지 모든 것을 포괄하는 100개 이상의 벤치마크를 다룰 예정입니다.
AMD Zen 6 마이크로아키텍처 분석
AMD Zen 6 마이크로아키텍처 분석
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)
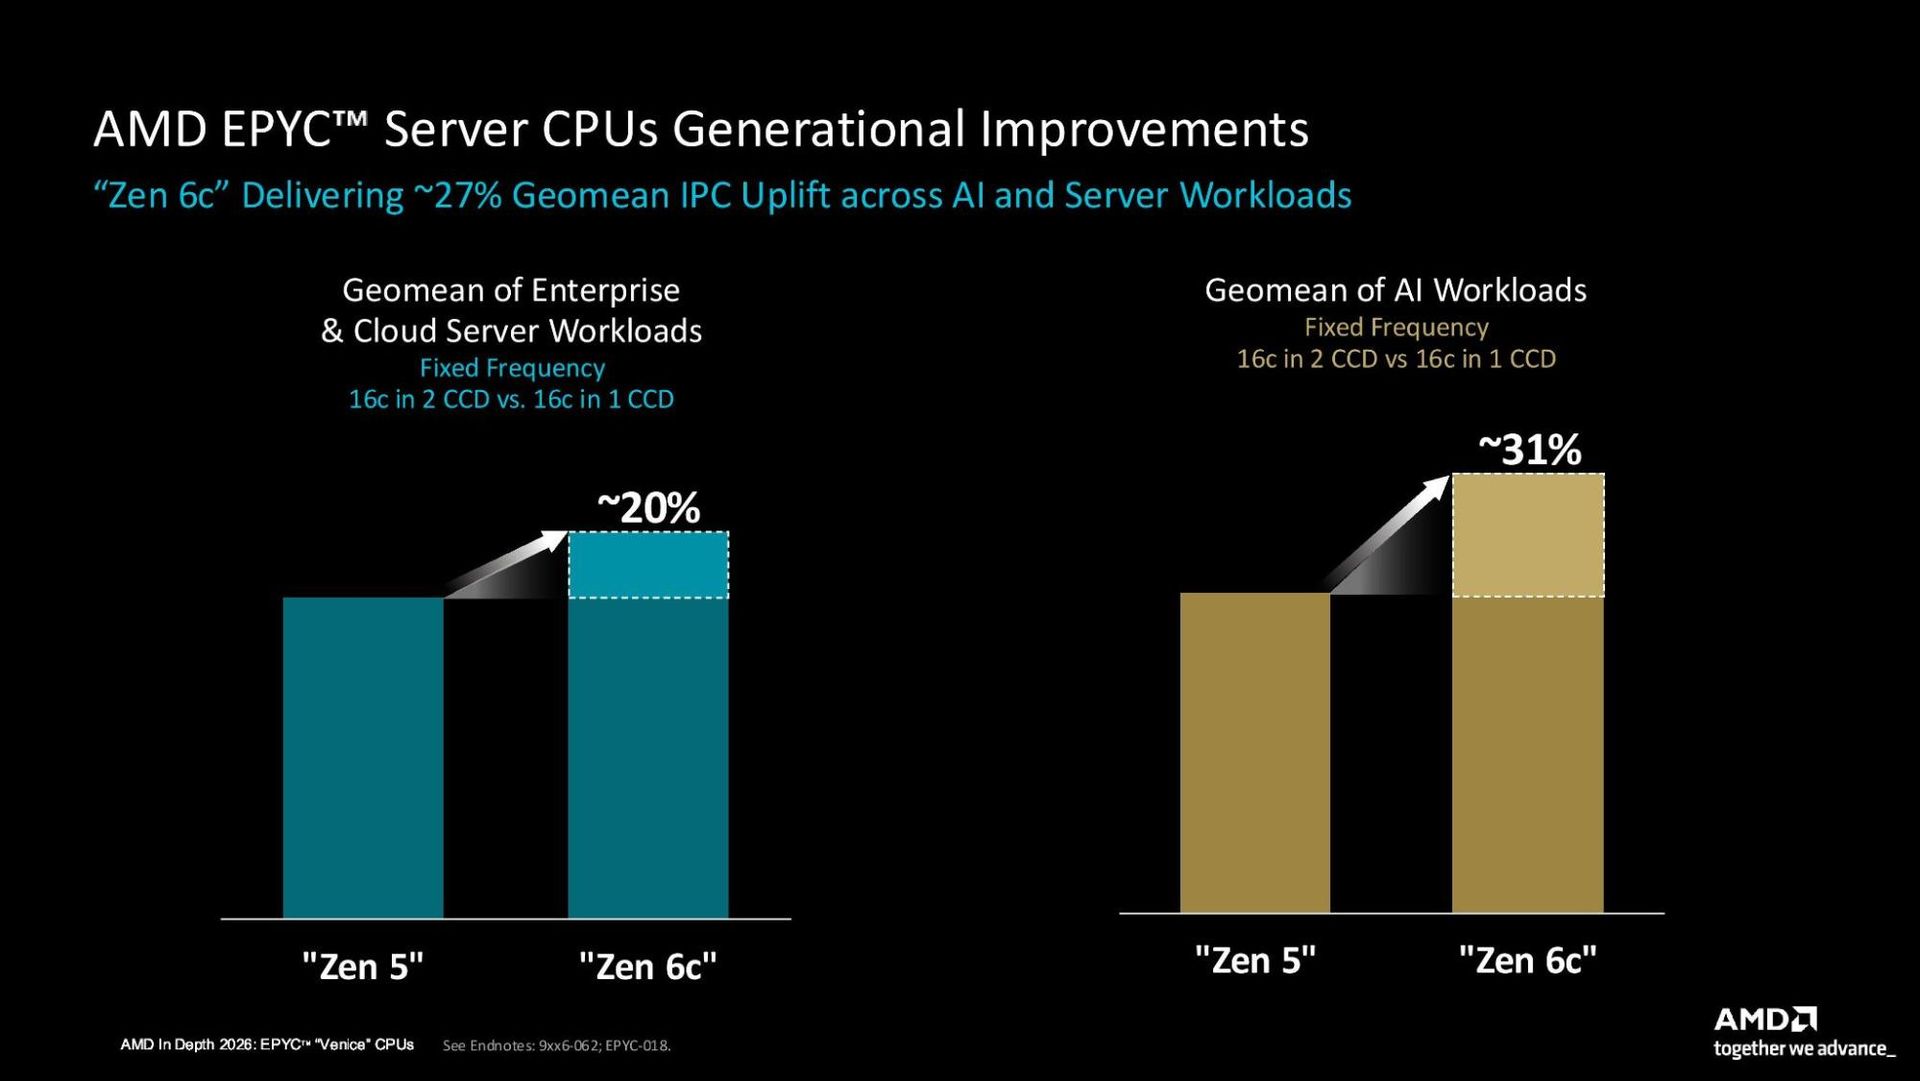
Zen 6의 주요 특징은 엔터프라이즈, 클라우드 및 AI 워크로드에서 Zen 5 대비 평균 27%의 IPC(Instructions Per Cycle) 향상입니다. 이 새로운 마이크로아키텍처는 데이터 센터에 초점을 맞추었으므로, 이 27%의 IPC 개선이 모든 워크로드에 광범위하게 적용된다고 받아들여서는 안 됩니다. 또한, AMD는 고정 주파수의 Zen 5와 코어 16개를 가진 Zen 6c를 비교하여 해당 수치를 도출했습니다. 다음 섹션에서 다룰 내용이지만, Zen 6c CCD는 여유 공간을 두고 코어 16개를 충분히 수용할 수 있는 반면, Zen 5의 코어 16개는 두 개의 CCD에 분산되어 있습니다.
컴퓨트 다이(compute die)는 TSMC의 N2P 노드에 구축되었으며, 이는 이미 최적화된 N2 버전으로 5%의 성능 향상을 제공합니다. N3E(Zen 5는 N4P 사용)와 비교했을 때, N2P는 동일 전력(iso-power)에서 18%의 속도 향상 또는 동일 속도에서 36%의 전력 감소를 제공합니다.
<table><tbody><tr><td class="firstcol empty"></td><td><p><strong>속도 개선 (v. N3E)</strong></p></td><td><p><strong>전력 개선 (v. N3E)</strong></p></td><td><p><strong>밀도 (v. N3E)</strong></p></td></tr><tr><td class="firstcol "><p><strong>TSMC N2P</strong></p></td><td><p>+18% (iso-power)</p></td><td><p>-36% (iso-speed)</p></td><td><p>+15%</p></td></tr></tbody></table>
AMD는 이 마이크로아키텍처가 2024년 중반에 처음 공개되었을 때 Zen 5를 전면 재설계(ground-up redesign)라고 설명했습니다. 이는 사이클당 8개의 명령어를 디스패치하고 반환할 수 있는 더 넓은 실행 엔진, 이를 공급하는 더 넓은 프론트엔드, 완벽한 AVX-512 지원, 그리고 L2 및 L1 캐시 간의 두 배가 된 대역폭 등의 특징을 가집니다. Zen 6은 Zen 5에서 본 재설계의 연속입니다. 이는 여러 면에서 향상되었을 뿐만 아니라, 많은 동일한 특징과 일반적인 토폴로지(topology)를 유지하고 있습니다.
분석을 진행하면서 Zen 6과 Zen 6c가 동일한 마이크로아키텍처를 사용한다는 점을 염두에 두십시오. Zen 6c는 단순히 전력 소모가 적고, 클럭 속도가 낮으며, 당연히 전체 Zen 6 코어보다 더 적은 다이 공간을 차지하도록 최적화된 설계입니다. 하지만 이 회사는 인텔의 E-코어가 P-코어와 다른 마이크로아키텍처를 사용하는 것과 달리, 코어 내부에는 동일한 마이크로아키텍처를 사용합니다.
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
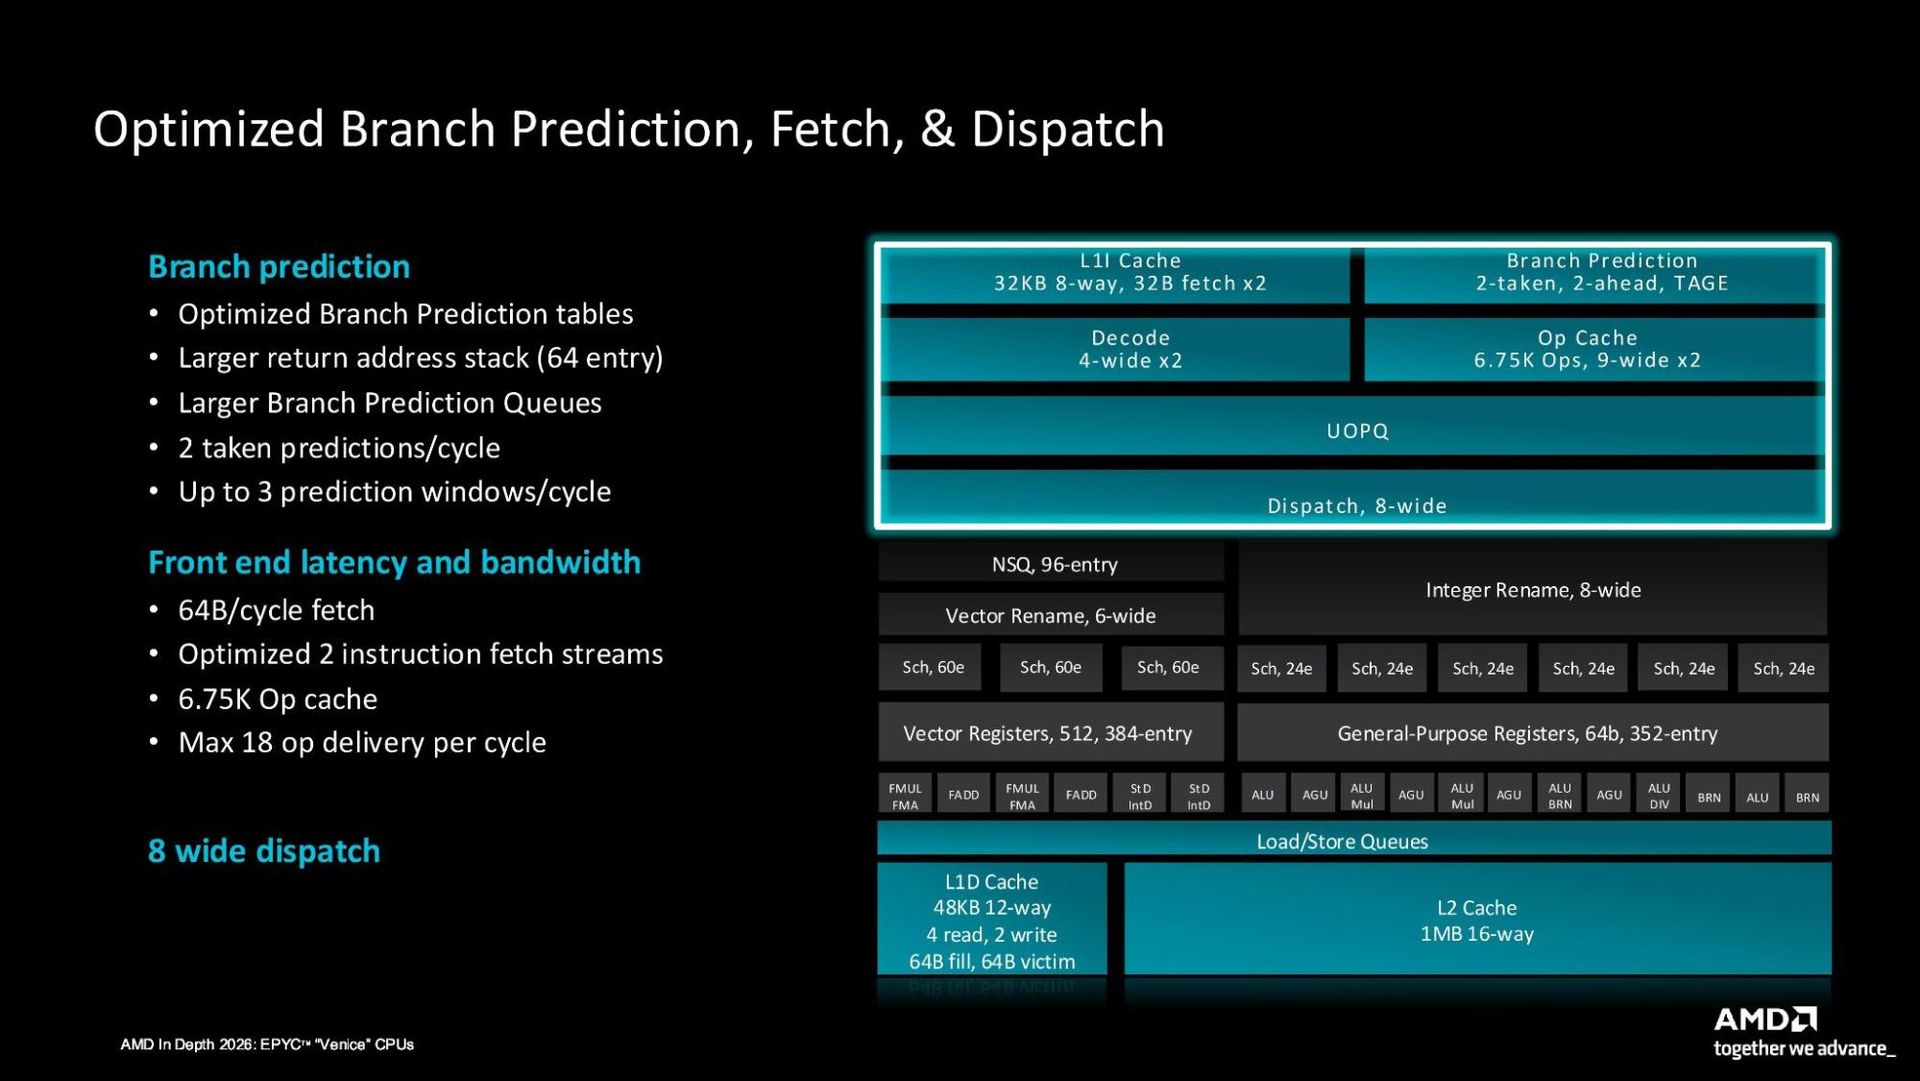
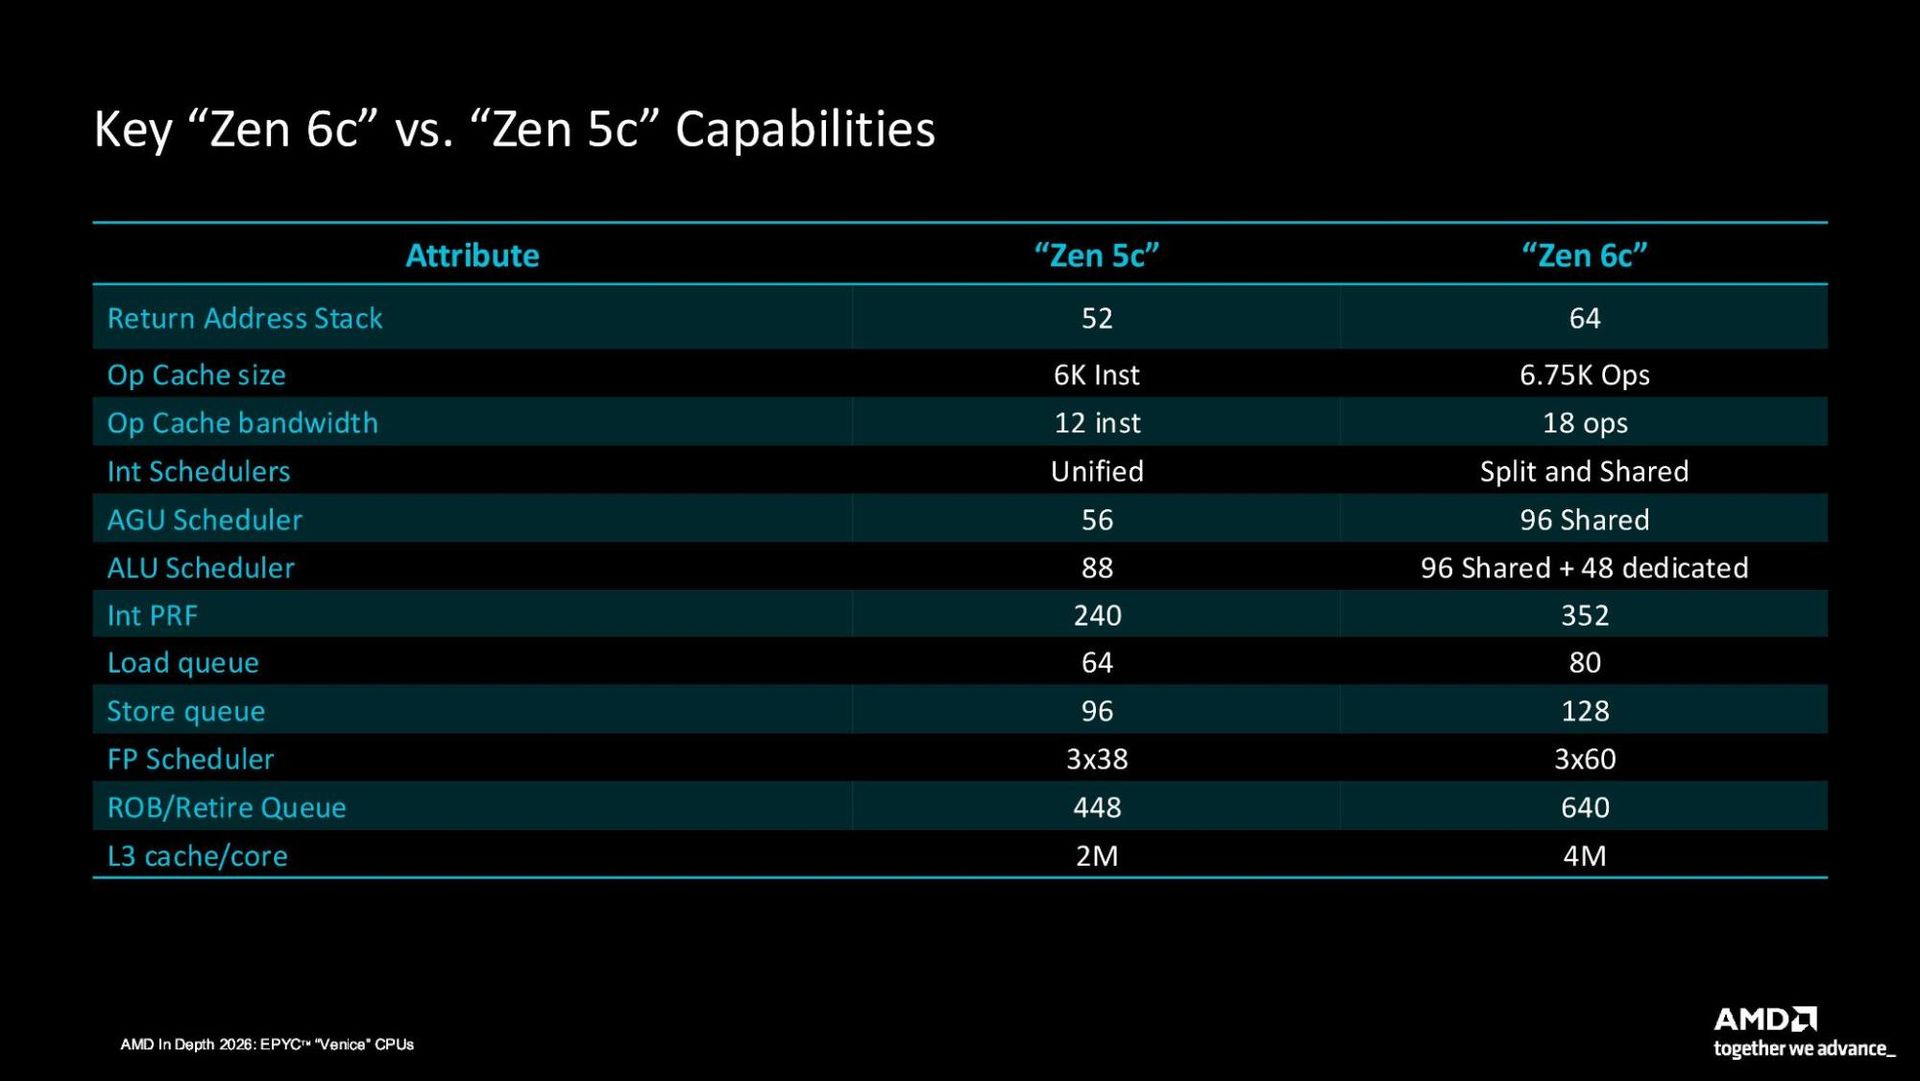
프론트엔드부터 살펴보면, 몇 가지 주목할 만한 개선 사항을 제외하고는 Zen 5와 크게 다르지 않습니다. 동일한 듀얼 4-wide 디코드 파이프와 8-디스패치를 제공하지만, AMD는 BPU(Branch Prediction Unit)와 op cache를 개선했습니다. BPU의 경우, Zen 5의 52개에서 증가하여 64개 항목의 Return Address Stack을 갖게 되었습니다. 또한 AMD는 op cache 크기를 Zen 5의 6K에서 다시 6.75K 항목으로 늘렸습니다 (Zen 4 역시 6.75K 항목의 op cache를 가졌습니다). 이 더 큰 캐시는 Zen 5의 12개에서 증가하여 사이클당 최대 18개의 micro-ops를 제공할 수 있습니다.
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
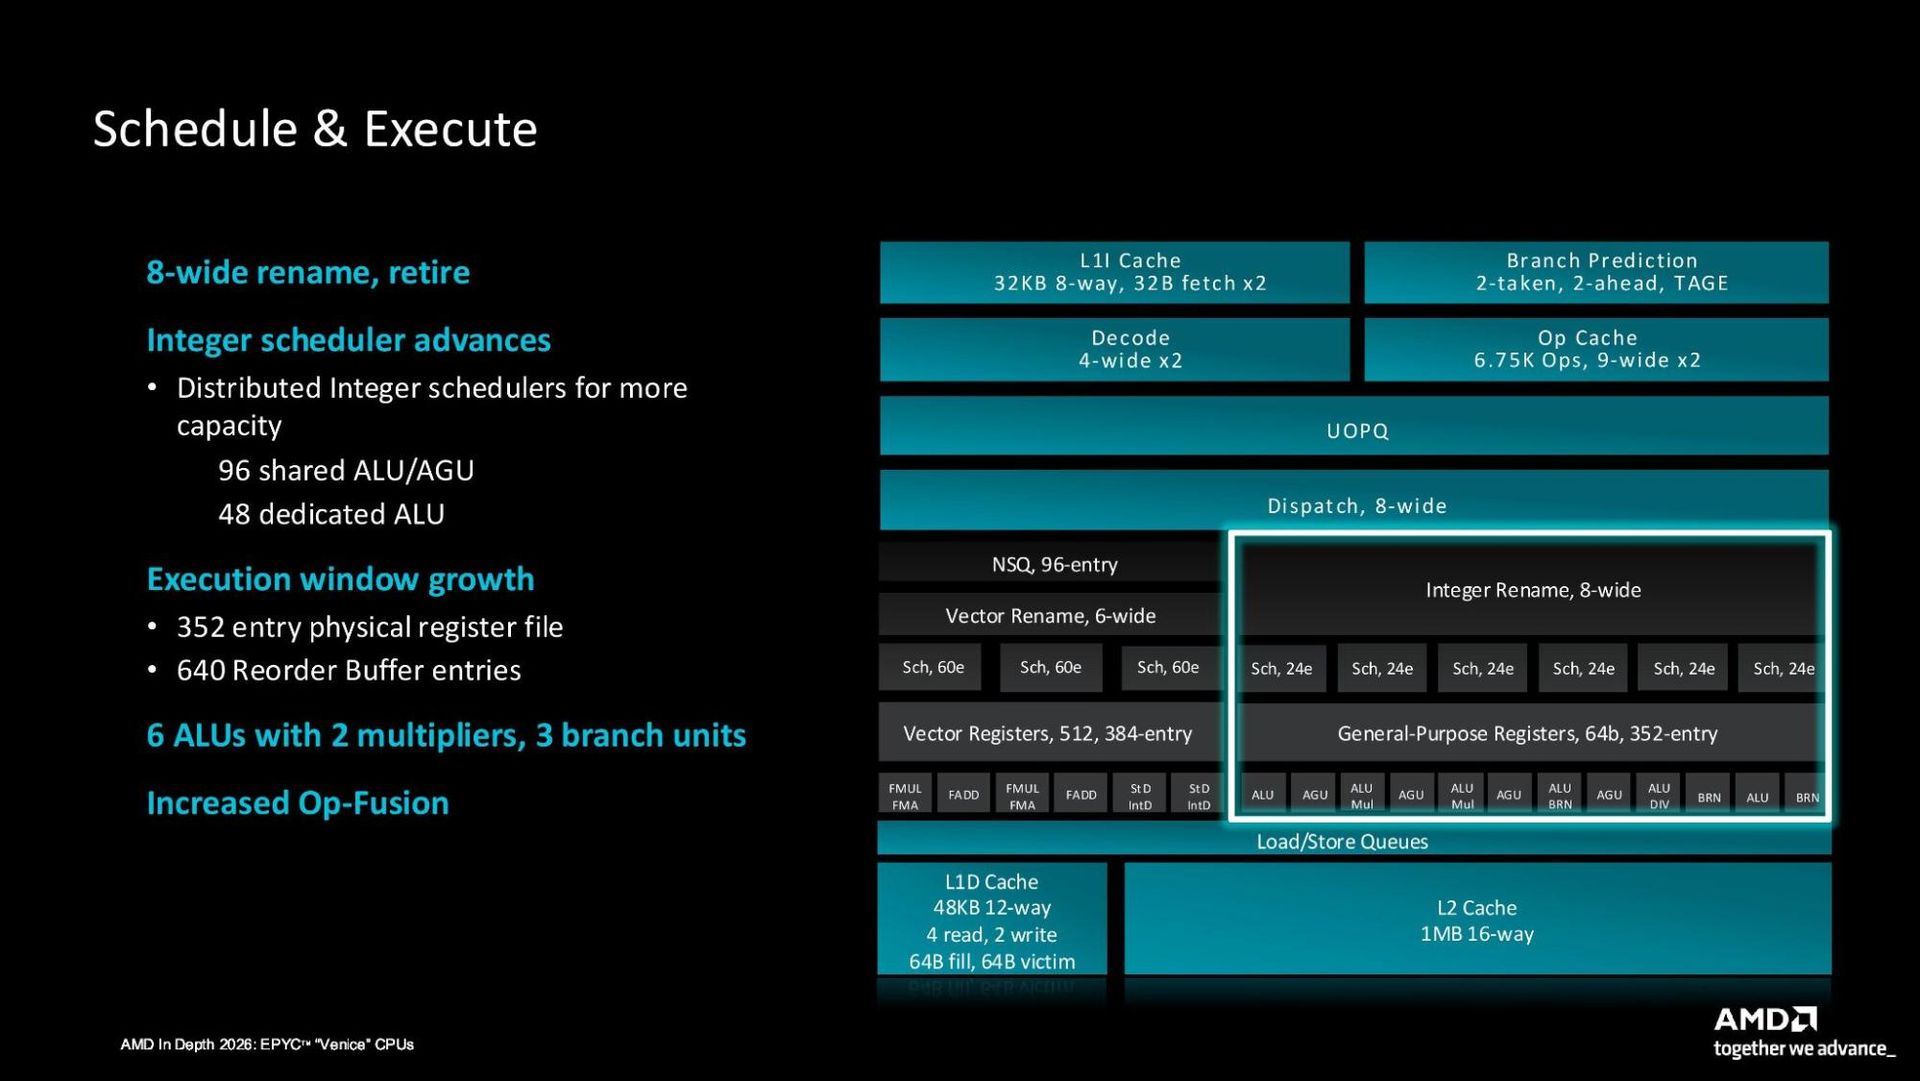
AMD는 Zen 6의 정수 스케줄러를 분리했습니다 (Zen 5는 통합 스케줄러를 가짐). 이제 Zen 5의 ALU/AGU에 대한 88/56 분할과 비교하여, 더 높은 용량을 제공하며 96개의 공유 ALU/AGU와 48개의 전용 ALU 항목을 갖게 되었습니다. 또한 AMD는 범용 레지스터를 Zen 5의 240개에서 증가시켜 352개 항목의 물리적 레지스터 파일(physical register file)로 확장했습니다.
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
벡터 실행 엔진(vector execution engine) 역시 개선되었으며, 이는 Zen 5의 진정한 512비트 레지스터에 이은 것입니다. Zen 6는 해당 512비트 데이터 경로를 계승하고 몇 가지 추가적인 개선 사항을 더했습니다. 특히 주목할 점은, 엔진이 이제 절반 정밀도(half-precision) AVX-512 FP16 명령어를 지원한다는 것인데, 이는 Zen 5의 벡터 실행 엔진에서는 변환이 필요했던 부분이었습니다. 또한 주목할 만한 것은 FP 로드/스토어 대역폭입니다. Zen 5는 모든 크기의 두 개의 로드를 지원하지만, Zen 6는 두 개의 512비트 로드 또는 네 개의 256비트 로드를 지원합니다. 스토어 대역폭은 변경되지 않아, 하나의 512비트 스토어 또는 두 개의 256비트 스토어를 지원합니다.
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
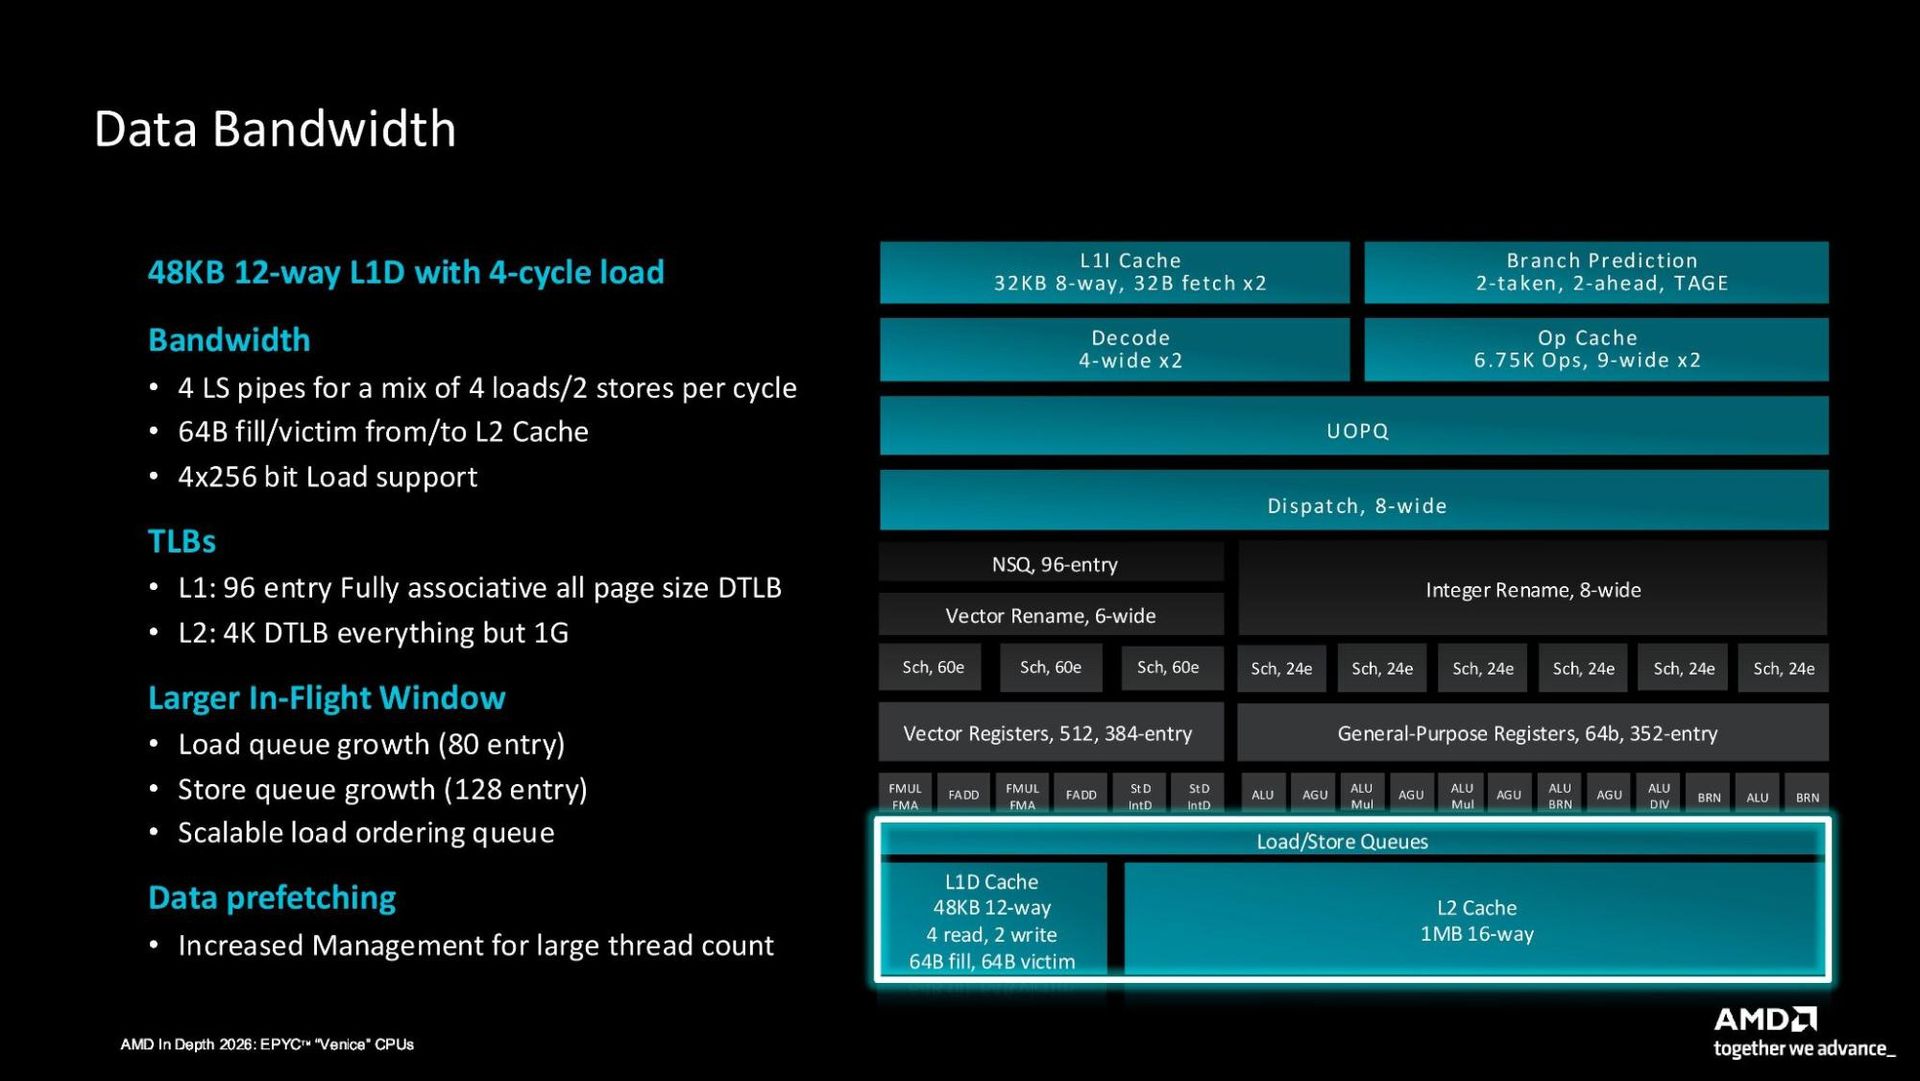
Zen 6은 Zen 5의 48 KB 12-way L1 데이터 캐시와 1 MB 16-way 사설(private) L2를 계승했습니다. 공유 L3는 Zen 5에서도 마찬가지로 L2의 피해자 캐시(victim cache)로 처리됩니다. 하지만 AMD는 Zen 5 대비 인플라이트 윈도우(in-flight window)를 늘려, 로드 큐(load queue)가 80개 엔트리, 스토어 큐(store queue)가 128개 엔트리로 증가했습니다.
AMD Zen 6 및 Zen 6c CCD 및 플랫폼 분석
AMD Zen 6 및 Zen 6c CCD 및 플랫폼 분석
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)
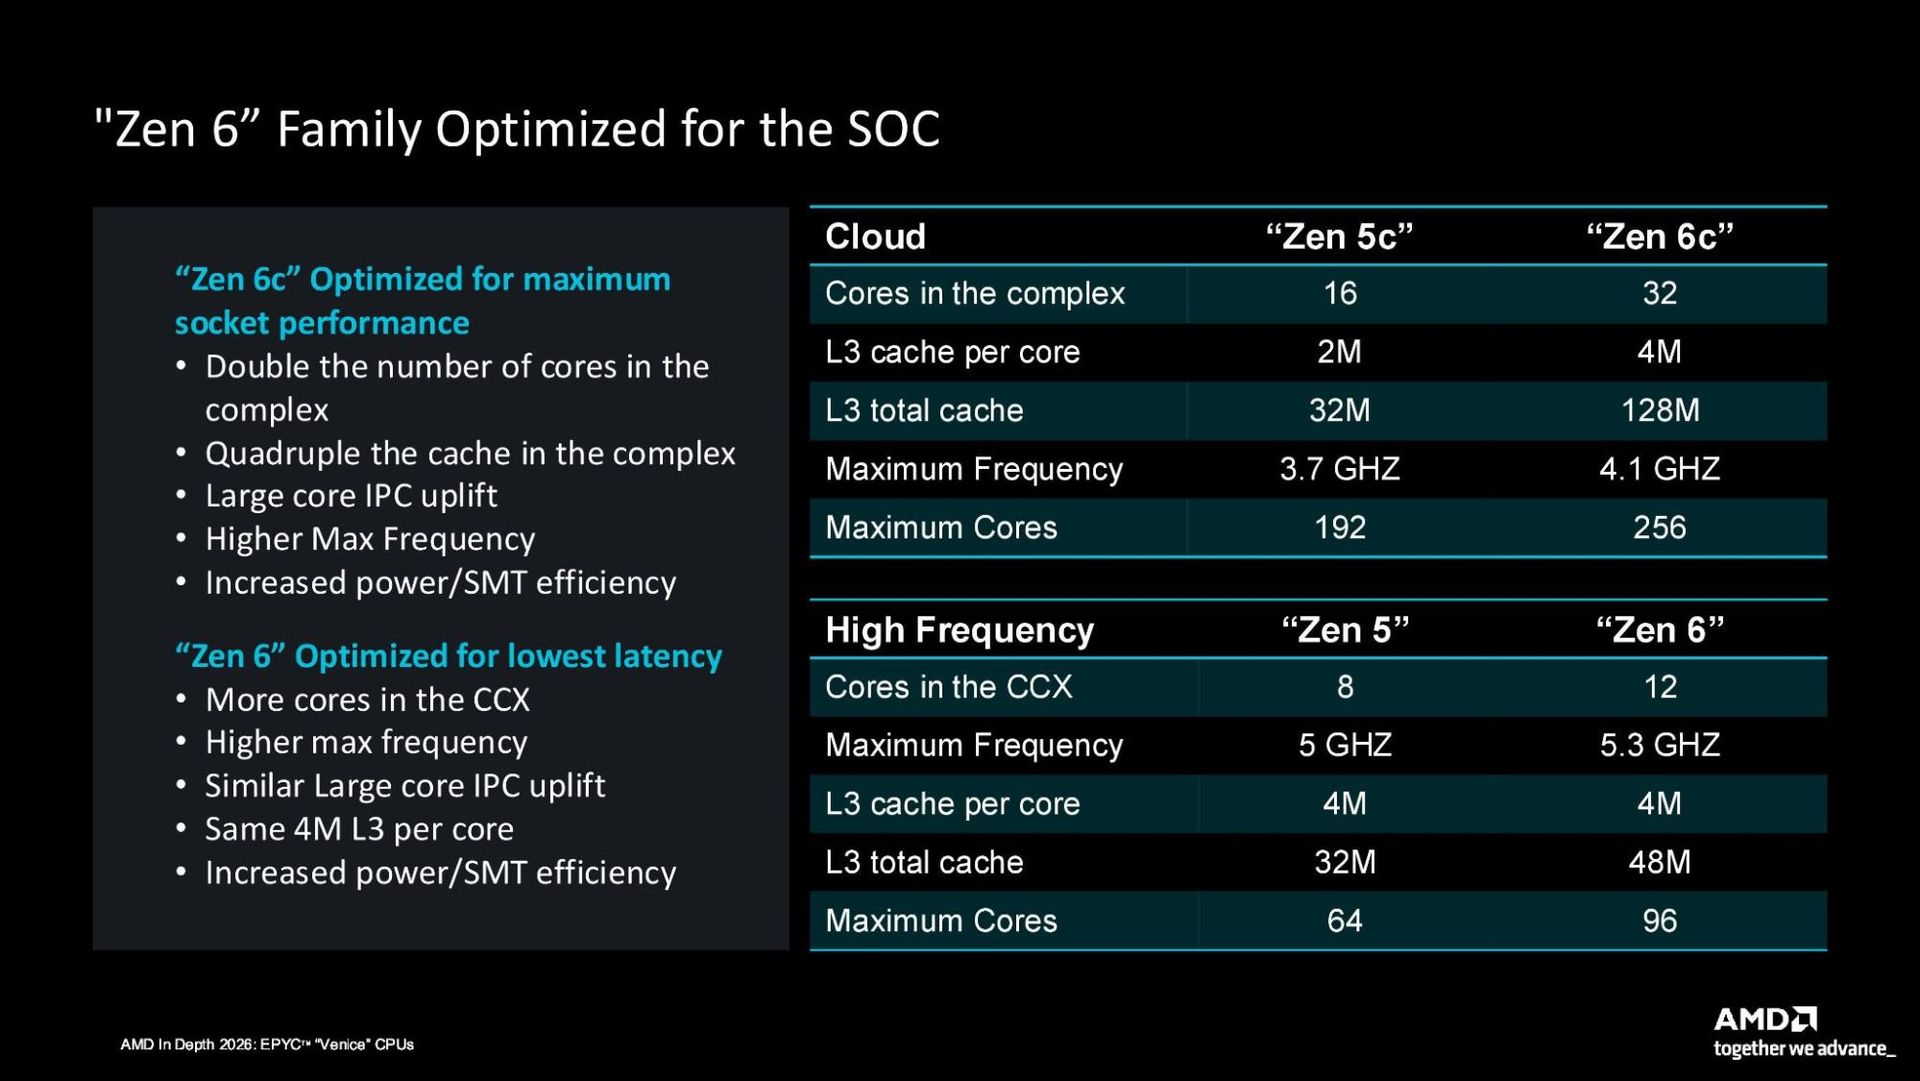
Zen 5에서 Zen 6으로 넘어오면서 가장 큰 변화는 CCD의 밀도에서 나타납니다. Zen 6은 CCD당 최대 12코어를 제공하여 Zen 5의 8코어보다 늘어났으며, Zen 6c는 최대 32개까지 확장되어 Zen 5c 대비 두 배에 달합니다. 그 외의 업데이트된 CCD들은 Zen 5/5c CCD와 동등하거나 개선된 성능을 보여줍니다.
Zen 6의 경우, AMD는 코어당 4 MB의 L3 캐시를 유지하며, 새로운 12코어 제한을 수용하기 위해 총 캐시 용량을 48 MB로 늘렸습니다. 표준 Zen 6 CCD의 최대 주파수는 Zen 5의 5 GHz에서 Zen 6에서는 5.3 GHz로 증가했습니다. 이 클럭은 Venice 환경에서의 것이라는 점을 염두에 두어야 하며, 소비자용 Olympic Ridge에서는 더 높은 최대 부스트 클럭이 예상됩니다.
Zen 6c는 추가적인 개선 사항을 갖추고 있습니다. AMD는 코어당 L3 용량을 2 MB에서 4 MB로 두 배 늘려 일반 Zen 6 CCD와 일치시켰습니다. 또한, 코어당 L3가 두 배가 되고 코어 수도 두 배가 되면서, Zen 6c CCD는 총 128 MB의 L3를 갖게 되어 Zen 5c CCD 대비 네 배에 달합니다. Zen 6c의 최대 주파수 역시 높아져 Zen 5c의 3.7 GHz에서 Zen 6c에서는 4.1 GHz로 상승했습니다.
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)
두 제품 모두에 걸쳐, AMD는 향상된 전력 및 SMT 효율성뿐만 아니라 “대규모 코어 IPC 향상”을 주장합니다. 아직 전체적인 IPC 수치는 공개되지 않았지만, 위에서 언급된 수치들을 기준으로 볼 때 Venice는 엔터프라이즈(enterprise), 클라우드(cloud), AI 워크로드에서 Turin 대비 약 27%의 우위를 점하고 있습니다.
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)
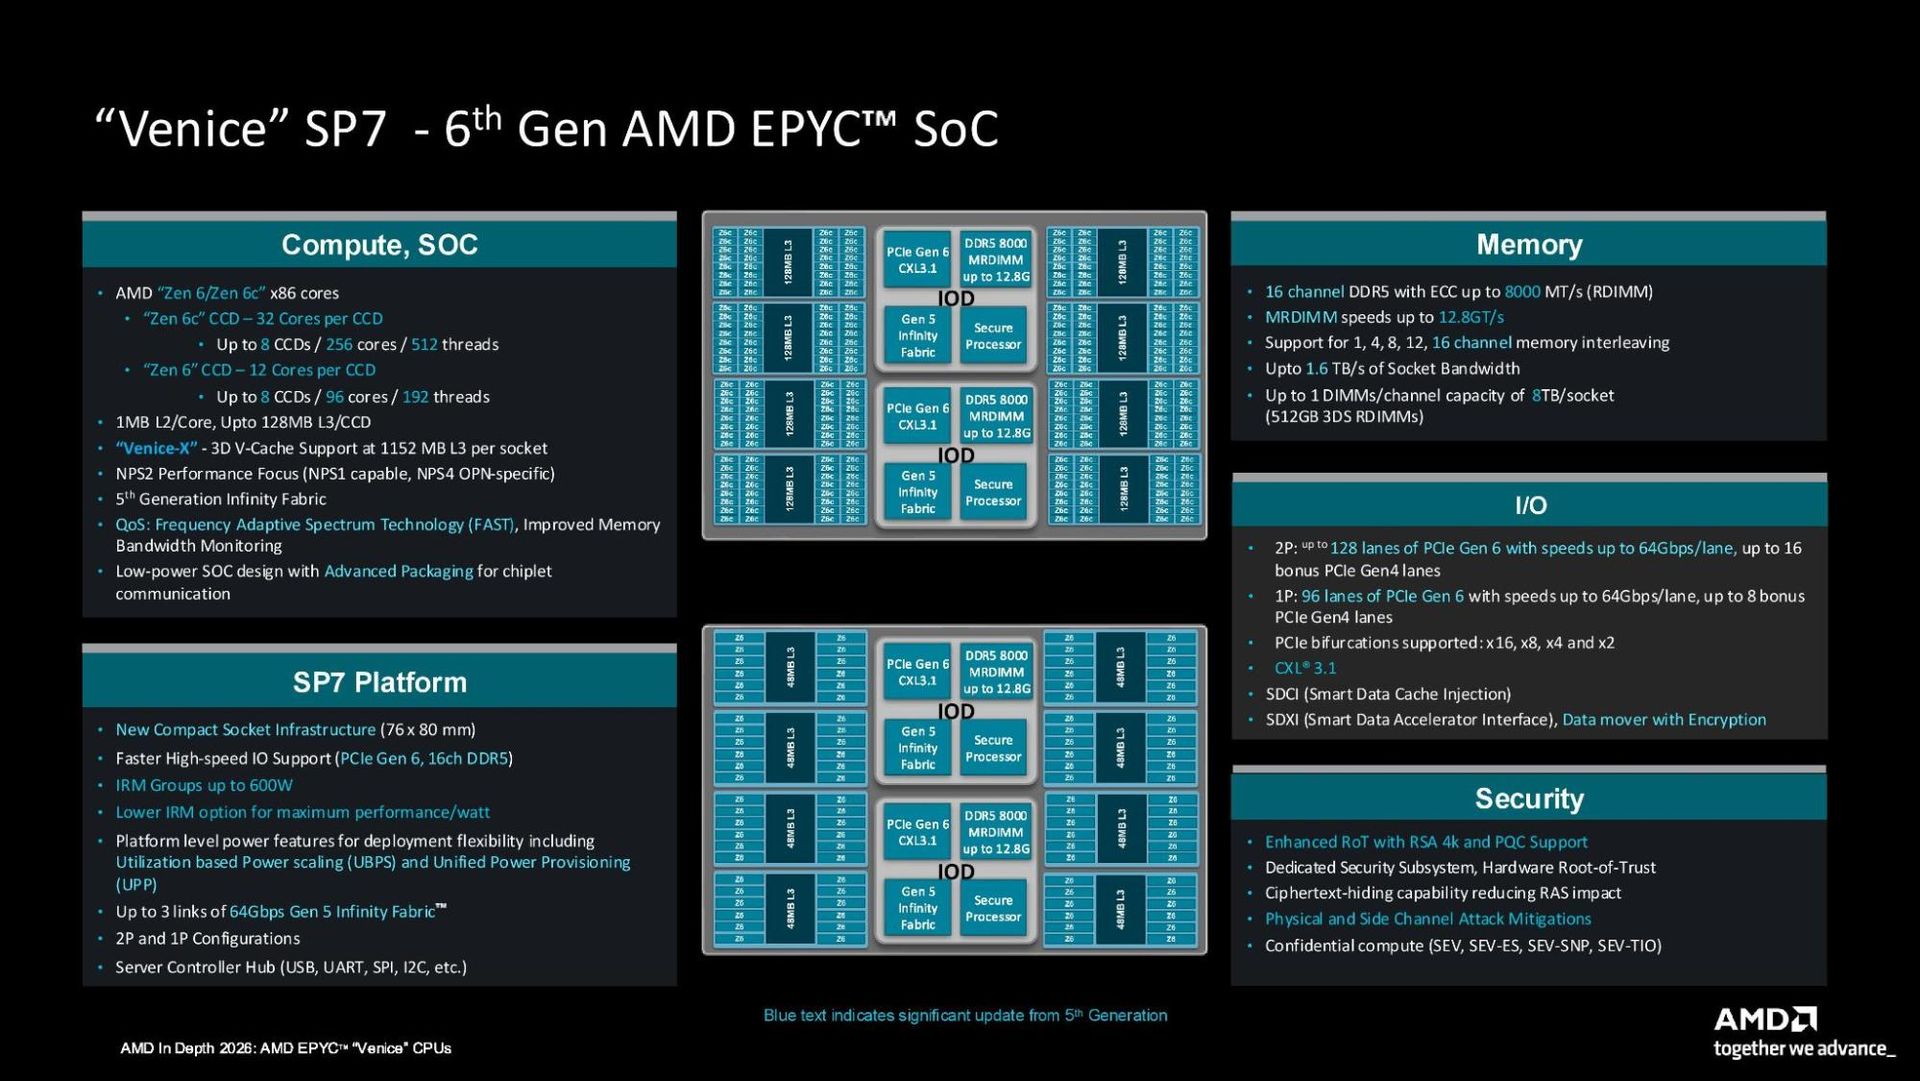
Venice의 맥락에서, AMD는 하나의 칩에 최대 8개의 CCD를 장착할 수 있으며, Zen 6c의 경우 총 256코어, 일반 Zen 6의 경우 SP7 플랫폼(Venice의 초기 라인업)용으로 총 96코어를 제공합니다. AMD는 Genoa 및 Turin CPU가 사용하던 SP5 소켓을 넘어 SP7로 이동하며, 이는 크기가 약간 더 큰 76 x 80 mm의 소켓입니다 (SP5는 약 72 x 75 mm).
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
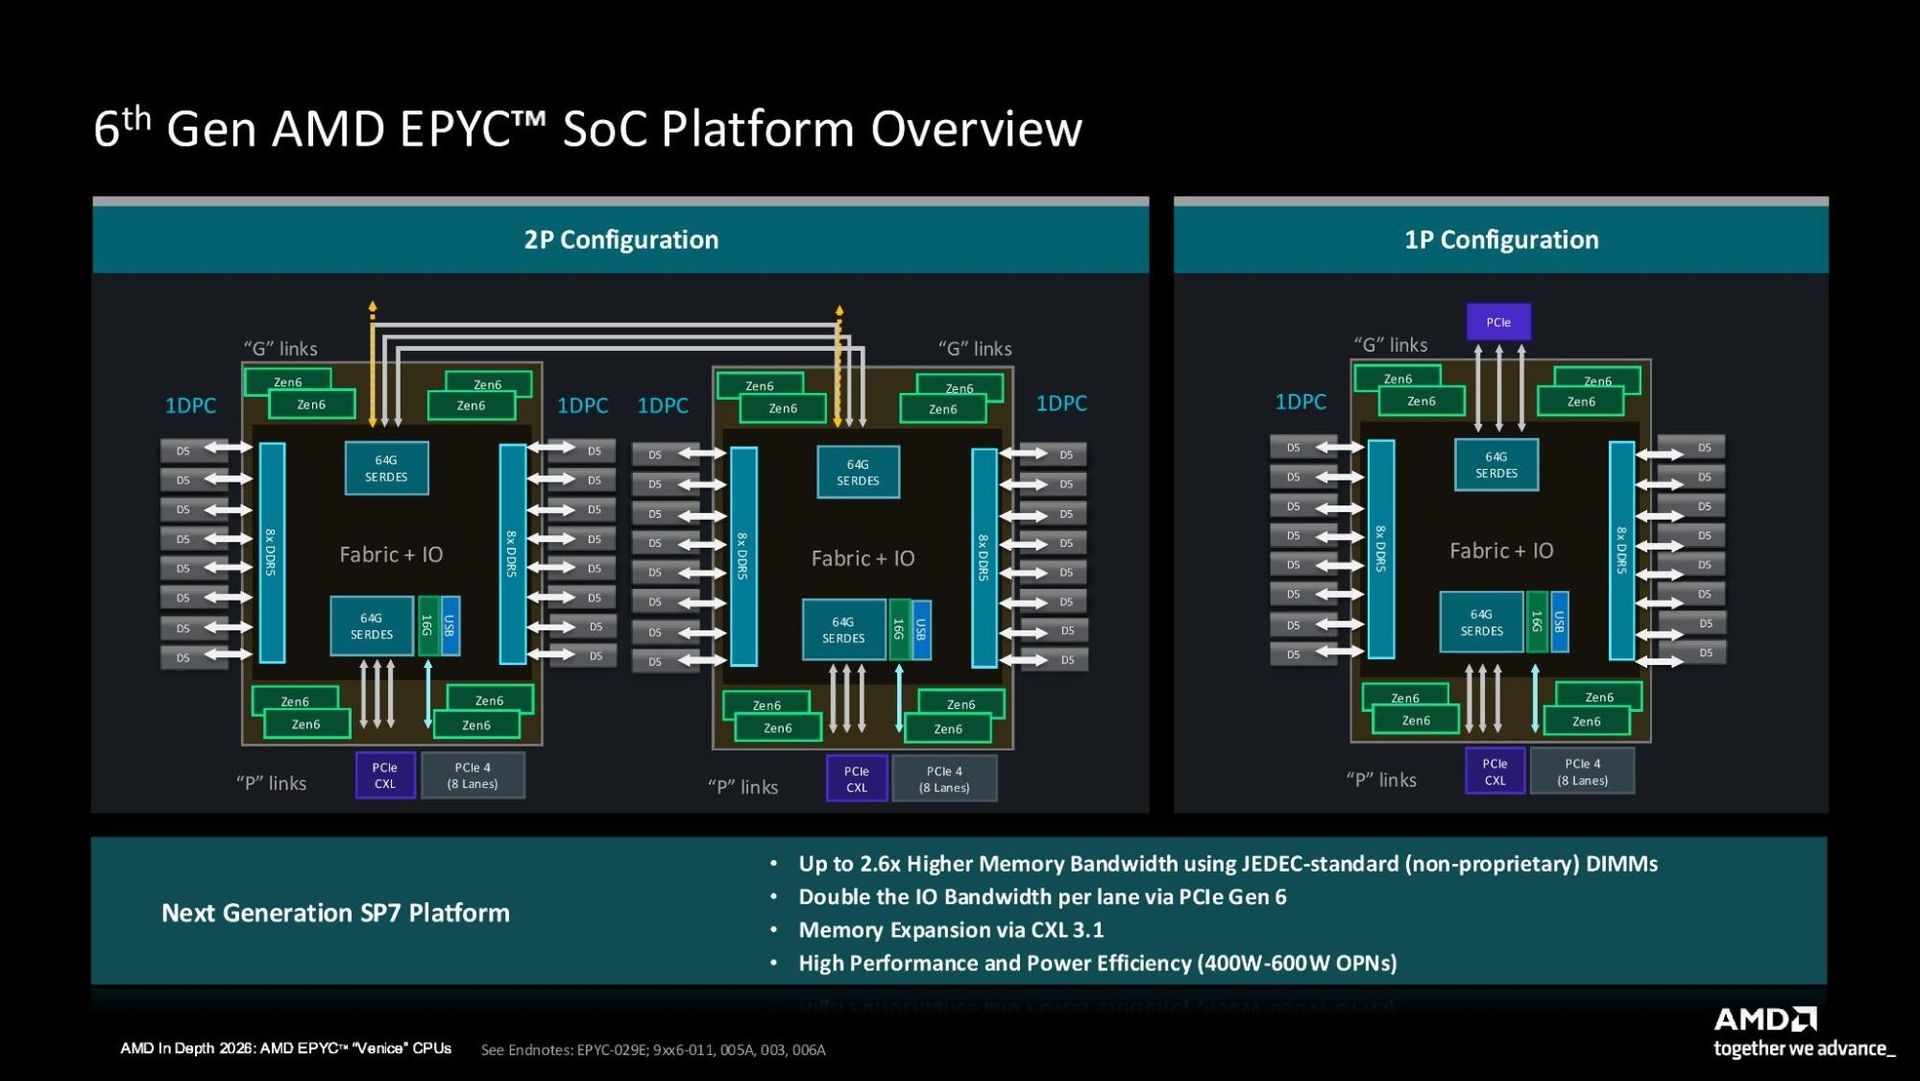
칩의 토폴로지(topology)는 Venice를 특징짓는 이중 IOD 다이(dual IO dies)가 제외하고는 Turin과 크게 변함이 없습니다. 두 개의 IOD는 칩 중앙에 위치하며, Zen 6 CCDs 사이에 자리 잡고 있습니다. 두 번째 IOD 덕분에 SP7 칩은 소켓당 16개의 메모리 채널(IOD당 8개 채널)에 접근할 수 있으며, 1DPC 구성에서 MRDIMMs를 사용하여 최대 12,800 MT/s 속도를 지원합니다. RDIMMs의 경우 AMD는 최대 8,000 MT/s를 지원합니다. 이 플랫폼은 소켓당 최대 8TB의 메모리를 지원하며, AMD는 소켓당 최대 1.6 TB/s의 대역폭을 주장합니다 (RDIMMs 사용 시 소켓당 1 TB/s).
또한 IOD에는 하드웨어 루트 오브 트러스트(hardware root-of-trust)와 실행 암호화(execution encryption), 메모리 무결성(memory integrity), 신뢰할 수 있는 I/O(trusted I/O)를 포함한 AMD의 기밀 컴퓨팅 확장 기능도 있습니다. 플랫폼에 새로 추가된 것은 레인당 최대 64 Gbps 속도의 PCIe 6.0입니다. 1P SP7 구성은 96개의 PCIe 6.0 레인에 접근할 수 있으며, 2P 플랫폼은 최대 128개를 가집니다. 각 구성에는 1P 구성의 경우 8개 또는 2P 구성의 경우 16개의 "보너스" PCIe 4.0 레인이 추가됩니다.
AMD Zen 6 EPYC ‘Venice’
(Image credit: AMD)
두 개의 64G SerDes 인터페이스가 PCIe 레인을 IOD로 가져오며, 이 중 하나는 2P 구성에서 칩을 연결하는 데 사용됩니다. 그 두 번째 인터페이스는 여전히 선택적으로 추가 12개의 PCIe 6.0 레인을 처리할 수 있어 "최대" 128개 2P 레인 수를 제공합니다. 보너스 레인은 더 작은 16G SerDes 인터페이스를 통해 작동합니다.
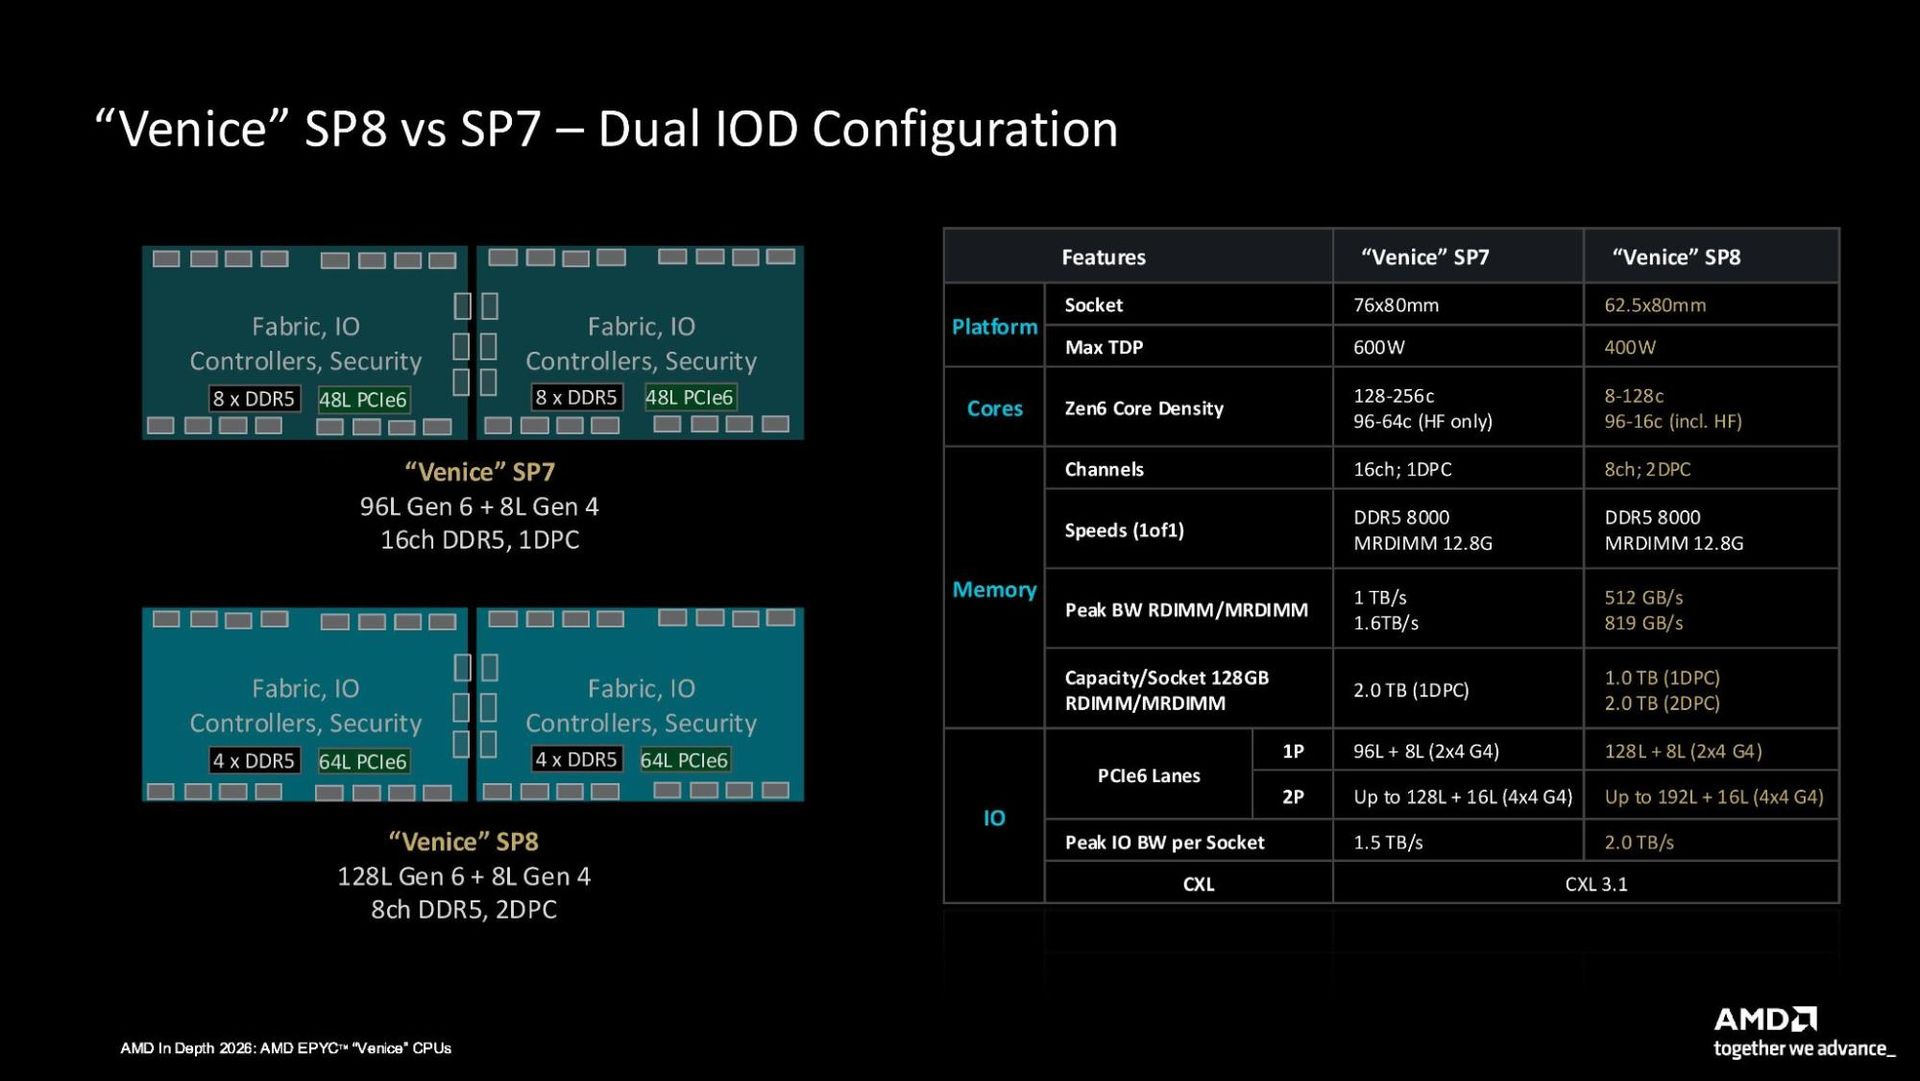
SP8 소켓을 사용하는 플랫폼은 메모리 채널을 PCIe 레인과 교환합니다. SP8 소켓은 크기가 62.5 x 80 mm로 더 작으며, 플랫폼은 최대 12,800 MT/s의 MRDIMM을 지원하는 것과 동일하게 16개 대신 8개의 메모리 채널을 지원합니다. 최대 지원 전송 속도에서 MRDIMM의 경우 819 GB/s로, RDIMM의 경우 512 GB/s로 메모리 대역폭이 감소합니다.
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)
하지만, SP8 칩은 IOD당 64개의 PCIe 6.0 레인에 접근할 수 있으며, 소켓당 총 128개 레인(추가적인 8개의 PCIe 4.0 보너스 레인 포함)을 가집니다. SP7과 마찬가지로, 이 레인 중 일부는 2P 구성에서 공유되며, 그 결과 2P SP8 서버에서는 총 192개의 PCIe 6.0 레인(추가적인 16개 PCIe 4.0 레인 포함)으로 줄어듭니다. 두 플랫폼 모두 CXL 3.1을 지원합니다.
AMD Zen 6 EPYC ‘Venice’
(이미지 출처: AMD)