
AMD, MEXT를 통해 절반의 DRAM으로 서버 성능의 95% 유지하며 메모리 부족 문제 해결 방안 공개
요약
AMD는 예측 메모리 엔진(MEXT)을 통해 DRAM 부족 문제를 해결하는 혁신적인 방안을 공개했습니다. 이 기술은 콜드 페이지를 플래시 스토리지로 오프로드하고, AI 모델이 데이터 필요 시점을 예측하여 데이터를 불러옵니다. 이를 통해 물리적 DRAM 용량이 줄어든 환경에서도 서버 성능의 높은 수준을 유지할 수 있다고 주장합니다.
핵심 포인트
- MEXT는 플래시 스토리지로 콜드 페이지를 오프로드하는 예측 메모리 엔진입니다.
- AI 모델이 데이터 필요 시점을 예측하여 DRAM 부족으로 인한 지연 시간을 극복합니다.
- AMD는 MEXT 사용 시 물리적 DRAM 용량이 50%일 때도 서버 성능의 95% 달성을 주장했습니다.
- HPE와의 파트너십을 통해 고객들에게 MEXT를 제공하며, 단계별 배포 계획을 가지고 있습니다.
지난 6월, AMD는 MEXT라는 예측 메모리 엔진(predictive memory engine)을 선보였습니다. 이 기술은 물리적 DIMM이 25%만 작동해도 전체 DRAM 용량을 갖춘 시스템의 99% 이상의 성능을 제공한다고 주장합니다. 이 기술은 콜드 메모리 페이지를 플래시 스토리지로 오프로드하고, 필요한 시점에 서비스를 제공하기 위해 AI 모델을 사용합니다. AMD는 내년에 이 기술을 광범위한 IT 인프라에 확장할 계획이라고 밝혔습니다.
MEXT의 핵심 원리는 너무 완벽해 보입니다. AMD와 MEXT 창립자인 Gary Smerdon에 따르면, 이 기술은 애플리케이션 및 성능 목표에 따라 서버가 요구하는 물리적 DRAM을 20%에서 최대 75%까지 줄일 수 있습니다. 이렇게 부족한 메모리 용량도 OS에는 설치된 DRAM으로 인식됩니다. 하지만 MEXT는 DRAM 대신 비교적 저렴한 플래시 스토리지를 사용하여 콜드 페이지를 오프로드하고, AI 모델을 통해 필요한 시점에 해당 데이터를 다시 불러옵니다. AMD가 언급한 Synopsys PrimeTime과 같은 내부 워크로드의 경우, 회사는 MEXT를 사용하면서 DRAM 용량이 50%일 때도 전체 서버 성능의 95%를 달성할 수 있다고 밝혔습니다.
AMD는 현재 145대의 서버에 MEXT를 내부적으로 배포했으며, 이는 내년에 2,000대로 확장될 예정입니다. 또한, AMD는 고객들에게 MEXT를 제공하기 위해 HPE와 파트너십을 발표했습니다. 현재 저희는 출시 1단계(Phase 1)에 있으며, 일부 'MEXT Ready' 배지를 달고 있는 EPYC Venice 서버 서버와 오프로드를 위한 전용 NVMe 드라이브 또는 베이를 갖추고 있습니다. 2단계(Phase 2)에서는 MEXT 라이선스와 RAM View 애플리케이션이 이들 서버에 제공될 예정입니다. AMD는 2단계가 언제 시작될지 밝히지는 않았습니다.
AI 기반의 DRAM 가격 급등은 게이밍 PC에만 영향을 미치는 것이 아니라, 기업들 역시 AI 워크로드를 실행하지 않더라도 가격 인상의 직격탄을 받고 있습니다. 만약 MEXT가 AMD가 주장하는 바를 달성할 수 있다면, 현재 시장 상황을 고려했을 때 혁신적일 수 있습니다. 따라서 MEXT가 정확히 무엇인지, 그리고 AMD가 이를 통해 무엇을 할 수 있다고 주장하는지 이해할 가치가 있습니다.
MEXT는 개념적으로 흥미롭지만, AMD가 배포에 있어 보수적인 접근 방식을 취하고 있다는 것은 분명합니다. 결국 특별한 주장은 특별한 증거를 요구하기 때문입니다. MEXT의 응용 분야는 현재 좁지만, AMD에 따르면 유망한 초기 결과를 바탕으로 MEXT를 사용하는 워크로드를 확장하고 있습니다.
DRAM, 플래시 및 LLM
(이미지 출처: AMD)
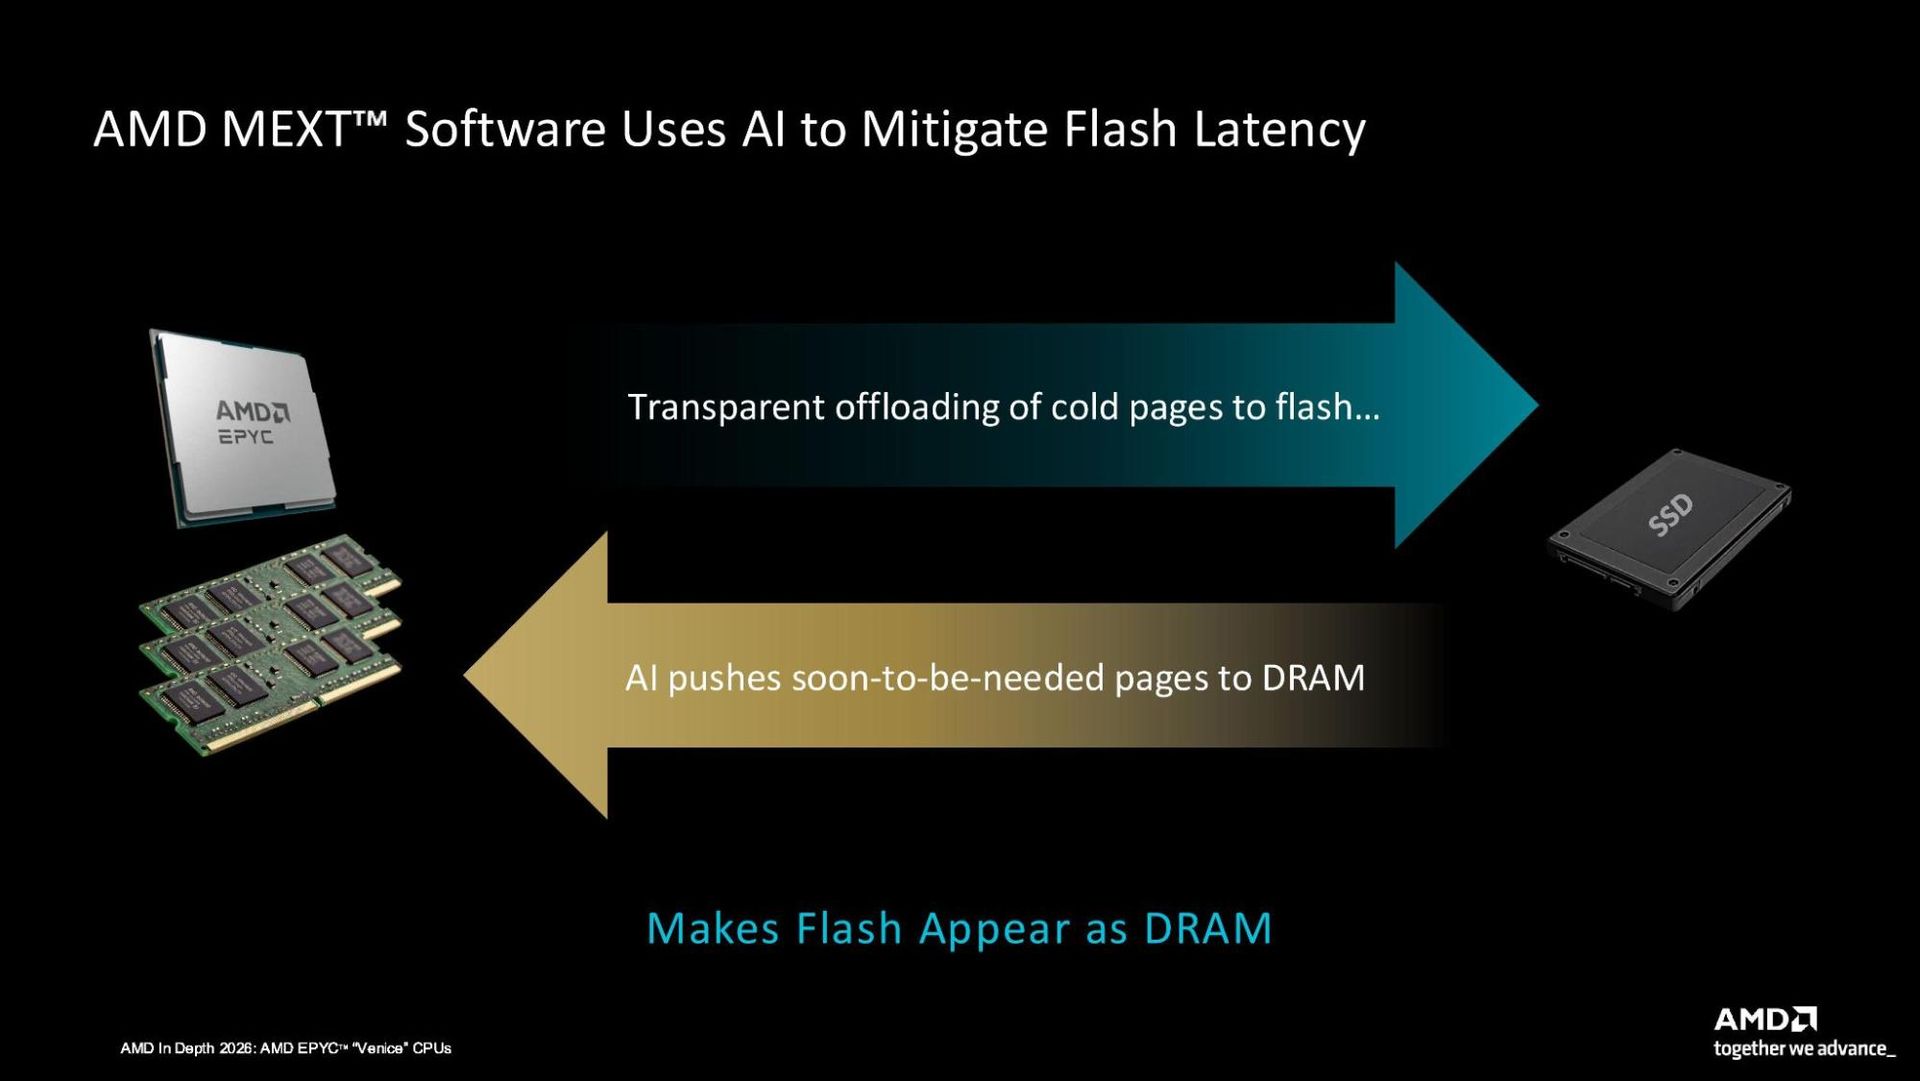
MEXT의 기본 구조는 개념적으로 간단합니다. 콜드 페이지(cold pages)가 플래시(flash)로 이동하면, AI가 필요할 때 이 페이지들을 다시 가져오므로 마치 메모리가 처음부터 부족했던 적이 없는 것처럼 작동합니다. 가장 큰 문제는 명확해야 합니다. 플래시는 DRAM보다 수십 배 더 느리기 때문에, 필요한 순간에 플래시에서 메모리로 페이지를 스트리밍하는 것은 실현 가능하지 않습니다. MEXT의 핵심 기술은 AI 모델을 사용하여 사용자가 필요로 할 페이지를 _예측_한다는 것입니다. 그리고 이 모델이 SSD로부터의 전송 지연 시간(transfer latency)보다 최소한 앞서 나갈 수만 있다면, 마치 물리적인 DRAM이 내내 설치되어 있는 것과 같은 효과를 얻게 됩니다.
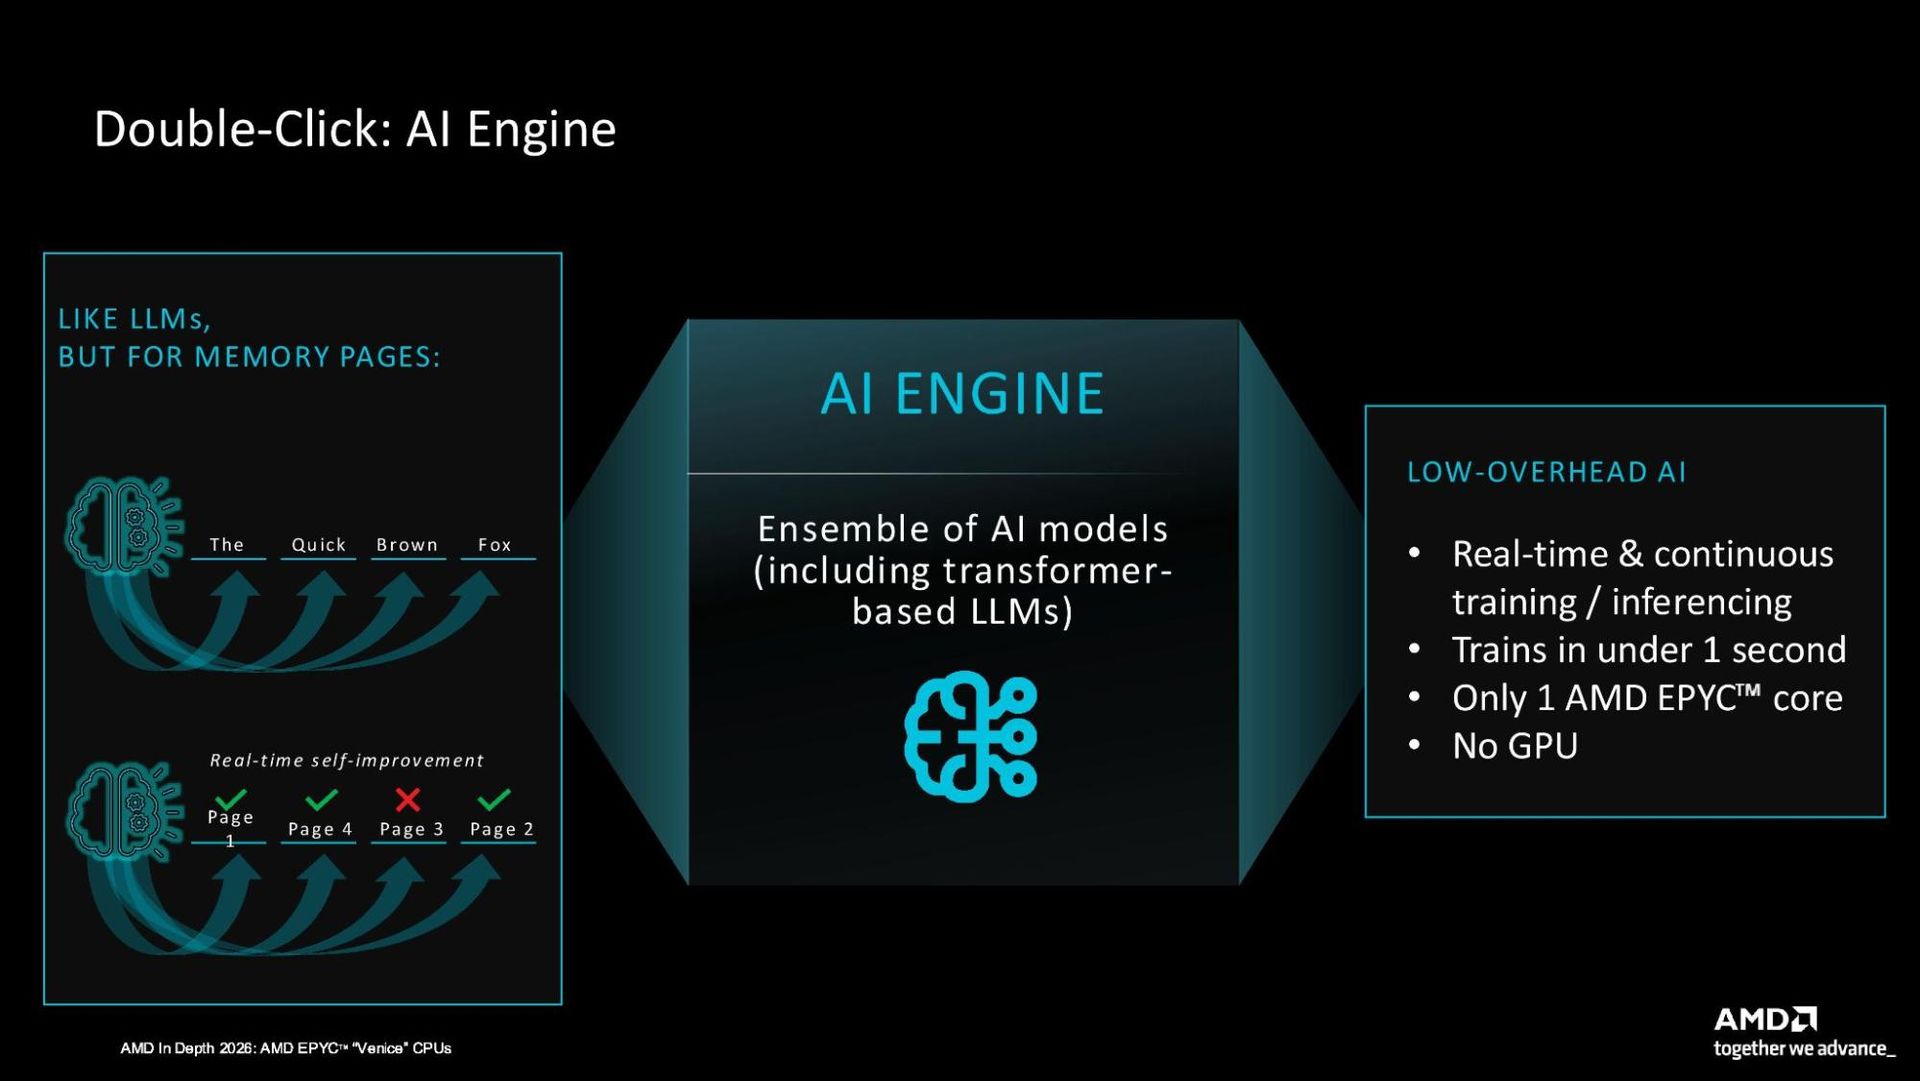
MEXT가 사용하는 트랜스포머 기반 LLM(Large Language Model)의 작동 방식을 고려할 때, 이는 터무니없는 개념은 아닙니다. 내부 작동 방식에 익숙하지 않다면, 이 오픈 소스 시각화 자료가 트랜스포머 AI 모델의 개념을 명확하게 설명해 줍니다. 근본적인 개념은 다음 토큰 예측(next token prediction)이며, 이는 현대 LLM 설계의 기반이 됩니다. LLM은 주어진 토큰 세트를 바탕으로 다음에 올 가능성이 가장 높은 토큰(단어, 단어의 일부 등)을 결정합니다. 즉, 예측을 수행하는 것입니다. MEXT의 경우, 다음으로 필요한 페이지를 예측하며, 다음 단어를 예측하는 것이 아닙니다.
(이미지 출처: AMD)
메모리 플래시 오프로딩은 새로운 개념이 아니지만, MEXT의 창립자인 Gary Smerdon은 이 기술에서 AI가 결정적인 차이를 만든다고 말합니다. MEXT 자체는 모든 Linux 배포판(distro)에서 작동하는 리눅스 커널 모듈로 배포됩니다. 이 기술은 "AI 모델 앙상블(ensemble of AI models)"을 사용하며, 주된 트랜스포머 기반 대규모 언어 모델(LLM)이 이 기술을 구동합니다. 그리고 결정적으로, 사전 학습되어 제공되지 않습니다.
대신 AMD는 MEXT가 처음 배포될 때 1초 이내에 학습하고, GPU 없이 단일 EPYC 코어에서 작동하며, 워크로드가 진행됨에 따라 지속적으로 학습한다고 말합니다. 이러한 접근 방식은 MEXT가 적용할 수 있는 다양한 워크로드(workloads)를 고려할 때 합리적입니다. 그 아이디어는 예측 엔진을 구동하기 위해 애플리케이션의 접근 패턴(access patterns)을 학습하는 것입니다.
MEXT가 완벽하지는 않지만, 모든 상황에서 완벽할 필요는 없습니다. 예를 들어, 저장된 페이지의 순서는 중요하지 않습니다. 텍스트의 경우 LLM은 올바른 순서로 정확한 텍스트를 예측해야 하지만, MEXT에서는 순서가 중요하지 않습니다. 필요한 시점에 해당 페이지가 DRAM에만 있으면 됩니다.
MEXT가 다양한 워크로드에 어떻게 적용되는지 이해하기 위해, AMD는 이 기술과 함께 RAM View를 개발했습니다. 이것은 어떤 페이지가 '핫(hot)'하고 어떤 페이지가 '콜드(cold)'해졌는지 보여주는 메모리 활용 도구입니다. 위 예시에서 볼 수 있듯이, 1.5 TB의 메모리를 가진 시스템은 전체 워크로드에 걸쳐 거의 최대 활용률을 보이지만, 주어진 시점에서는 저장된 페이지 중 약 절반이 5분 이상 건드려지지 않았습니다.
AMD는 이 일반화된 예시를 제공했으며 어떤 워크로드를 테스트했는지 명확히 밝히지 않았습니다. 이는 매우 중요한데, 활용도 분석은 서버에서 실행되는 애플리케이션에 따라 크게 달라질 것이기 때문입니다. 초기에는 AMD가 Synopsys PrimeTime과 같은 내부적으로 사용하는 핵심 EDA(Electronic Design Automation) 애플리케이션에 MEXT를 적용하고 있지만, 회사는 에이전트형 AI(agentic AI), 데이터베이스, 미디어 및 엔터테인먼트 워크로드 최적화에도 집중했다고 밝혔습니다.
(Image credit: AMD)
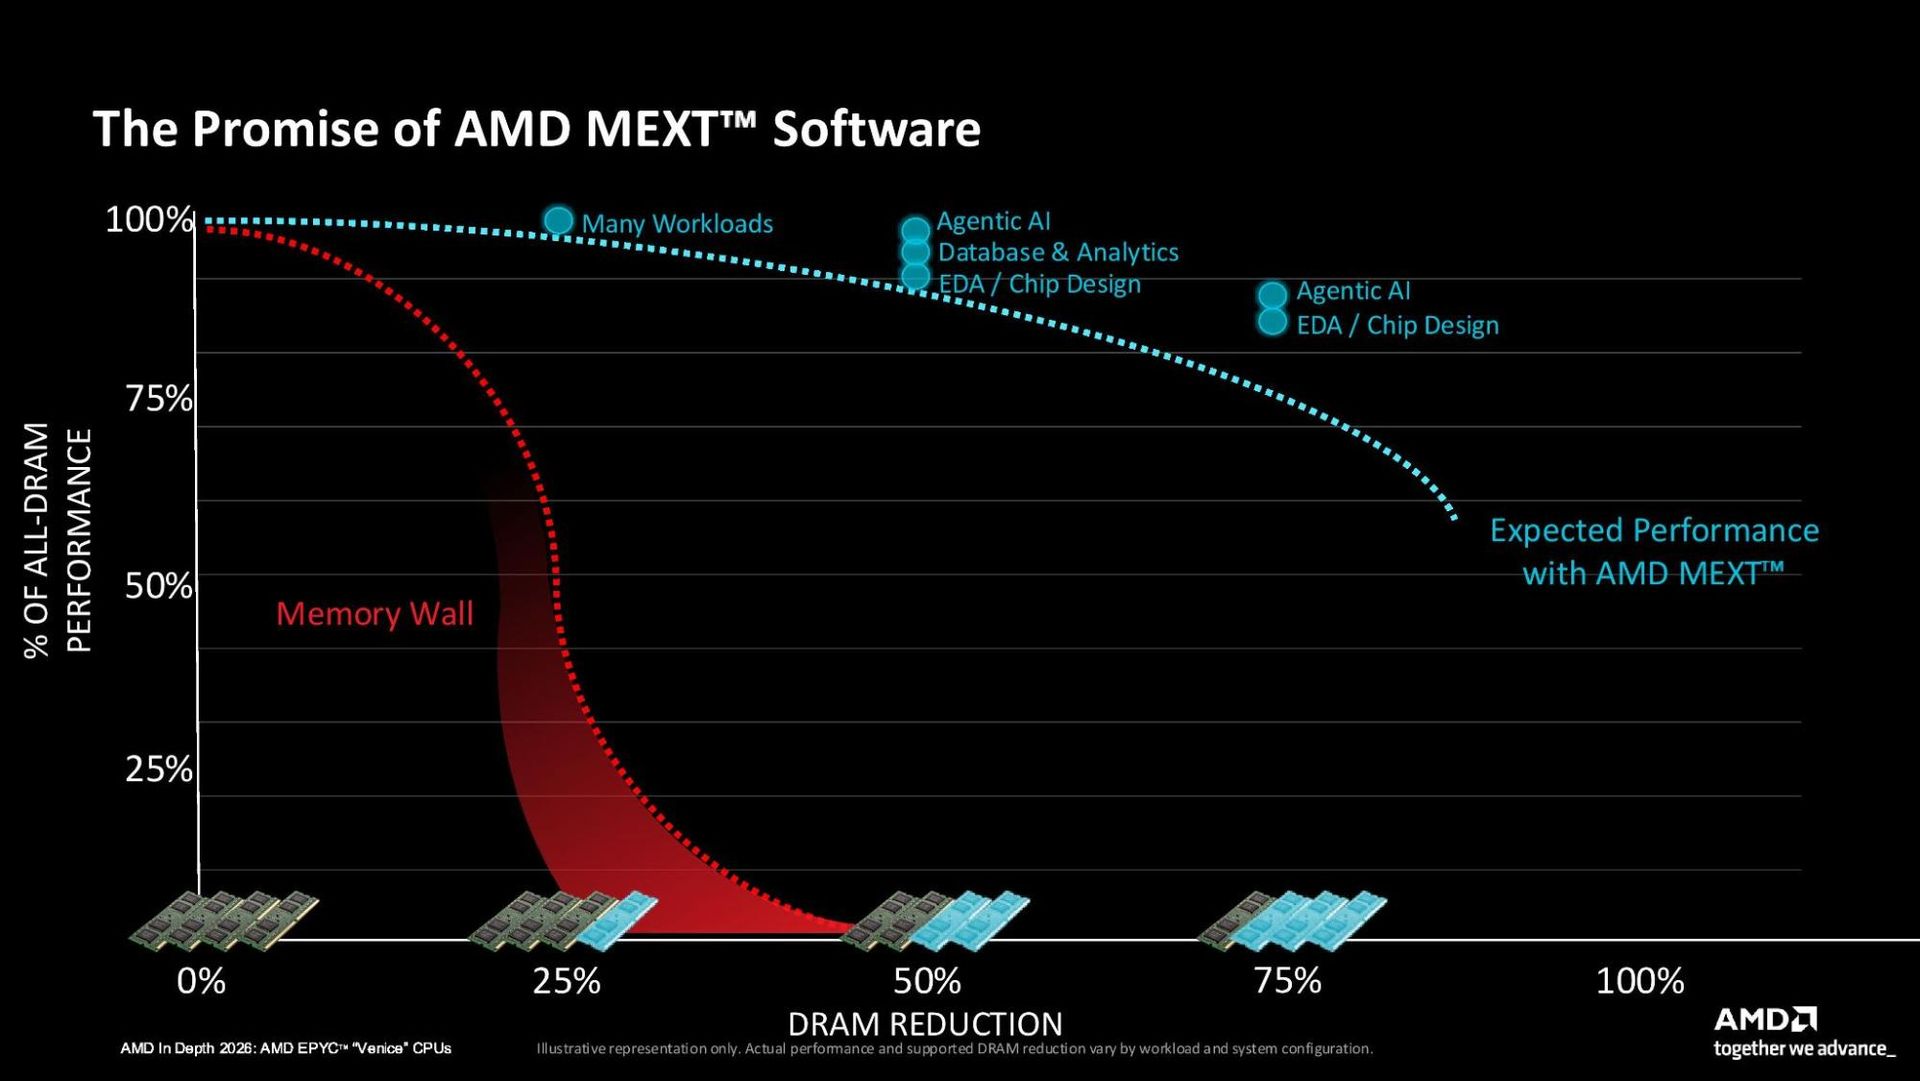
이는 메모리 접근 패턴이 애플리케이션마다 달라질 뿐만 아니라, 시스템에 충분한 메모리가 없을 때 해당 애플리케이션의 성능 반응도 다르게 나타나기 때문에 중요합니다. AMD가 '메모리 벽(memory wall)'이라고 부르는 개념은 서버를 사용해 본 적이 있는지 여부와 관계없이 익숙해야 할 개념입니다. AMD는 MEXT를 통해 이 메모리 벽을 확장하려고 노력하고 있으며, 이는 애플리케이션마다 다르게 보일 수 있다고 말합니다.
예를 들어, 회사는 많은 워크로드가 용량을 약 20%에서 25%까지 줄일 수 있다고 자신합니다. 하지만 감소 폭이 커질수록 애플리케이션은 더욱 전문화되고 성능 격차(performance delta)는 더 크게 나타납니다.
AMD의 내부 MEXT 결과
(Image credit: AMD)
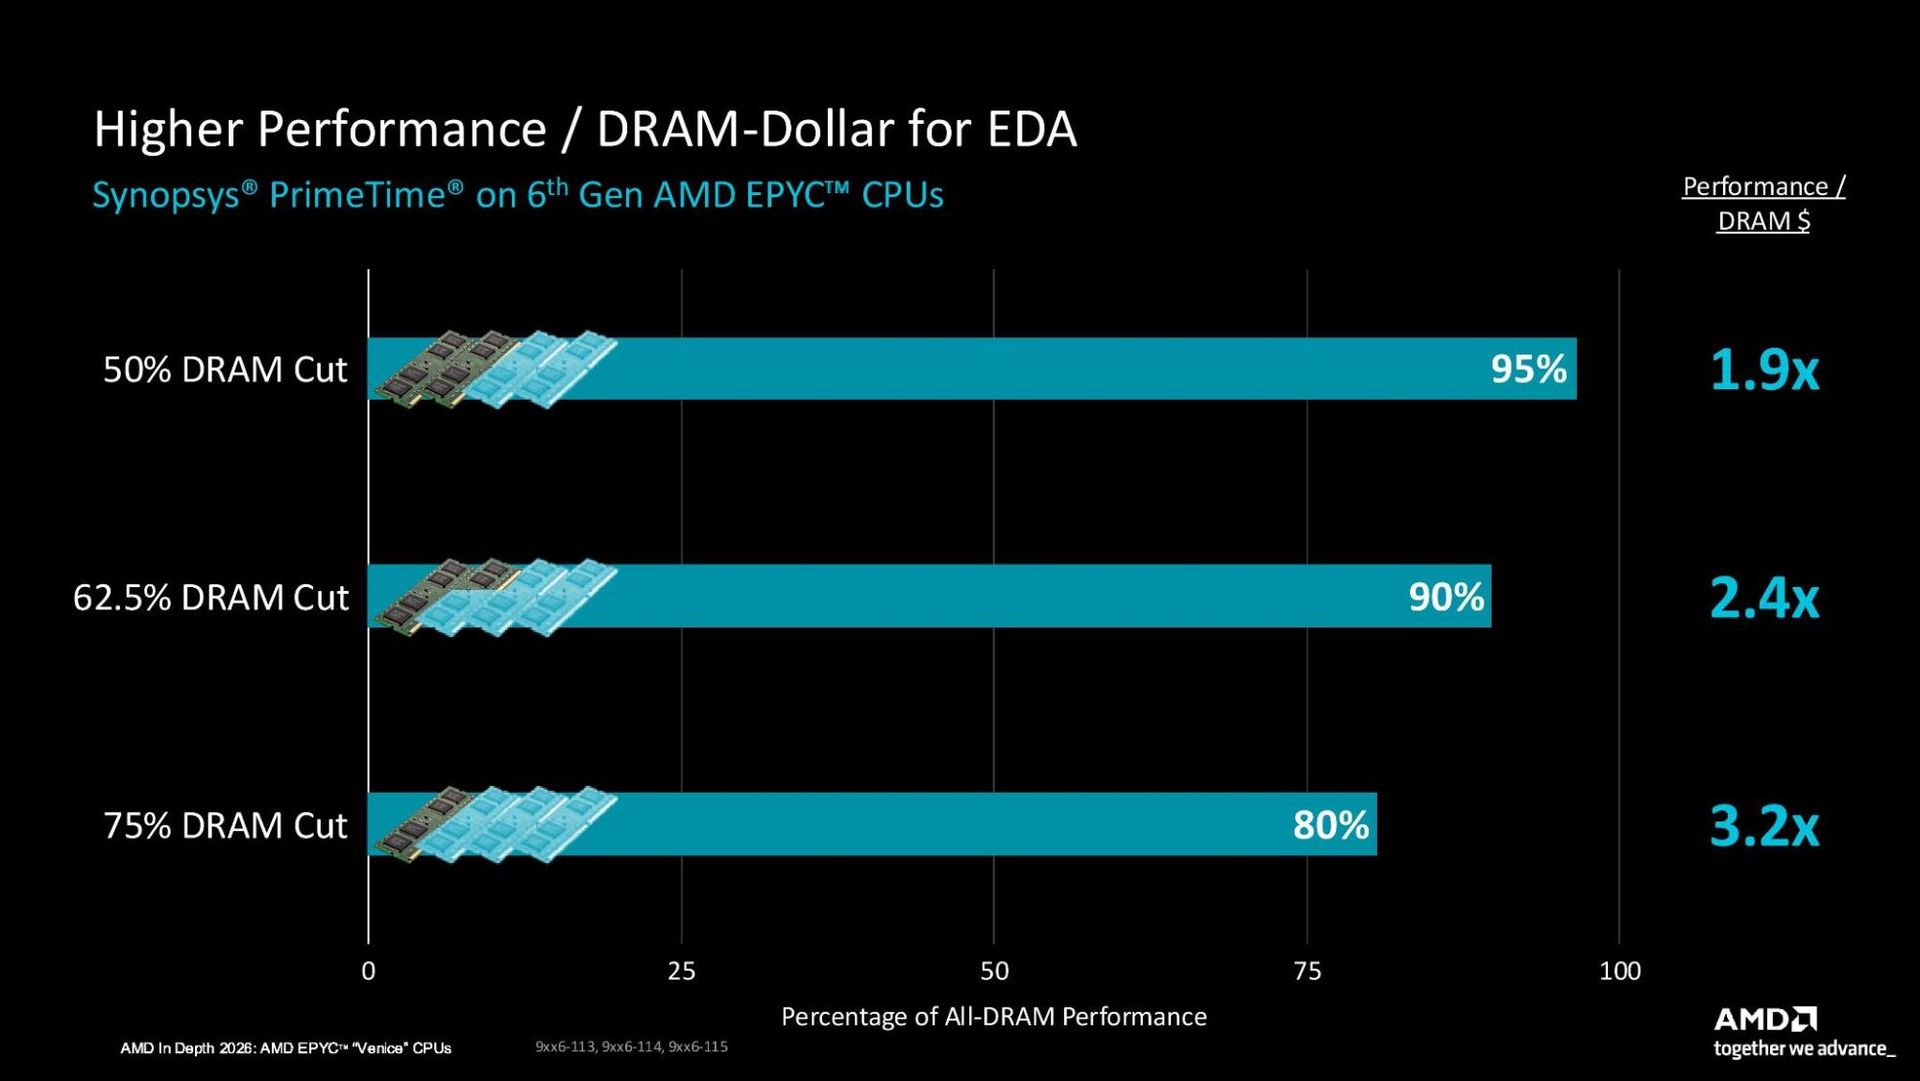
AMD는 몇 가지 내부 MEXT 결과를 공유했는데, 인상적으로 보이지만 평소와 마찬가지로 이러한 자체 벤치마크(first-party benchmarks)는 회의적인 시각으로 접근하는 것이 현명합니다. AMD가 지금까지 MEXT에 많은 관심을 기울여 온 PrimeTime을 시작으로, 서버가 50% 용량에서 실행될 경우 전체 용량 서버 성능의 95%를 유지하며, 심지어 25%까지 감소하더라도 애플리케이션 성능의 80%를 유지한다고 밝혔습니다.
(Image credit: AMD)
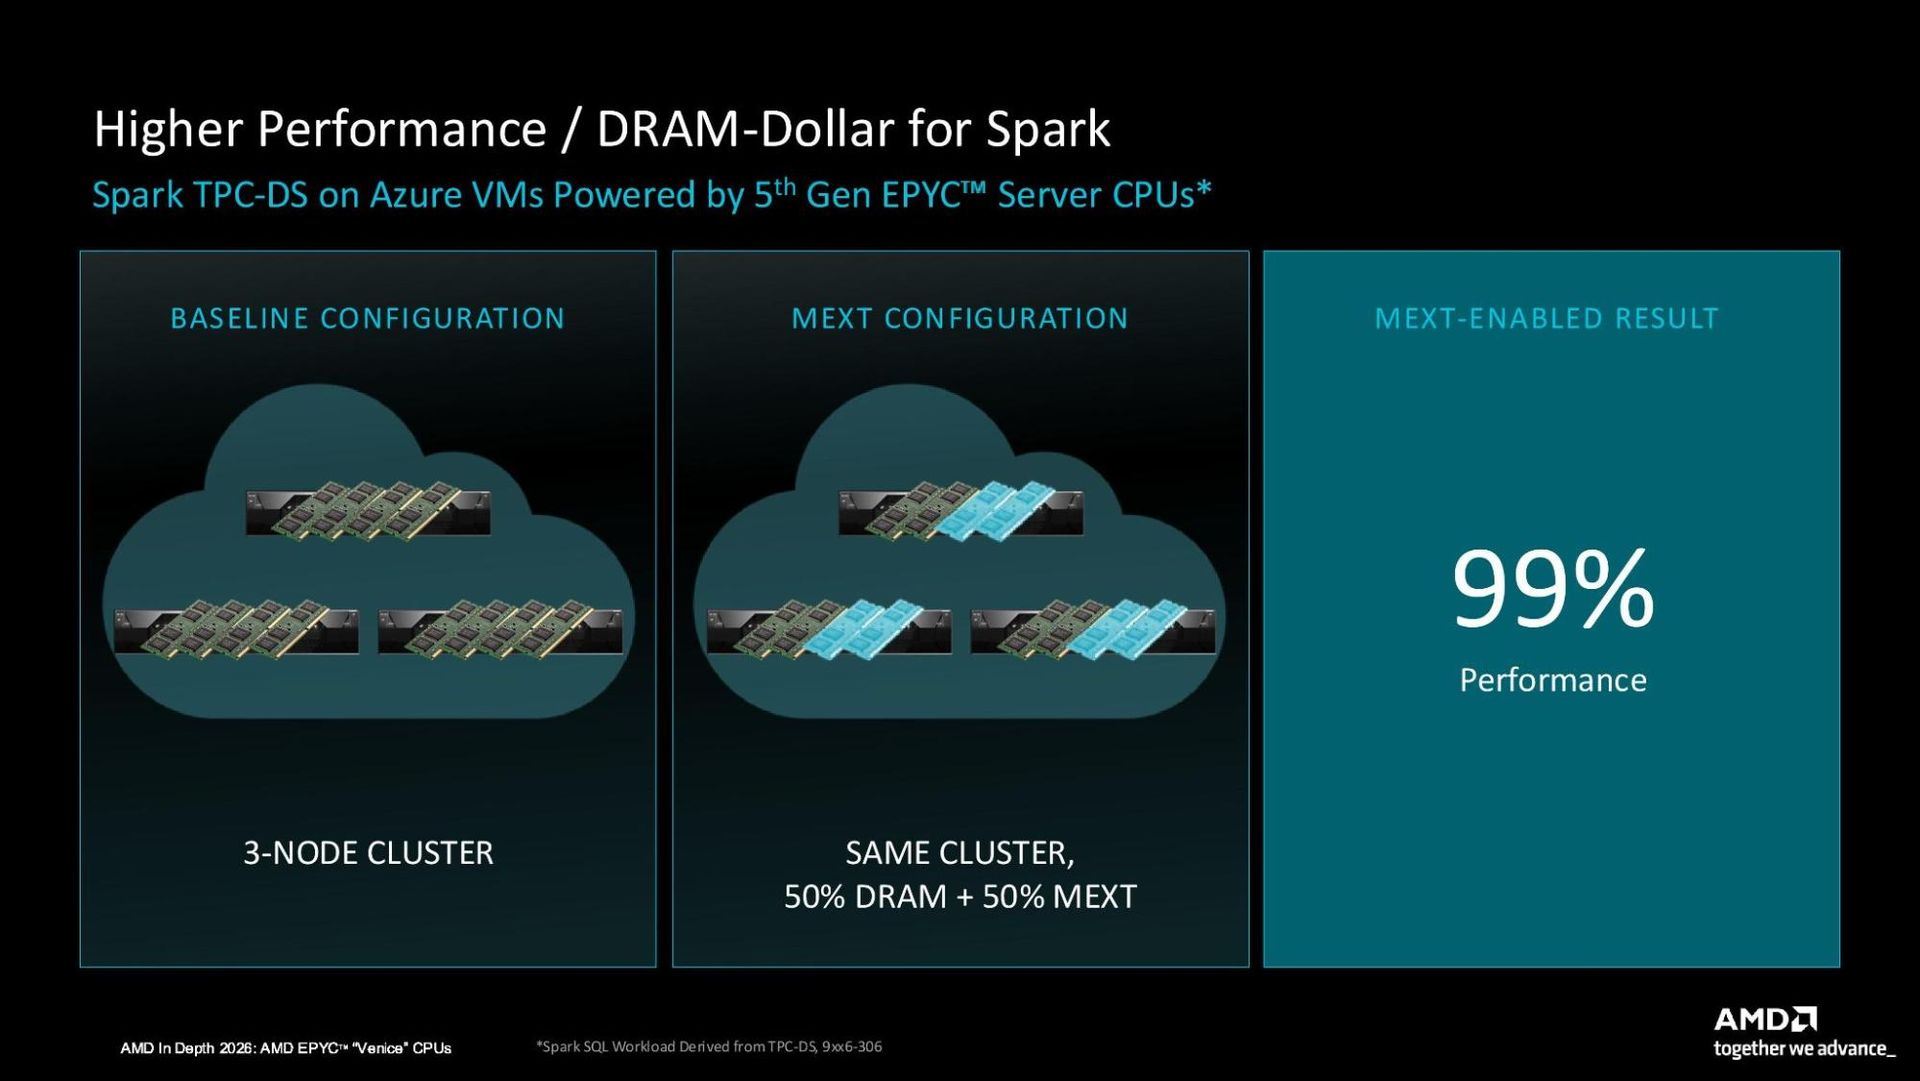
PrimeTime은 대규모 디자인에 많은 메모리를 요구합니다. AMD에 따르면 성능이 거의 동일한 일부 애플리케이션도 있습니다. 5세대 EPYC CPU가 장착된 Azure에서 실행되는 3노드 클러스터의 경우, AMD는 MEXT가 TPC-DS 벤치마크의 Spark SQL 워크로드를 사용하면서 DRAM 용량의 50%만으로 전체 클러스터 성능의 99%를 제공한다고 밝힙니다. SQL 데이터베이스는 I/O 병목 현상을 방지하기 위해 가능한 많은 데이터를 메모리에 캐시하려고 시도하며, 이는 콜드 페이지(cold pages)를 해제하려는 MEXT와 같은 기술에게 황금 같은 기회를 창출합니다.
(이미지 출처: AMD)
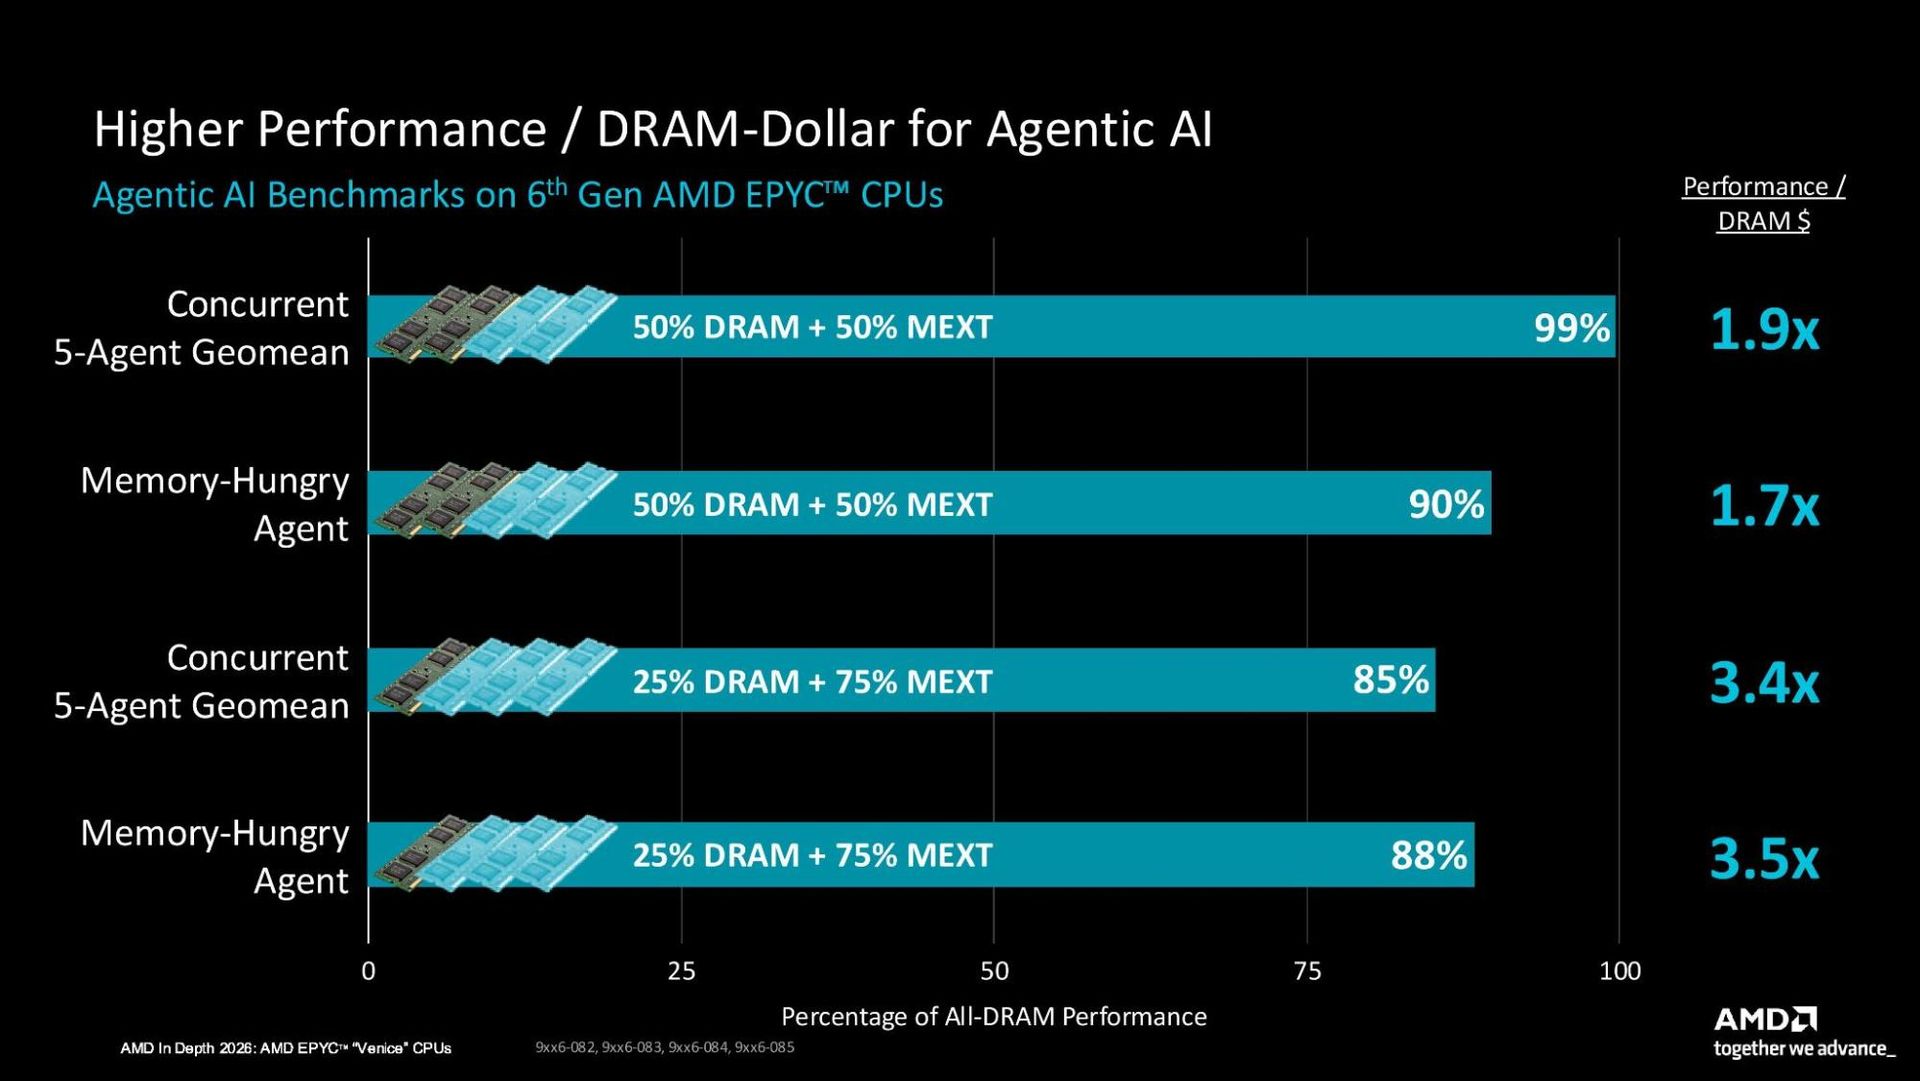
하지만 현재로서는 가장 적용 가능한 워크로드는 에이전틱 AI(agentic AI)이며, AMD는 MEXT가 이 분야에서도 유사한 응용 사례를 가지고 있다고 말합니다. 5개 에이전트 동시 지오미안(geomean)을 거쳐, AMD는 메모리 용량의 50%일 때 전체 서버 성능의 99%, 그리고 25%일 때는 85%의 성능을 주장합니다. '메모리를 많이 사용하는' 에이전트의 경우, 각각 50%와 25% 용량에서 90% 및 88%의 성능을 주장합니다.
위에 보이는 슬라이드에는 각주 태그가 있습니다. 하지만 AMD는 아직 저희에게 해당 각주를 공유하지 않았기 때문에, 이 테스트들이 어떻게 실행되었는지에 대한 정보가 없습니다. 당연히 저희는 AMD가 최소한 MEXT의 성능을 가장 좋은 방식으로 표현했다고 가정합니다. 다만, 테스트가 어떻게 진행되었는지 알지 못하면 전체적인 분석은 할 수 없습니다.
흥미로운 점은 MEXT를 출시하는 AMD의 신중한 접근 방식입니다. 현재로서는 EPYC 전용 기능이지만, AMD는 먼 미래에 소비자 장치(예: Strix Halo)에서도 지원할 수 있는 가능성을 열어두었습니다. 이는 RAM View 소프트웨어와 번들로 라이선스 형태로 판매될 예정이지만, 언제 그렇게 될지에 대한 시간표는 없습니다. 또한, HPE와의 파트너십을 통해 'MEXT Ready' 서버를 출시하고 있음에도 불구하고, MEXT 자체가 AMD의 영역 밖에서 배포 준비가 되는 시점은 여전히 알 수 없습니다.
이러한 보수적인 접근 방식을 고려할 때, 아직 우리가 알지 못하는 MEXT의 함정들이 있을 가능성이 높으며, AMD가 벤치마크에서 보여준 50% 및 25% DRAM 용량 수준에서 모든 서버에 광범위하게 적용될 것이라고 상상하기는 어렵습니다.
하지만 서버의 DRAM 용량을 25%만 줄일 수 있다는 것 자체가 현재 공급 제약(supply-constrained) 환경에서는 엄청난 비용 절감 효과를 의미합니다. 만약 일부 워크로드(workloads)가 이를 50% 용량까지 끌어올릴 수 있다면, 그것은 훨씬 더 좋은 일입니다. 물론, MEXT가 광범위하게 사용 가능해진 후에 어떻게 작동하는지 지켜봐야겠지만, 만약 AMD의 주장이 사실이라면(hold water), 메모리가 충분하지 않은 것 같은 데이터센터에서 핵심적인 기술이 될 수 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기