
AMD, 예상되는 RTX Spark 출시에 앞서 Gorgon Halo 벤치마크로 선제공격
요약
AMD가 Nvidia의 예상되는 RTX Spark 출시를 앞두고, 경쟁 라인업인 Gorgon Halo 칩의 일부 벤치마크 정보를 선제적으로 공개했습니다. AMD는 Ryzen AI Max+ Pro 495와 Intel Core Ultra X9 388H 등 최고 사양 부품 간의 비교에 초점을 맞추며 시장 대응을 예고하고 있습니다.
핵심 포인트
- AMD가 Nvidia RTX Spark 출시 전, Gorgon Halo 칩 벤치마크를 공개하며 선제적 경쟁 구도를 형성함.
- AMD는 최고 사양 부품 간의 비교에 집중하여 시장에서의 성능 우위를 강조하고 있음.
- Nvidia RTX Spark의 공식 성능 결과가 나오지 않아 AMD는 이를 직접적인 비교 지표로 사용하지 않음.
Nvidia는 이번 주 후반에 (지난주 말의 은근한 티저와 해당 칩의 발표된 가을 출시를 거쳐) RTX Spark 장치를 출시할 것으로 예상됩니다. 다음 주 수요일(10월 7일), 마이크로소프트 이벤트에서 이 출시가 예상되는 것에 앞서, AMD는 RTX Spark 장치와 직접 경쟁할 라인업인 새로운 Gorgon Halo 칩의 일부 벤치마크를 공유했습니다. 이러한 추가 정보는 가장 비싼 모델 중 일부가 $7,099 이상에 달하는 첫 번째 Gorgon Halo 장치가 출시된 지 얼마 지나지 않아 나왔습니다.
Go deeper with TH Premium: CPU
(Image credit: Tom's Hardware)
- Intel VP Robert Hallock, Nova Lake 기대치 제시 및 DDR4 플랫폼용 Raptor Lake 복귀 암시
- DLSS를 활용한 CPU 스케일링
- 데스크톱 CPU 분야에서 구체화되는 Intel의 원투 펀치 계획
- AMD의 BC-250 벤치마크: Steam Machine과 유사한 성능을 절반 가격에 제공
하지만 몇 가지 의심스러운 Geekbench 유출 정보 외에는 RTX Spark의 성능 결과가 아직 나오지 않았기 때문에 AMD는 이를 비교 지점으로 사용하고 있지 않습니다. 대신, Ryzen AI Max+ Pro 495를 Intel의 Core Ultra X9 388H와 비교하고 있습니다. 비록 이 두 칩이 같은 등급의 장치에는 속하지 않지만, AMD는 최고 사양 부품끼리 비교하는 것이라고 주장합니다.
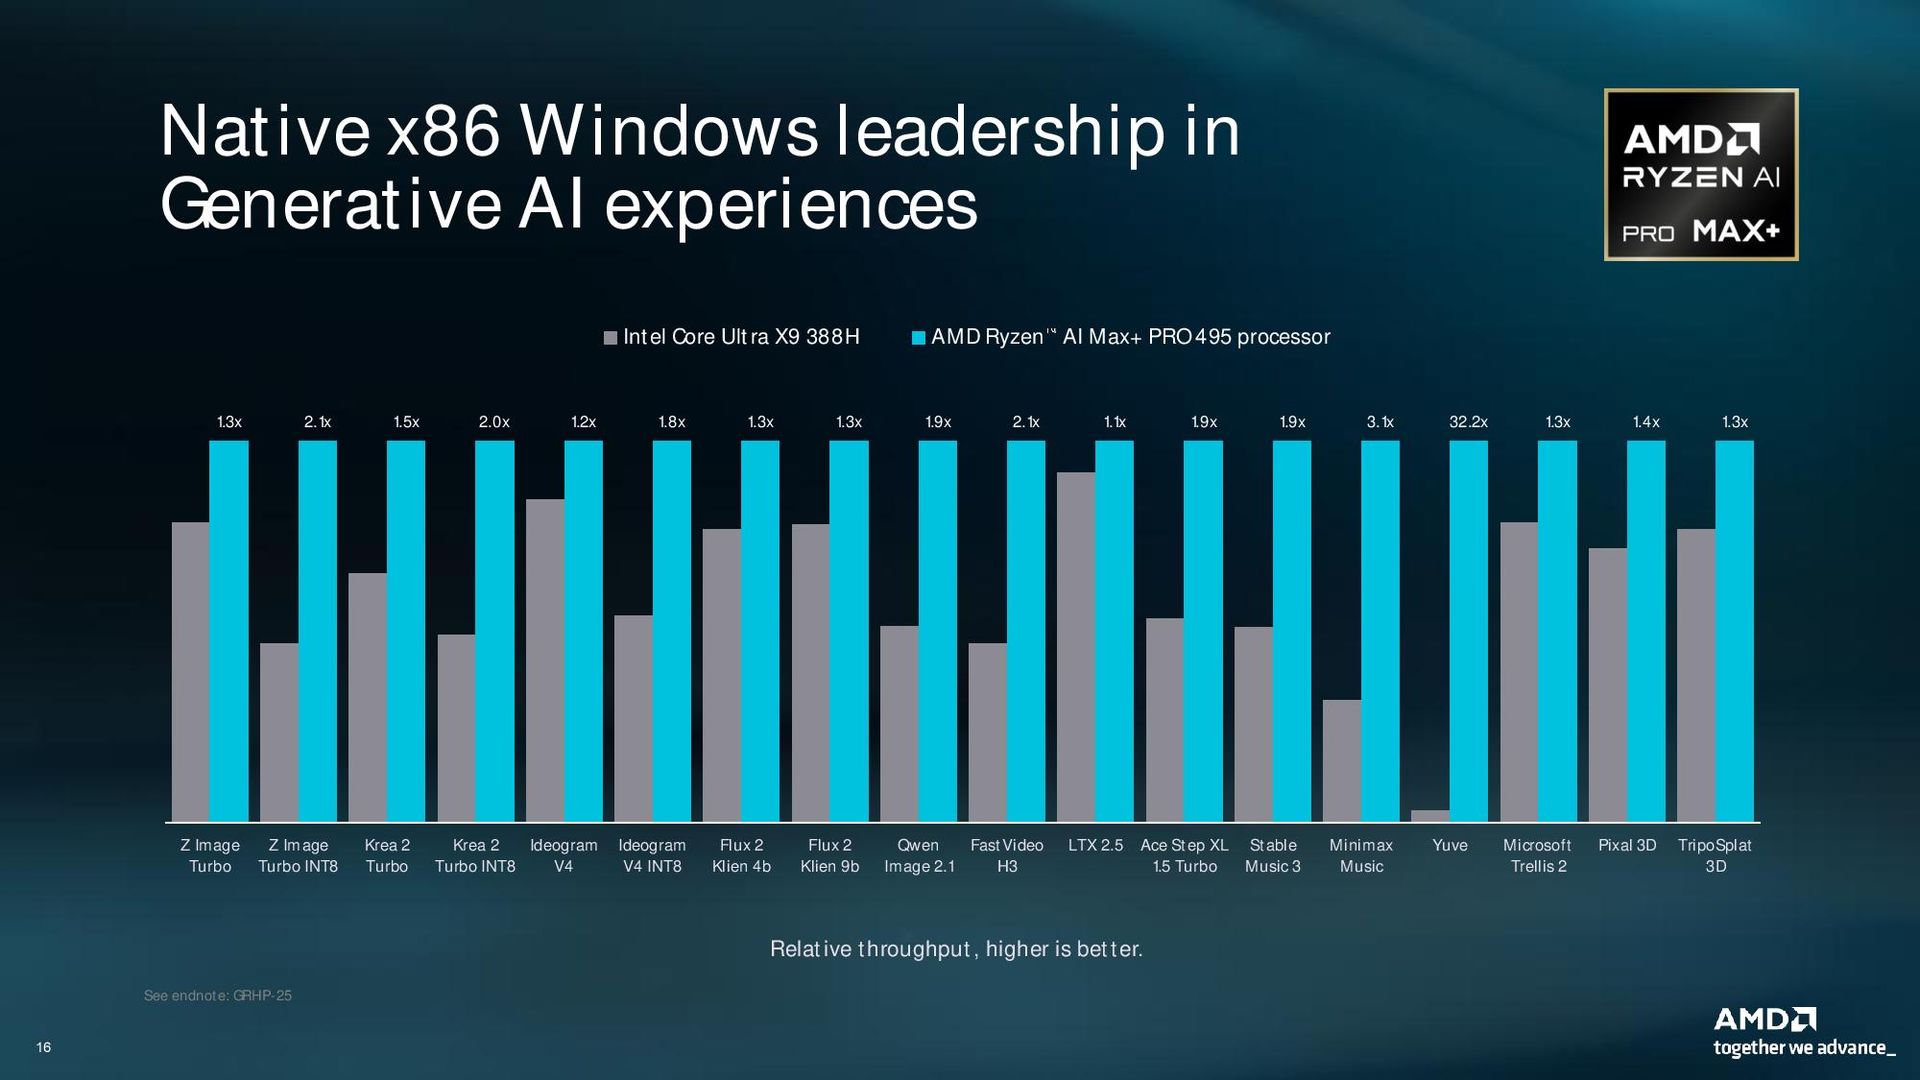
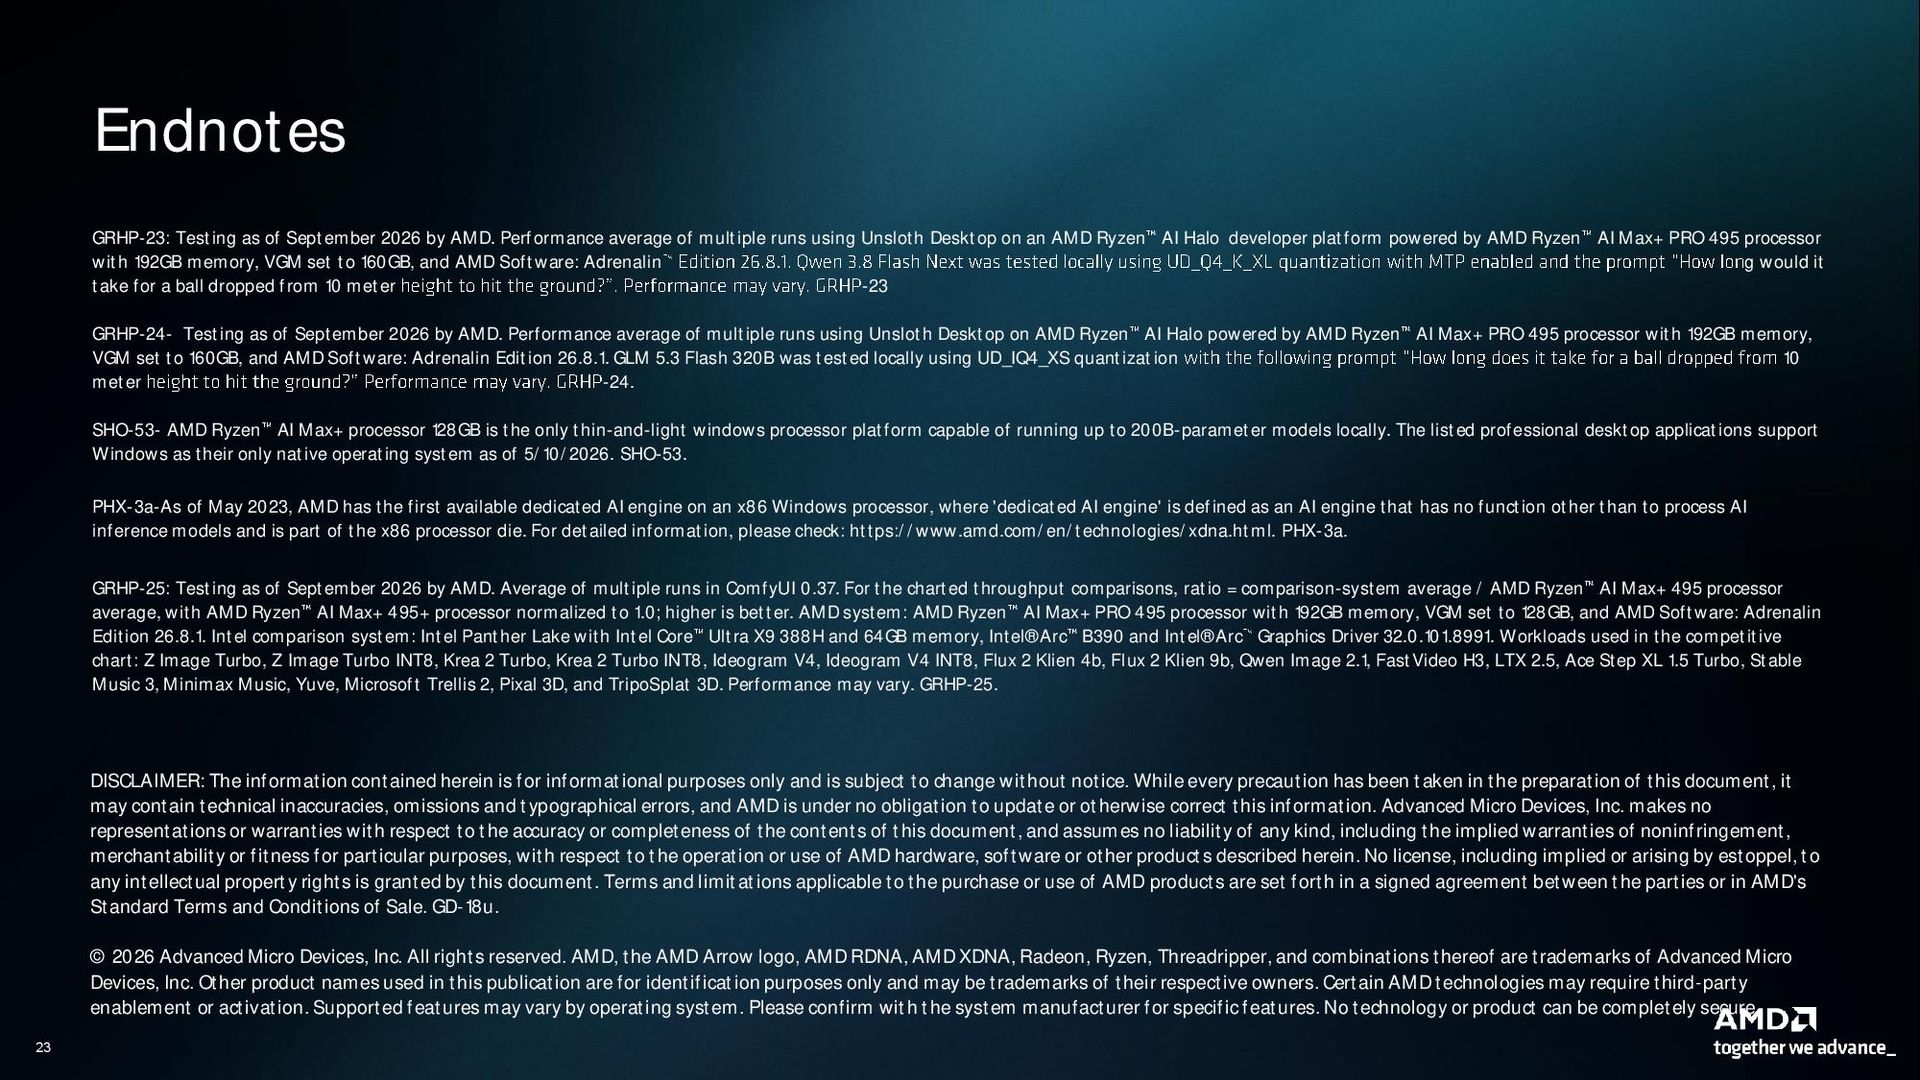
AMD는 ComfyUI를 사용하여 생성형 AI 성능을 측정했습니다. AMD는 다양한 모델의 여러 실행 결과를 평균화하여 총 처리량을 Intel의 경쟁 제품과 비교했습니다. AMD는 Ryzen AI Max+ Pro 495의 최고 사양인 192GB 구성을 사용했으며, 메모리 64GB 시스템에 탑재된 Core Ultra X9 388H와 비교했습니다 (Panther Lake는 최대 128GB를 지원합니다).
성능 우위는 1.1배에서 최대 32.2배까지 다양하지만, 이 끝점은 명확한 이상치입니다. 저희가 Hugging Face에서 Yuve를 검색했지만 아무런 결과도 찾지 못했습니다. 이러한 차이는 최적화 문제 때문이거나, 단순히 Panther Lake 장비에서 실행하기에 너무 클 수 있습니다.
(이미지 출처: AMD)
저희는 게이밍 또는 일반 애플리케이션 성능은 가지고 있지 않지만, 이전 세대 Strix Halo 칩과 비교했을 때 큰 변화를 기대하지 않습니다. Gorgon Halo는 이 범위의 상당한 리프레시 제품입니다.
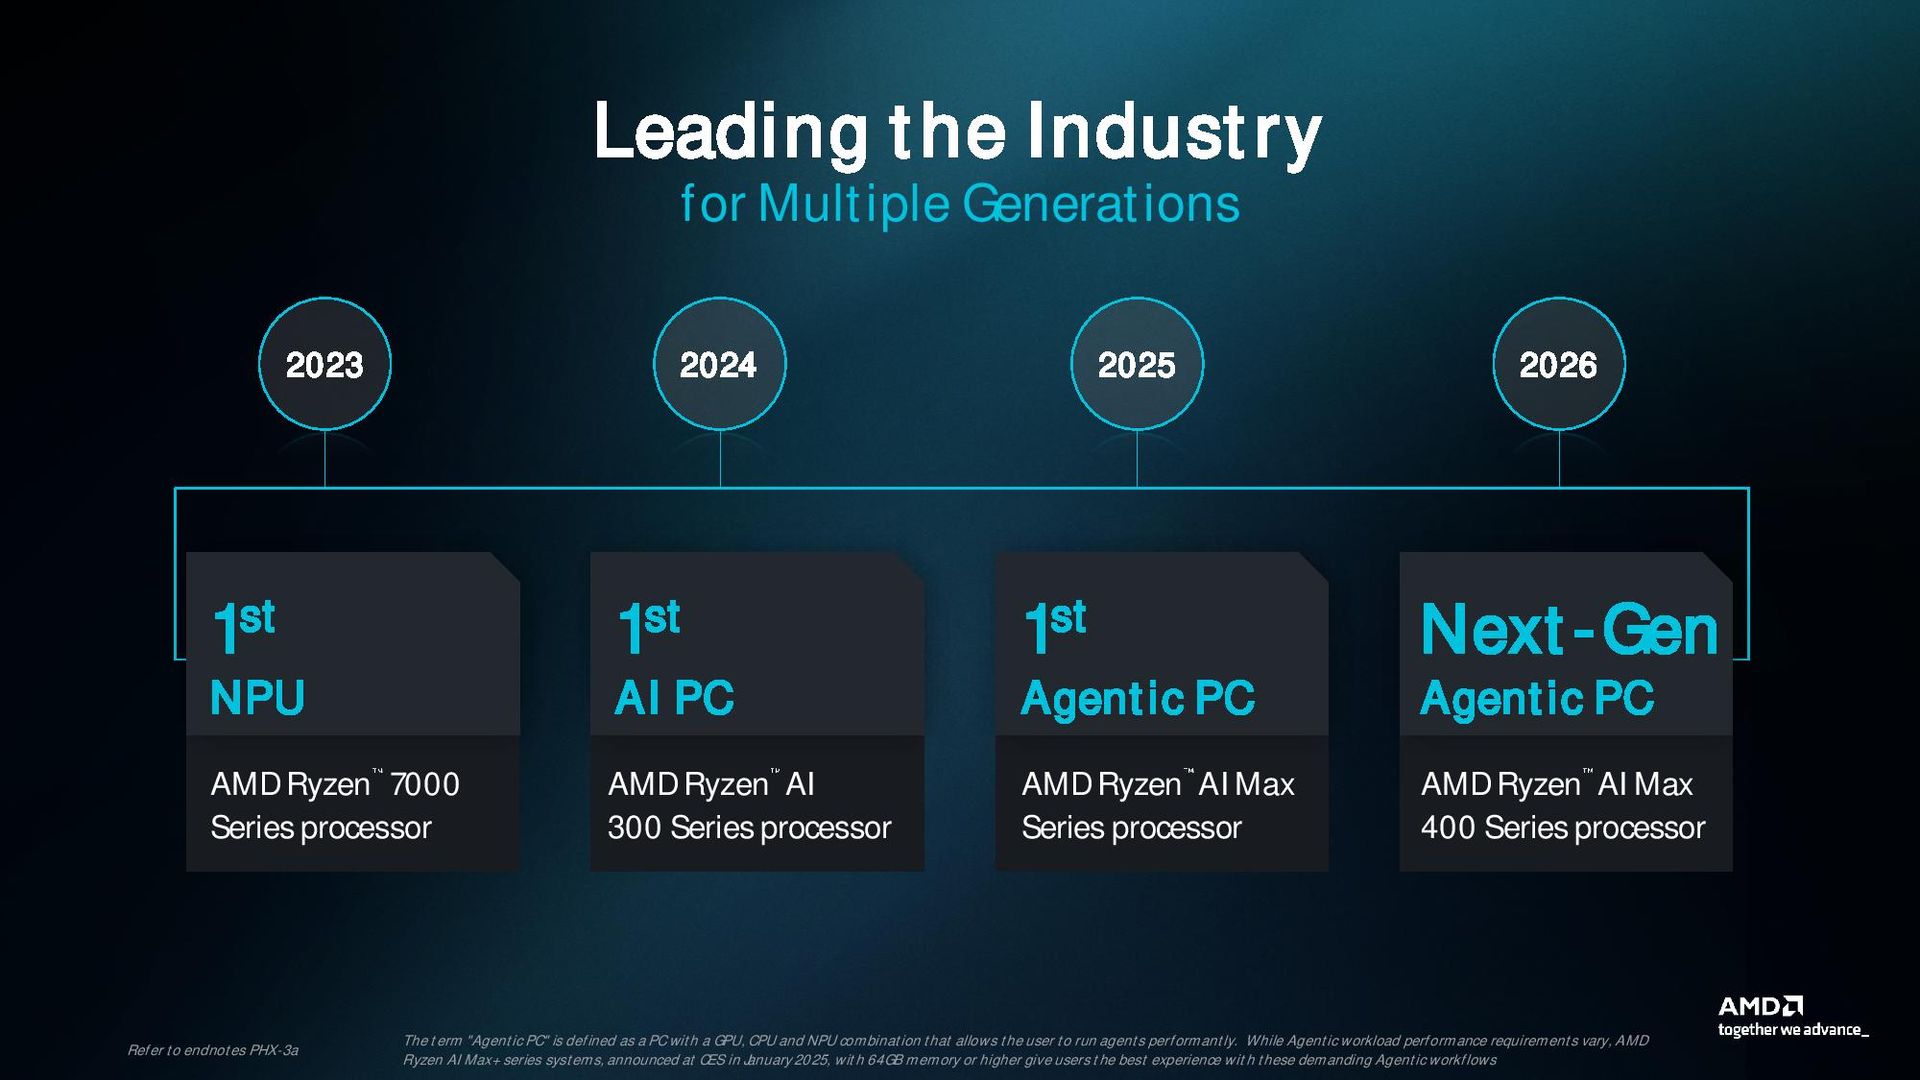
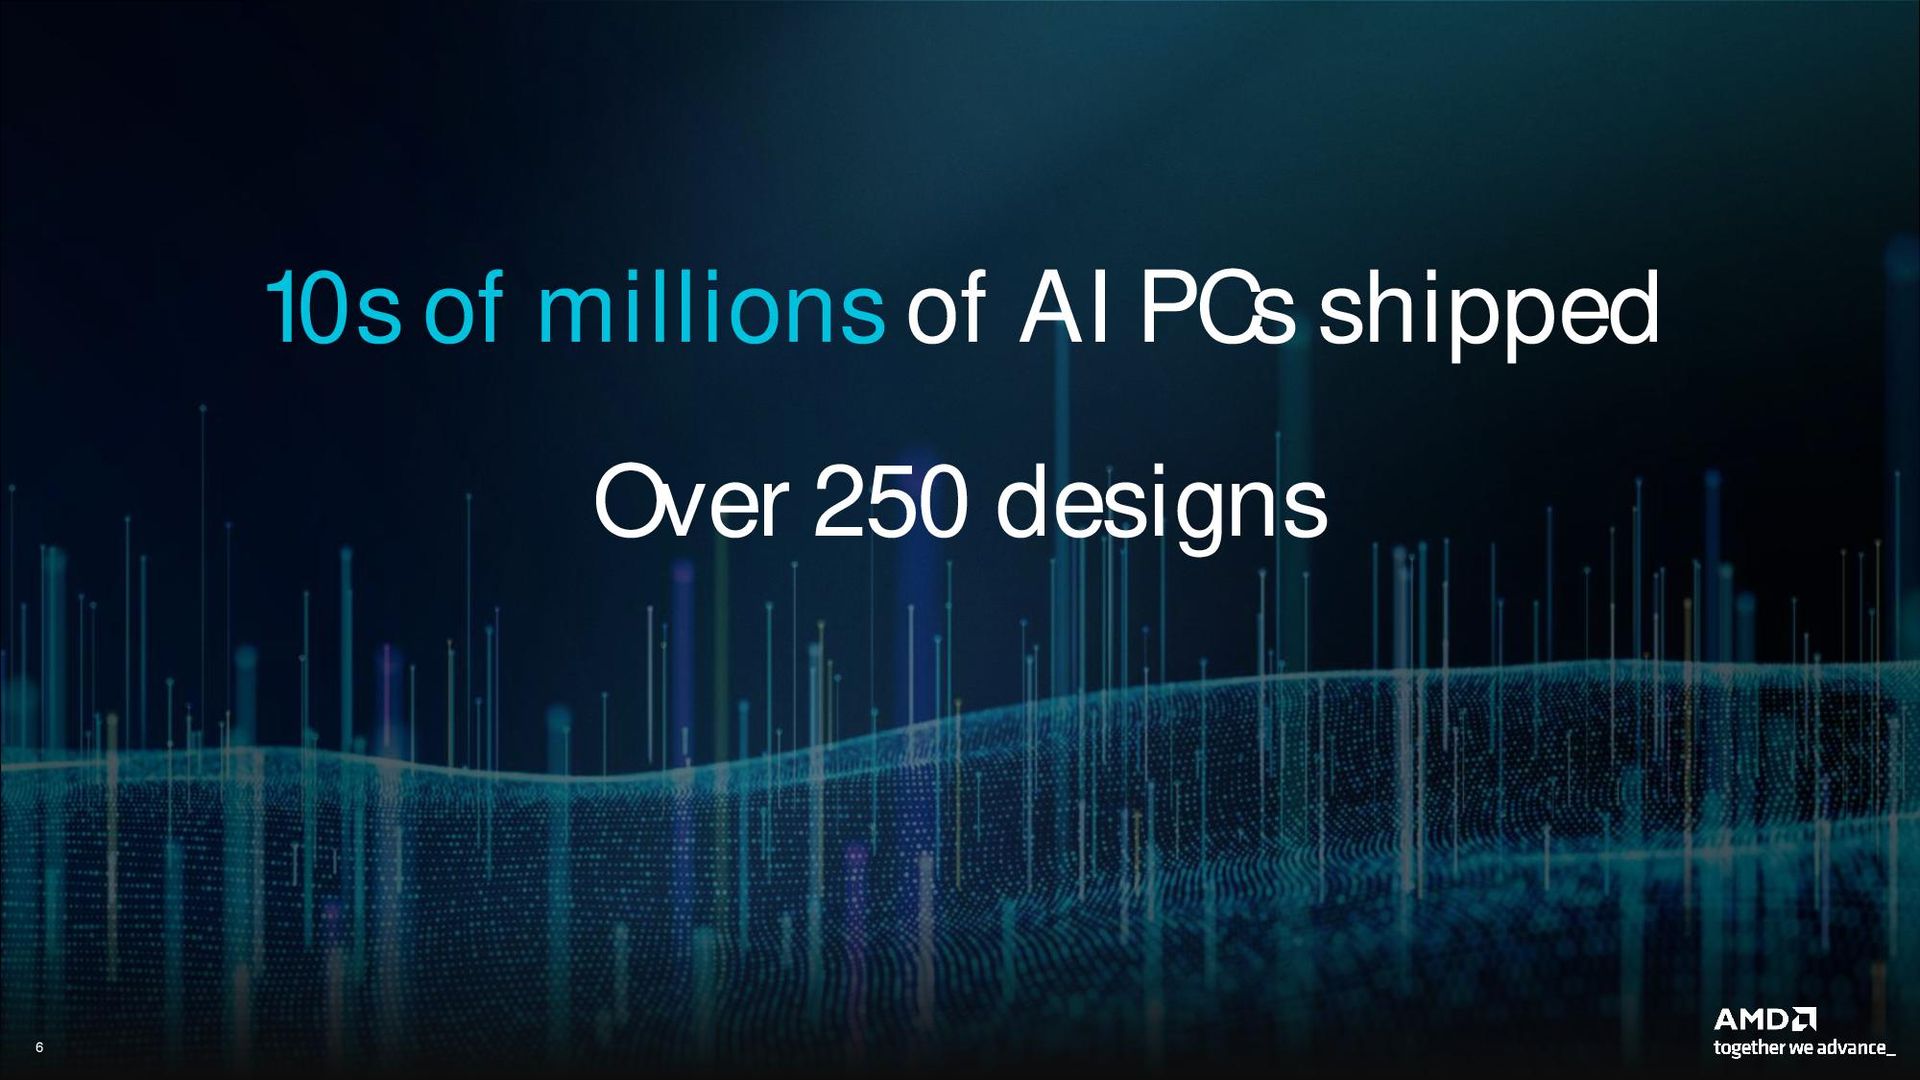
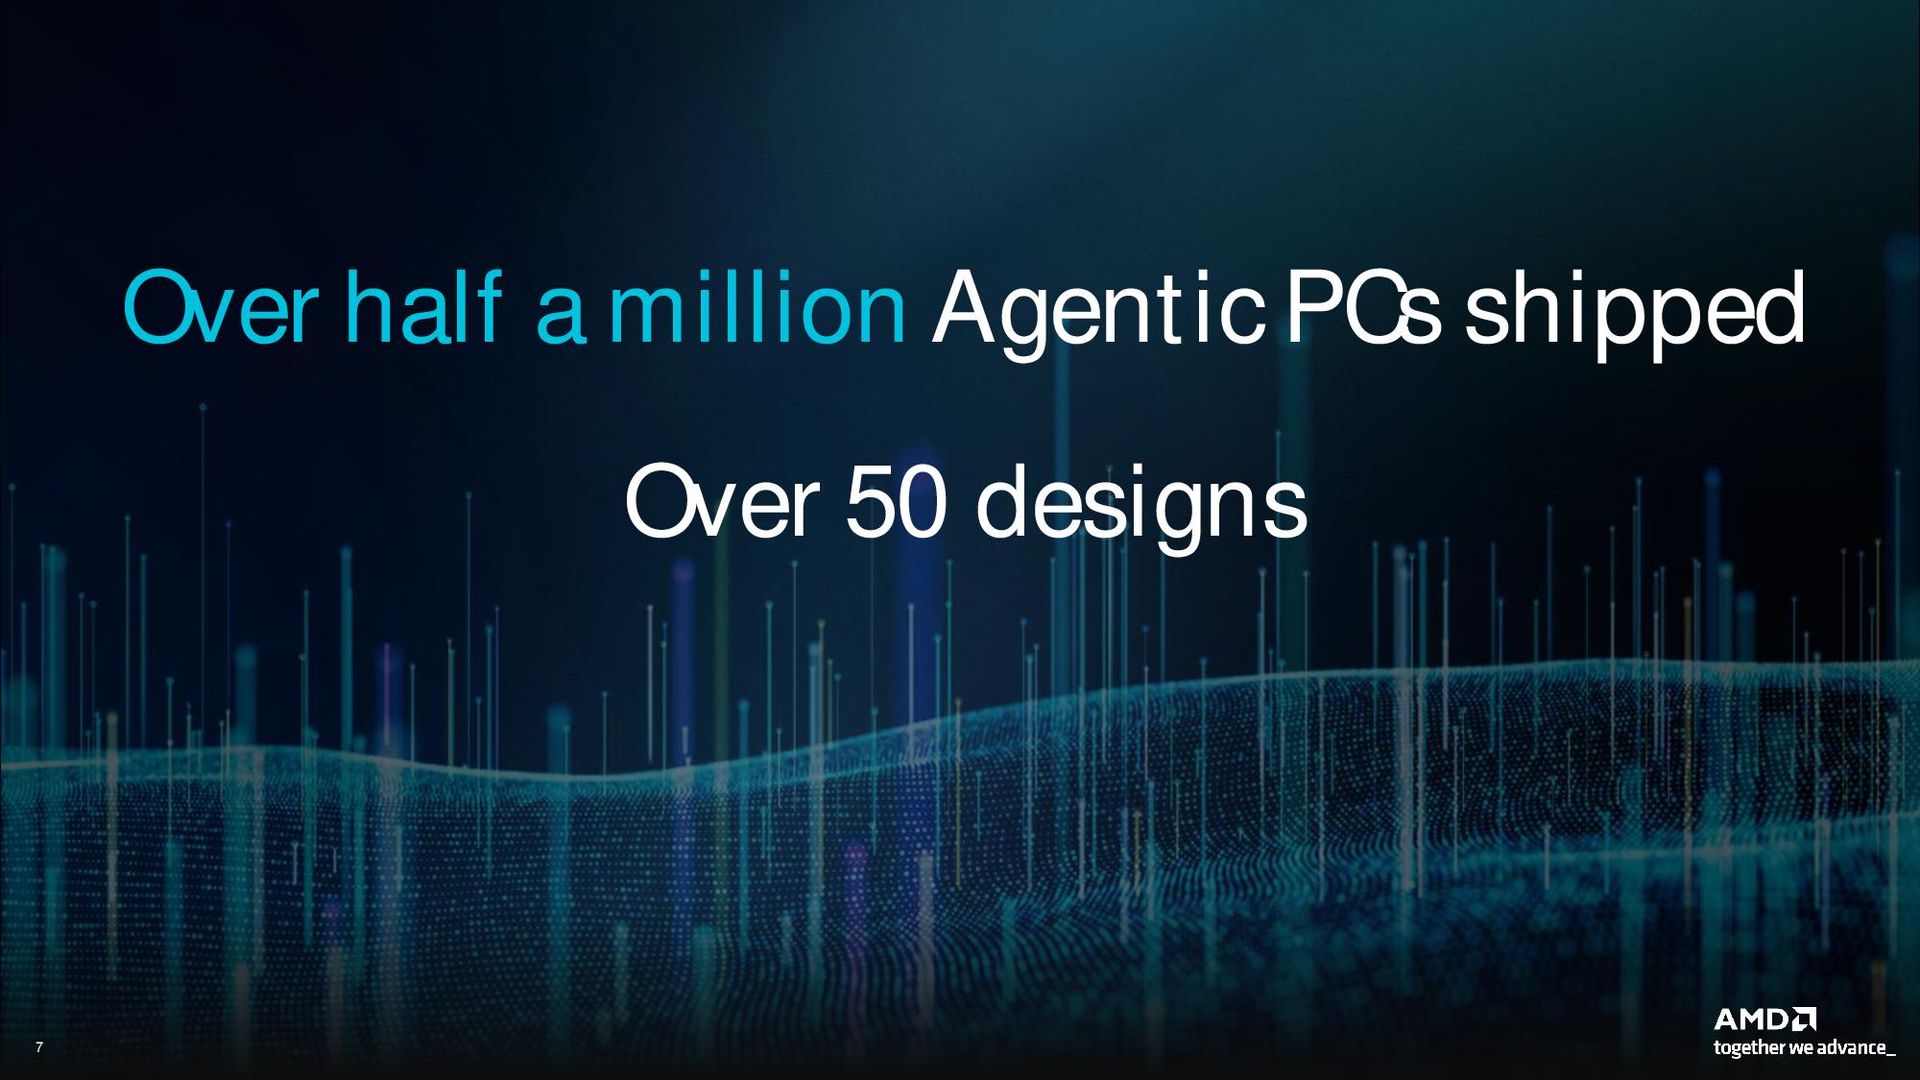
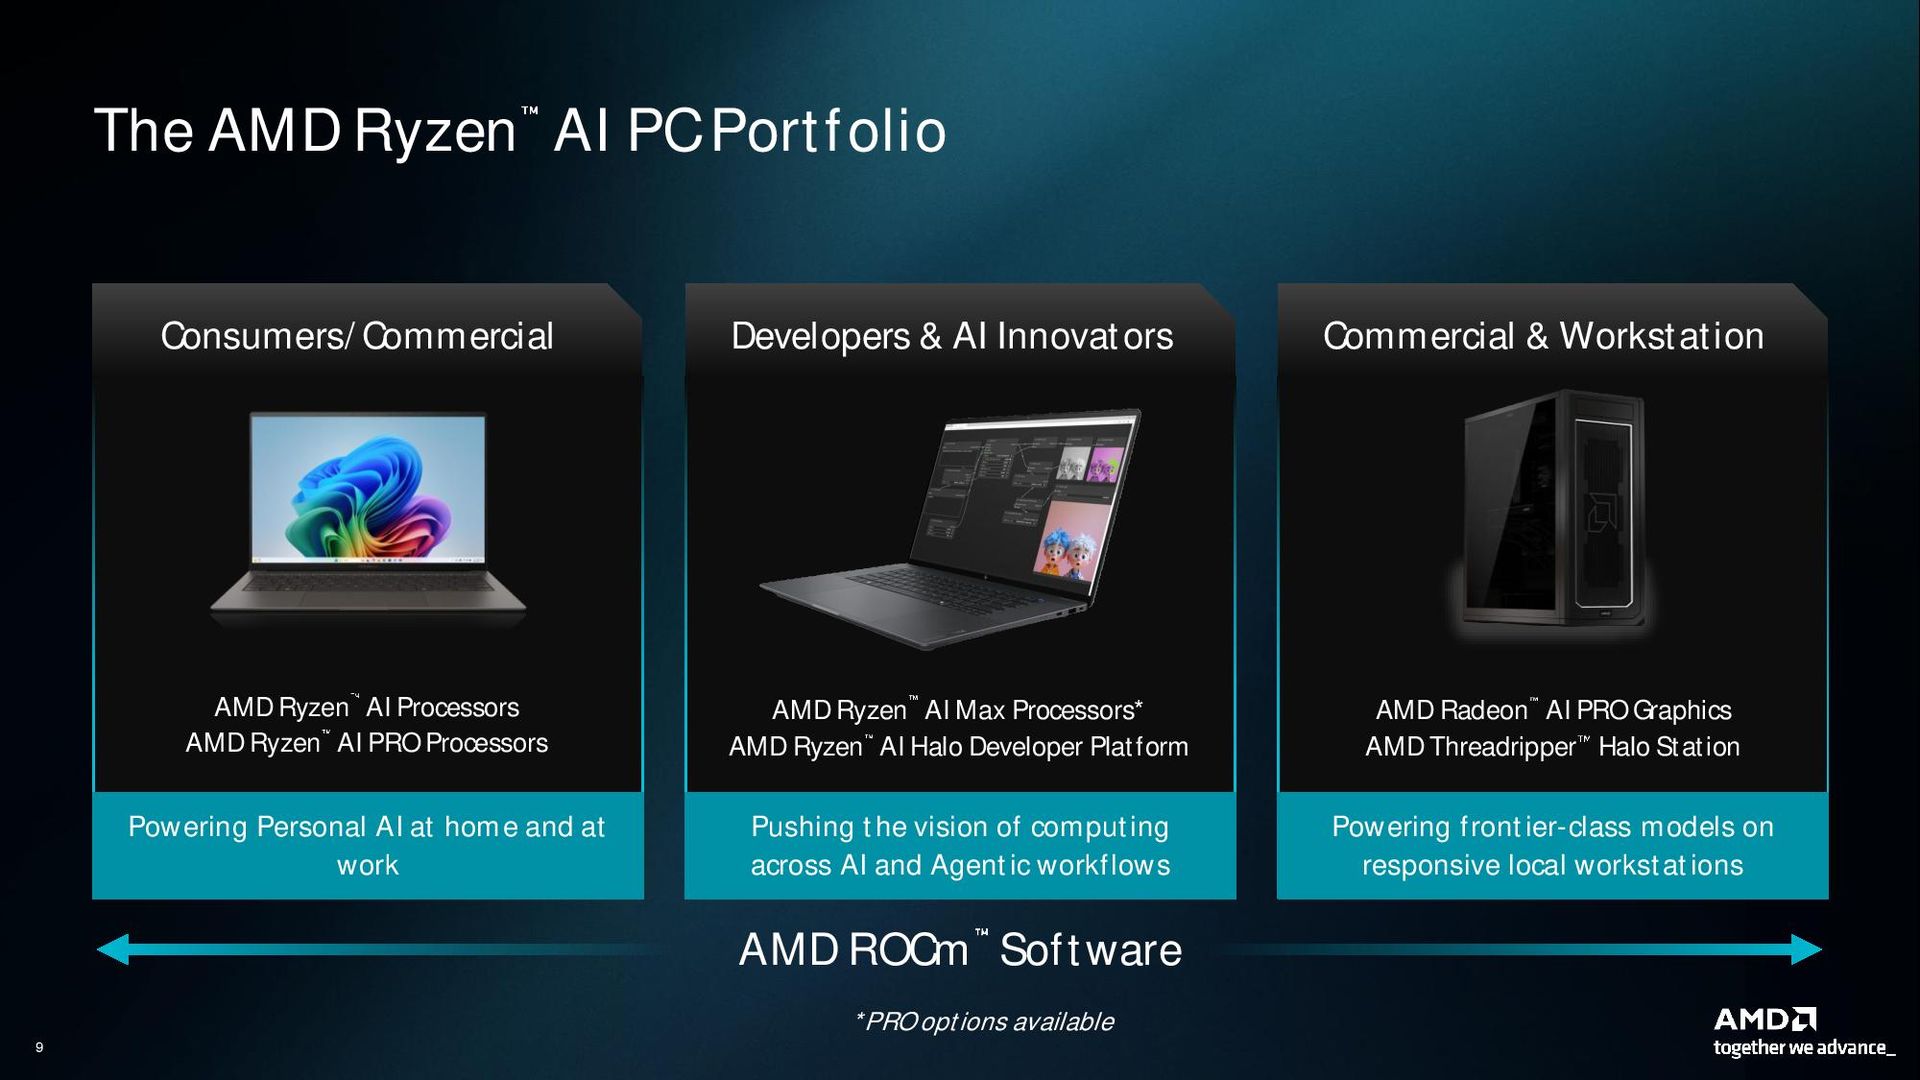
하지만 Gorgon Halo는 Panther Lake와 경쟁하지는 않습니다. 주로 RTX Spark를 겨냥하며, 어느 정도는 Apple의 대형 M-시리즈 SoC도 상대합니다. AMD가 부르는 이 에이전트 PC 카테고리는 확장되는 것처럼 보이지만, 여전히 RTX Spark에 대한 과장된 기대치보다 훨씬 작습니다. AMD는 기자 브리핑에서 수천만 개의 AI PC(즉, 노트북)를 출하했다고 자랑했지만, 나중에 '50만 개가 넘는' 에이전트 PC를 출하했다고 정정했습니다. 아마도 이 수치는 Strix/Gorgon Halo 장치에 대한 수치일 것입니다.
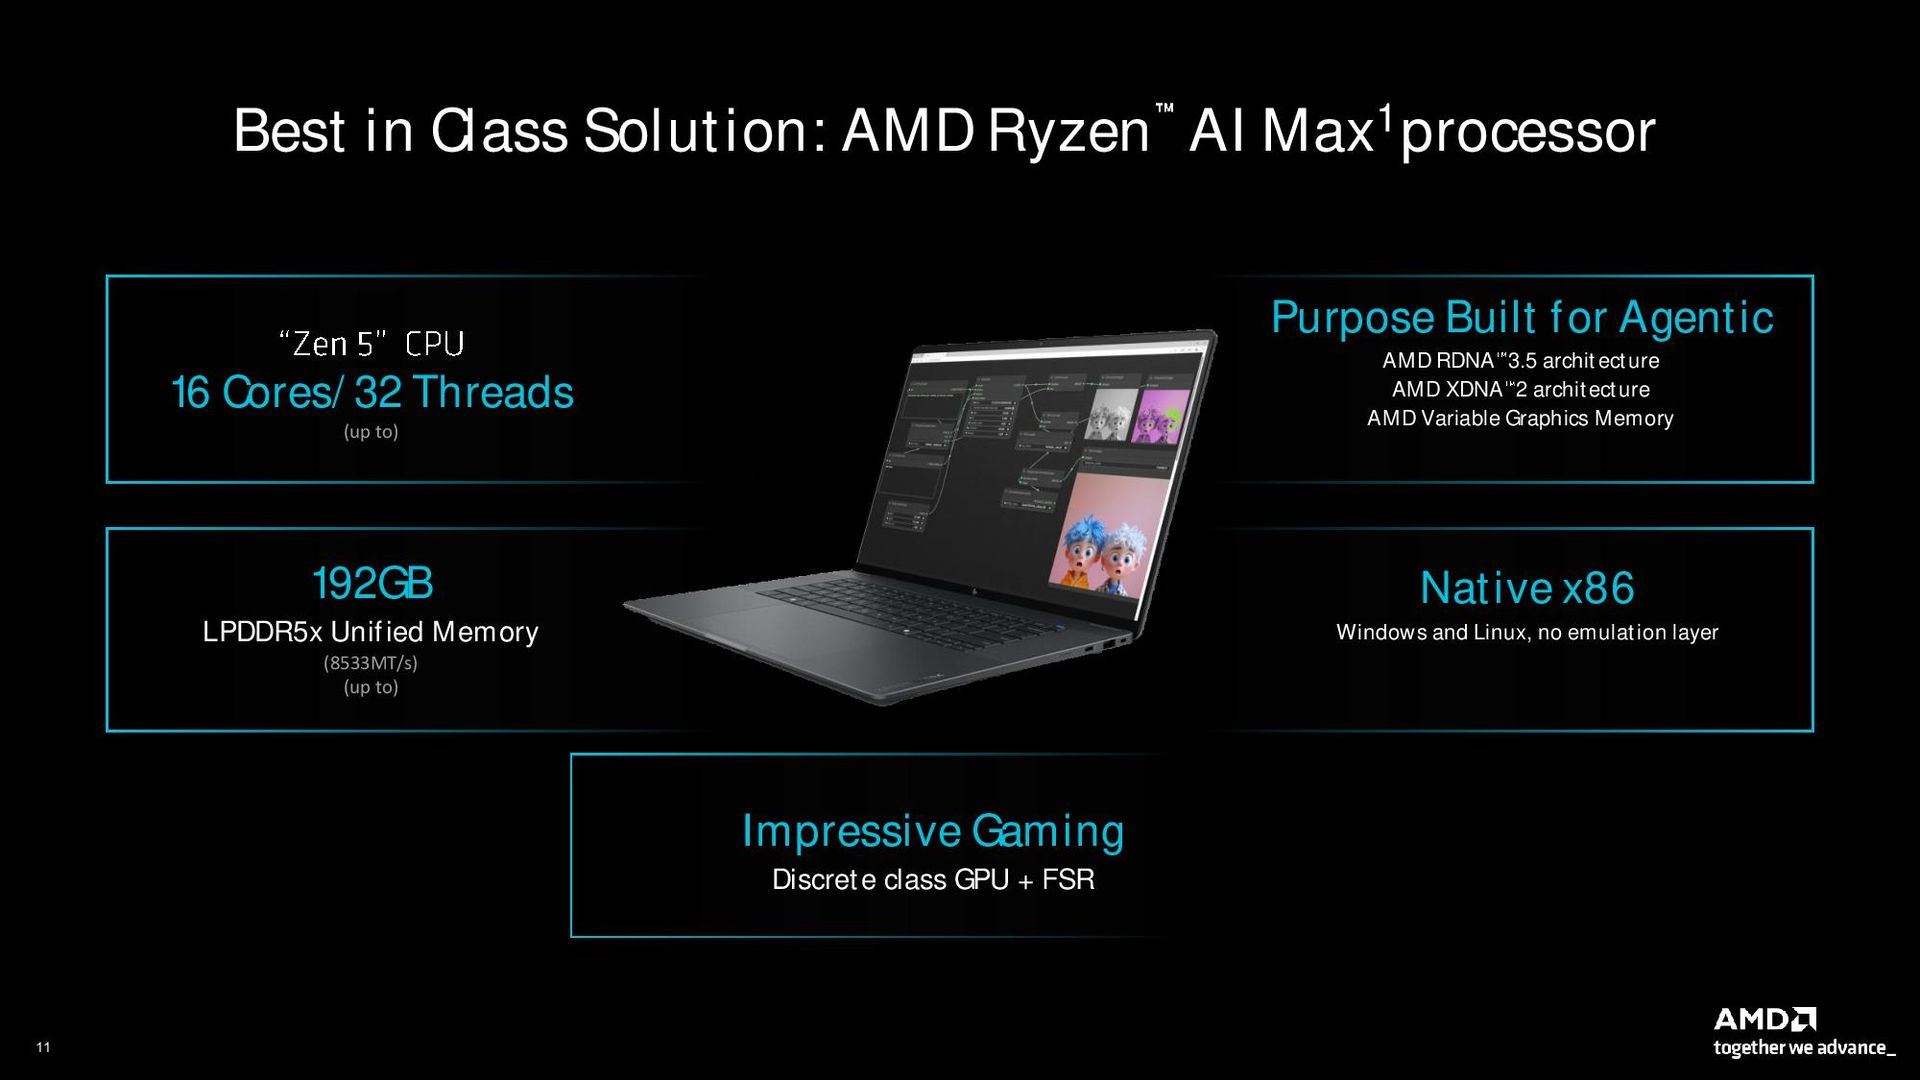
Gorgon Halo와 RTX Spark 간의 대결은 지금까지 주로 메모리 용량에 초점을 맞추어 왔습니다. RTX Spark 장치의 통합 메모리는 128GB로 최대이며, 이는 DGX Spark의 GB10과 동일합니다(두 칩은 거의 동일합니다). 반면 AMD는 Gorgon Halo를 통해 최대 192GB까지 지원합니다. 용량이 높다는 것은 더 큰 모델을 로컬에서 실행할 수 있다는 의미이지만, 성능 수준은 낮습니다.
(이미지 출처: AMD)
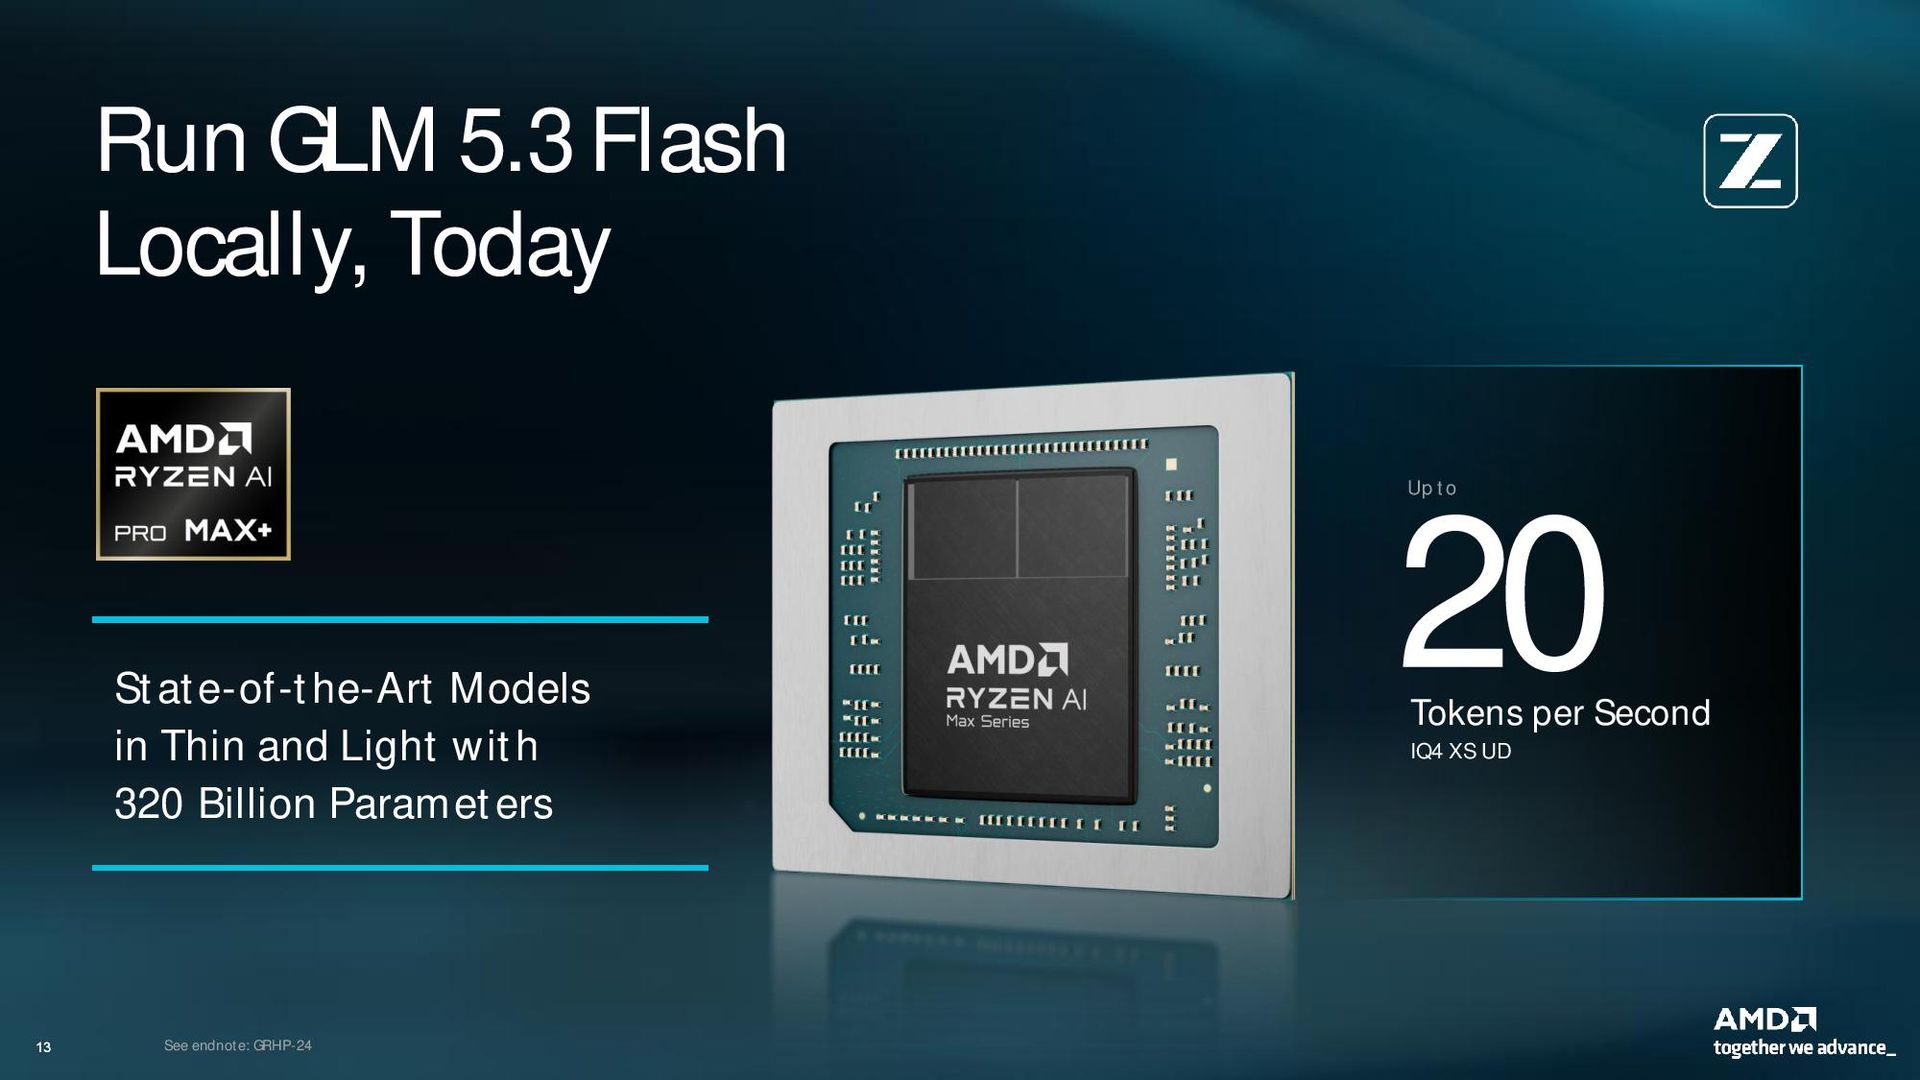
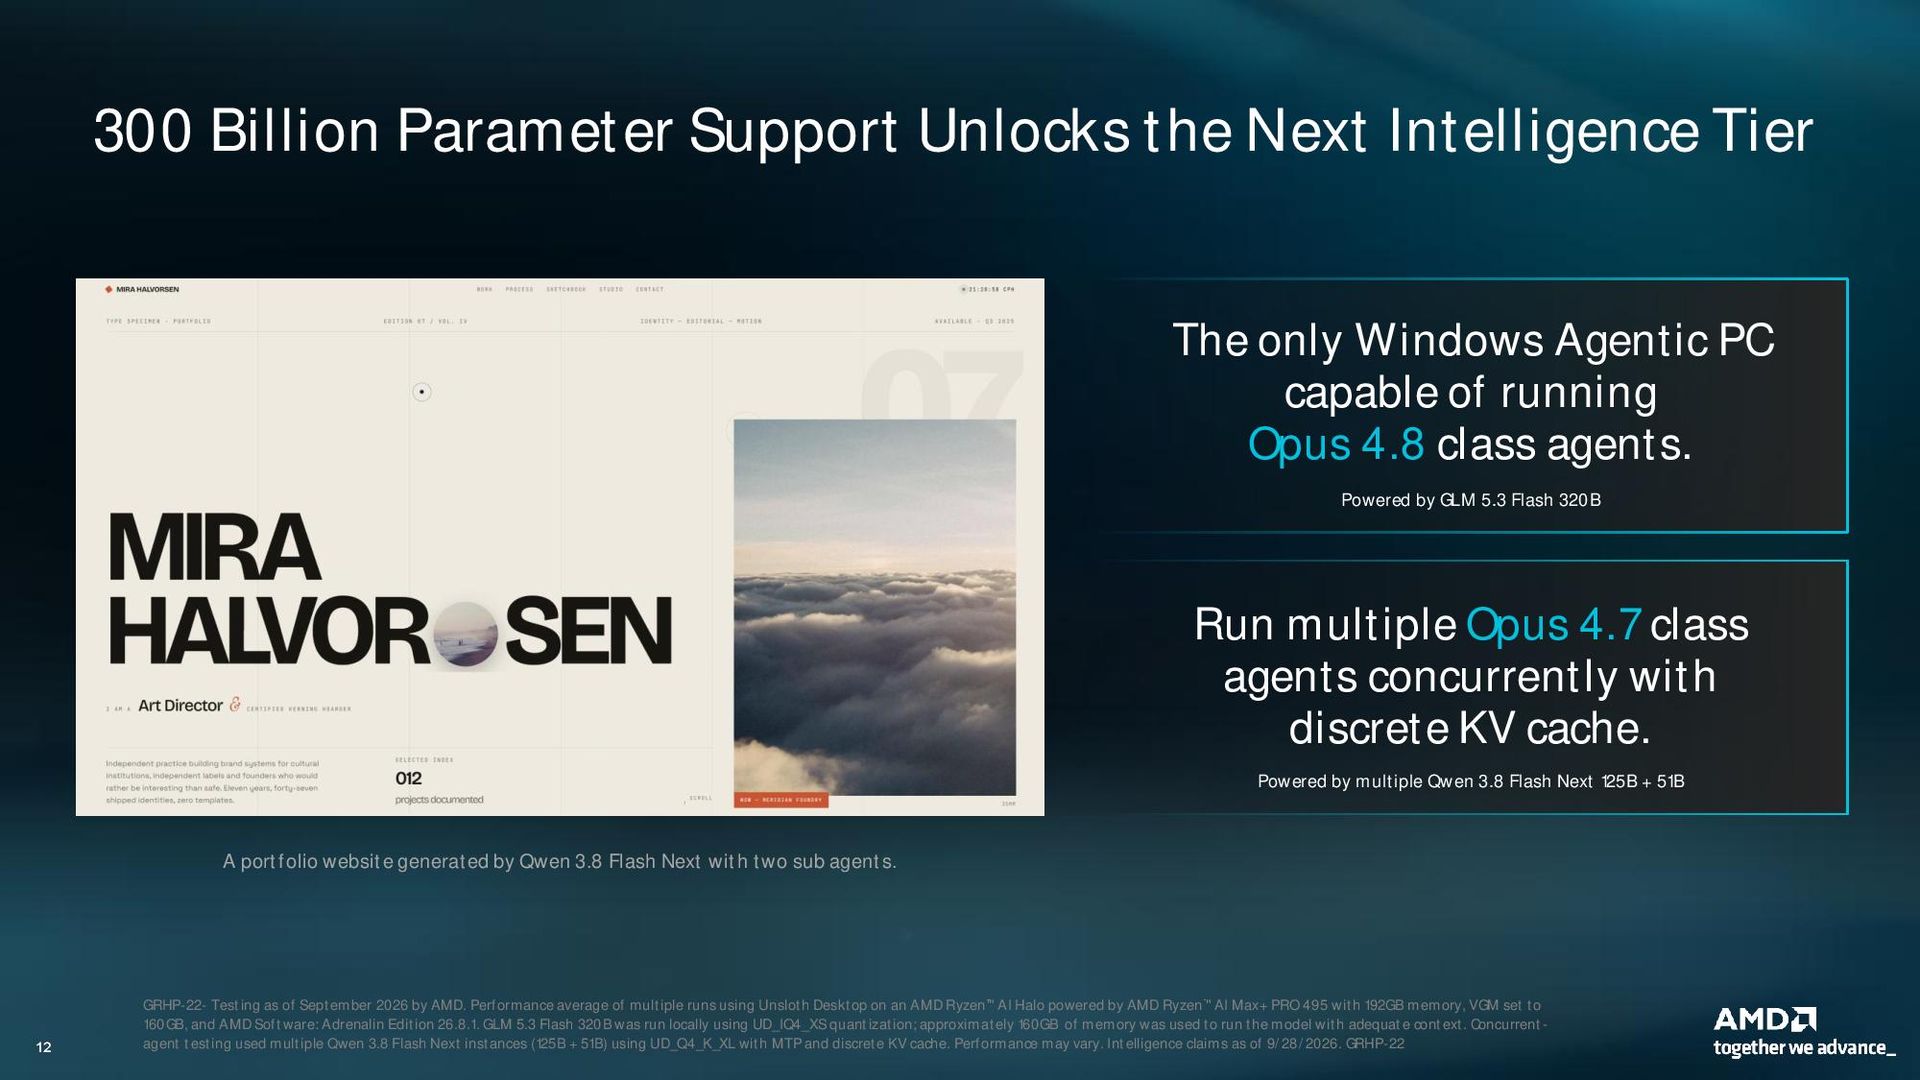
3,200억 개의 파라미터를 가진 GLM 5.3 Flash의 경우, Unsloth의 UD-IQ4_XS 혼합 양자화 형식을 사용했을 때 AMD는 초당 최대 20 토큰의 처리량을 기록했습니다. 참고로, 저희가 DGX Spark에서 GPT-OSS 120B를 4비트 양자화로 실행했을 때 측정한 최대 토큰 처리량은 초당 64 토큰이었고, 이전 세대 Ryzen AI MAx+ 395는 초당 56 토큰이었습니다.
참고할 점은 GLM 5.3 Flash가 총 3,200억 개의 파라미터를 가지고 있지만, 각 토큰에 활성화되는 것은 180억 개뿐이라는 것입니다. 마찬가지로, GPT-OSS 120B는 총 1,200억 개의 파라미터를 가진 또 다른 Mixture-of-Experts 모델이지만, 토큰당 약 50억 개만 활성화됩니다.
(이미지 출처: AMD)
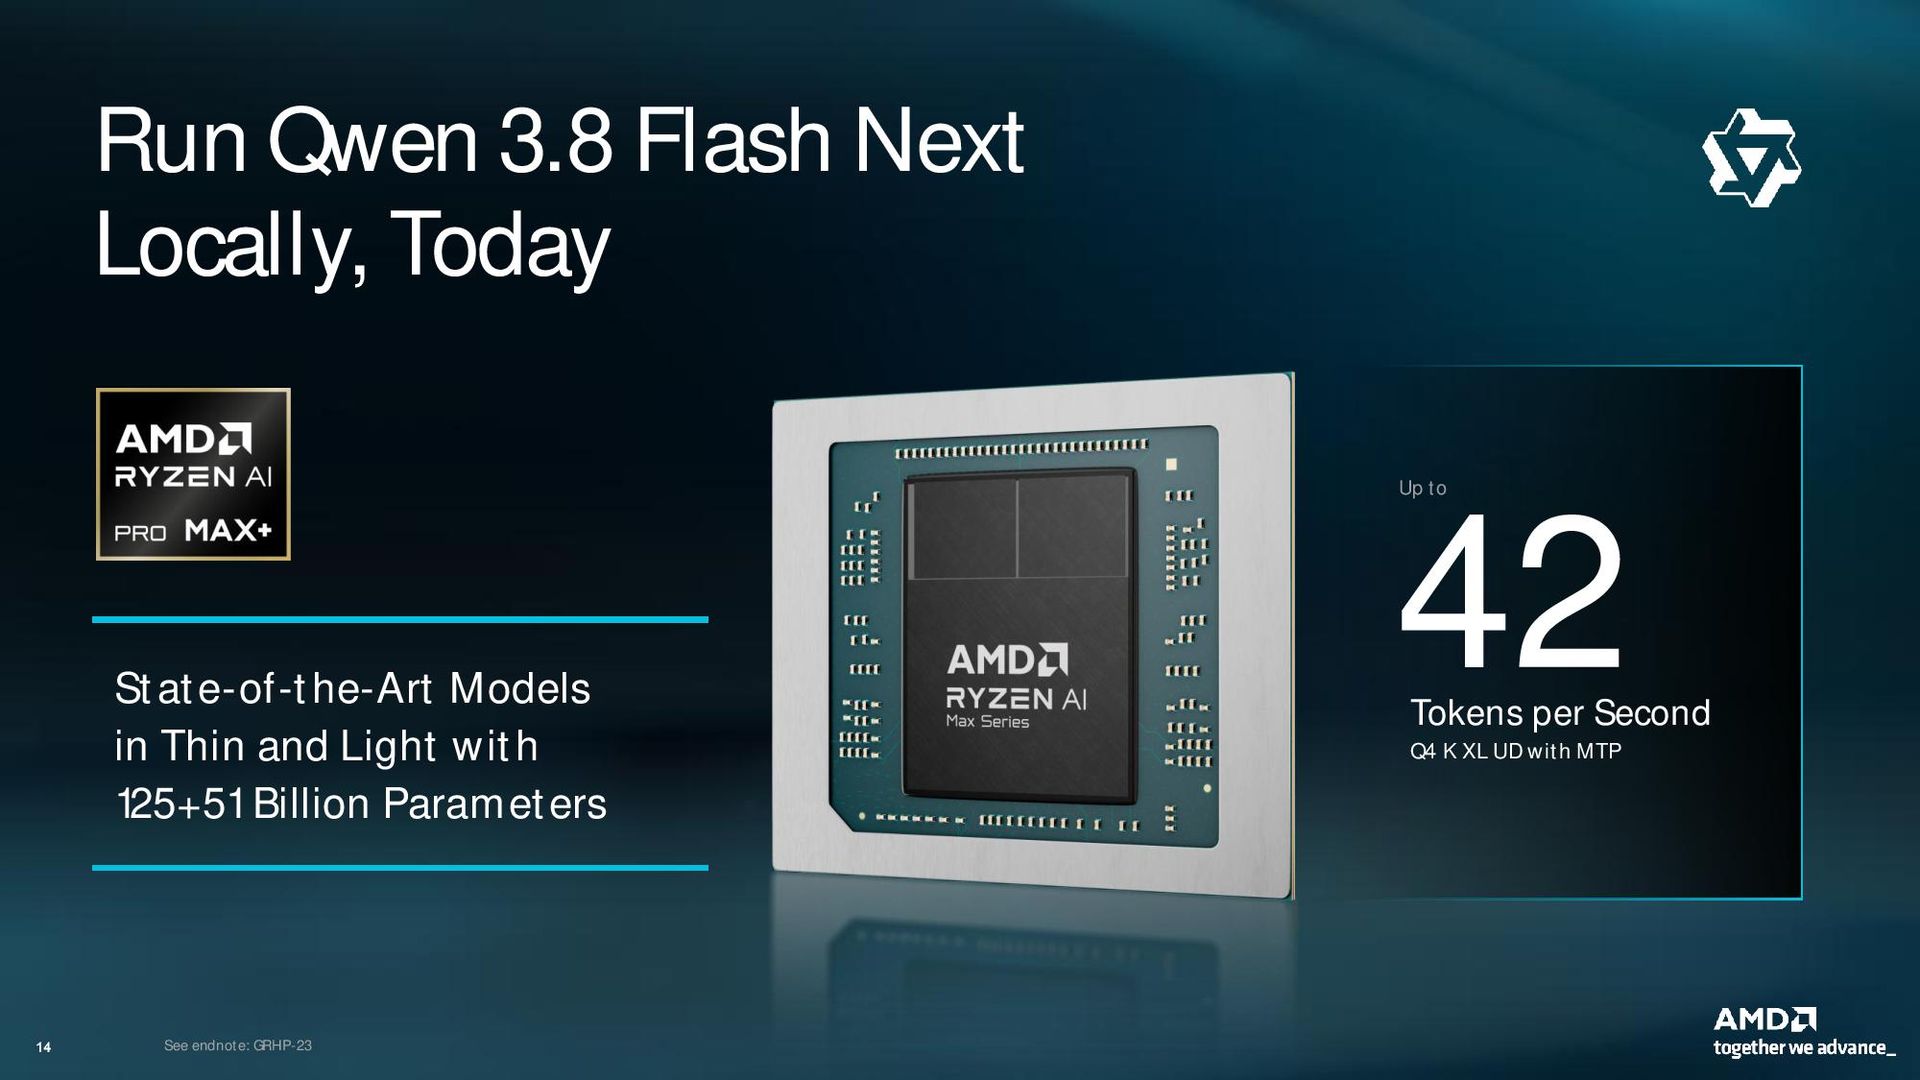
AMD는 또한 1250억 개의 메인 파라미터, 510억 개의 임베딩 파라미터를 가지며, 다중 토큰 예측(MTP)을 위해 약 40억 개의 파라미터를 사용하는 멀티모달 MoE 모델인 Qwen 3.8 Flash Next의 성능도 공유했습니다. 이 모델은 토큰당 50억 개의 파라미터가 활성화됩니다. AMD에 따르면 Ryzen AI Max+ Pro 495는 Unsloth의 동적 4비트 양자화와 MTP를 다시 사용하여 이 모델로 최대 초당 42개의 토큰을 달성합니다.
이는 견고한 성능이지만, 두 경우 모두 '최대'라는 단어가 큰 부담을 안겨줍니다. 토큰 처리량에 대한 이야기는 컨텍스트 길이가 증가함에 따라 전개되며, 단순히 부팅하는 것이 아니라 실제로 이 모델들을 로컬에서 실행했을 때 어떤 일이 발생하는지를 보여줍니다. 당연히 컨텍스트 길이가 길어지면 성능은 저하될 수 있으며, 이는 대규모 모델들에게 일부 문제를 야기할 수 있습니다. 만약 GLM 5.3 Flash가 최대 초당 20개의 토큰을 제공한다 하더라도, 컨텍스트 길이가 증가함에 따라 사용 불가능한 영역으로 쉽게 떨어질 수 있습니다.
우리는 Ryzen AI Max+ Pro 495와 Gorgon Halo의 예상 성능에 대해 대체로 알고 있습니다. 이는 Strix Halo의 리프레시 버전이며, 주목할 만한 사양 변경점은 통합 메모리가 128GB에서 192GB로 증가했다는 점과 495의 부스트 클럭이 100MHz 상승했다는 것입니다. 그 외에는 이전 세대 Strix Halo 칩과 동일한 코어 수와 마이크로아키텍처를 사용합니다.
이러한 대리 지표(proxy)들, 즉 Gorgon Halo에 대한 Strix Halo, 그리고 RTX Spark에 대한 GB10을 통해 우리는 이 부품들이 어떻게 성능을 발휘할지 이미 좋은 아이디어를 얻을 수 있습니다. 저희의 Ryzen AI Halo 리뷰 (Ryzen AI Max+ 395 탑재)에서 볼 수 있듯이, AMD의 부품은 세 가지 모델 모두에서 최초 토큰까지 걸리는 시간과 초당 토큰 수 측면에서 DGX Spark보다 전반적으로 성능이 떨어졌습니다. 더 많은 통합 메모리는 더 큰 모델을 실행할 수 있게 해주지만, 그것이 그 모델들이 더 빠르게 실행된다는 의미는 아닙니다.
첫 번째 Gorgon Halo 장치들은 현재 판매되고 있습니다. 예를 들어 Minisforum MS-S1 Max-P495와 같은 제품이 있습니다. 최고 사양 구성의 경우 현재 가격은 약 7,000달러 수준이지만, 다양한 장치들이 출시되면 광범위한 가격대가 형성될 것으로 예상되며, 이는 아마도 7,000달러를 초과할 가능성이 높습니다.
전체 발표 (Full presentation)
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AMD
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기