슈퍼컴퓨팅 2026 (SC26)이 이번 주 시카고에서 개최됨에 따라, AMD가 데이터센터 GPU 제품군에서 네이티브 FP64(배정밀도) 데이터 타입 지원 부족 문제를 간접적으로 지적하고 있습니다. FP64, 즉 배정밀도 부동소수점 연산은 SC26의 초점이 되는 고성능 과학 컴퓨팅 및 시뮬레이션 분야에서 광범위하게 사용됩니다. 이러한 고객들을 위해 AMD는 국가 연구소나 슈퍼컴퓨팅 센터와 같이 여전히 네이티브 FP64가 필요한 곳에 최신 Instinct MI430X 가속기의 가치를 홍보하고 있습니다.
지난 몇 년 동안 Nvidia는 데이터센터 GPU의 다이 영역을 현대 AI 추론(inference)에 필요한 연산을 증강시키는 낮은 정밀도의 행렬 수학에 유리하도록 재배치해 왔습니다. 이러한 재배치는 전체 시장 규모가 폭발적으로 증가한 AI 컴퓨팅 분야와 비교하여 대규모 슈퍼컴퓨팅 시설에서 배정밀도 수학 수요는 상대적으로 평탄하게 유지되었기 때문에 비즈니스적으로만 의미가 있습니다.
네이티브 FP64 지원 부족을 메우기 위해 Nvidia는 Ozaki schemes 같은 방법을 사용하여 FP64 연산을 에뮬레이션할 수 있도록 하는 기술에 의존해 왔습니다. 그러나 AMD는 이러한 종류의 에뮬레이션은 몇 가지 이유로 인해 네이티브 배정밀도 처리의 대체재가 될 수 없다고 주장하며, 이 때문에 MI430X와 같은 전문화된 제품 개발을 지속하고 있습니다.
첫째, AMD는 Ozaki 에뮬레이션이 해당 워크로드가 밀집 일반 행렬 곱셈(GEMM)과 유사하다고 가정한다고 지적합니다. 자체 애플리케이션 프로파일링에 따르면, 이 회사는 HPC 워크로드의 '10% 미만'만이 밀집 GEMM 연산을 수행하므로, 이러한 에뮬레이션은 네이티브 컴퓨팅의 좋은 대체재가 아니라고 말합니다. AMD는 밀집 선형 대수(Dense linear algebra)가 Ozaki 에뮬레이션이 자연스럽게 적합하다고 주장하는 공통 워크로드라고 언급했습니다.
AMD는 희소 반복 선형 대수(sparse iterative linear algebra), 스텐실 및 유체 역학(stencils and hydrodynamics), 고차 유한 요소 해석(high-order finite element analysis), 몬테카를로 및 입자 수송(Monte Carlo and particle transport), 그리고 고전 분자 동역학(classical molecular dynamics)과 같은 워크로드의 경우, 최상의 결과를 얻기 위해 개발자들이 여전히 강력한 FP64 벡터 성능이 필요하다고 말합니다.
더 나아가, GEMM 연산에 잘 매핑되는 워크로드의 경우에도 AMD는 최고의 성능을 달성하려면 행렬 크기가 커야 하며, 이것이 모든 연산에서 보장되는 것은 아닐 수 있다고 밝힙니다. 또한 해당 행렬의 피연산자(operands) 역시 하드웨어에 맞게 적절한 크기로 조정되어야 하는데, 잘못 스케일링된 피연산자는 성능을 저하시킬 수 있습니다. MI430X의 FP64 벡터 수학 기능은 이러한 피연산자 크기 문제에 영향을 받지 않습니다.
이러한 난관 외에도 AMD는 Ozaki 에뮬레이션 방식을 사용하면 애플리케이션의 메모리 풋프린트(memory footprint)가 급증하여, 네이티브 FP64를 사용할 때보다 최대 세 배 많은 용량을 요구할 수 있다고 지적합니다.
현대 슈퍼컴퓨팅 설치 환경에서 HBM 용량은 GPU에 직접적으로 연결되어 있기 때문에, 오직 FP64 연산만 에뮬레이션할 수 있는 장치에 워크로드를 맞추는 것은 필요한 GPU 및 컴퓨트 노드 수에 연쇄적인 영향을 미칠 수 있으며, 이는 시스템을 지원하는 데 필요한 바닥 면적(floor area), 전력, 냉각 측면에서 파급되는 도전 과제를 야기합니다.
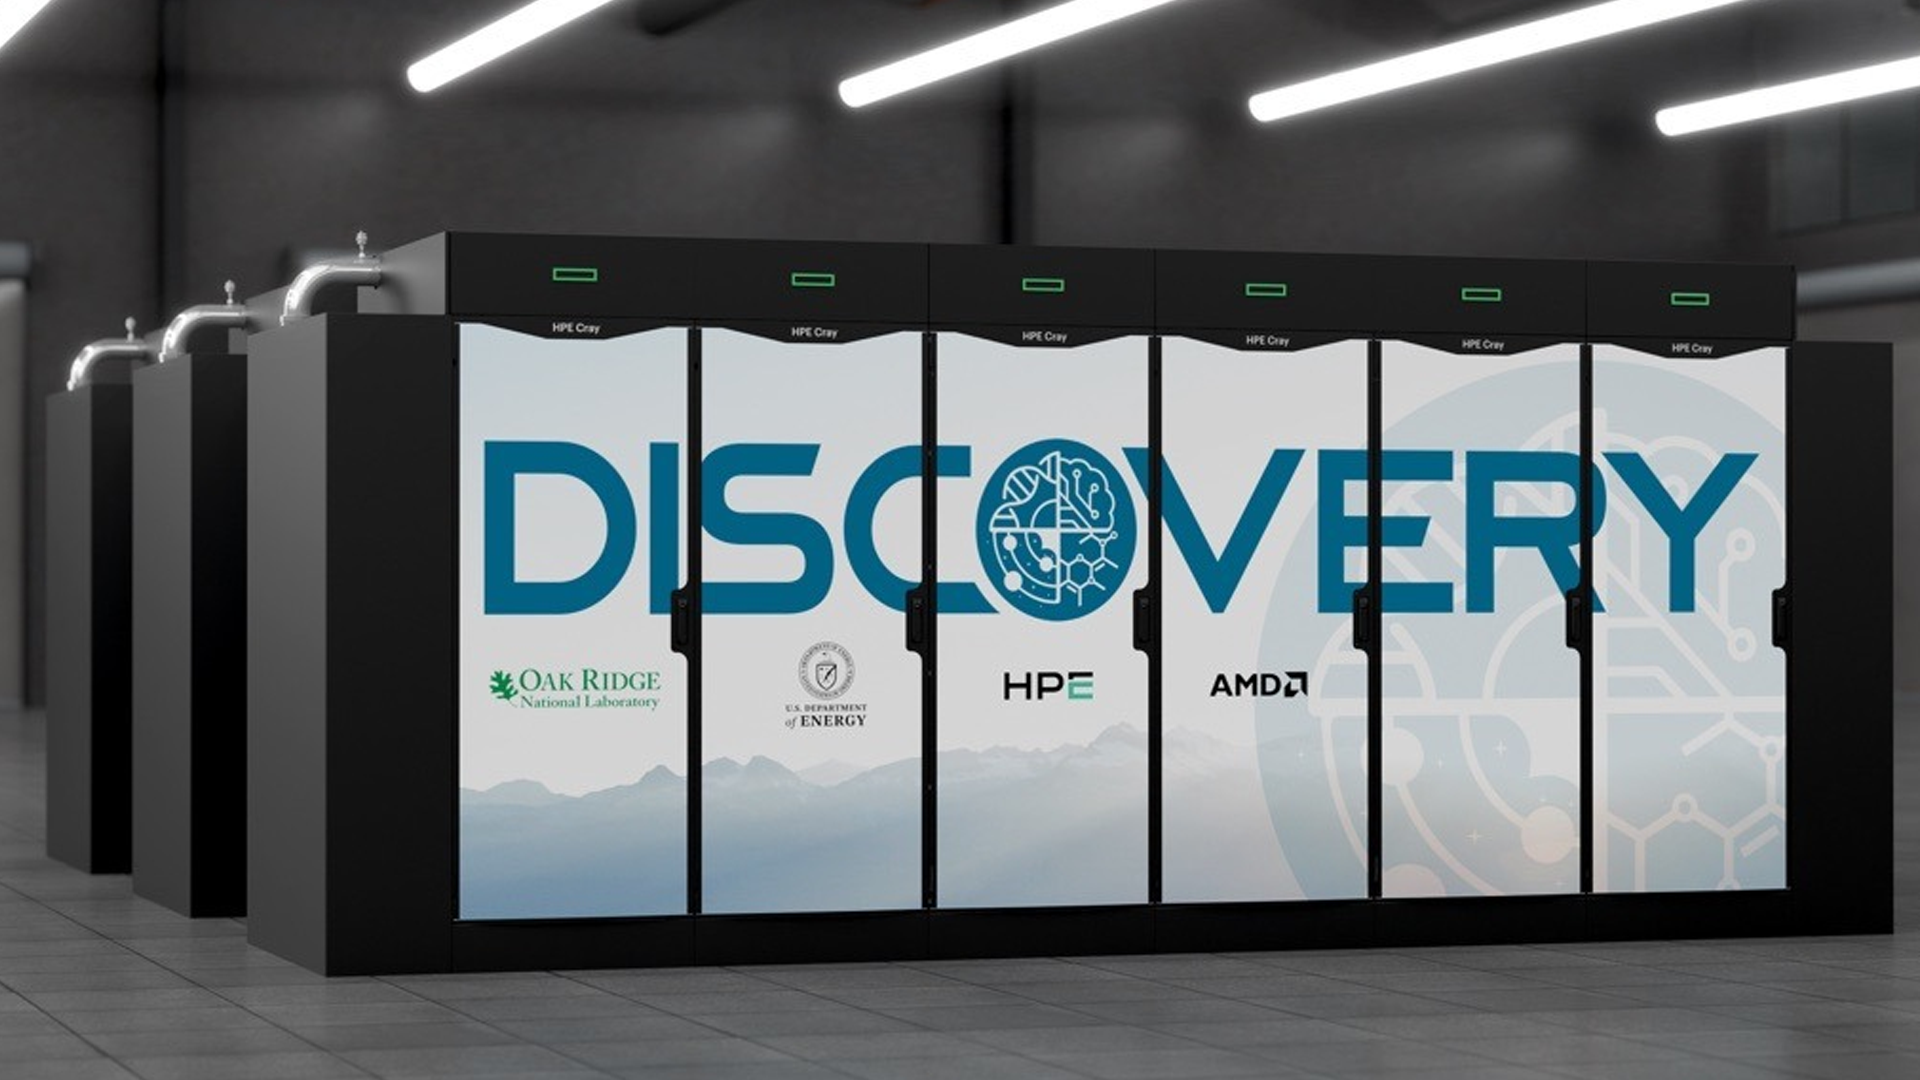
A render of the Discovery supercomputer
오크리지 국립 연구소 디스커버리 슈퍼컴퓨터 (MI430X GPU 구동) (이미지 출처: 오크리지 국립 연구소)
AMD는 MI430X 노드당 높은 432GB의 HBM4 메모리 용량이 고객들이 시스템 내에서 더 적은 수의 GPU와 컴퓨트 노드를 구성할 수 있게 하여, 네트워킹, 전력 및 바닥 공간을 절약할 수 있도록 한다고 말합니다.
AMD는 FP64 HPC 성능 외에도, 연구 과정의 일부로 해당 모델을 활용하는 워크로드를 개발하기 위한 AI 추론 플랫폼으로 MI430X 기반 슈퍼컴퓨터를 포지셔닝하고 있습니다. 하지만 이 시스템들과 동일한 CDNA 5 아키텍처 계열의 MI455X GPU가 구동하는 Helios 랙 규모 가속기 사이에는 몇 가지 주요 차이점이 있습니다.
각 MI430X GPU는 추론을 위한 이론적 FP4 컴퓨팅 성능으로 9.2 PFLOPS를 제공하지만, 이는 AI에 초점을 맞춘 MI455X 가속기 각각이 제공하는 무려 40.3 PFLOPS의 FP4 컴퓨팅 성능과 비교하여 이해해야 합니다.
순수 성능을 넘어, 6세대 EPYC 호스트 CPU와 결합된 AMD의 Infinity Fabric 인터커넥트를 통한 네 개의 MI430X의 네이티브 스케일업 도메인 크기는 Helios 랙에 있는 72개의 MI455X 가속기의 도메인 크기와 비교했을 때 미미합니다. AMD는 이 인터커넥트가 대규모 스케일업 도메인보다는 지연 시간에 민감한 작업에 더 최적화되어 있다고 말합니다.
물론 이러한 시스템의 모든 고객과 사용자는 서로 다른 요구 사항을 가질 것이며, 기관용 슈퍼컴퓨팅 시설은 일반적으로 클라우드 추론 제공업체 역할을 이중으로 수행하려고 하지 않습니다.
12.3 Tbps의 스케일업 대역폭 내에서 작동하는 네 개의 MI430X가 제공하는 총 1.72 TB의 HBM4 용량과 93.2 TB/s의 메모리 대역폭 내에서 잘 작동하는 AI 모델을 선택한 과학자 및 엔지니어들에게, 각 노드의 추론 성능은 배정밀도 컴퓨팅 워크로드와 함께 실행되어야 하는 종류의 AI 애플리케이션 작업을 충분히 수행할 가능성이 높습니다.
어쨌든, MI430X는 이미 여러 슈퍼컴퓨팅 설계 수주를 확보했습니다. 오크리지 국립 연구소(Oak Ridge National Laboratory)의 차세대 Discovery 슈퍼컴퓨터, 프랑스의 Alice Recoque 설치 시스템, 핀란드의 CSC에 있는 LUMI-AI 시스템, 그리고 독일의 Herder 시스템 모두 MI430X가 제공하는 네이티브 FP64 지원을 활용할 것입니다.
Nvidia가 자사 제품에서 해당 기능을 포기하는 상황에서도 AMD의 네이티브 FP64에 대한 지속적인 지원은 아키텍트와 엔지니어들에게 의심할 여지 없는 자랑거리가 될 것입니다. 비록 이러한 기관용 슈퍼컴퓨터들이 전 세계적으로 AMD 및 Nvidia 기반 AI 추론 설치 시설에 의해 압도될 것이라 할지라도 말입니다. 이 회사의 반맞춤형 실리콘 설계 역량(semi-custom silicon design chops)과 chiplet 경험은 MI430X와 같은 제품을 범용적인 접근 방식(one-size-fits-all approach)을 추구하는 대신 이러한 전문 시장에 맞게 조정할 수 있는 유연성을 제공합니다.