
AMD가 돈을 벌기 위해 활용하는 랙 규모(Rackscale) AI 시스템 로드맵
요약
AMD는 데이터센터 시장에서 신뢰도를 회복하며, AI 산업 거물 Nvidia에 대항하는 강력한 로드맵을 제시하고 있습니다. AMD는 Zen 6 CPU와 같은 차세대 서버 CPU를 통해 X86 서버 시장 점유율을 확대할 계획이며, Arm 기반 아키텍처의 성장에 주목해야 합니다.
핵심 포인트
- AMD는 데이터센터 시장에서 Nvidia에 대항하는 강력한 로드맵을 구축 중입니다.
- Zen 6 CPU 등 차세대 서버 CPU를 통해 X86 시장 점유율 확대를 목표합니다.
- Arm 기반 아키텍처가 하이퍼스케일러의 자체 개발 CPU로 급성장하고 있습니다.
- AMD는 Intel보다 Arm의 공격으로부터 더 큰 위협을 받고 있다는 분석도 제기됩니다.
COMPUTE
AMD가 돈을 벌기 위해 활용하는 랙 규모(Rackscale) AI 시스템 로드맵
데이터센터에는 지난 수십 년 동안 하나의 격언이 존재해 왔습니다. 특히 대기업과 이후 하이퍼스케일러 및 클라우드 빌더들에 의해 확고하게 자리 잡은 격언입니다: 고객들은 제품을 사는 것이 아니라, 로드맵을 산다. 여기서 '사다(buy)'는 문자 그대로의 제품 구매를 의미하기보다는 '믿는다'라는 의미로 해석되어야 합니다.
칩 제조사 AMD는 15년 전 데이터센터 시장에서 한발 물러났을 때 많은 신뢰도를 잃었습니다. 이는 Lisa Su가 회사 경영권을 잡고 AMD의 방향타를 완전히 돌려 거대한 데이터센터 지출 및 수익 파도 속으로 겨누기 이전이었습니다. 대불황(Great Recession)과 Opteron 서버 CPU의 버그는 Intel이 마침내 'Nehalem' Xeon을 통해 제자리를 찾으려던 시기와 맞물렸고, AMD는 PC 칩 사업 보호에 집중하기 위해 데이터센터에서 숨 고르기가 필요했습니다.
AMD가 신뢰도를 회복하는 데는 10년이라는 시간이 걸렸으며, 솔직히 말해 Intel이 어려움을 겪고 그 제품과 파운드리 기반 시설(foundry hulls)이 무너지는 것을 지켜본 AMD는 자체적으로도 매우 믿을 만한 로드맵을 가졌을 뿐만 아니라, 비교 대상으로서의 Intel보다 훨씬 나아 보입니다. AMD는 칩부터 랙 규모 시스템에 이르기까지 하드웨어 측면에서 AI 산업 거물 Nvidia와 의심할 여지 없이 경쟁하며, 소프트웨어 측면에서도 하이퍼스케일러 및 클라우드 빌더들의 도움을 받고 있습니다. 이들은 Big Green(Nvidia)에게 계속 압박을 가하고, 2020년대 중반의 상당한 공급망 위험을 완화하기 위해 Nvidia 스택에 대한 대안—혹은 자체 XPU와 CPU 칩셋까지 포함하면 두 가지 이상의 대안—을 간절히 원하고 있습니다.
따라서 이제 AMD 로드맵은 훨씬 더 흥미진진해졌으며, Su는 지난주 실리콘밸리에서 열린 Advancing AI 2026 행사에서 전 세계에 CPU 및 GPU 로드맵을 공개하며 그 여정을 분명히 보여주었습니다.
서버 CPU 로드맵부터 시작해 보겠습니다. 곧 출시될 “Venice” Zen 6 CPU에 대한 세부 사항을 깊이 있게 살펴보겠습니다.
Su는 AMD가 2015년 서버 CPU 시장 점유율이 약 0.0%였던 때, 다시 게임에 참여하겠다고 공언했고, 그로부터 2년 뒤 첫 번째 세대인 “Naples” Epyc CPU가 출시되었을 때를 상기시켰습니다. 그리고 지금, 2026년 초에 AMD는 X86 서버 시장에서 46%의 매출 점유율을 차지하고 있습니다. AMD가 경쟁사 Intel보다 더 많은 서버 CPU를 판매하는 날이 머지않았으며, Intel은 과거 2000년대 초 Opteron으로 몇 번의 공백기를 제외하면 X86 서버 CPU 프랜차이즈를 완전히 독점했었습니다.
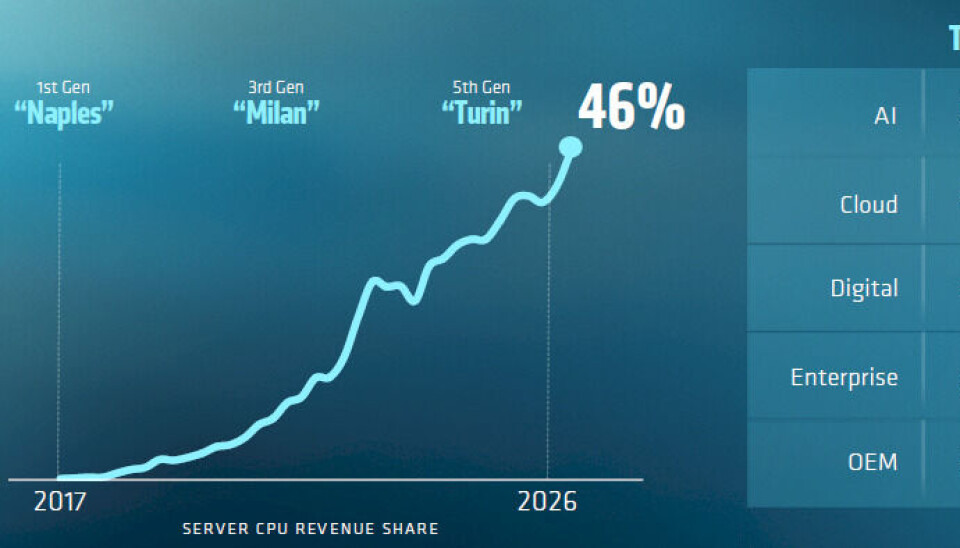
Su가 지적하지 않았지만 제가 지적할 부분은 Arm 기반 CPU입니다. 이들은 주로 하이퍼스케일러와 클라우드 빌더의 자체 개발 CPU에 의해 구동되고 있으며, Nvidia의 모든 랙 규모 시스템에 내장된 “Grace” CG100 CPU에도 힘입어 현재 서버 출하량과 서버 매출의 절반을 차지하고 있다는 점입니다. 저희는 이 모든 것을 아직 계산해 보지 않았지만, X86 파이 조각은 Arm 파이 조각만큼 빠르게 성장하고 있지 않으며, Arm의 공격을 가장 크게 받고 있는 것은 AMD가 아니라 Intel이라는 것입니다.
2024년 10월에 데뷔한 “Turin” Epyc 9005 칩은 Zen 5 변형에서 128개의 코어와 256개의 스레드를 가지고 있으며, L3 캐시를 절반으로 줄여 50% 더 많은 코어를 집적시킨 Zen 5c 변형에서는 192개의 코어와 384개의 스레드를 가집니다.
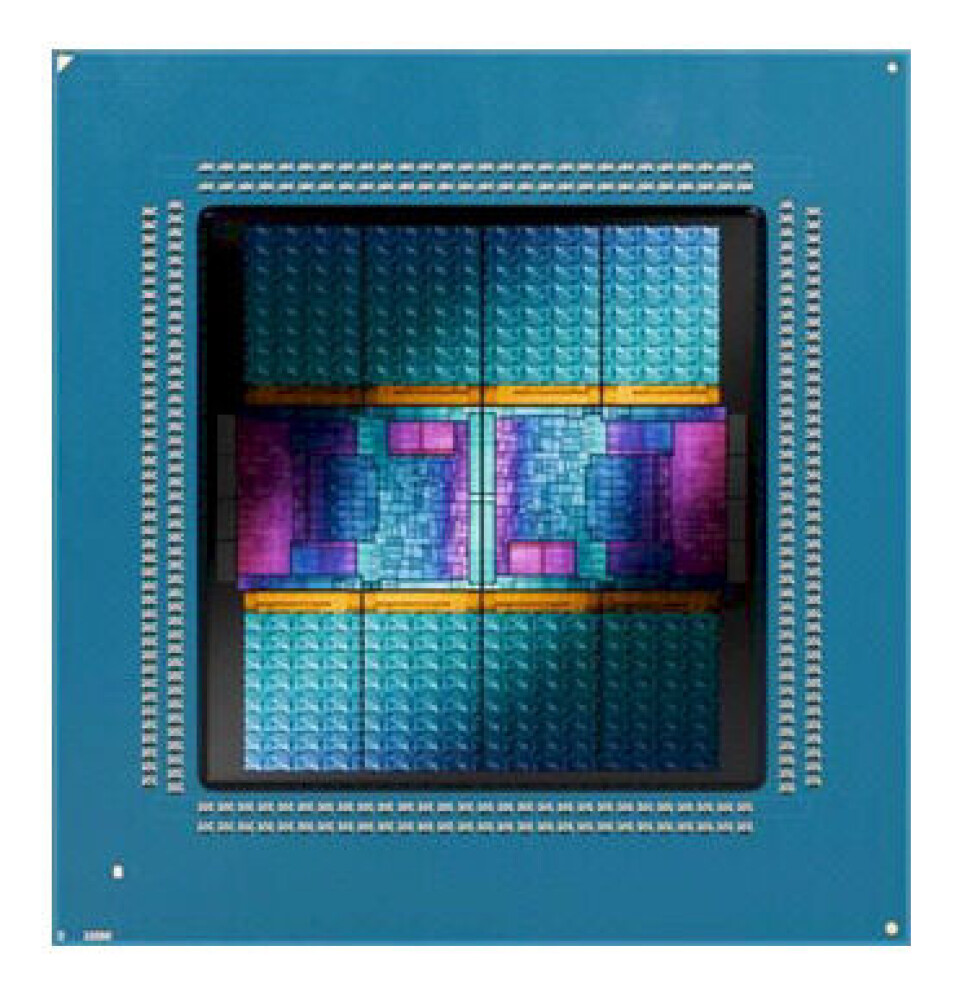
Su에 따르면, Zen 6 및 Zen 6c 코어 변형을 탑재한 후속 Venice Epyc 9006 라인업은 다양한 변종을 가질 예정입니다. Epyc 9006은 Taiwan Semiconductor Manufacturing Co의 2 나노미터 N2 공정을 사용하여 컴퓨트 코어를 식각하고, I/O 다이와 메모리 컨트롤러에는 6 나노미터 공정을 사용하며, 이들이 컴퓨트 다이에 연결됩니다. Venice 코어는 더 높은 주파수와 클럭 사이클당 처리되는 명령어(IPC)가 높아질 것이며, Venice 칩은 더 많은 코어를 갖게 되어 최고 사양 부품의 경우, 같은 사양을 비교할 때 Turin 대비 Venice에서 소켓당 성능이 1.8배 증가합니다. (이는 SPEC integer 2006 성능에 구체적으로 해당됩니다.)
참고로, Venice CPU는 PCI-Express 6.0 주변 장치 슬롯을 갖춘 최초의 서버 컴퓨트 엔진이 될 것입니다.
최고 사양의 Venice Zen 6c 버전은 256 코어와 512 스레드를 탑재하여 Turin Zen 5c 대비 33% 높은 성능을 보여줍니다. 이 Venice 6c 소켓에는 각각 32개의 코어를 가진 8개의 컴퓨트 복합 다이(compute complex dies)가 있습니다. 또한 이 칩은 SP7 소켓의 DDR5 DIMM에서 1.6 TB/sec의 총 메모리 대역폭을 갖추며, 이 소켓은 12.8 GHz MRDIMMs 또는 8 GHz RDIMMs를 지원하는 16개의 메모리 컨트롤러를 가지고 있습니다. AMD는 초기에는 수율이 낮고 비용이 높은 새로운 DDR6 메모리보다는 더 빠른 메모리에 초점을 맞추고 있습니다. Su에 따르면, 목표는 '단연코' 최고 성능의 전력 대비 및 랙당/달러당 에이전트 AI 샌드박스(agentic AI sandboxes)를 제공하는 것입니다.
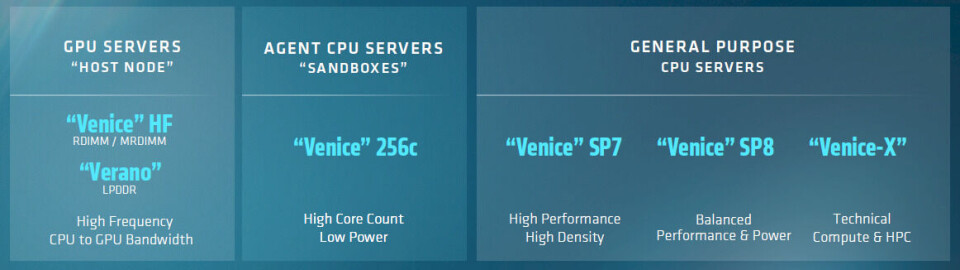
최고 사양의 Venice Zen 6 파트는 128개의 코어를 탑재하여 Zen 6c 파트의 절반 수준이며, 엔터프라이즈 백 오피스(back office), 분석(analytics), 웹 인프라 워크로드에 최적화되어 있습니다. 우리는 이 파트가 SP7 소켓에서 지원하는 16개 대신 8개의 메모리 채널을 갖는 더 작은 SP8 소켓에 장착될 것이라고 강력히 추정합니다.
Venice HF라는 또 다른 Epyc 9006 칩이 있는데, 이 칩은 소켓에 8개의 칩렛을 가지고 있지만 각 칩렛에는 Zen 6 코어가 겨우 12개만 있어 클럭 속도를 5 GHz까지 끌어올려 코어에서 극도로 높은 싱글 스레드 성능을 구현할 수 있습니다. 바라건대 이것이 빠른 코어들을 충분히 구동시킬 수 있는 전체 메모리 용량과 대역폭을 갖춘 SP7 소켓에 장착되기를 바랍니다. . . . 저희는 이 칩이 또한 완전한 512비트 벡터 지원만 제공된다면 HPC(고성능 컴퓨팅) 환경의 업체들에게도 인기가 있을 것이라고 생각합니다. (물론 그럴 것입니다.)
캐시에 민감한 HPC 및 AI 워크로드를 위해 3D 수직 캐시 확장이 적용된 Venice-X 버전이 나올 예정입니다. 그리고 Nvidia의 Grace CPU나 향후 'Vera' CV100 서버 CPU가 하듯이, 일반 DDR5 DIMM 대신 LPDDR5 메모리를 사용할 Verano라는 이름의 변종이 2027년에 출시될 것입니다. Verano 칩은 거대한 프로세서 및 메모리 복합체가 필요하지 않은 AI 호스트 노드를 목표로 합니다. 그와 같은 대규모 시스템을 갖춘 경우에는 이중 소켓 Venice 5 파트의 변종을 사용할 것입니다.
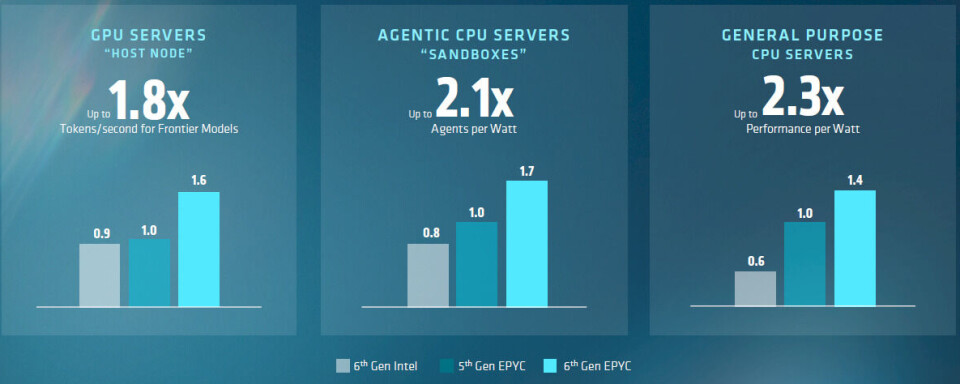
Su가 세 가지 핵심 워크로드(AI 호스트 서버, 에이전틱 AI 샌드박스, 일반 목적 데이터센터 애플리케이션)에 대해 Intel의 다양한 Xeon 6 칩과 자체 Turin Epyc 9005를 기준으로 Venice 칩들을 어떻게 배치했는지 살펴보겠습니다:
앞서 지적했듯이, 현재 부족한 시장 상황에서는 CPU만 만들면 팔 수 있습니다. 그리고 이것은 Intel에게 매우 편리한 점인데, Intel은 가까운 미래 동안 성능과 와트당 성능 면에서 AMD에 뒤처질 것이기 때문입니다. (제가 궁금한 것은 AMD가 더 많은 CPU를 만든다고 해서 판매량이 늘어날까요? 아마도 그럴 수도 있지만, 기업들이 서버를 구매하고 자체적인 CPU 편견과 선호도를 가지고 있는 방식을 고려하면 아닐 수도 있습니다.)
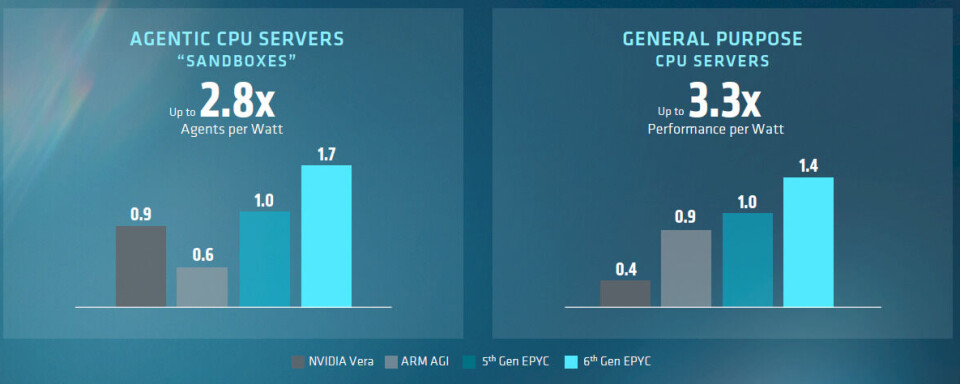
여기서는 Su가 Venice와 Turin을 Nvidia의 곧 출시될 Vera 서버 CPU 및 Arm의 이름 제한적이고 또한 곧 나올 AGI CPU와 비교하여 어떻게 배치했는지 보여줍니다:
성능의 이러한 큰 격차는 AMD가 자체 개발한 Venice CPU에 프리미엄을 붙여 판매할 수 있는 여지가 얼마나 많은지를 보여줍니다. 만약 AMD가 평균적인 격차의 절반만 가격을 책정하더라도, 여전히 가격 대비 성능 분석(price/performance analysis)에서 압도적으로 승리할 것입니다. 이 Venice는 아마 올해 가을에 출시될 것으로 예상됩니다.
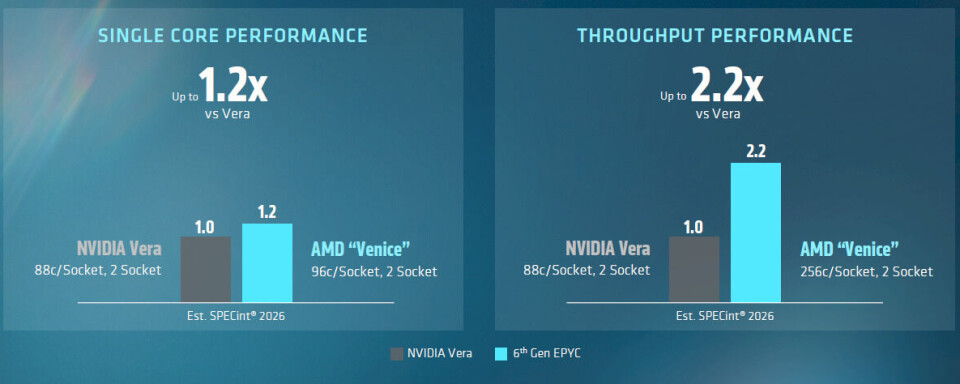
여기서 Su는 특히 사촌인 Jensen Huang의 Vera 프로세서를 SPEC integer 2006 벤치마크로 비교하며, 96코어의 Venice HF Zen 6과 256코어의 Venice 256c Zen 6c 부품을 88코어의 Vera CPU와 대조합니다:
보시다시피, Venice HF 부품은 순수 정수 성능(raw integer performance)에서 20% 앞서며, Venice 256 부품은 클럭 속도가 더 낮고 코어당 L3 캐시가 절반임에도 불구하고 2.2배의 성능 우위를 보입니다. 3.4GHz로 2.67배 많은 코어를 갖는 것이 위 차트에 표시된 Vera 칩 대비 2.2배의 성능 향상을 가져올 것입니다.
하지만 이 시점에서 기업들은 에이전트형 샌드박스(agentic sandboxes)를 위해 CPU 서버 랙에 얼마나 많은 코어를 배치할 수 있는지를 기준으로 생각하고 있습니다. 다양한 Venice 256c 서버 설계는 다른 결과를 도출합니다:
Nvidia 부품으로 Vera MGX 랙을 구성하는 방법은 오직 랙당 22,528개의 코어를 사용하는 것입니다.
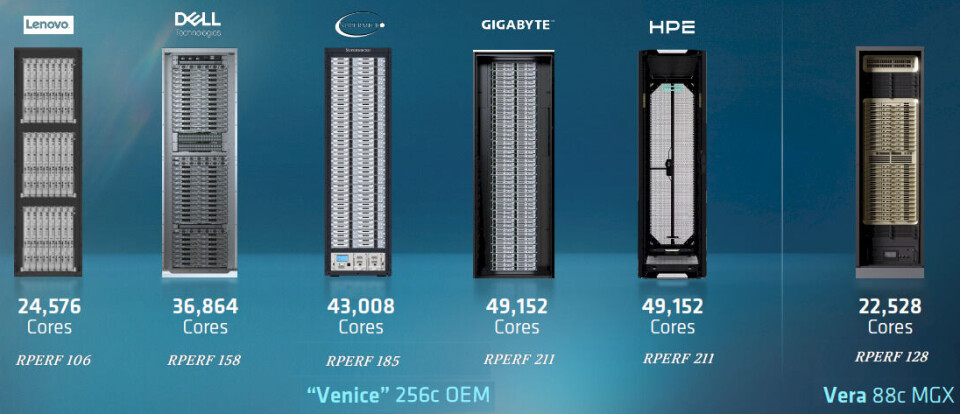
이 차트는 랙당 상대적 성능(relative performance per rack)을 보여주지는 않으므로, 이 기사 상단에 제시된 SPEC integer 2006 벤치마크 결과를 사용하여 각 Venice 랙의 성능을 Vera MGX 랙과 비교한 추정치를 포함했습니다. 제가 만든 RPERF 상대 성능 수치는 두 소켓(two-socket) Vera-Vera 서버의 성능을 기준으로 산출되었습니다.
이것이 Venice에 대한 새로운 내용 전부이니, 이제 Epyc 로드맵을 살펴보기 위해 계속 진행하겠습니다:
Epyc CPU 로드맵은 2년 주기를 유지할 예정이며, 솔직히 말해 서버 산업이 감당할 수 있는 모든 것이 이 정도 수준입니다. AMD가 TSMC의 1.4 나노미터 A14 공정 노드는 물론, 경쟁사인 인텔의 14A 노드와도 교차시키려고 노력할 것으로 예상하는 것이 합리적입니다. 그래야 정치적, 기술적, 경제적 위험을 완화하기 위해 두 개의 파운드리(foundry)를 활용할 수 있기 때문입니다. (중국은 언제든지 마음만 먹으면 대만을 침공할 수 있습니다... 그리고 TSMC와 인텔 모두 미국에 첨단 파운드리 역량을 보유하고 있으므로, 실제로 그렇게 될 가능성이 더 높습니다.) 우리는 Zen 7과 Zen 7c 코어 변형이 확실히 존재할 것이며, 이 Florence 컴퓨팅 엔진들이 DDR6 메인 메모리로 전환되고 PCI-Express 6.0 주변 장치를 유지할 것이라고 가정하는 것이 합리적입니다. 또한 일부 첨단 패키징(advanced packaging)도 기대하지만, 무엇이 나올지는 추측하기 어렵습니다.
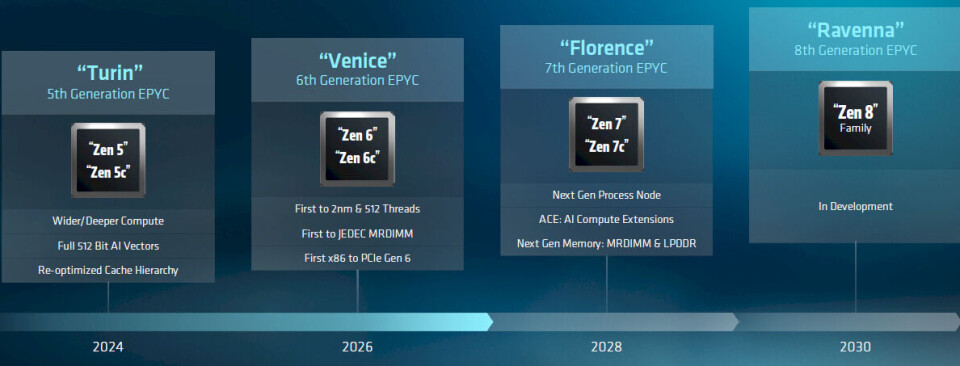
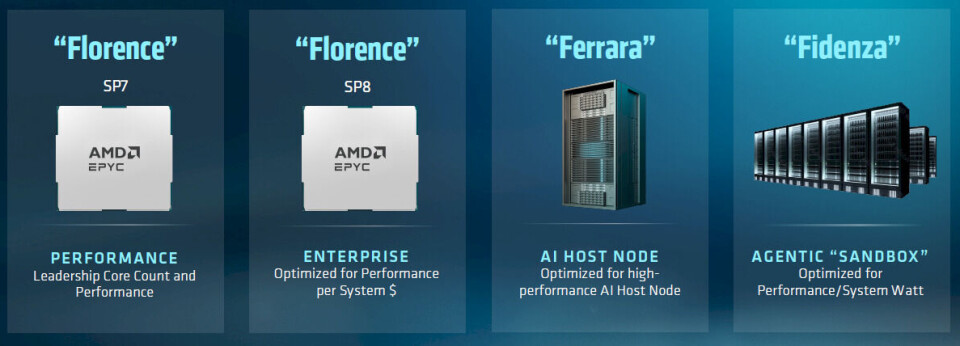
우리는 세 가지 다른 워크로드에 맞춰진 여러 Florence 변형이 있을 것이라는 것은 알고 있습니다:
AMD는 agentic AI 샌드박스(sandbox) 변형과 AI 호스트 노드에도 별도의 코드명을 부여하고 있습니다. Florence 칩들은 적절한 경우 동일한 SP7 및 SP8 소켓에 장착되며, AI 호스트 머신용 Verano 변형의 Venice와 같은 카드에 마운트될 것입니다. 우리는 “Fidenza”가 무엇일지, 그리고 Epyc 라인업에서 대체할 Venice HF 부분과 접근 방식이 어떻게 다를지 궁금합니다. Zen 및 Zen c 코어 간의 분기(fork)를 제외하고는 어느 Venice 또는 Florence 변형도 고유한 코드명을 가질 만한지에 대해서는 논쟁의 여지가 있습니다. Windows Server나 Linux 머신에서 실행되는 소프트웨어는 실제로 그러한 구분을 신경 쓰지 않습니다. 코어들은 단지 다른 성능 프로필을 가질 뿐, 소프트웨어에 대한 추상화 수준이 다르지는 않습니다.
Instinct GPU 컴퓨팅 엔진 및 Helios 랙 규모 시스템
그것이 Epyc CPU에 대한 업데이트입니다. 자, 그럼 Su가 제공한 Instinct MI400 시리즈 업데이트를 살펴보겠습니다. 먼저 MI400 시리즈부터 시작하여, 이후의 MI500 및 MI600 GPU 로드맵과 이와 관련된 “Helios” 랙 규모 시스템 구현을 살펴볼 것입니다.
현재 AMD는 두 가지 MI400 시리즈 GPU에 대해 이야기하고 있습니다: AI 워크로드를 겨냥한 MI455X, 그리고 전통적인 HPC ModSim 워크로드를 겨냥한 MI430입니다.
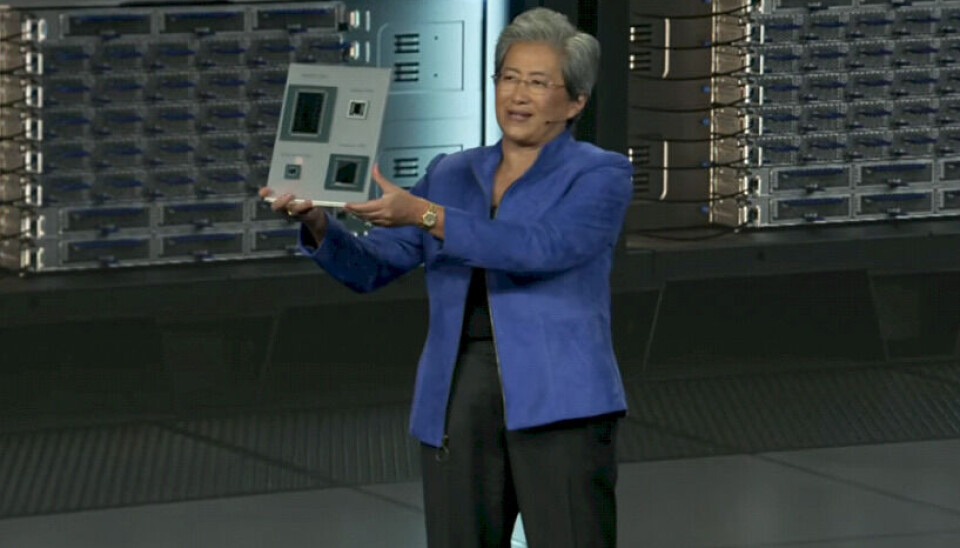
MI455는 12개의 컴퓨팅 및 I/O 치프렛으로 구성되어 있으며, TSMC의 N2와 N3 공정을 혼합하여 구현되었습니다. (컴퓨팅 타일은 항상 더 작은 공정에 배치되는 경향이 있습니다. 왜냐하면 컴퓨팅은 I/O 및 메모리 컨트롤러보다 프로세스 축소에 훨씬 더 잘 대응하기 때문입니다. SerDes(SerDeses?)는 코어보다 다루기 까다롭습니다.)
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기