
AI 역할극의 '기억 상실'과 '설정 붕괴'를 해결! Cloudflare(DO + Vectorize)와 툴 호출로 ADV 스타일 게임을 만든
요약
AI 역할극(TRPG)에서 발생하는 '기억 상실'과 '설정 붕괴' 문제를 아키텍처적으로 해결한 개인 개발 사례를 소개합니다. Cloudflare Workers와 Durable Objects, Vectorize 등을 활용하여 LLM의 기억을 외부 디스크에 영구 저장하고 검색 가능하게 만듭니다.
핵심 포인트
- LLM의 기억은 컨텍스트 윈도우가 아닌 외부 DB(디스크)에 보관해야 합니다.
- GM에게 '기억할 책임'을 파일 시스템으로 옮기는 아키텍처를 구축했습니다.
- Cloudflare Workers/DO와 Vectorize를 활용하여 장기 기억과 설정 일관성을 확보합니다.
- ADV 스타일의 이미지 생성 노벨게임 형태로 구현되어 몰입도를 높였습니다.
AI와의 역할극은 재미있지만, 오래 플레이하다 보면 반드시 이 두 가지 문제에 부딪히지 않나요?
- 기억이 흐릿하게 사라진다. 20턴 전에 주웠던 열쇠, 이름을 붙여준 동료, NPC와 나눈 약속. 대화가 길어질수록 언제 그랬는지 모르게 사라져 버립니다.
- 설정이 무너진다. '제1차 세계대전에서 분기된 패러렐 월드의 로봇 전기'처럼 세밀한 설정으로 시작해도, 어느새 스마트폰이나 현대의 군제가 슬쩍 섞여 들어옵니다.
원인은 간단합니다. LLM에게 있어 '기억'이 컨텍스트 윈도우(context window)밖에 없기 때문입니다. 창문 밖으로 밀려난 것은 사라지고, 세계관의 텍스트도 희미해지면서 모델의 사전 지식(즉, 현대 상식)이 우세해집니다.
저는 이 문제를 '프롬프트를 열심히 짜는 것'이 아니라 아키텍처로 해결하는 것을 목표로 개인 개발을 통해 AI 게임 마스터(GM) 하네스(harness)를 만들었습니다. 이름은 Aisling입니다. 또 하나의 특징으로는, 단순한 채팅 화면이 아니라 이미지 생성을 활용한 노벨게임(ADV) 스타일의 화면에서 플레이할 수 있도록 했습니다.
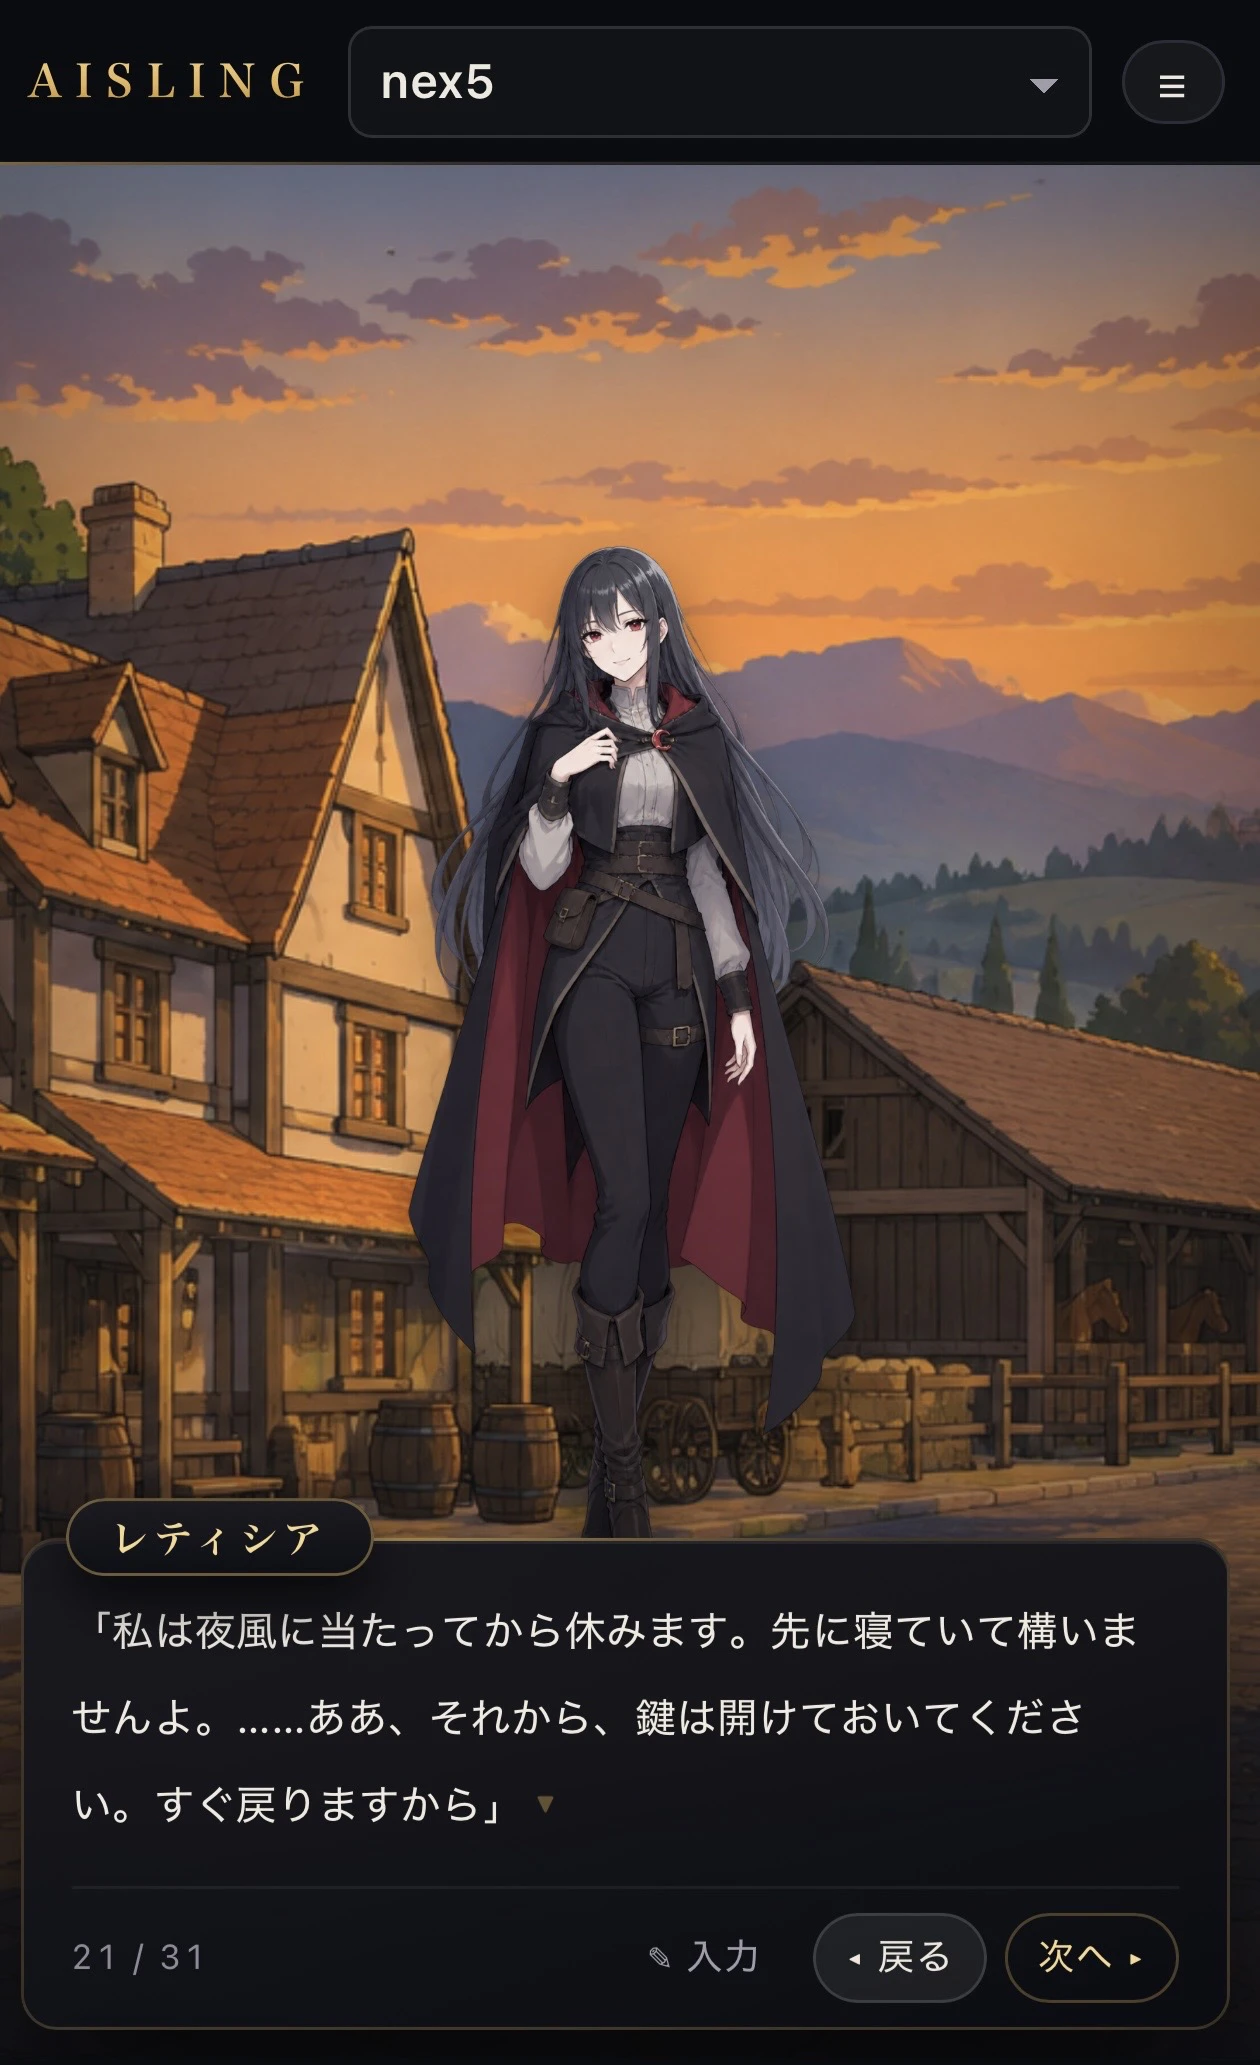
하루에 50턴까지 무료로 플레이할 수 있습니다.
(모델 고정, 수동 이미지 생성 없음. ADV 생성은 평소대로 진행됩니다)
이 글에서는 인프라를 Cloudflare로 통일한 구성과 '장기 기억', '설정의 일관성'을 어떻게 구현했는지 개념도와 처리 흐름 중심으로 소개합니다. 소스 코드 자체보다는 사고방식에 대한 설명이 주 내용입니다.
가장 먼저 정한 원칙은 이것입니다.
대화 기록은 캐시일 뿐이다. 진실(정확한 정보)은 디스크(영구 저장된 기록)에 있다.
GM 역할을 하는 LLM에게는 '중요한 것은 모두 툴로 기록하라. 기록하지 않은 것은 다음 턴에는 일어나지 않은 것으로 간주하라'라는 규칙으로 작동하도록 했습니다. 마치 인간 TRPG의 게임 마스터가 캠페인 노트를 작성하는 것과 같아서, 기억할 책임 자체를 LLM의 머리에서 파일로 옮기는 것입니다.
기록되는 종류는 역할별로 나누었습니다.
| 기록 | 내용 | 성질 |
|---|---|---|
| state | 현재 위치, 게임 내 시간, HP, 소지품, 플래그 | 구조화 데이터 (JSON Merge Patch로 업데이트) |
| ... |
핵심은 이 모든 것이 검색 대상이 된다는 것입니다. GM이 '어라, 북문 경비병 이름이 뭐였더라'라고 생각하면, 추측으로 채우는 것이 아니라 검색해서 읽어옵니다 (후술).

언어는 TypeScript로, 인프라는 Cloudflare로 통일했습니다.
각 역할은 다음과 같습니다.
- Workers (진입점): 로그인(Google 로그인), 화면 배포, API 라우팅. 세션 목록이나 세계관 프리셋 공유 등 '세션을 넘나드는 데이터'는 D1에 배치합니다.
- Durable Objects (DO): 1 세션 = 1 오브젝트. 해당 세션의 기록은 모두 DO 내장 SQLite에 저장됩니다.
- Workers AI + Vectorize: 기록의 임베딩 및 의미 검색.
- AI Gateway: LLM 호출을 통합하여, 제공업체별 사용량을 한 곳에서 볼 수 있도록 합니다. 요청 본문은 로그에 남기지 않고, 어느 세션의 호출인지만 메타데이터로 첨부합니다.
- Workflows + R2: 이미지 생성을 비동기 작업으로 처리하고, 결과를 R2에 저장합니다.
- Cron: 매일 밤, 플레이된 세션 전체를 백업용 버킷으로 내보냅니다.
AI 역할극의 세션은 '한 방에 한 명(또는 소수)이 들어가 순서대로 턴을 진행하는' 매우 상태적이고 직렬적인 특성을 가지고 있습니다. 이는 DO 모델과 궁합이 아주 좋았습니다.
- 방마다 상태가 독립적이다. 다른 세션의 기록이 섞일 여지가 없고, 세션을 삭제하면 그 오브젝트 내부를 통째로 지울 수 있습니다.
- 직렬화가 공짜로 얻어진다. 같은 방으로의 요청은 하나의 오브젝트가 순차적으로 처리하므로, '턴 도중에 다시 전송되었다'는 것을 앱 측에서 애쓰지 않아도 됩니다.
- SQLite를 동기 API로 사용할 수 있다. 전체 텍스트 검색(FTS5) 인덱스도, 대화 기록도 같은 데이터베이스에 둘 수 있습니다.
또 다른 중요한 부분은 **알람(Alarm)**이었습니다. LLM의 1턴은 도구 호출을 여러 번 왕복하기 때문에 몇 분이 걸리기도 합니다. 이 시간을 HTTP 요청 내에서 기다리는 대신,
- 요청은 '턴을 수신했다'는 것을 SQLite에 기록하고 즉시 알람을 울린 후 202를 반환합니다.
- 실제 턴 처리는 알람 내부에서 진행됩니다 (연결과 무관하게 작동 가능) - 화면은 SSE(Server-Sent Events)로 진행 상황을 받습니다.
이러한 방식으로 구현했습니다. 도중에 배포가 실행되어 DO가 재시작하더라도, '시작됨' 표시가 남아있기 때문에 다음에 열었을 때 '중단됨'으로 처리할 수 있고, 재실행된 알람이 같은 턴을 LLM에 다시 보내지 않습니다 (같은 턴을 중복 처리하지 않음).
여기부터가 핵심 내용입니다. 구조는 세 가지 기둥으로 이루어져 있습니다.
도구 호출(Agent적 루프)로 기록 읽기/쓰기
하이브리드 검색(FTS5 + Vectorize)으로 필요한 기억만 가져오기
체크포인트로 대화 기록을 '요약 + 기록'으로 대체하기
GM에게는 기록을 다루기 위한 일련의 도구 세트가 제공됩니다.
| 도구 | 역할 |
|---|---|
| recall | 전체 기록 교차 검색 (키워드 + 의미) |
| ... |
1턴의 흐름은 다음과 같습니다.
중요한 점은 LLM이 '스스로 검색 쿼리를 작성하여' 기록을 가져오는 부분입니다. 프롬프트에 세계관 설정을 모두 흘려보내는 것이 아니라, 자료는 목차만 상시 제공하고 필요한 절만 읽어오게 하는 이층 구조를 채택했습니다. 설정이 수만 자가 되어도 컨텍스트가 늘어나지 않으며, '설정 희석' 현상도 발생하기 어렵습니다.
또 하나, **턴 중의 모든 쓰기는 스테이징(Staging)**됩니다. state, journal, memory, 이야기 DB, 이미지 주문, ADV 연출 등은 해당 턴의 대화 기록을 저장할 때 하나의 트랜잭션으로 함께 확정됩니다. API 오류 등으로 턴이 실패하면 전부 롤백되므로, 다시 보내도 중복 기록되지 않습니다. 이미지 생성 역시 턴이 확정된 후에 시작됩니다 (실패한 턴 분량은 생성되지 않음).
recall
의 내용은 두 가지 검색을 합성한 것입니다.
- 키워드 측: DO의 SQLite에 FTS5의 trigram 인덱스를 가지고 있습니다. trigram이기 때문에 일본어(한국어)도 형태소 분석 없이 부분 일치가 가능합니다. 고유명사('브람', '북문')에 강합니다.
- 의미 측: Workers AI의
bge-m3(1024 차원)로 임베딩하여 Vectorize에 넣습니다. 인덱스는 하나이며, 네임스페이스를 세션별로 분리했습니다. '그때 경비병이 말했던 소문'과 같은 표현 방식의 차이에 강합니다. - 통합: Reciprocal Rank Fusion (RRF)으로 두 개의 랭킹을 혼합합니다. 의미 검색 측은 유사도 임계값과 '최상위와의 차이'로 걸러내어, 무관한 질문에 적절한 히트가 반환되는 것을 방지합니다.
- 반환하는 것은 절: 파일 전체가 아니라, 제목 단위의 청크를 반환합니다. 자료 측은 제목으로 분할하여 인덱싱했기 때문에 '지리 › 북부 › 북문'과 같은 경로별로 반환할 수 있습니다.
Vectorize를 사용하면서 가장 어려웠던 점은 쓰기 반영이 비동기로 이루어지고 몇 분 지연될 수 있다는 것이었습니다.
- 아직 기록하지 않은 사실을 툴로 저장하기 (현재 위치, 시간, 상태 변화, 등장한 NPC, 복선, 플레이어와의 약속 등) 리셋된 자신에게 전달할 요약본 작성하기
요약본에는 고정된 제목(현재 장면, PC와 동행자, 진행 중인 퀘스트와 복선, 주요 NPC, 플레이어의 취향 등)을 사용하도록 하고, '확인된 사건/소문/추측/미실행 예정 사항을 구분하기', '모순은 그대로 작성하고 개연성을 맞추는 정보는 만들지 않기'와 같은 규약을 두고 있습니다.
그리고 대화 기록을 비우고, 다음 발언의 시작 부분에 **요약본 + 자료 목차 + state + 직전 일지(journal)**를 첨부합니다. 즉 LLM 입장에서 보면,
'요약본 읽기 → 부족한 세부 정보는 recall / read_document로 기록에서 가져오기 → 이야기 이어가기'
라는 방식으로 재개할 수 있습니다. 컨텍스트 길이에 구애받지 않고, 수십 세션 동안 같은 캠페인을 계속할 수 있는 구조입니다.
기억 상실은 위의 3가지 기둥으로 상당히 제어되었지만, '현대적 요소가 혼합되는' 유형의 붕괴에는 추가로 2가지 장치를 넣었습니다.
스토리 DB (GM 전용 비공개 기록): 메인 스토리의 골격, 확정된 진실(추가만 가능, 덮어쓰기 불가), 퀘스트, 단서를 전용 툴로 저장하게 합니다. 퀘스트 결말마다 '결과와 다음 계획'을 같은 트랜잭션으로 저장하기 때문에, GM 측에서 '저 복선이 뭐였지?' 하는 상황이 발생하지 않습니다. 진실이나 스포일러는 요약본에도 이미지 프롬프트에도 전사(轉寫)하지 않는 규약입니다. -
세계관 프리셋: 전제/세계 설정/PC・NPC(외형 포함)・GM의 행동 방식・GM만이 아는 비밀을 1세트로 만든 것입니다. 이것이 자료로 인덱싱되므로, GM은 이야기하기 전에 recall
으로 '이 세계에 전화가 있는가'를 확인할 수 있습니다.
솔직히 말하자면, LLM 자체가 진실을 알고 이야기하는 이상, 유출을 기계적으로 100% 막는 것은 아닙니다. 다만 '추측으로 채우기'가 아니라 '기록을 찾아가는' 경로를 반드시 마련하고, 기록을 정(正)으로 삼음으로써, 붕괴 양상이 상당히 온화해졌습니다.
애써 기억이 유지되게 되었으니, 외형에도 공들였습니다.
배경과 캐릭터 이미지: GM이 set_scene
으로 장면을 등록하면 배경이, register_npc
으로 인물을 등록하면 전신 투명 캐릭터 이미지가 각각 비동기적으로 생성됩니다. 생성은 Workflows의 작업(1 작업 = 1 인스턴스)으로, 턴이 확정된 후에 시작하며, 결과는 R2에 저장됩니다. DO가 일시 중지/재시작해도 작업은 멈추지 않습니다. -
연출: GM은 adv_stage
으로 '이 단락 전에 A가 왼쪽에서 입장', '이 대사로 B를 퇴장'과 같은 큐(cue)를 지정합니다. 연출은 답변 완료 후에 재생되며, 실패한 턴의 연출은 반영되지 않습니다. -
화자 태그: 본문의 대사에는 화자 태그가 붙기 때문에, 화면 측에서는 캐릭터 이미지를 최대 3명(왼쪽・중앙・오른쪽) 나란히 배치하고, 발언자만 밝게, 나머지는 회색으로 표시할 수 있습니다. -
백로그: '이력'에서 과거 대화를 거슬러 올라가고, 그때의 배경과 캐릭터 이미지도 함께 재현합니다.

이미지가 준비되지 않는 동안은 그리드 형태의 가상 공간이나 실루엣을 보여주며, 가능하다면 자동으로 교체됩니다.
현재 공식 세계관으로 2가지를 준비하고 있습니다.
검과 마법 판타지 제1차 세계대전에서 분기된 패러렐 월드의 로봇 전쟁기
후자가 방금 앞에서 언급한 '설정 붕괴가 쉬운' 소재입니다. 시대 고증과 가상의 기술이 혼합되는 세계에서, 어디까지 일관성을 유지할 수 있을지 실험하는 장소이기도 합니다.
더불어, 자신만의 오리지널 세계관을 만들고 공유하는 기능이 있습니다. 전제/세계 설정/PC・NPC・GM의 행동 방식・GM만의 비밀을 작성하여 프리셋으로 만들고, 비공개 / 한정 공개(링크를 아는 사람만) / 공개 중 선택할 수 있습니다. 다른 사람의 세계관에서 플레이할 때, 그 사람이 작성한 자료 본문은 GM만이 읽을 수 있고, 플레이어에게는 이름만 보입니다(스포일러 방지). 공개된 것은 신규/인기/즐겨찾기에 배열됩니다.
일본어와 영어 양쪽에 대응하며, 하나의 세션 안에서 여러 LLM 프로바이더(Anthropic / OpenAI / Google)의 모델을 전환할 수도 있습니다. 다른 회사의 모델로 옮길 때는 현재 모델이 한 번 요약본을 작성한 후 인계하기 때문에, 여기에서도 체크포인트 메커니즘이 작동합니다.

회원가입 없이 (Google 로그인만으로) 매일 50턴 플레이할 수 있도록 했습니다. (모델 고정, 수동 이미지 생성은 사용할 수 없습니다.)
'정말로 설정이나 기억이 휘발되지 않는지?'는 만드는 제가 가장 알고 싶어 하는 부분입니다.
- 30턴 전에 주웠던 소품의 이름을 갑자기 물어보기
- 로봇 전쟁기 세계관에서 일부러 현대적인 것을 가져와 보기
- 자신만의, 지나치게 세밀한 설정의 세계를 만들어서 놀아보기
부디 무리한 질문(도전)으로 와서 망가뜨려 주세요. 만약 고장 난 부분이 있다면 알려주시면 다음 개선에 도움이 됩니다(。•ᴗ•。)
AI 자동 생성 콘텐츠
본 콘텐츠는 Qiita AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기