
AI 에이전트를 위한 컨텍스트 엔지니어링 (Agent Memory), 검색(Retrieval)부터 시작합니다.
요약
에이전트는 제한된 컨텍스트 창으로 인해 정보 검색 과정에서 비효율성, 과도한 데이터 로딩 등의 문제에 직면합니다. 본문은 이러한 문제를 해결하기 위해 '검색(retrieve), 오프로드(offload), 위임(delegate)' 방식을 제안합니다. 이를 통해 에이전트 하네스는 작업에 필요한 정확하고 적절한 시점의 컨텍스트만을 선별적으로 제공하는 것이 핵심입니다.
핵심 포인트
- 에이전트는 제한된 컨텍스트 창으로 작동하며, 정보 검색 과정에서 여러 실패 유형을 겪습니다.
- '검색-오프로드-위임' 방식을 사용하여 결과를 파일에 저장하고 경로만 반환해야 합니다.
- 대용량 결과는 오프로드(offload)하여 에이전트가 전체 데이터 대신 경로와 미리보기만 받도록 해야 합니다.
핵심 요약 사항
- 에이전트는 제한된 컨텍스트 창(context window)으로 작동하며, 정보 검색은 세 가지 방식으로 실패합니다: 비효율적인 검색, 한 번에 너무 많은 컨텍스트, 그리고 관련성이 없거나 오래된 컨텍스트입니다.
- Deep Agents harness는 검색을 처음부터 작게 유지합니다. 내장된 파일 시스템 도구들은 읽기 전에 검색합니다: glob은 파일 이름을 일치시키고, grep은 일치하는 줄을 찾으며, read_file은 한 페이지씩 읽습니다. 크기가 큰 도구 결과는 오프로드(offload)됩니다: 전체 결과는 파일에 저장되지만, 에이전트는 경로와 미리보기만 받습니다.
- 사용자 지정 검색 도구(예: RAG)의 경우, "검색(retrieve), 오프로드(offload), 위임(delegate)" 방식을 사용하세요: 결과를 파일에 저장하고 경로를 반환하며, 서브 에이전트가 이를 읽도록 합니다. 메인 에이전트는 관련성 있는 정보만 볼 수 있습니다.
마치 오픈북 시험을 치르는 상황을 상상해 보세요. 기술적으로는 모든 정답을 가지고 있지만, 왠지 모르게 그중 올바른 답을 찾는 것이 더 어려워집니다.
- 어디서부터 검색을 시작해야 할까요?
- 출처가 정확하다는 것을 언제 알 수 있을까요?
- 중복 검색에 에너지를 낭비하지 않도록 시간을 어떻게 최적화할 수 있을까요?
올바른 정보를 효율적으로 찾는 것은 그렇게 간단하지 않습니다.
에이전트에게 질문을 던지면, 이 역시 비슷한 곤경에 처합니다: 제한된 컨텍스트 창을 가지고 있기 때문에, 우리 인간처럼 특정 작업을 완료하기 위해 정보를 **검색(retrieve)**해야 합니다 (모든 것을 암기하는 대신). 검색할 때, 에이전트는 다음과 같은 문제에 직면합니다:
비효율적인 검색: 모든 검색은 토큰과 시간을 소모합니다. 내용 확인을 위해 모든 파일을 열거나 동일한 쿼리를 계속 재작성하는 등 서투르게 검색하는 에이전트는 유용한 정보를 찾기 전에 컨텍스트를 검색 결과로 가득 채울 수 있습니다.한 번에 너무 많은 컨텍스트: 전체 데이터 내보내기(data export)나 수십 개의 문서를 덤프하는 단 한 번의 검색만으로도 컨텍스트 창(context window)을 가득 채워, 실제 작업할 공간이 남지 않게 만듭니다.관련 없거나 오래된 컨텍스트: 구식이거나 주제에서 벗어난 정보도 모델에게 정답만큼 설득력 있게 보일 수 있습니다. 일단 컨텍스트 창에 들어가면, 에이전트는 이를 기반으로 작업을 진행할 수 있으며 (그리고 그 실수는 이후 모든 단계로 이어집니다).
다행히도, 에이전트가 정확한 정보를 검색할 수 있도록 하는 여러 가지 기술들이 있습니다. 에이전트 하네스(agent harness)의 역할은 이러한 기술들을 전략적으로 적용하여 주어진 작업에 대해 모델에게 적절한 시점에 올바른 컨텍스트를 제공하는 것입니다.
이 블로그는 에이전트 검색(agent retrieval)의 어려움(현재 작업에 필요한 정보만 찾고 끌어오는 것), 이를 극복하기 위한 우리가 사용할 수 있는 기술들, 그리고 에이전트 하네스를 설계할 때 이러한 점들을 어떻게 고려해야 하는지(LangChain의 Deep Agents harness를 예시로 사용)를 다룹니다.
컨텍스트가 컨텍스트 창에 들어온 후 이를 어떻게 관리하는지에 대한 더 많은 정보는 'Context Engineering' 블로그를 확인해 보세요.
우리의 예시: 경쟁사 분석 에이전트 (a competitive analysis agent)
실제 사용 사례인 경쟁사 분석 에이전트(a competitive analysis agent)에 이것을 어떻게 적용할 수 있는지 살펴보겠습니다. 매주 월요일마다, 이 에이전트는 수백 개의 경쟁사를 조사하고 팀의 템플릿으로 보고서를 작성합니다. 이 에이전트는 다음 작업을 수행해야 합니다:
- 회사 A에 대한 지난주 메모 찾기
- 방대한 시장 데이터 내보내기(market data export)에서 특정 매출액 숫자 조회하기
- 새로운 내용이 있는지 뉴스 아카이브 검색하기
이 각각은 다른 종류의 검색(retrieval)이며 따라서 각기 다른 문제를 안고 있습니다. 저희는 Deep Agents harness를 사용하여 에이전트를 구축했기 때문에, 이러한 문제들을 최소화하기 위해 즉시 적용할 수 있는 몇 가지 기술들이 있습니다.
1. 비효율적인 검색
우리 에이전트는 각 경쟁사에 대해 세 가지 정보를 찾아야 합니다. 만약 이 과정 중 하나가 수십 번의 시도(내용을 확인하기 위해 파일을 열거나, 출처가 다른 단어를 사용해서 검색어 재작성)를 필요로 한다면, 보고서의 한 단어도 작성하기 전에 컨텍스트 윈도우(context window)가 실패한 검색으로 가득 차게 됩니다.
따라서 가장 좋은 검색은 에이전트가 반복할 필요가 없는 검색이며, 이는 각 작업에 맞는 적절한 도구를 사용하는 것을 의미합니다.
내장 파일 시스템 도구부터 시작하기
에이전트가 정보를 검색하는 가장 일반적인 방법 중 하나는 파일 시스템(filesystem)을 이용하는 것입니다. 하지만 우리 에이전트가 내용을 확인하기 위해 모든 파일을 열어본다면, 이는 매우 비효율적으로 검색하는 것입니다. 읽은 각 파일은 컨텍스트 윈도우에 저장되므로, 단순히 보는 것만으로도 가득 찰 수 있습니다.
더 나은 접근 방식은 **이름(names)**과 **키워드(keywords)**를 먼저 확인하는 것입니다 (개방형 시험에서 모든 페이지를 읽는 대신 책의 색인을 훑어보는 방식과 같습니다). 두 가지 일반적인 파일 시스템 도구가 정확히 이 기능을 수행합니다:
glob
파일 이름 패턴으로 파일을 찾습니다. 예를 들어, **/company-a*.md는 지난주 Company A에 대한 노트를 찾아줍니다.
grep
파일을 컨텍스트 윈도우에 로드하지 않고 파일 내부를 검색합니다. 이는 문자 그대로의 텍스트와 일치하는 부분을 매칭하며, 일치하는 파일을 반환하거나, 일치하는 라인 또는 개수를 반환할 수 있습니다.
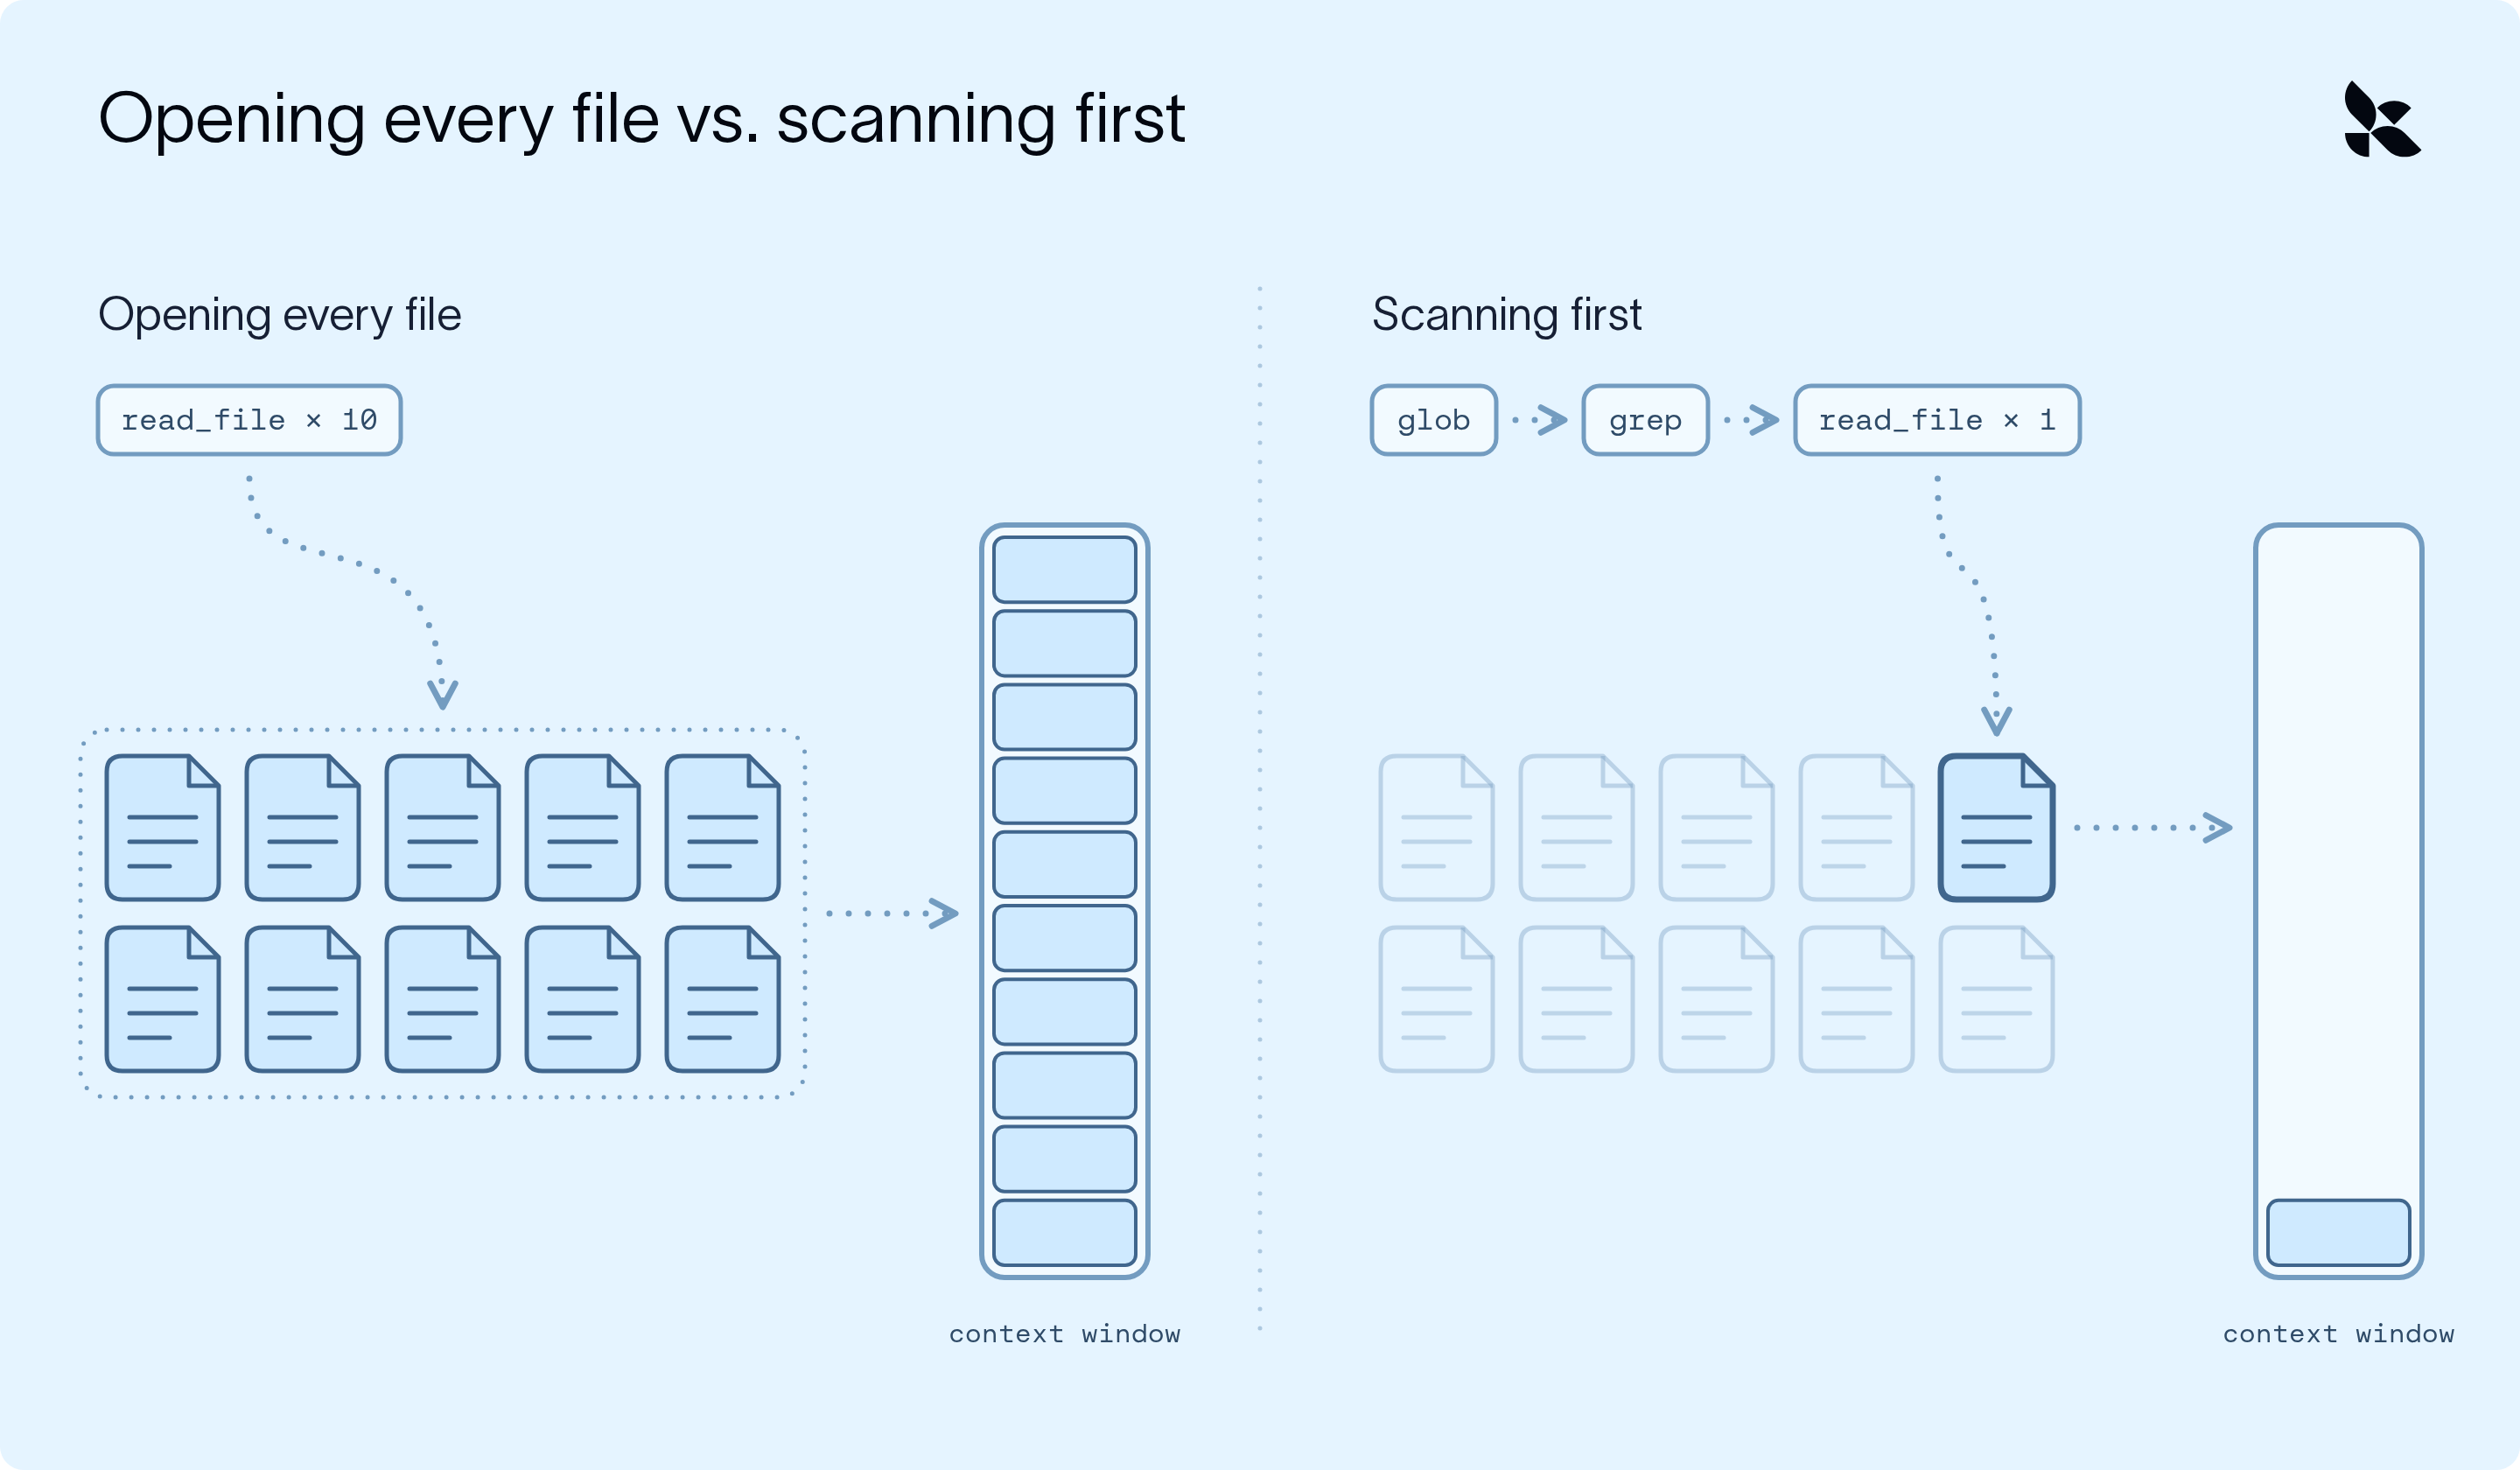
모든 고급 에이전트는 ls, read_file, write_file, edit_file과 함께 이러한 도구들을 내장하고 제공합니다. 파일이 어디에 있든지(에이전트 상태, 로컬 디스크, 영구 저장소 또는 샌드박스) 동일한 도구가 작동하는 이유는 모두 에이전트의 백엔드를 거치기 때문입니다.
키워드로 충분하지 않을 때 검색 도구 추가하기
Grep은 어떤 단어를 찾아야 하는지 알 때 매우 유용하지만, 사용자가 제공한 정확한 텍스트와만 일치합니다. 이는 예시의 세 번째 작업, 즉 뉴스 아카이브에서 새로운 내용을 검색하는 경우에 문제가 됩니다. 만약 우리 에이전트가 'Company A funding'으로 grep을 실행한다면, 비록 그것이 정확히 찾고 있는 내용일지라도, 'Company A closes $50M Series B'라는 제목의 기사는 놓치게 될 것입니다.
의미로 검색하는 것(semantic search)은 정확한 단어 일치 방식이 아니므로, 벡터 스토어(vector store) 기반의 **검색 도구(retrieval tool)**를 추가해야 합니다. 검색 도구는 에이전트가 정보를 가져오기 위해 호출할 수 있는 모든 도구를 의미합니다. 이 도구는 쿼리를 받아 특정 데이터 소스에서 조회하고, 발견한 정보 중 가장 근접한 일치 항목을 반환합니다.
하지만 의미 검색으로 전환하기 전에 동의어(synonyms)를 시도해 볼 수 있습니다. Grep은 주어진 정확한 단어만 일치시키지만, 해당 단어를 선택하는 에이전트는 이미 'funding'이라는 것이 'Series B' 또는 'raised'로 나타날 수도 있다는 것을 알고 있습니다. 검색에 실패할 경우 다른 표현을 시도하도록 지시하면, 각 용어마다 한 번씩 Grep을 실행합니다. 팀에서만 사용하는 단어(예: 내부 제품명)의 경우 스킬(skill)에 목록으로 작성해 주세요. 이는 문구가 예측 가능한 경우에 잘 작동합니다. 그렇지 않은 경우에는 의미 검색이 필요합니다.
검색 도구가 어떻게 일치하는지는 그 뒤에 있는 데이터 소스에 따라 다릅니다. 벡터 스토어 기반일 때는 의미로 일치시키지만, 검색 도구는 다른 데이터 소스 위에도 배치될 수 있습니다:
- 구조화된 조회를 위한 SQL 데이터베이스(예: 판매 실적 또는 고객 기록)
- 웹의 최신 정보를 위한 검색 API(search API)
- 다른 사람이 이미 구축한 문서 검색과 같은 도구를 위한 MCP 서버(MCP server)
의미 검색이 어떻게 작동하는지에 대한 더 깊은 내용은 LangChain 가이드를 참고하세요.
에이전트가 언제 검색할지 결정하게 하기
많은 검색 설정은 시작 시 한 번 검색한 후 답변합니다. 이는 FAQ 봇(2단계 RAG)에는 적합하지만, 저희의 에이전트에게는 그렇지 않습니다. 회사 C에 대한 조사를 진행하던 중, 에이전트가 이전에 알지 못했던 제품 출시 관련 기사를 발견했고, 이제 그 제품의 가격 정보가 필요하다고 가정해 봅시다 (이는 시작할 때 검색할 것이라고 예상하지 못한 정보입니다). 단 한 번의 검색만으로는 보고서가 완성되지 않습니다.
연구 에이전트는 2단계 RAG 대신 에이전트적 검색(agentic retrieval)이 필요합니다. 즉, 에이전트 스스로 언제 검색해야 할지, 무엇을 검색해야 할지, 그리고 더 필요한 정보가 있는지 여부를 결정하는 것입니다. Deep Agents를 사용하면 기본적으로 이 방식으로 작동합니다. 에이전트는 루프 내에서 실행되며 필요한 만큼 모든 도구를 호출할 수 있습니다.
검색 노하우를 스킬로 패키징하기
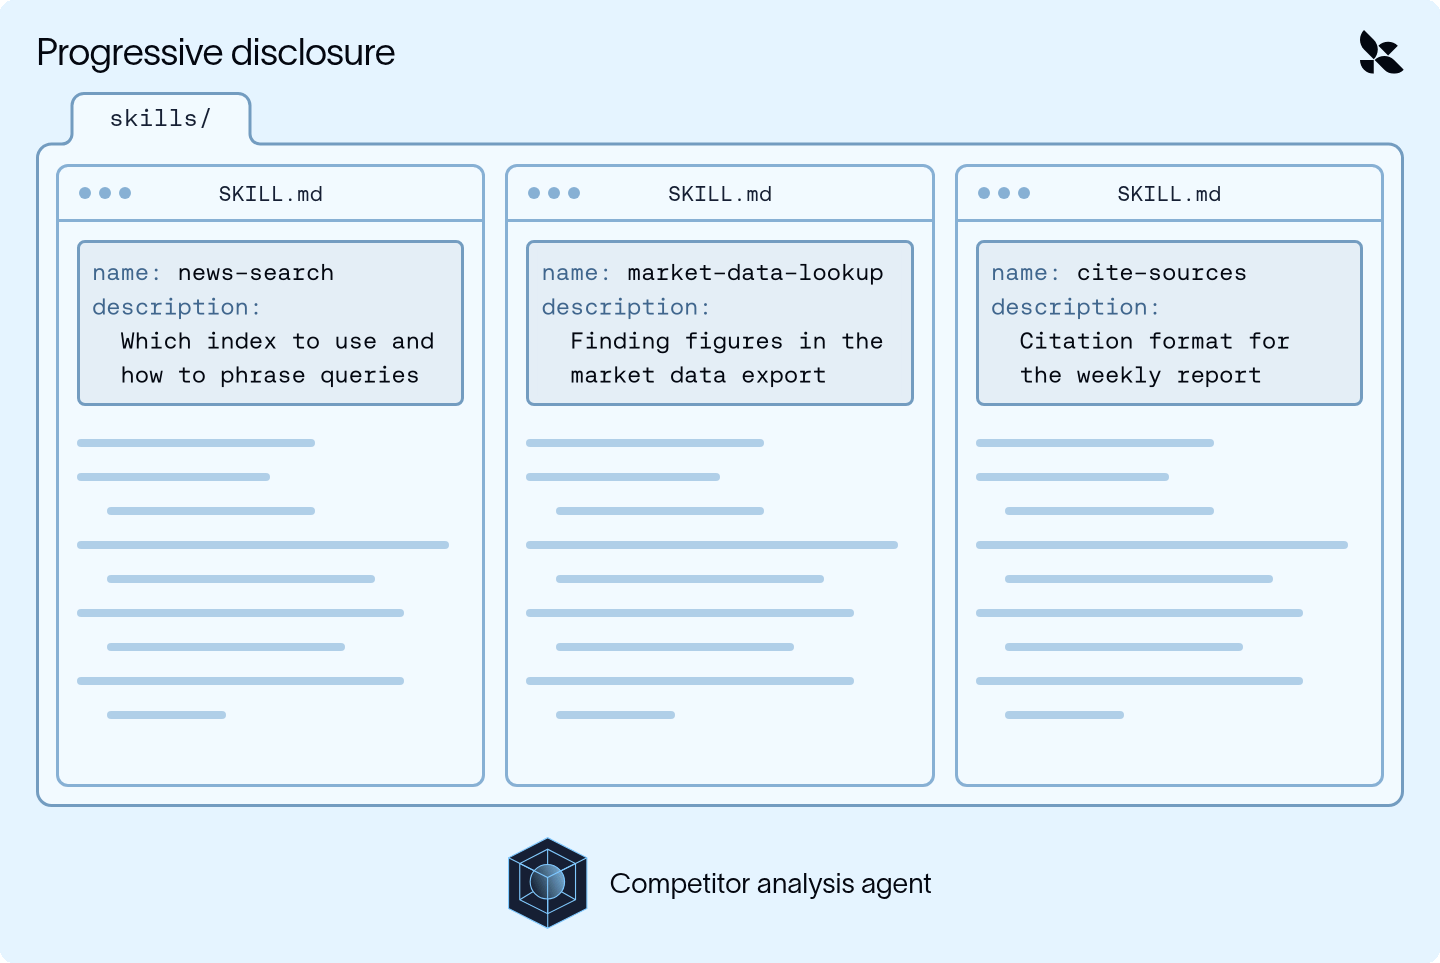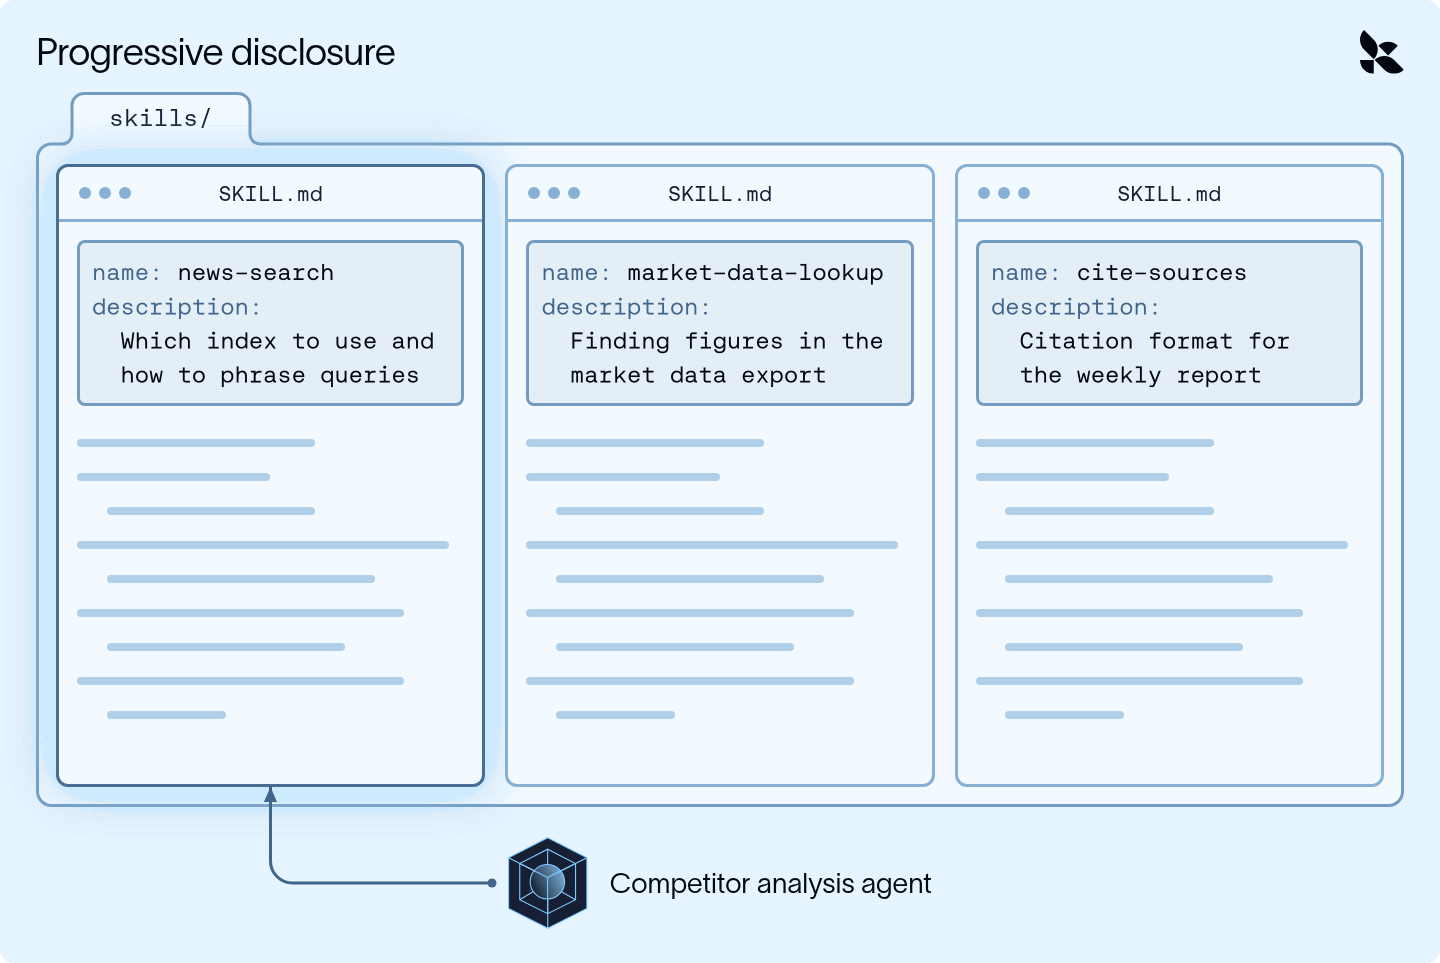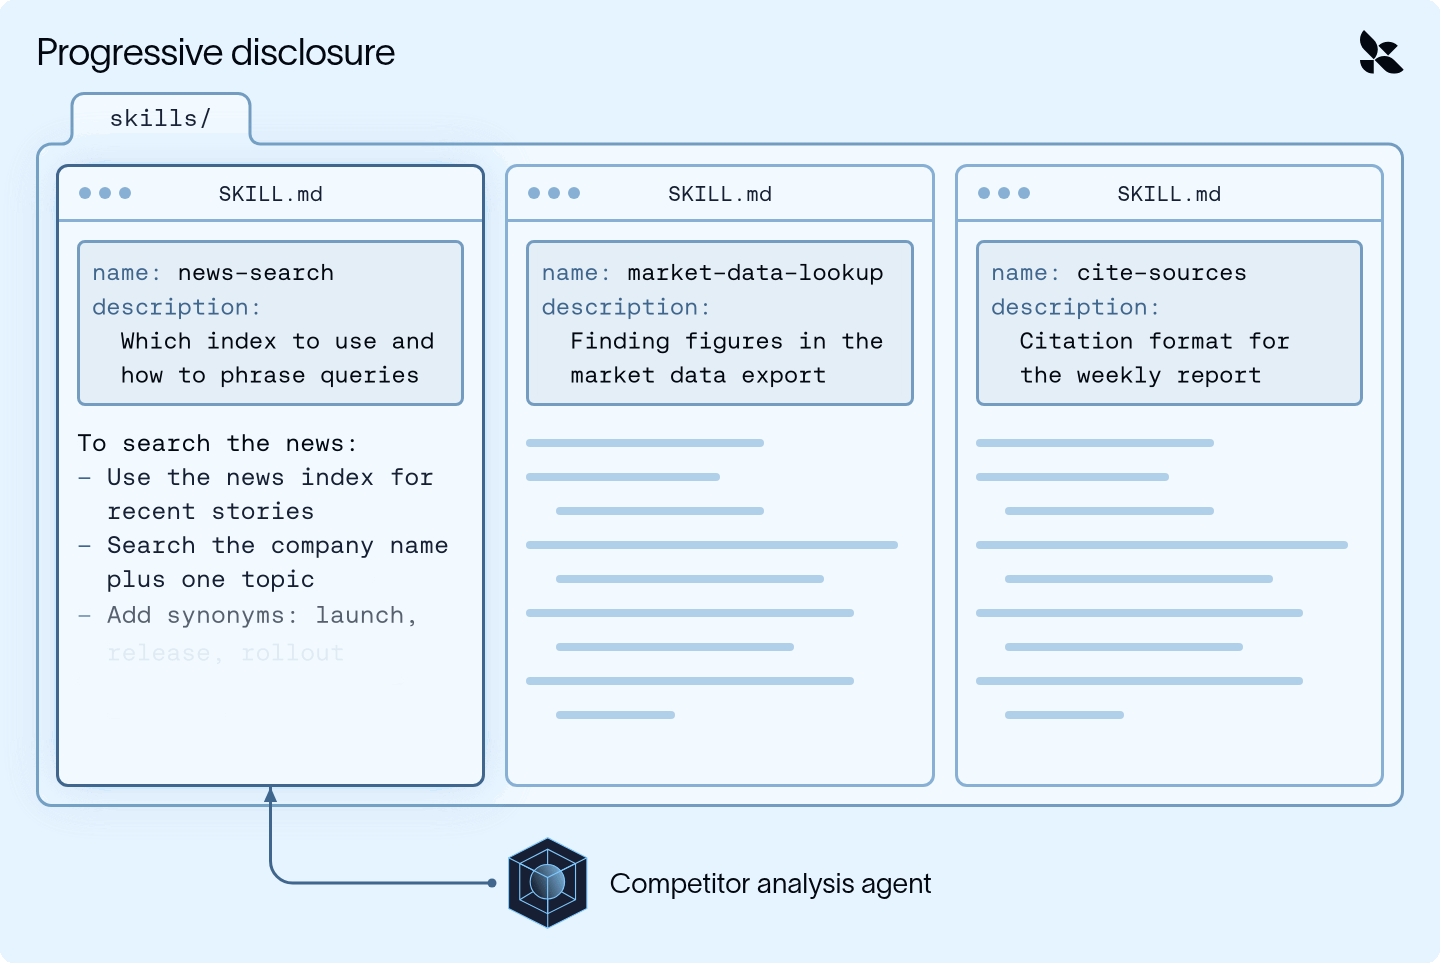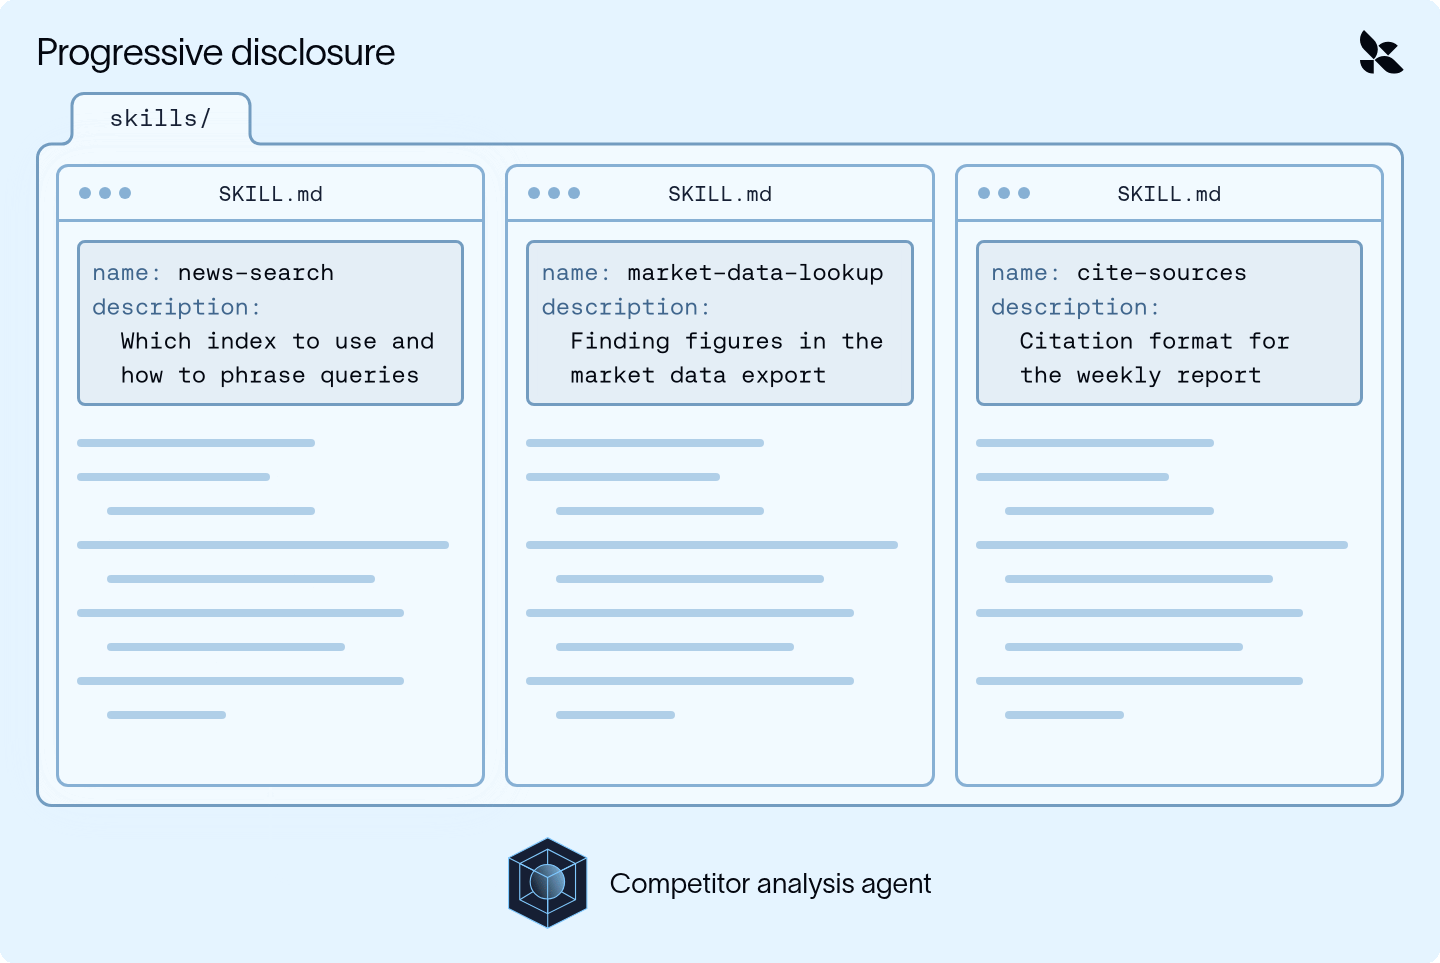
에이전트가 검색을 잘 수행하도록 돕기 위해, 사용자의 검색 지식(search know-how)을 하나의 스킬로 패키징할 수 있습니다. 스킬이란 특정 작업을 위한 일련의 지침 세트를 의미합니다 (예: 어떤 인덱스를 사용할지, 어떻게 쿼리를 작성하고 인용을 형식화할지 등).
에이전트는 작업 요청이 있을 때까지 각 스킬의 이름과 짧은 설명만 보게 됩니다. 그 후 전체 지침을 로드하게 되므로, 특정 분야의 노하우가 필요할 때 준비되어 있지만 평소에는 컨텍스트를 차지하지 않습니다 (이는 점진적 공개(progressive disclosure)라고 불리는 기술입니다). 비디오 설명을 참고하세요.
2. 한 번에 너무 많은 컨텍스트가 주어지는 경우
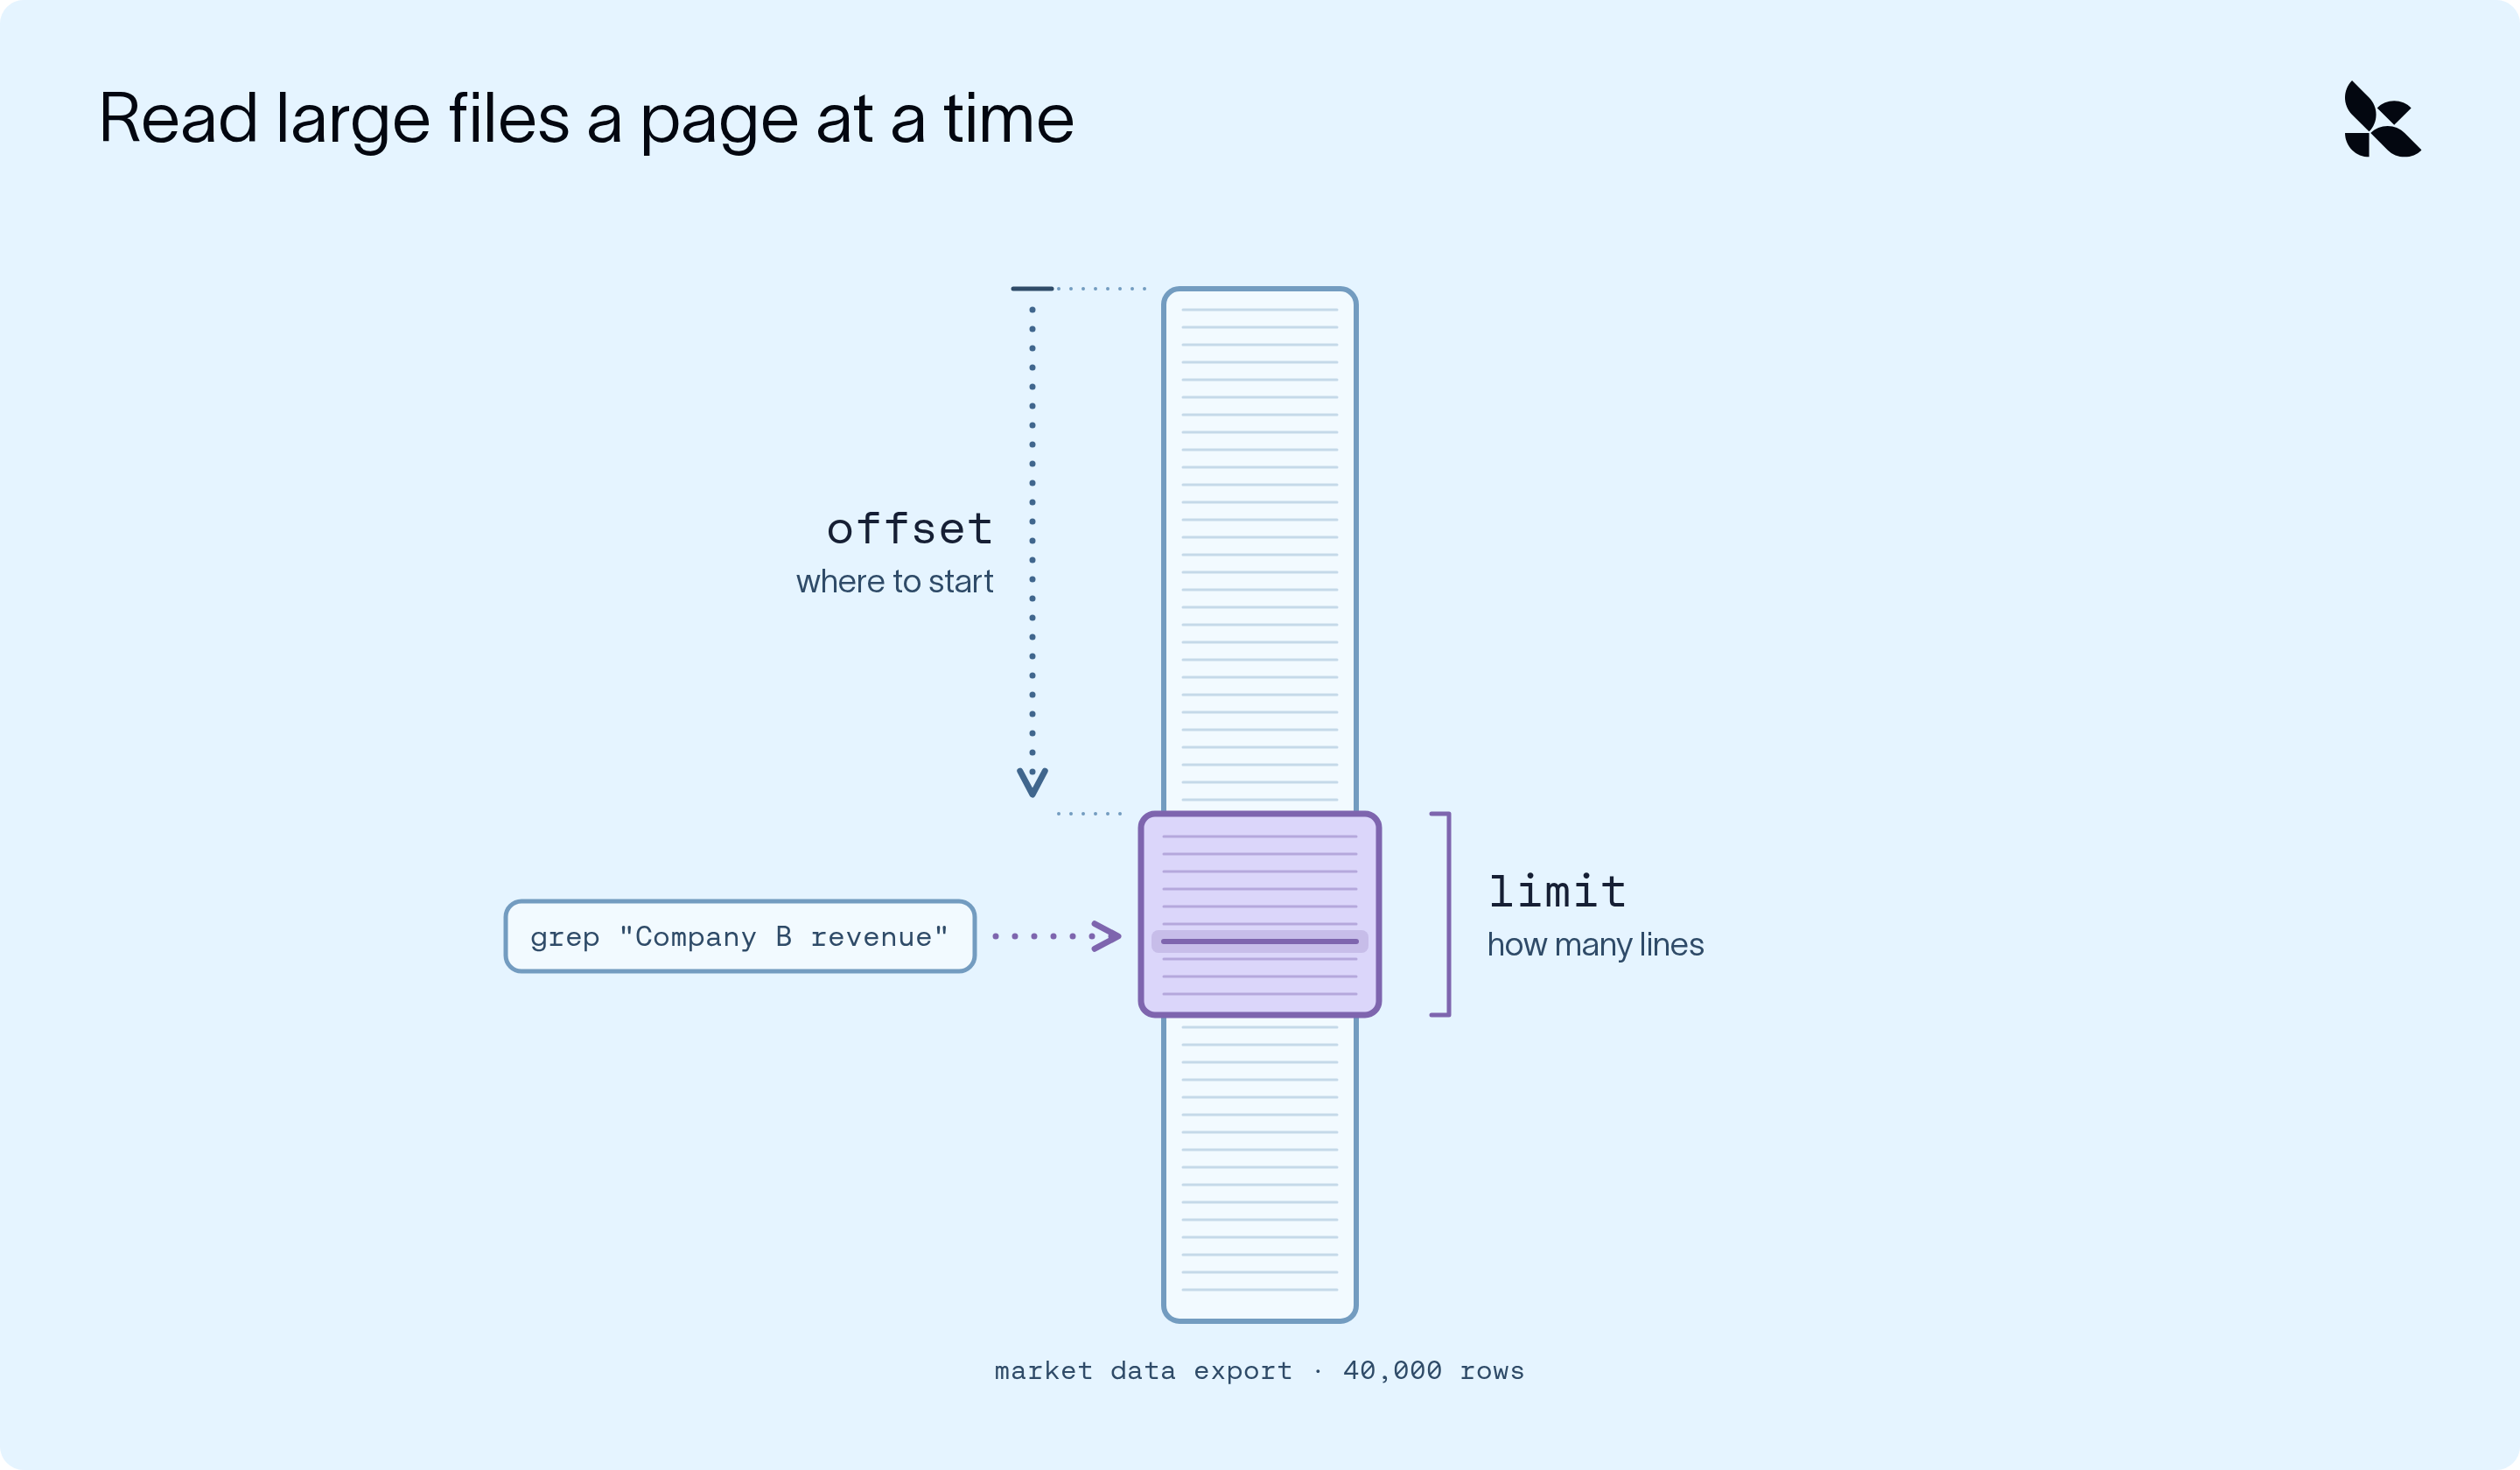
하지만 검색 프로세스를 최적화했음에도 불구하고, 심지어 올바른 검색 결과라도 너무 많은 정보를 반환할 수 있습니다. 저희 에이전트는 시장 데이터 내보내기에서 단 하나의 숫자(Company B의 분기별 매출)만 필요하지만, 그것을 찾기 위해 40,000개 행 전체를 로드하면 컨텍스트 창(context window)이 가득 차게 됩니다. 저희 검색 도구도 같은 문제가 있습니다. 만약 모든 뉴스 기사를 모델에 바로 반환한다면, 다섯 개 회사에 걸쳐 검색할 때마다 네 개의 결과가 쌓이면 금방 양이 많아집니다.
대용량 파일을 한 페이지씩 읽기
파일 시스템 도구들은 가능한 최소한의 정보만 반환하도록 설계되었습니다. read_file은 파일을 한 번에 한 페이지(기본값 100줄)씩 읽으며, 에이전트는 오프셋(offset, 시작할 줄 번호)과 제한(limit, 몇 줄을 읽을지)을 설정하여 필요한 부분으로 건너뛸 수 있습니다. 따라서 Company B의 매출을 찾으려면, 에이전트가 해당 내용을 검색한 후 주변의 몇 줄만 읽어오면 됩니다.
대용량 결과를 하네스(harness)가 오프로드하도록 하기
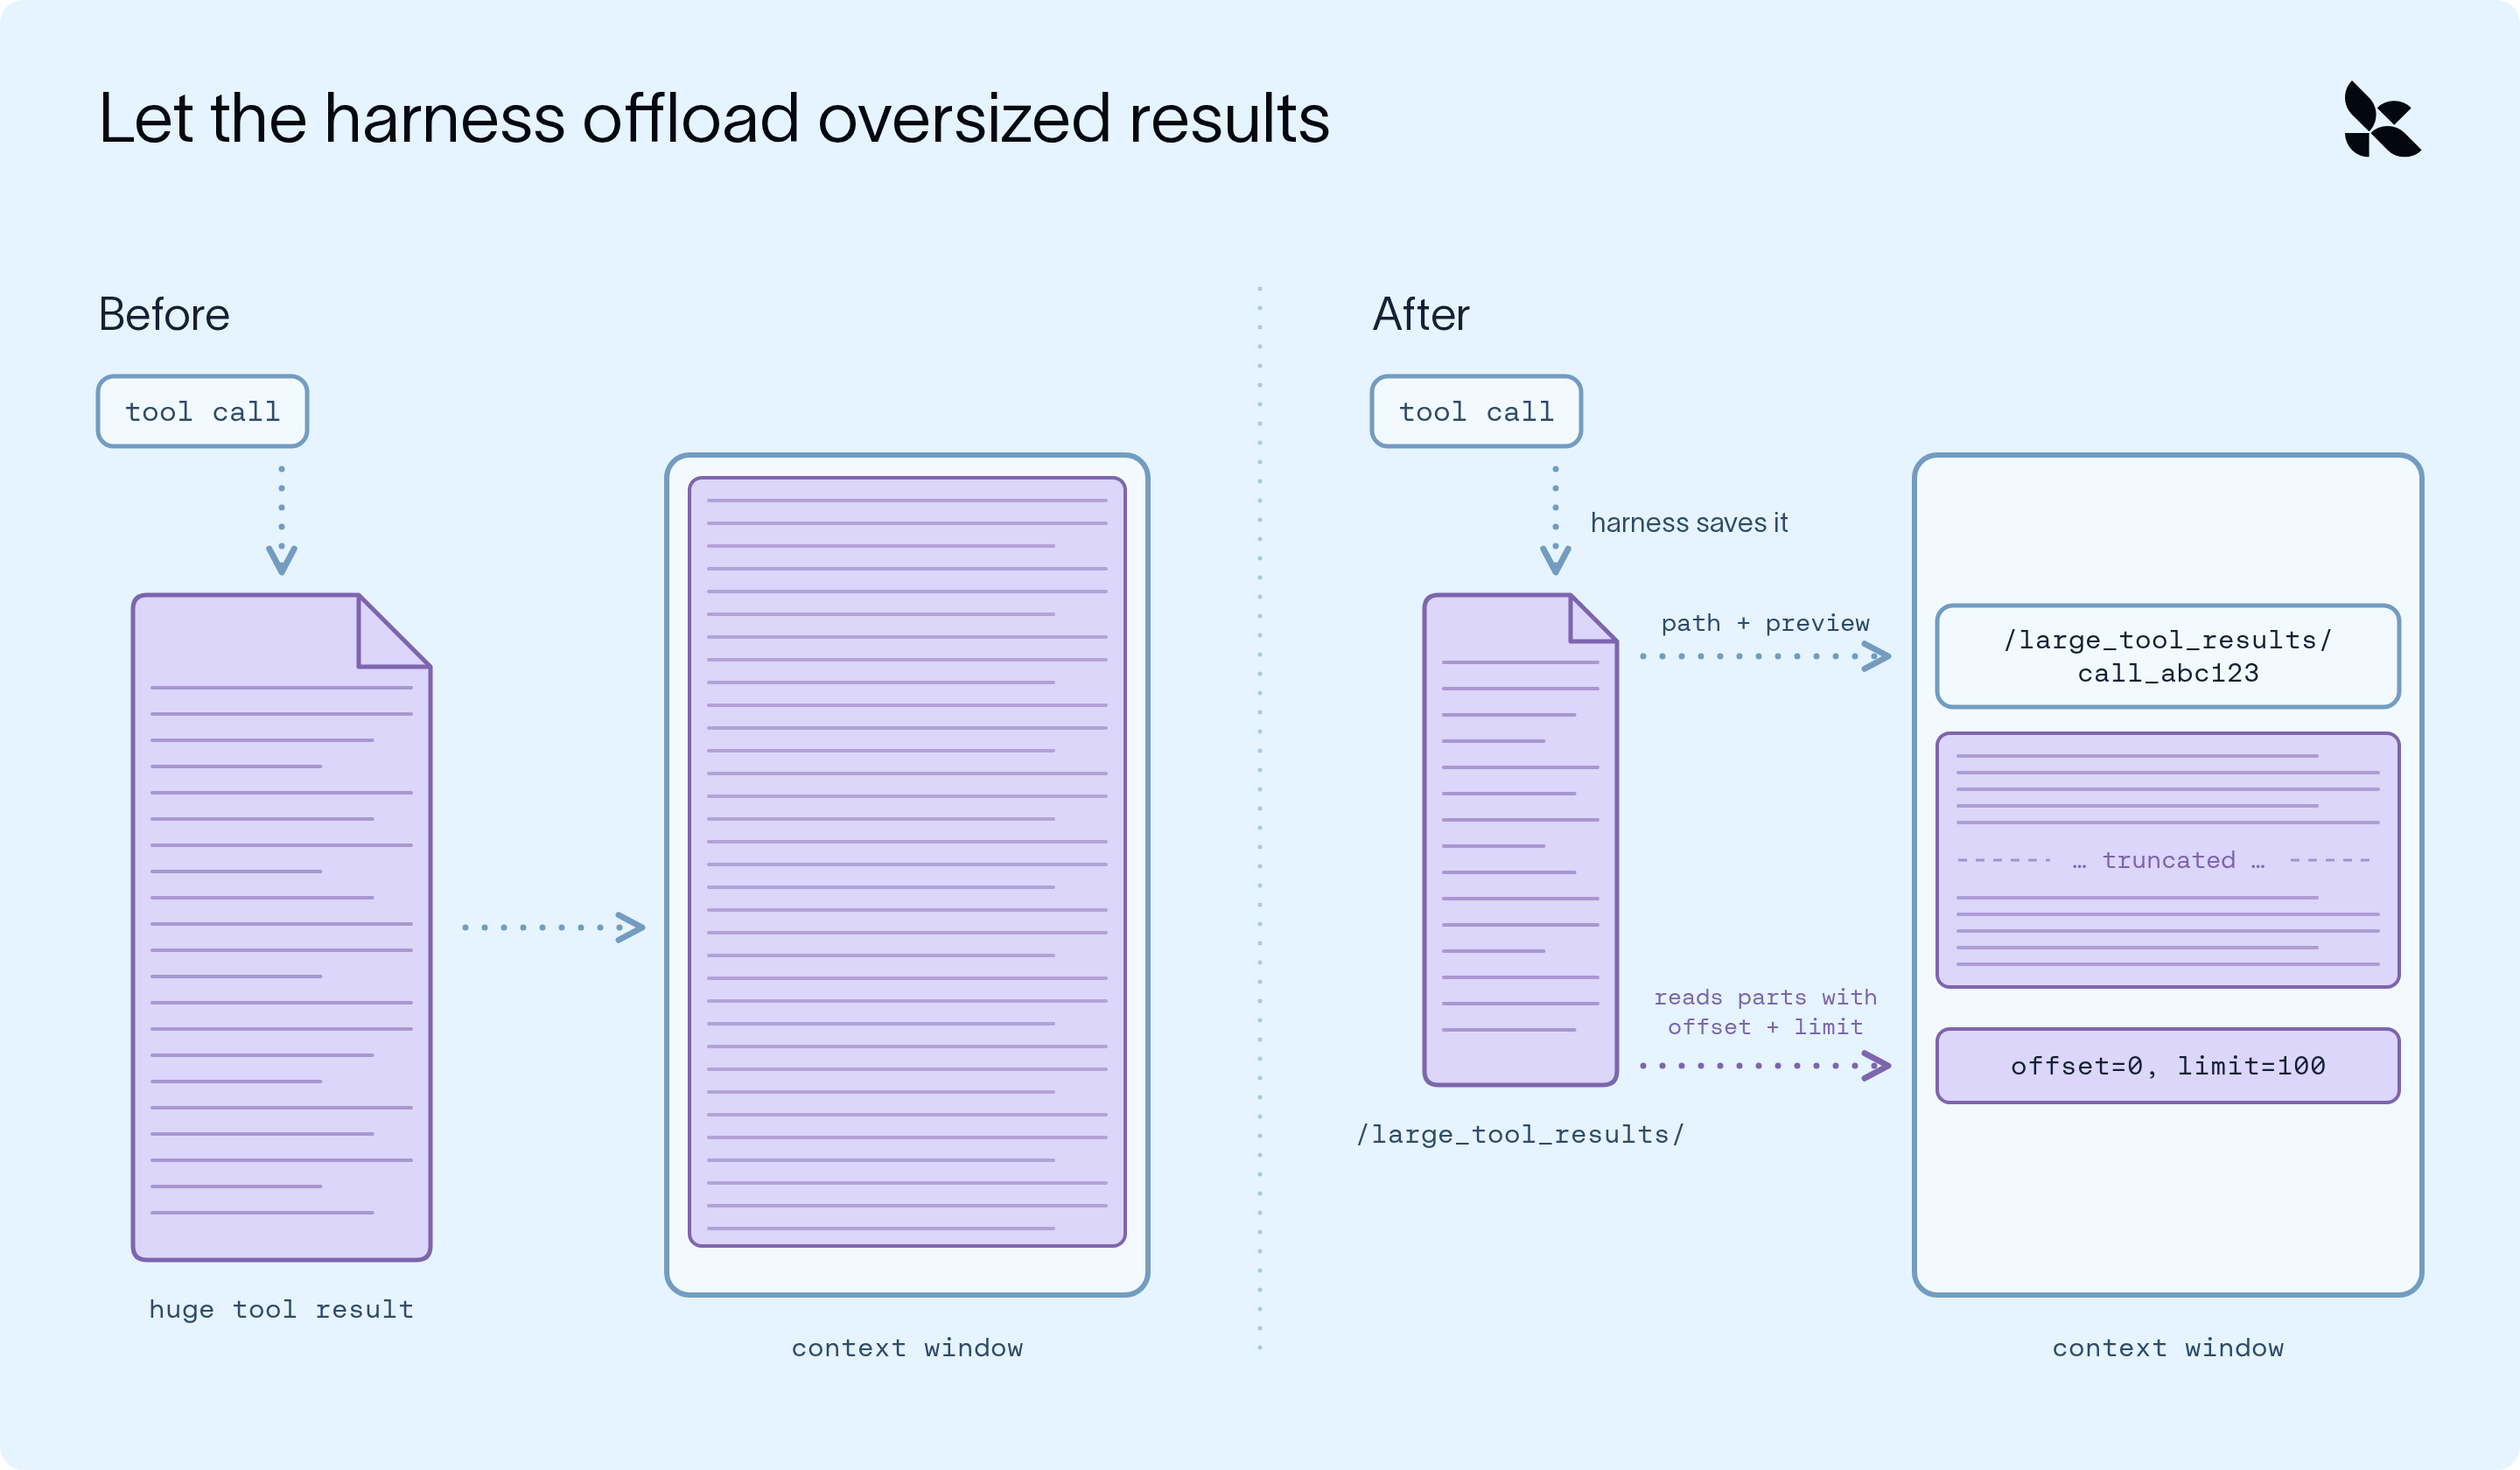
때로는 도구가 예상보다 많은 것을 반환하기도 합니다. 도구 결과가 너무 클 경우 (약 20,000 토큰 초과), 하네스는 해당 내용을 /large_tool_results/ 폴더에 파일로 저장하고 에이전트에게 경로와 짧은 미리보기(첫 몇 줄과 마지막 몇 줄)를 제공합니다. 그러면 에이전트는 read_file의 오프셋과 제한을 사용하여 필요한 부분만 다시 읽어올 수 있습니다.
검색 도구가 파일 경로를 반환하도록 하기
크기 제한을 기다리는 대신, 이와 동일한 아이디어를 자체 검색(retrieval) 도구에 적용할 수 있습니다. 각 결과를 파일로 작성하고 경로만 반환하도록 만드세요. 이것은 “검색(retrieve), 오프로드(offload), 위임(delegate)”이라는 패턴의 첫 번째 부분입니다 (LangChain의 RAG 가이드에서 이 과정을 전체적으로 설명합니다).
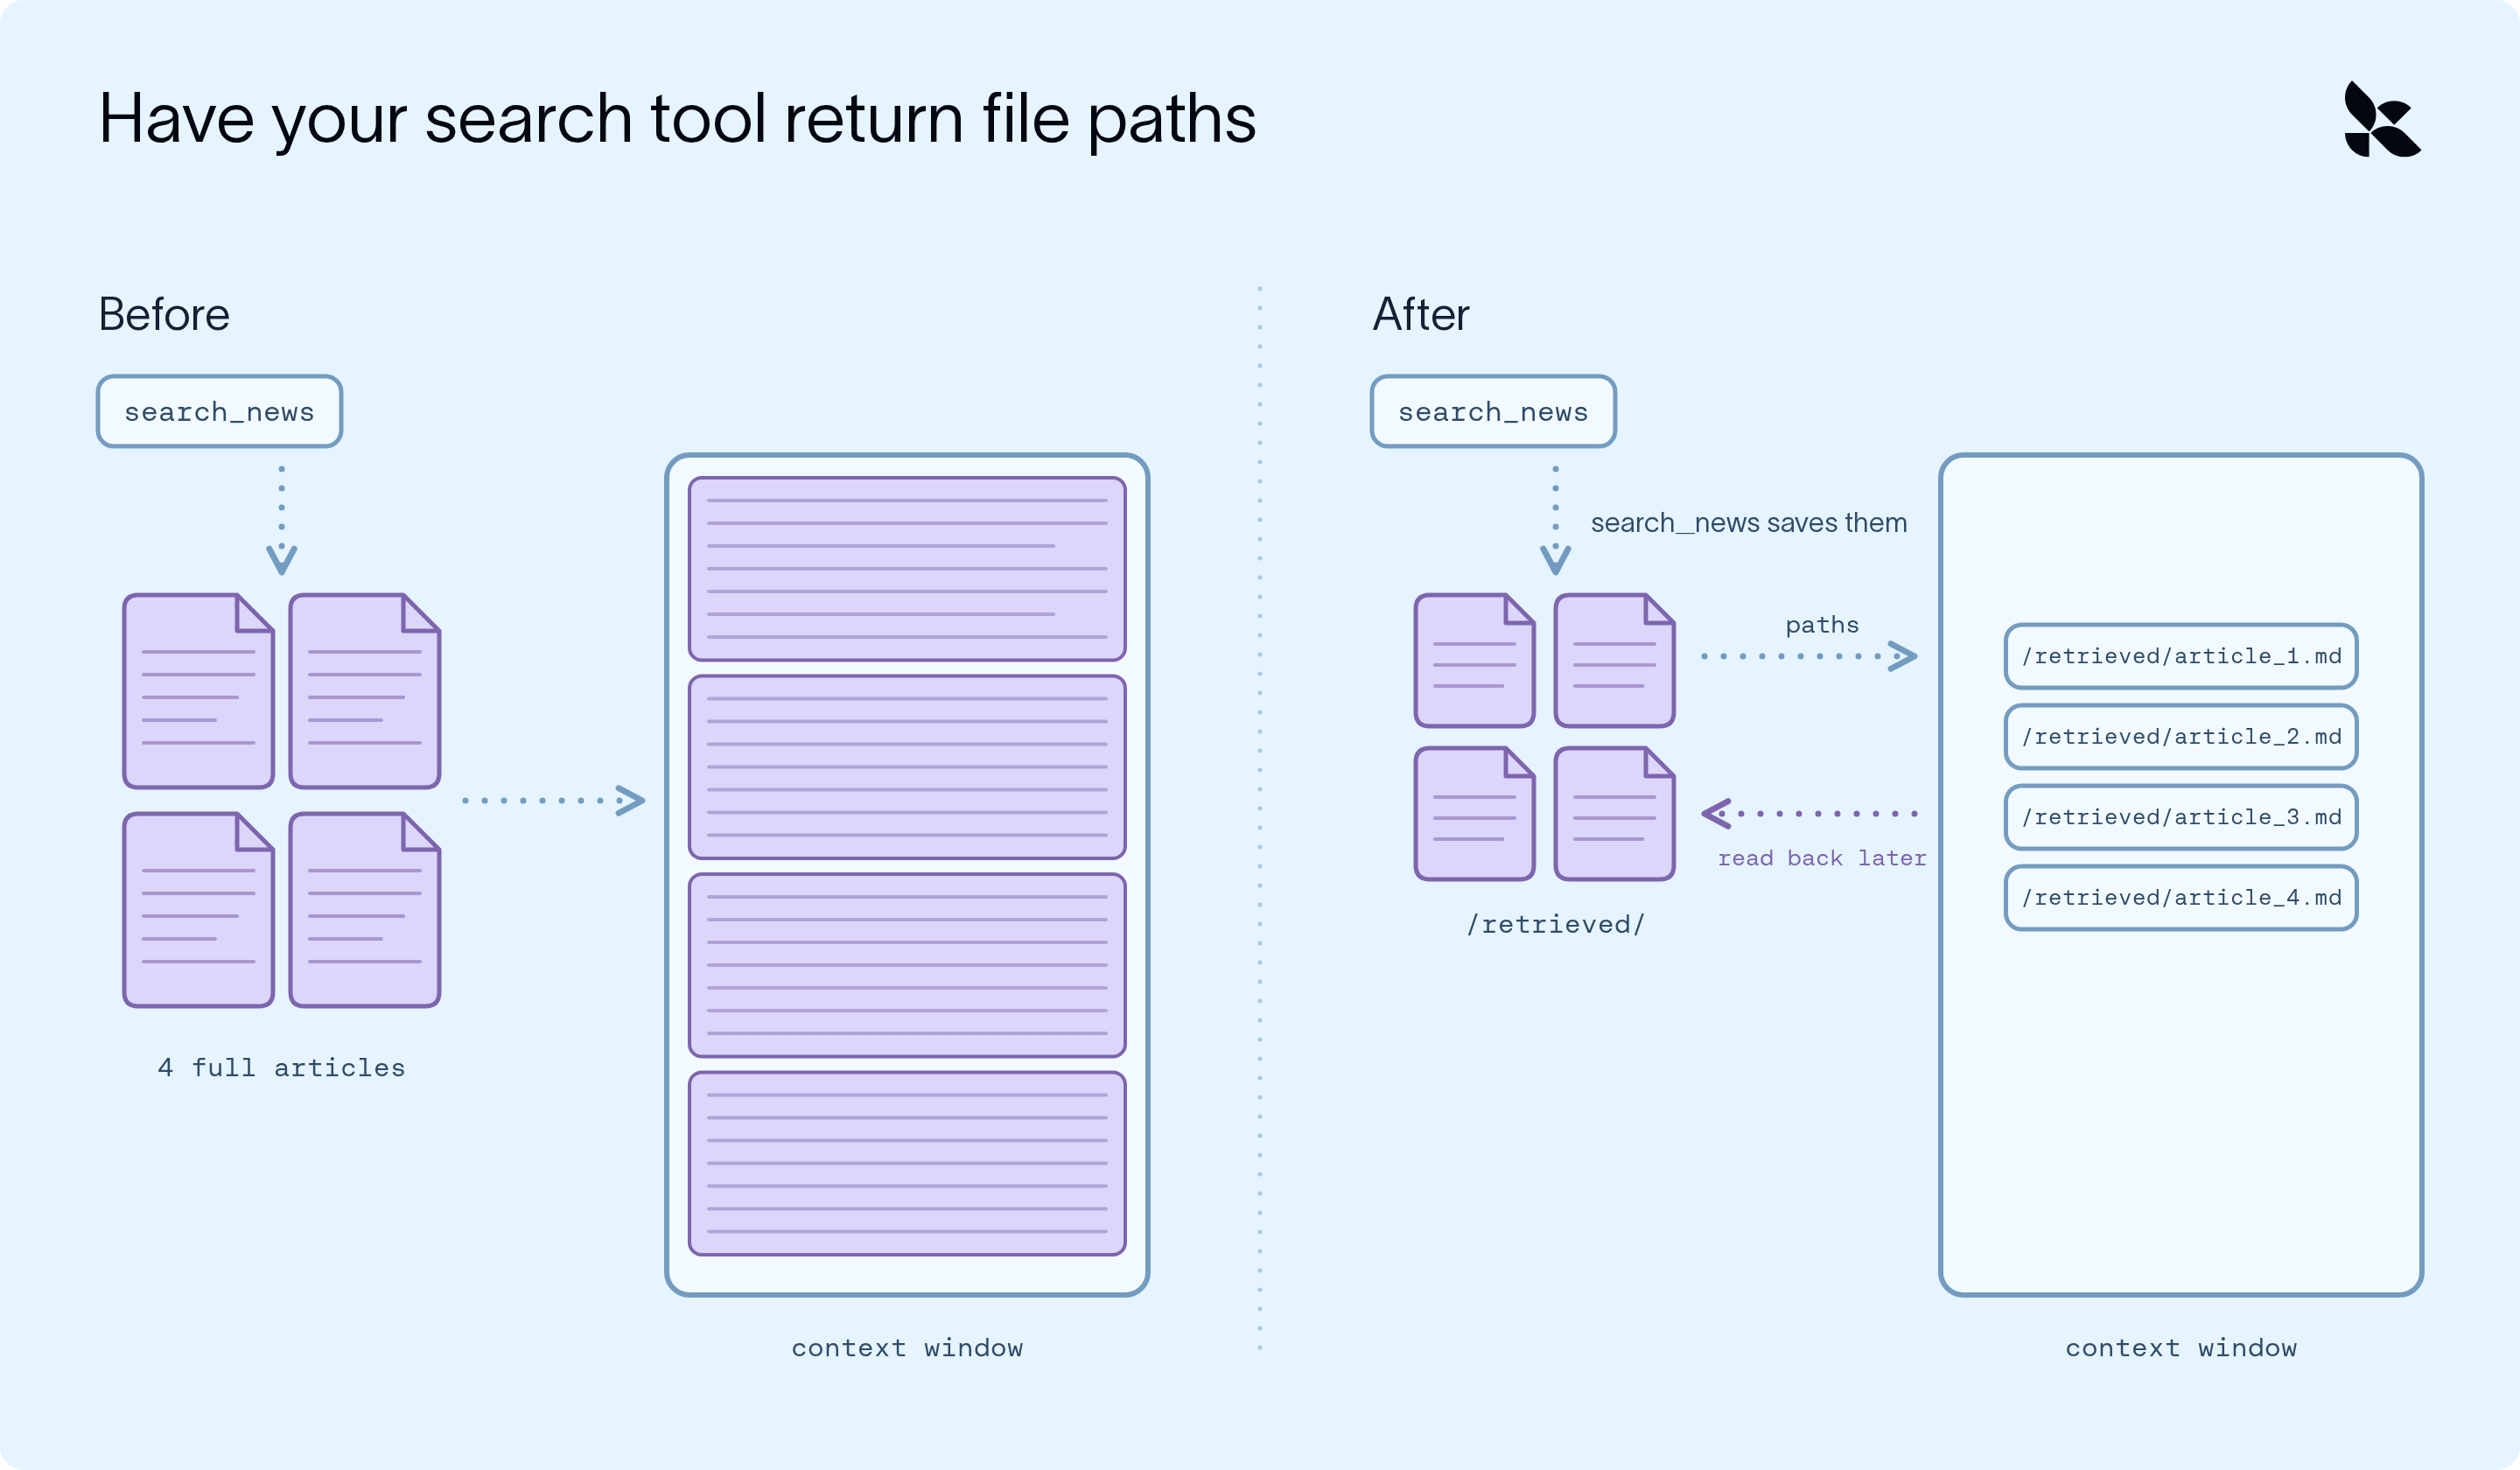
다음은 간소화된 검색 도구 예시입니다. 이 도구는 검색을 실행하고, 각 결과를 에이전트 백엔드에 파일로 저장하며, 오직 파일 경로 목록만 반환합니다:
backend = StateBackend()
@tool
def search_news(query: str) -> str:
"""뉴스 아카이브를 검색하고 각 결과를 파일로 저장합니다."""
docs = vector_store.similarity_search(query, k=4)
files = [(f"/retrieved/result_{i}.md", doc.page_content.encode()) for i, doc in enumerate(docs)]
backend.upload_files(files)
return "Saved results to: " + ", ".join(path for path, _ in files)"
이제 메인 에이전트는 네 개의 전체 기사 대신 네 개의 짧은 경로를 보게 됩니다.
3. 관련성이 없거나 오래된 컨텍스트 (Irrelevant or stale context)
작은 결과물이라도 잘못된 결과라면 도움이 되지 않습니다. 그 네 개의 파일 중 어느 것이든 유사한 이름의 다른 회사에 관한 내용이거나, 2년 전 이야기일 수 있습니다. 주제에서 벗어났거나 오래된 텍스트는 올바른 답변만큼이나 모델에게 설득력 있게 보일 수 있으므로, 목표는 이를 메인 에이전트의 컨텍스트에서 완전히 배제하는 것입니다.
서브에이전트로 결과 필터링하기 (Let subagents filter the results)
하지만 메인 에이전트는 어떤 파일들이 중요한지 알아내기 위해 여전히 그 파일들을 읽어야 합니다 (그리고 주제와 관련 없는 모든 기사를 열면 컨텍스트에 포함됩니다). 바로 여기에 “검색, 오프로드, 위임” 패턴의 “위임(delegate)” 부분이 들어옵니다. 서브에이전트가 검색된 각 파일을 읽고 핵심 사실만을 반환하는 것입니다.
- 서브에이전트 정의: 설명(description)은 메인 에이전트에게 언제 사용할지 알려주고, 시스템 프롬프트는 서브에이전트에게 해당 파일로 무엇을 할지 지시합니다.
`chunk_analyst = {
"name": "chunk-analyst",
"description": "검색된 파일을 하나 분석합니다. 질문과 /retrieved/ 아래의 단일 경로를 전달받습니다."}
"system_prompt": "할당된 파일을 읽으려면 read_file을 사용하세요. 핵심 사실과 출처 URL을 반환합니다.",
- 메인 에이전트에게 검색(retrieval) 도구와 서브 에이전트를 제공합니다. 서브 에이전트가 해당 도구가 저장한 파일을 읽을 수 있도록
search_news에서 사용했던 백엔드(backend)를 동일하게 전달해야 합니다.
agent = create_deep_agent(
    model=model,
    tools=[search_news],
    backend=backend, # 동일 인스턴스를 사용하므로 read_file이 /retrieved/를 볼 수 있습니다.
    subagents=[chunk_analyst],
)
이제 흐름은 다음과 같습니다:
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기