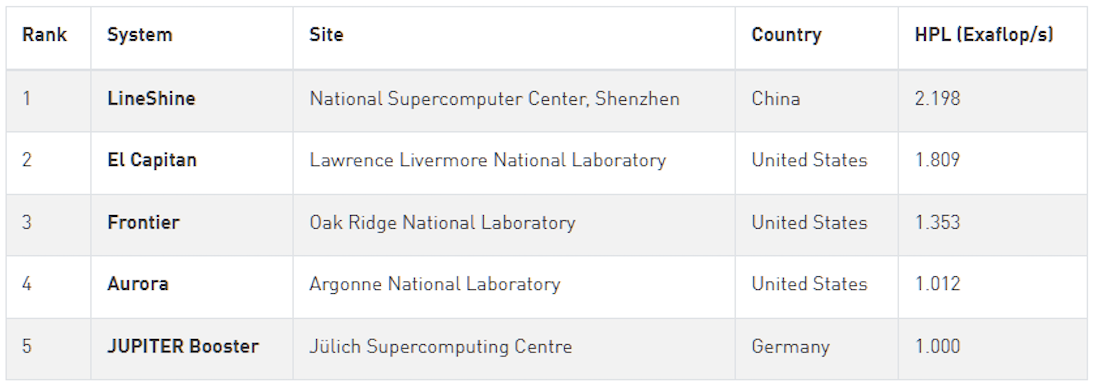
지난 월요일 시카고에서 발표된 제68회 Top500 리스트에 따르면, 중국의 LineShine은 여전히 세계 최고 성능을 자랑하는 슈퍼컴퓨터로 남아 있습니다. 수십 년 만에 처음으로, 전례 없는 고성능 컴퓨팅 하드웨어 수요에도 불구하고 슈퍼컴퓨터 순위에는 이례적으로 적은 추가 시스템만 기록되었습니다. 이는 오늘날 배치되는 막대한 양의 컴퓨팅 자원이 전통적인 슈퍼컴퓨터를 위한 것이 아니라 인공지능(AI) 데이터 센터를 위해 사용될 운명이기 때문입니다.
변경되지 않은 상위 10개 슈퍼컴퓨터
선전의 국립슈퍼컴퓨터센터에 설치된 중국의 [LineShine]은 High Performance Linpack (HPL) 벤치마크에서 42.22 MW를 소비하며 2.198 FP64 ExaFLOPS의 지속적인 FP64 컴퓨팅 성능을 제공합니다. 이 시스템은 자체 개발한 LingKun 플랫폼과 304코어 Armx9 기반 LX2 프로세서(클럭 속도 1.55 GHz, 총 13,789,440 코어) 및 독점적인 LingQi 인터커넥트를 활용합니다. LineShine은 다른 네 개의 exascale급 슈퍼컴퓨터와 달리 컴퓨팅 가속기(compute accelerators)를 전혀 사용하지 않고 CPU에 전적으로 의존한다는 특징이 있습니다. 이것이 바로 FP64에서 혼합 정밀도 데이터로 전환할 때 성능 향상이 3.6X에 그치는 주된 이유이며, 이는 저정밀도 가속기를 사용하는 시스템보다 낮은 수치입니다.
Top 500
(이미지 출처: Top 500)
미국에서 가장 강력한 엘 카피탄(El Capitan) 슈퍼컴퓨터는 로렌스 리버모어 국립 연구소(Lawrence Livermore National Laboratory)에 있으며, AMD의 Instinct MI300A 가속 처리 장치(APU)를 사용합니다. HPE Cray EX255a 플랫폼은 29.69 MW에서 1.809 FP64 ExaFLOPS를 제공하며, 이는 중국의 경쟁 제품보다 전력 효율성이 훨씬 높습니다. 오크리지 국립 연구소(Oak Ridge National Laboratory)의 프론티어(Frontier) 슈퍼컴퓨터는 AMD의 3세대 EPYC 프로세서와 Instinct MI250X 컴퓨팅 GPU를 기반으로 하며, 24.61 MW에서 1.353 FP64 ExaFLOPS를 달성합니다. 한편, 아르곤 국립 연구소(Argonne National Laboratory)의 오로라(Aurora)는 Intel의 Xeon CPU Max 9470 프로세서와 Data Center GPU Max 가속기를 사용하여 38.70 MW에서 1.012 FP64 ExaFLOPS를 제공합니다.
세 미국 초메가급 슈퍼컴퓨터 모두 HPE의 Cray EX 플랫폼과 Slingshot-11 인터커넥트를 사용합니다.
독일 율리히 슈퍼컴퓨팅 센터(Jülich Supercomputing Center)에 위치한 주피터 부스터(Jupiter Booster)는 Nvidia의 GH200 Grace Hopper Superchip, BullSequana XH3000 플랫폼, 그리고 Nvidia의 쿼드-레일 InfiniBand NDR200 인터커넥트를 사용하여 15.79 MW에서 1.0 FP64 ExaFLOPS를 제공하며, 목록 중 가장 에너지 효율적인 초메가급 슈퍼컴퓨터로 남아있습니다.
주목할 만한 점은 지난 6월 이후 상위 10개 성능 슈퍼컴퓨터와 상위 10개 에너지 효율 슈퍼컴퓨터의 순위가 변동되지 않았다는 것입니다.
Top 500에 포함된 단 27대의 신규 슈퍼컴퓨터
Top 500 목록에 포함된 새로운 슈퍼컴퓨터는 단 27대(전체 목록 기기의 5.4%)에 불과하며, 이는 이 프로젝트가 1993년에 설립된 이후 가장 적은 수치입니다. 가장 강력한 신규 진입자는 한국의 KISTI 슈퍼컴퓨팅 센터에 있는 한강(Hanggang)으로, 342.6 FP64 PFLOPS로 12위에 올랐습니다. 이 장비는 Nvidia의 GH200 Grace Hopper Superchip과 HPE의 Cray EX254n 플랫폼을 사용합니다. 한강은 또한 HPCG 벤치마크에서 4.29 HPCG PFLOPS를 기록하며 8위를 차지했습니다.
세계 500대 최고 성능 슈퍼컴퓨터의 총 HPL(High Performance Linpack) 성능은 지난 6개월 동안 소폭인 4.4% 증가하여 19.57 FP64 ExaFLOPS를 기록했습니다. 그럼에도 불구하고, TOP500에 자격을 얻으려면 지속적인 FP64 성능이 2.857 PFLOPS에 달하는 장비가 필요하며, 이는 지난 6월의 2.662 PFLOPS보다 7.3% 증가한 수치입니다. 순위 50위와 100위 시스템의 성능은 각각 49.85 PFLOPS에서 55.81 PFLOPS(12%)로, 그리고 21.85 PFLOPS에서 22.74 PFLOPS로 상승했습니다. 또한, 최소 100 PFLOPS의 FP64 성능을 제공하는 장비가 지난 6월의 25대에서 27대로 늘어났으며, 컴퓨팅 가속기(compute accelerators)를 갖춘 슈퍼컴퓨터 수는 275대에서 291대(58.2%)로 증가했습니다.
모든 것이 AI 데이터 센터로 향하다
최근 첨단 컴퓨팅 인프라에 대한 전례 없는 규모의 투자가 이루어지고 있음에도 불구하고, TOP500 순위에 신규 진입하는 장비 수가 역사적으로 적다는 점은 특히 주목할 만합니다. Top 500 저자들이 인용한 Epoch AI의 추정치에 따르면, 전 세계적으로 분기별로 추가되는 AI 컴퓨팅 용량은 매년 2.5배씩 증가했습니다. 본질적으로 업계의 우선순위는 예외적으로 복잡한 과학적 문제를 해결할 수 있는 장비 건설에서 상업용 AI 워크로드(AI workloads)를 위한 방대한 양의 컴퓨팅 용량 배치로 이동했습니다.
실제로 Epoch AI에 따르면, 전 세계 설치된 AI 컴퓨팅 용량은 이미 1,500만 개의 Nvidia H100 GPU 상당을 초과합니다. 더욱이, 2025년 4분기 기준으로 다섯 개의 주요 미국 초거대 클라우드 제공업체(hyperscalers)가 전 세계 AI 컴퓨팅 자원의 약 71%를 차지했으며, 이 중 상당 부분은 대규모 클러스터에 배치되었습니다. 첨단 컴퓨팅 하드웨어에 대한 수요는 사상 최고치이지만, 새로운 하드웨어의 대다수는 세계적으로 가장 잘 알려진 슈퍼컴퓨터 순위에는 도달하지 않는 것으로 보입니다.