
1억 명 사용자 규모의 은행이 프로덕션 환경에서 에이전틱 AI를 테스트하는 방법
요약
KDD 2026 논문은 1억 명 이상의 사용자를 보유한 은행이 고객 지원 AI 에이전트를 프로덕션 환경에서 테스트하는 방법을 제시합니다. 다섯 가지 에이전트 모두 거래 순추천 지수(tNPS)를 개선했으나, 은행 전문가 인간 에이전트의 기준점에는 미치지 못했습니다. 다만, 셀프 서비스율은 크게 증가하며 AI 도입의 유효성을 입증했습니다.
핵심 포인트
- AI 에이전트는 대규모 사용자 기반(1억 명 이상)에서 테스트되었습니다.
- 모든 에이전트가 만족도를 개선했으나 인간 전문가 기준점에는 미달했습니다.
- 셀프 서비스율은 AI 도입의 주요 성과 지표로, 일부 분야에서 큰 폭으로 증가했습니다.
- 자동 채점기는 초기 성능을 높이기 위해 최적화(GEPA optimization) 과정이 필요합니다.
요약: KDD 2026 논문은 다섯 가지 고객 지원 AI 에이전트가 테스트 및 배포 과정을 거치는 내용을 다룹니다. 팀은 자동 채점기를 전문가의 판단과 비교하고, 노출도를 1%에서 5%로 늘리며 새로운 버전을 시작하며, 만족도 향상이 더 많은 셀프 서비스(self-service)를 가져오는지 아니면 인간 에이전트에게 더 많은 업무를 주는지 추적합니다.
자동 채점기는 AI 에이전트에게 합격 점수를 줄 수 있지만 여전히 틀릴 수 있습니다. 이 논문은 1억 명 이상의 사용자를 보유한 은행이 카드 배달, 부채 관리(debt management), 신용 한도(credit limits), 카드 관리, 상품 설명 등 여러 영역에서 프로덕션 환경에 에이전틱 AI를 테스트하는 방법을 설명합니다. 이 고객 기반이 배포의 맥락을 제공하며, 이것이 테스트 표본 크기는 아닙니다.
에이전틱 AI를 구매하는 기업들에게 이 사례는 팀이 어떤 에이전트가 더 많은 업무를 처리할 준비가 되었는지 결정하는 방법을 보여줍니다. 증거는 유료 미디어(paid media)나 백오피스 워크플로우(back-office workflows)가 아니라 고객 지원에서 나옵니다. 이의 유용한 기여는 새로운 버전이 통과해야 하는 테스트부터 사람이 인계받는 지점까지, 각 준비 결정 뒤에 숨겨진 세부 사항입니다.
다섯 가지 AI 에이전트 모두 만족도를 개선했지만 인간의 기준점에는 미치지 못했다
온라인 A/B 테스트에서 지원 상호작용(support interaction) 후에 수집된 거래 순추천 지수(transactional Net Promoter Score, tNPS)를 다섯 가지 에이전트 모두 개선했습니다. 비교는 이전 버전과 대조군(control group)을 포함하여 에이전트별로 달랐습니다. 그럼에도 불구하고 점수는 지원 퍼널(support funnel) 내에서 별도로 측정된 은행의 전문가 인간 에이전트 기준점보다 낮게 유지되었습니다.
| 에이전트 | 만족도 | 셀프 서비스 | 인간 에이전트 대비 비교 | |
| :--- | :--- | :--- | :--- |
| 카드 배달 | 큰 폭 증가 | 가장 큰 폭 증가 | 뒤처짐 |
| 부채 관리 | 가장 큰 폭 증가 | 작은 폭 증가 | 가장 많이 뒤처짐 |
| 신용 한도 | 작은 폭 증가 | 보통 폭 증가 | 근접하게 뒤처짐 |
| 카드 관리 | 큰 폭 증가 | 작은 폭 증가 | 거의 일치함 |
| 상품 설명 | 보통 폭 증가 | 약간 감소 | 근접하게 뒤처짐 |
출처: Gupta et al., KDD 2026, 표 3. 인간 점수는 AI 점수와 별도로 측정되었습니다.
셀프 서비스율(self-service rate)은 AI가 요청을 사람에게 전달하지 않고 해결한 비율을 추적합니다. 카드 배송 분야에서 가장 큰 증가를 보였으며, 29% 포인트 상승과 함께 만족도 역시 37포인트 상승했습니다. 제품 설명자(product explainer)는 예외적인 경우로, 저자들은 이를 언어 모델 호출 시 발생한 일시적인 오류 때문이라고 분석합니다.
자동 채점기(The Automated Grader)가 초기에는 단순 기준선보다 낮은 점수를 기록함
팀은 에이전트의 지침과 비즈니스 절차를 개별적으로 수정할 수 있는 모듈로 분리합니다. 도메인 전문가들이 이 모듈들을 변경하고, 이후 자동 채점기 역할을 하는 언어 모델(language models)이 라이브 테스트 전에 후보 버전을 평가합니다.
기준 답변을 설정하기 위해 세 명의 운영 분석가(operations analysts)가 각 평가 샘플에 라벨을 지정하고 그 결정 과정을 설명했습니다. 다수결 투표로 최종 라벨이 결정되었습니다. 이러한 설명들은 이후 프롬프트 최적화 방법인 GEPA를 통해 채점기의 지침을 개선하는 데 도움을 주었습니다.
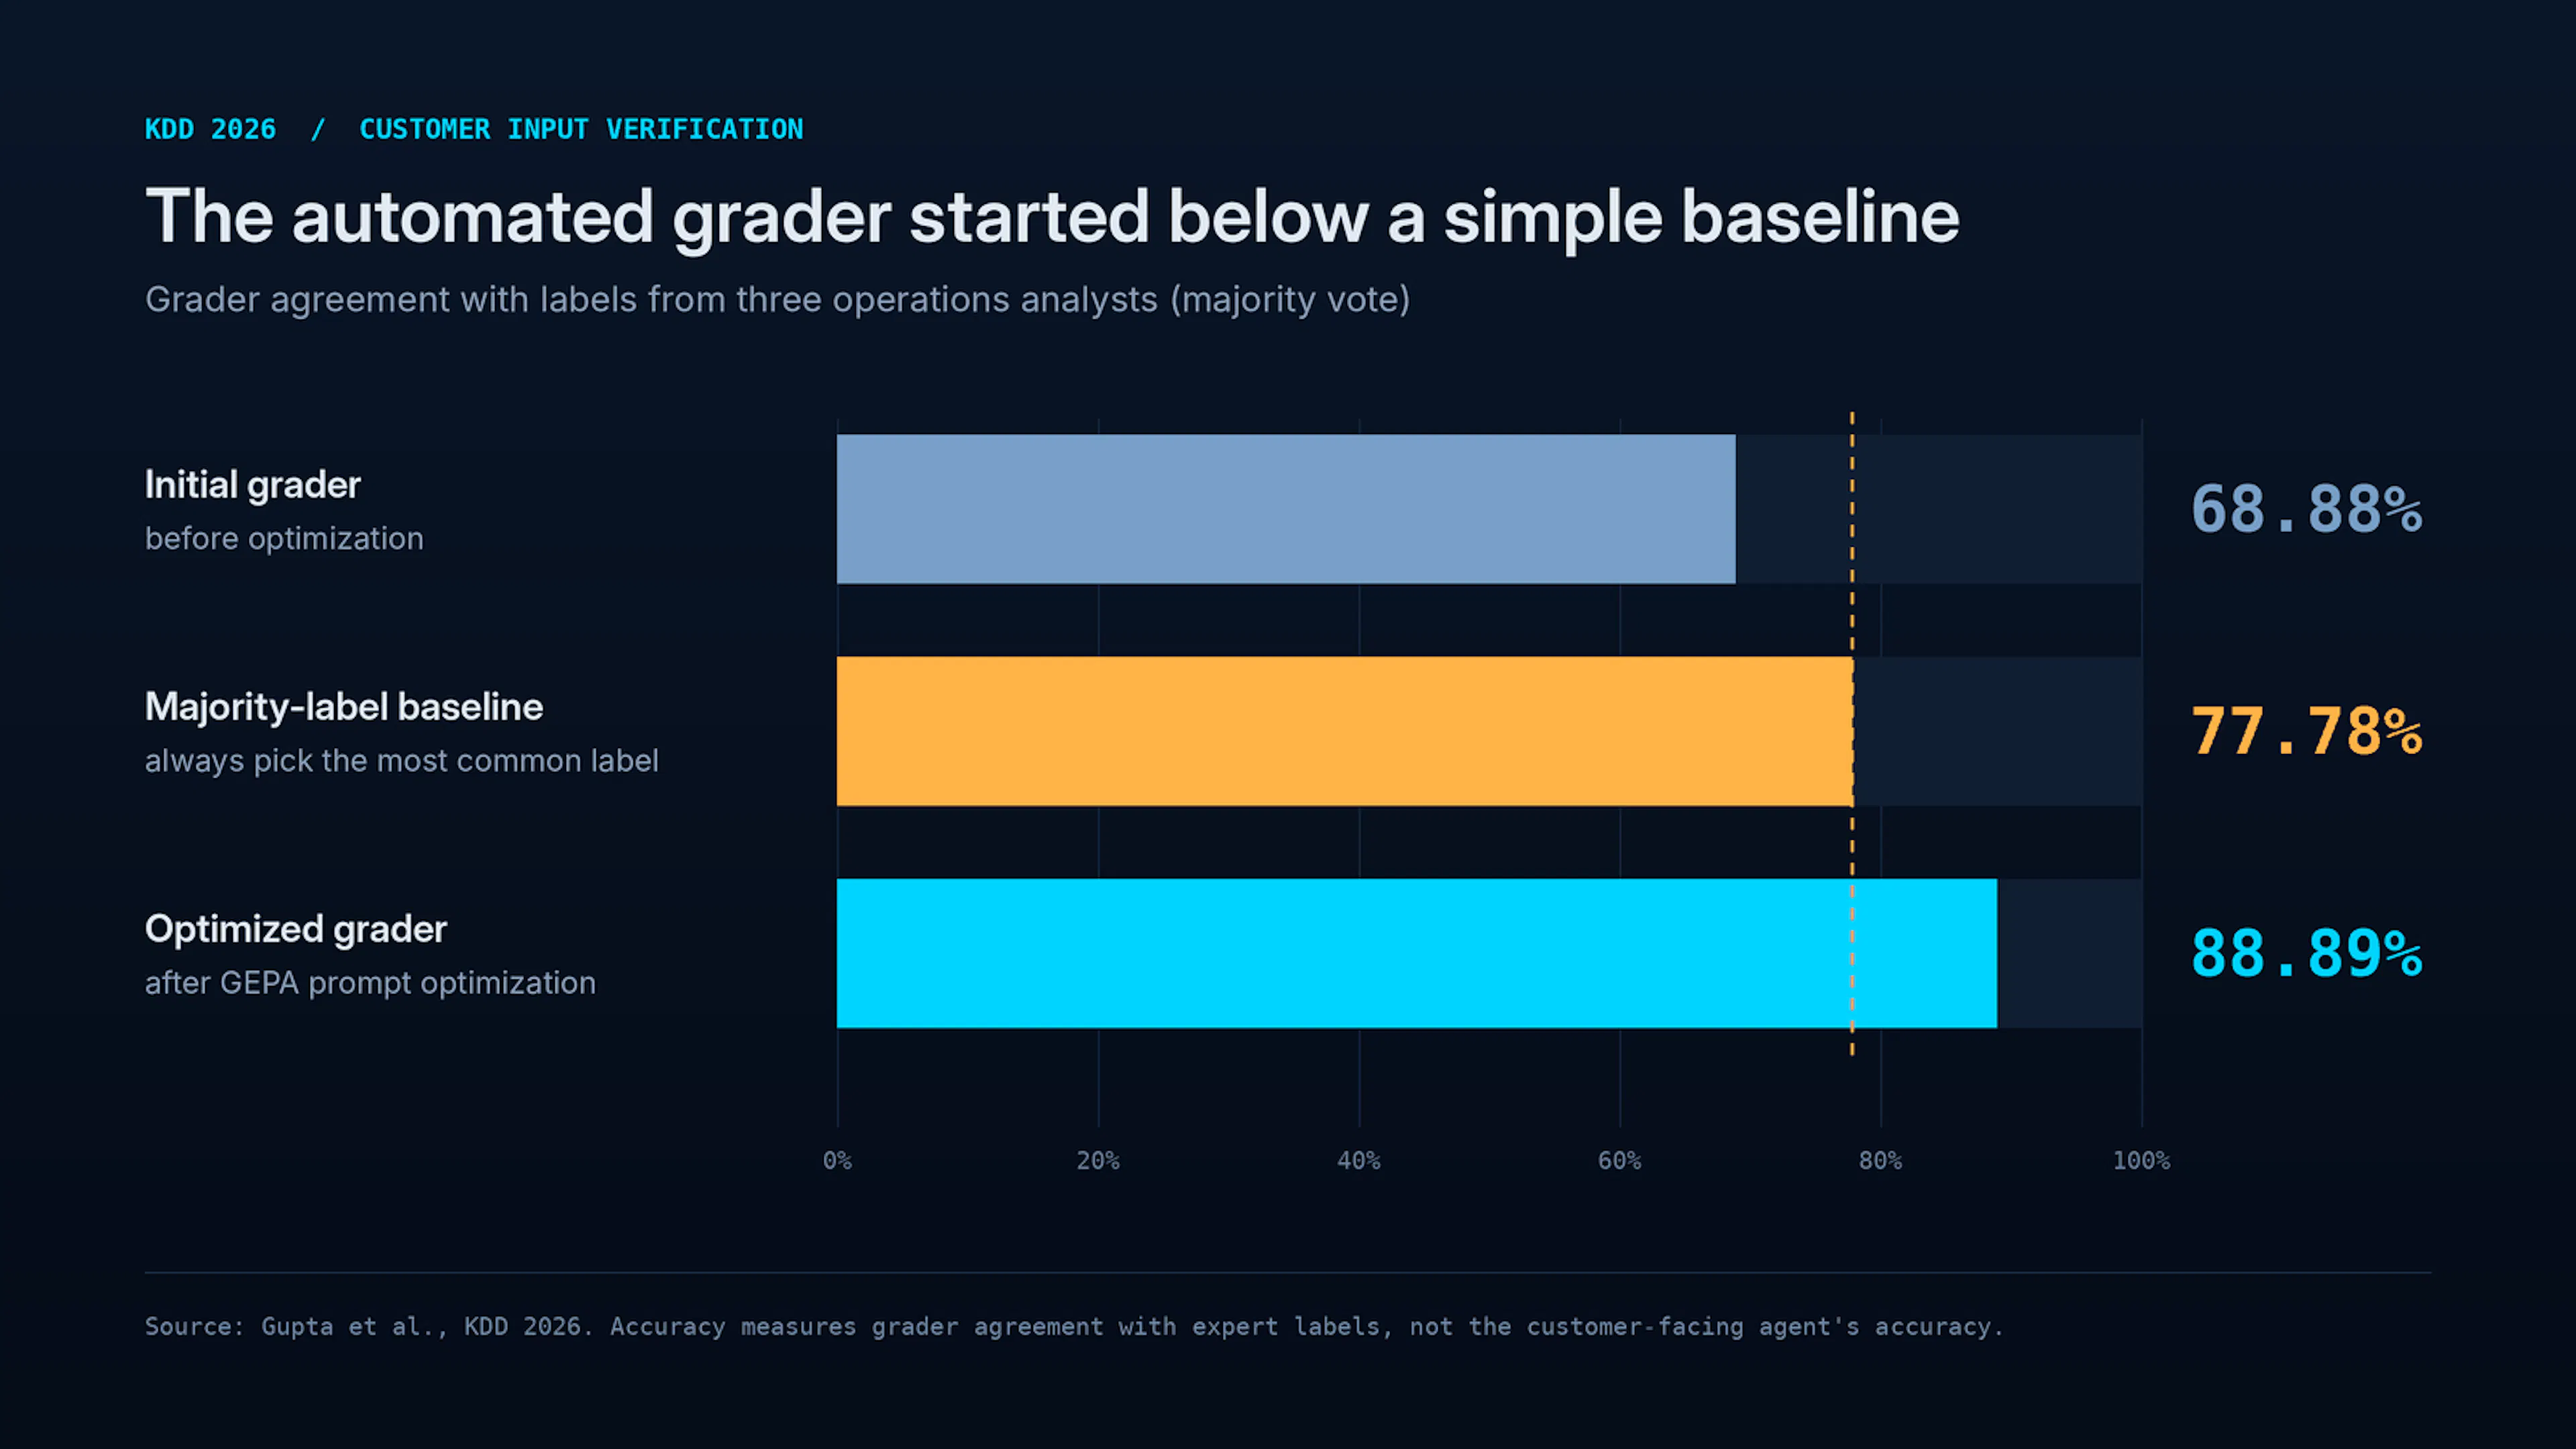
고객 입력 검증(customer input verification)의 경우, 초기 채점기는 68.88%의 정확도를 기록했습니다. 항상 가장 흔한 라벨을 선택하는 방식은 77.78%를 기록했을 것입니다. 최적화 과정을 거치자 정확도는 88.89%로 상승했으며, 이는 고객 대면 에이전트의 전반적인 정확도보다는 전문가 라벨과의 일치도를 측정합니다.
저자들은 또한 최적화 후 서로 다른 채점기 모델들이 동의하는지 여부도 테스트했습니다. 이 테스트는 한 공급업체(vendor)의 모델들을 다루었으며, 더 광범위한 모델 커버리지는 향후 작업에 남겨두었습니다.
새로운 에이전트 버전은 1%에서 5%의 노출률로 시작함
오프라인 검사(Offline checks)를 통해 팀은 고객에게 노출하기 전에 목표로 하는 수정 사항들을 테스트할 수 있습니다. 이후 라이브 지표(Live metrics)는 이러한 검사에서 놓친 문제점들, 여기에는 에스컬레이션 패턴(escalation patterns)의 변화가 포함됩니다. 새로운 버전들은 1%에서 5%의 노출률로 시작하며, 팀은 셀프 서비스율(self-service), tNPS, 에스컬레이션 건수, 오류 등을 추적합니다.
은행의 에이전트는 요청이 루틴 범위를 벗어나거나, 필요한 데이터를 검색할 수 없거나, 또는 신뢰도가 낮은 경우 대화를 사람에게 인계합니다. 저자들에 따르면, 이 에이전트들은 기존 정책과 인간의 감독 하에 운영되며, 신용이나 부채 관리에 대한 무제한적이거나 되돌릴 수 없는 결정을 내리지 않습니다.
일부 인계 과정은 에이전트에게 정의된 작업을 완료할 수 있는 도구를 제공함으로써 제거될 수 있습니다. 카드 배송(card-delivery) 환경에서, 카드 재발급 기능(card-reissue capability)을 추가한 것은 가장 일반적인 해결 경로에서의 인간 인계 필요성을 없앴습니다. 다른 인계 과정들은 운영 설계의 일부로 남아있습니다.
인간 인계는 AI 성능 지표의 의미를 변화시킨다
자동화가 작동하고 있음에도 불구하고 평균 처리 시간(Average Handle Time)은 상승할 수 있습니다. 만약 AI가 더 간단한 요청을 해결한다면, 인간 팀은 시간이 더 오래 걸리는 더 어려운 사례들을 맡게 됩니다.
고객 경험 혁신 파트너인 TELUS Digital은 10월 6일 발표에서 이 점을 지적했습니다. TELUS Digital의 CX AI, 비즈니스 및 배송 글로벌 부사장(Global Vice President of CX AI, Business & Delivery) 에린 워커(Erin Walker)는 “AI가 상담원에게 속도를 늦추는 고객 상호작용 부분을 맡아, 상담원이 판단력을 가장 필요한 곳에 집중할 수 있도록 해야 한다”고 말했습니다.
회사 프레임워크는...
더 높은 만족도 점수는 더 어려운 사례를 사람에게 보내고 더 간단한 요청은 AI에게 남김으로써 얻을 수 있습니다. 따라서 프로덕션 환경에서 에이전트형 AI(agentic AI)를 평가한다는 것은 왜 사례가 격상되었는지 검토하는 것을 의미합니다. 도구의 부재와 인간 판단에 맡겨진 결정은 서로 다른 응답을 요구합니다. 만족도 점수만으로는 에이전트가 개선되었는지, 아니면 작업 부하(workload)가 이동했는지를 보여줄 수 없습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Hacker Noon AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기