
하이브리드 상태 공간 모델(Hybrid State-Space Models)이 기존 Transformer 아키텍처에 던지는 도전
요약
본 글은 순수 Transformer 아키텍처의 이차 스케일링(Quadratic scaling) 문제를 지적하며, 리소스가 제한된 환경에서의 한계를 논합니다. 해결책으로 State-space models (SSMs)와 선택적 어텐션 블록을 결합한 하이브리드 모델을 제시합니다. 이 아키텍처는 상수 메모리 처리량과 정확한 연관 기억력을 동시에 확보하는 것이 핵심 목표입니다.
핵심 포인트
- 순수 Transformer의 이차 시간 복잡도는 장기 스트림 및 로컬 에이전트 배포에 구조적 제약을 가합니다.
- SSM은 상태 벡터를 이용해 상수 메모리 푸트프린트와 선형 컴퓨팅 스케일링을 제공하여 효율성을 높입니다.
- 하이브리드 레이아웃은 SSM의 처리량과 어텐션의 정밀한 조회 능력을 결합하는 최적의 방안입니다.
- 이러한 아키텍처 변화는 모델 배포 시 GPU 청구서 부담을 줄이고 로컬 실행 가능성을 높이는 데 기여합니다.
들어보세요. 저는 사람들이 순수 Transformer 아키텍처가 원래 설계되지 않은 작업을 수행하려고 클라우드 컴퓨팅 예산을 낭비하는 것을 보는 것에 진심으로 지쳤습니다. 누군가가 새로운 백만 토큰 컨텍스트 창을 주장하는 논문을 발표할 때마다, 그들은 여러분의 KV cache가 빌드 실패 시 저의 인내심보다 더 빠르게 확장된다는 사실을 편리하게 간과합니다. 이차적 스케일링(Quadratic scaling)은 단순한 수학적 불편함이 아닙니다. 그것은 모든 추론 사이클에 가해지는 구조적인 세금입니다. 만약 여러분이 리소스가 제한된 하드웨어에서 에이전트를 배포하거나, RAM이 타버리지 않게 지속적인 고주파 스트림을 처리하려고 한다면, 순수 어텐션(pure attention)은 막다른 길입니다.
2026년의 현실 점검에 들어갑니다. State-space models와 하이브리드 믹서가 공식적으로 과장된 사이클(hype cycle)을 지나 프로덕션 단계로 진입했습니다. 최고 수준부터 최하위까지의 연구소들은 선형 시간 재귀 레이어(linear-time recurrent layers)와 선택적 어텐션 블록(selective attention blocks)의 균형 잡힌 비율이 처리량과 연관 기억력 사이의 황금 지점을 건드렸다는 것을 깨달았습니다. 여러분은 어텐션이 실제로 잘하는 정밀한 조회 능력(precise lookup capabilities)을 잃지 않으면서, 상수 메모리 푸트프린트와 선형 컴퓨팅 스케일링을 얻게 됩니다. 이것은 로켓 과학이 아니지만, 최소한 3년 전에 작성된 튜토리얼에서 같은 표준 Transformer 블록을 복사-붙여넣기 하는 것을 멈추는 것은 필요합니다.
본 글에서는 선택적 게이팅(selective gating)과 계층적 재귀(hierarchical recurrence)가 실제로 내부적으로 어떻게 작동하는지 분석할 것입니다. 아무런 포장된 마케팅 허풍도, 학계의 문지기 역할도, 그리고 기업 로봇 같은 말은 전혀 없습니다. 오직 순수한 아키텍처 선택, 뇌를 녹이지 않는 수학 공식, 그리고 여러분이 GPU 청구서를 내기 위해 모기지를 필요로 하지 않고 실제로 로컬에서 실행할 수 있는 깔끔한 Python 코드가 전부입니다. RAM이 완전히 포기하기 전에 믹서 메커니즘을 깊이 파헤쳐 봅시다.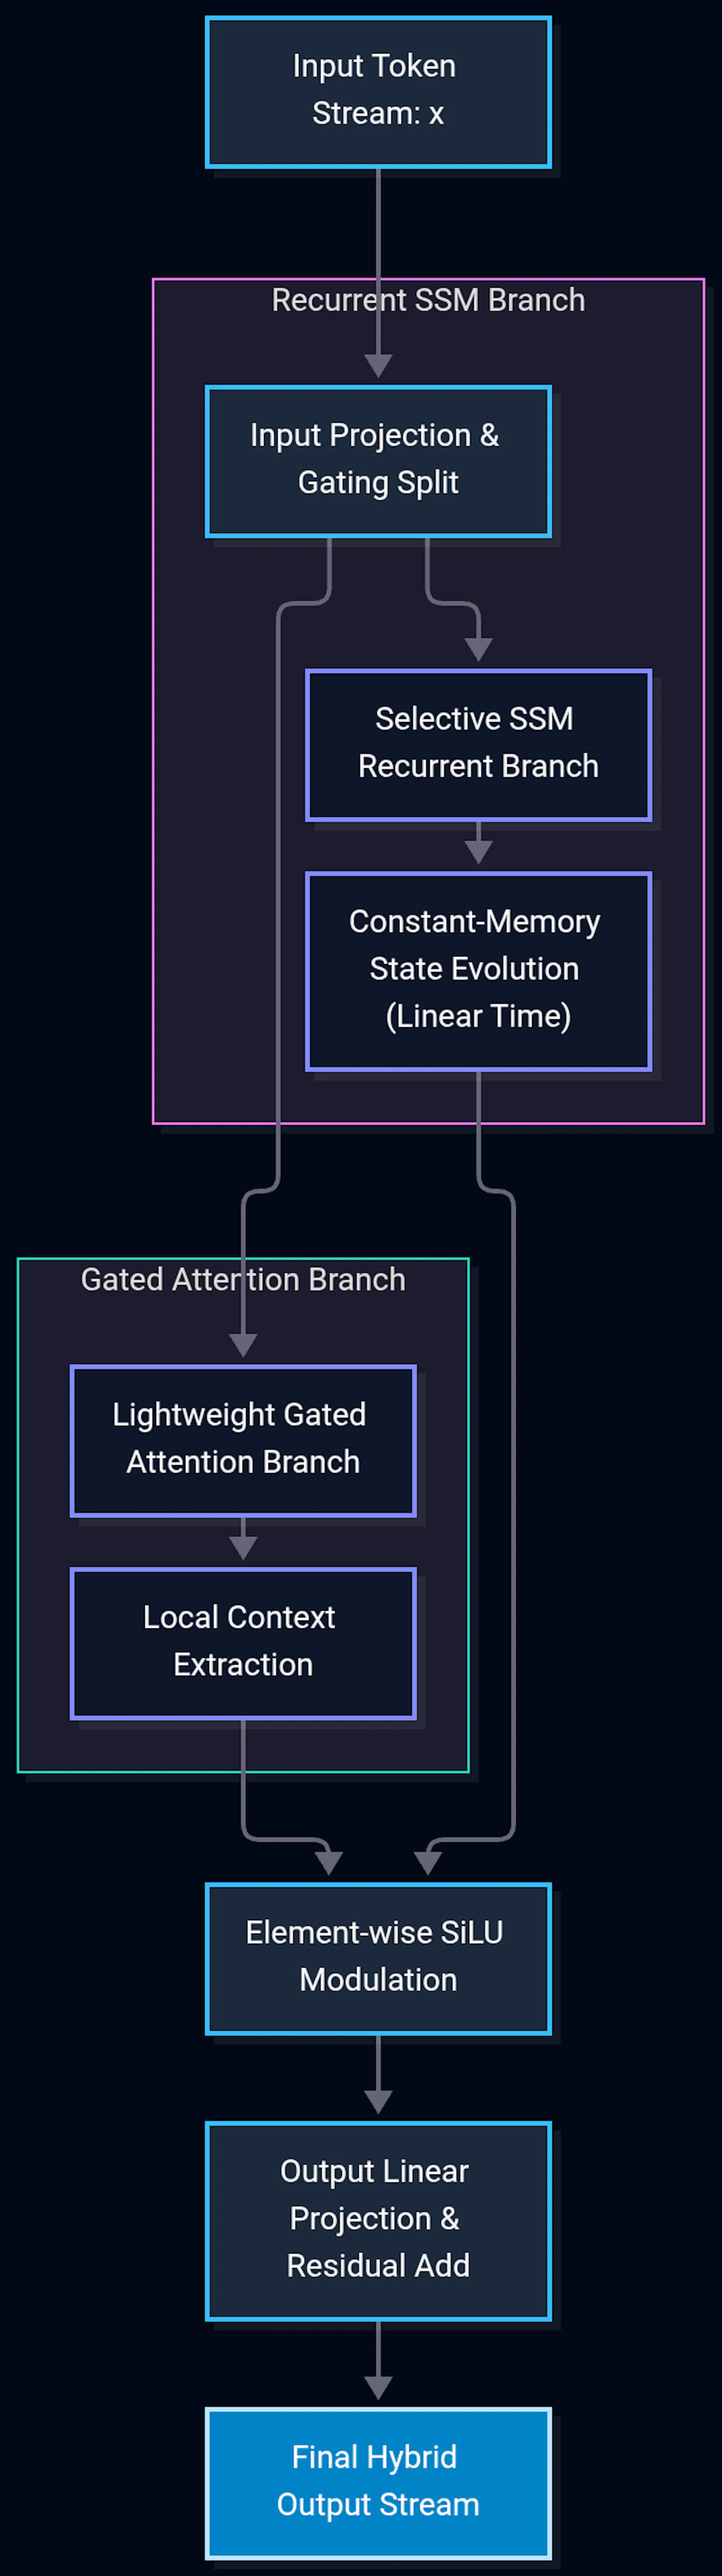
표준 어텐션 메커니즘의 근본적인 결함은 새로운 토큰이 이전에 온 모든 것을 되돌아봐야 한다는 것입니다. 이것은 데이터 센터에 배치된 엔터프라이즈 GPU 클러스터가 있을 때는 훌륭하게 작동하지만, 자율 에이전트를 로컬에서 실행하거나 장기 지평(long-horizon) 스트림으로 확장하려고 하는 순간, 이차 시간 복잡도(quadratic time complexity)가 당신을 괴롭히게 됩니다. SSM은 시간 역학(temporal dynamics)을 고정 크기 상태 벡터(fixed-size state vector)로 압축함으로써 판도를 바꿉니다.
import torch
import torch.nn as nn
import torch.nn.functional as F
...
물론, 순수 SSM은 역사적으로 악명 높은 '재현율 격차(recall gap)'를 겪었습니다. 이는 시퀀스 깊숙이 묻힌 정확한 문자 그대로의 토큰을 잊어버리는 현상입니다. 이것이 바로 현대 아키텍처가 하이브리드 레이아웃으로 기울는 정확한 이유입니다. 어텐션 레이어의 일부를 순환형 SSM 믹서(recurrent SSM mixers)와 교차 배치함으로써, 두 가지 장점을 모두 얻을 수 있습니다. 즉, 긴 컨텍스트에 대한 상수 메모리 처리량(constant-memory throughput)과 실제로 중요한 곳에서의 날카로운 연관 기억력(sharp associative recall)입니다. 트랜스포머를 당신의 공구 상자 속 유일한 망치로 취급하는 것을 멈추고, 하드웨어 한계를 존중하는 아키텍처를 구축하기 시작하십시오.
AI 자동 생성 콘텐츠
본 콘텐츠는 Hacker Noon AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기