요약
Project Zero는 Google이 Chrome의 자바스크립트 엔진인 V8에서 취약점을 정기적으로 찾기 위해 사용하는 두 가지 자동화 도구를 비교했습니다. Fuzzilli는 생성형(generative) 자바스크립트 엔진 퍼저이며, BigSleep은 LLM 기반 버그 탐지 시스템입니다. 지난 6개월 동안 BigSleep이 Fuzzilli보다 더 많은 취약점(45개 대 37개)을 발견했으며, 보고된 특정 버그 간에는 25%의 중복률을 보였습니다. 이 비교 방법론은 중복률을 과소평가하는 경향이 있으므로, 저희는 2023년 이후 보고된 취약점의 이론적 중복률을 테스트하기 위한 전용 실험도 수행했습니다. 이 실험들은 중복률을 약 60%로 추정했습니다. 어떤 수치가 정확하든 관계없이, 상당 부분의 취약점은 LLM만으로 또는 퍼징(fuzzing)만으로 발견될 수 있었습니다. LLM이 이렇게 많은 취약점을 빠르게 찾아낼 수 있게 되었다는 점은 매우 유망하지만, 퍼징과 LLM은 여전히 상호 보완적인 접근 방식입니다. 따라서 저희는 벤더들이 사용자에게 영향을 미치기 전에 보고되는 취약점의 수를 극대화하기 위해 코드에 대한 퍼징과 에이전트 분석(agentic analysis)을 모두 수행할 것을 권장합니다.
서론
퍼징은 오랫동안 Chrome이나 V8(Chrome의 자바스크립트 엔진)와 같은 소프트웨어 프로젝트에서 버그를 탐지하는 데 성공적으로 적용되어 왔습니다. 최근 코드를 읽고, 추론하며, 작성할 수 있는 강력한 LLM의 등장은 소프트웨어 개발과 소프트웨어 보안에 혁신적인 변화를 가져오고 있습니다. 잘 퍼징된(well-fuzzed) 대상에서 수백 개, 때로는 수천 개의 새로운 버그와 취약점이 발견되면서 자연스러운 질문이 제기됩니다: 새로운 LLM은 '전통적인' 퍼저와 어떻게 비교되는가? 이들이 기존의 도구를 대체하기 시작하는 것일까요, 아니면 두 접근 방식이 서로를 보완하는 것일까요? 이에 답하기 위해 저희는 세 가지 핵심 질문을 살펴봅니다:
- 각 접근 방식은 실제 환경에서 몇 개의 버그를 발견하는가?
- 두 접근 방식 간의 중복률은 어떠한가?
- 한 시스템이 발견했지만 다른 시스템이 발견하지 못한 '독특한' 버그의 형태는 무엇인가?
본 블로그 게시물에서는 두 가지 구체적인 시스템, 즉 자바스크립트 엔진 퍼저인 Fuzzilli와 에이전트 기반 버그 탐지 시스템인 BigSleep에 초점을 맞출 것입니다. 이 두 시스템 모두 운영 환경에서 실행되며 새로 추가된 코드의 버그를 자동으로 찾기 때문에 상당히 직접적으로 비교할 수 있습니다. 구체적으로, Fuzzilli는 여러 인스턴스에 걸쳐 지속적으로 실행되며, 첫 번째 인스턴스는 보통 몇 시간 내에 새로운 변경 사항을 포착합니다. 반면 BigSleep은 현재 하루에 한 번 실행되며, 새로 커밋된 내용을 검토하고 발견한 버그에 대한 개념 증명(PoC) 테스트 케이스를 작성하도록 프롬프트가 제공됩니다. 두 시스템 모두 Clusterfuzz를 통해 버그를 보고하며, 이는 기본적인 충돌 분류(crash triaging)를 수행한 후 Chrome의 이슈 트래커에 버그 보고서를 제출합니다.
또한 우리는 고성능 자바스크립트 및 WebAssembly 엔진이며 정교하고 성숙한 테스트 및 퍼징 환경을 갖춘 V8만을 대상으로 제한합니다. 특히 Fuzzilli는 이러한 엔진에서 버그를 찾기 위해 설계된 특수 목적의 퍼징 도구입니다. 일반적으로 복잡성을 띠는 이러한 버그들은 두 접근 방식이 잘 테스트된 소프트웨어에서 깊고 복잡한 버그를 찾아내는 능력을 비교할 수 있는 흥미로운 “놀이터”를 제공합니다. 더 광범위한 대상, 퍼저, 그리고 에이전트 기반 버그 탐지 시스템에 대해 유사한 분석을 수행하는 것은 향후 연구 과제로 남겨둡니다.
이제 세 가지 주요 질문 각각에 대해 전용 섹션에서 살펴보겠습니다. 각 섹션은 먼저 일반적인 접근 방식을 요약하고, 그 다음 방법론을 자세히 설명하며(자세한 내용에 크게 관심이 없다면 이 블록들은 건너뛰셔도 됩니다), 마지막으로 결과를 탐구할 것입니다. 우리는 퍼징 대 AI의 현재 상태를 파악하기 위해 결과 해석 시도를 하며 마무리합니다.
Part 1: 운영 통계
이것은 분석하기 가장 간단한 부분이지만, 나중에 알게 될 몇 가지 주의사항(caveats)이 있습니다. 기본 아이디어는 Chromium의 버그 트래커(V8 버그가 추적되는 곳)에서 이슈를 조회하고 거기서 다양한 통계를 추출하는 것입니다. 각 시스템에 전용 목록(hotlist)이 있기 때문에 이는 특히 쉽습니다. 저희는 분석 범위를 2026년 4월부터 9월까지의 6개월로 제한했습니다. 자동 BigSleep 파이프라인은 올해 4월에야 활성화되었기 때문입니다. 따라서 원본 데이터는 다음 두 가지 버그 트래커 조회에서 가져왔습니다:
[데이터 출처 표]
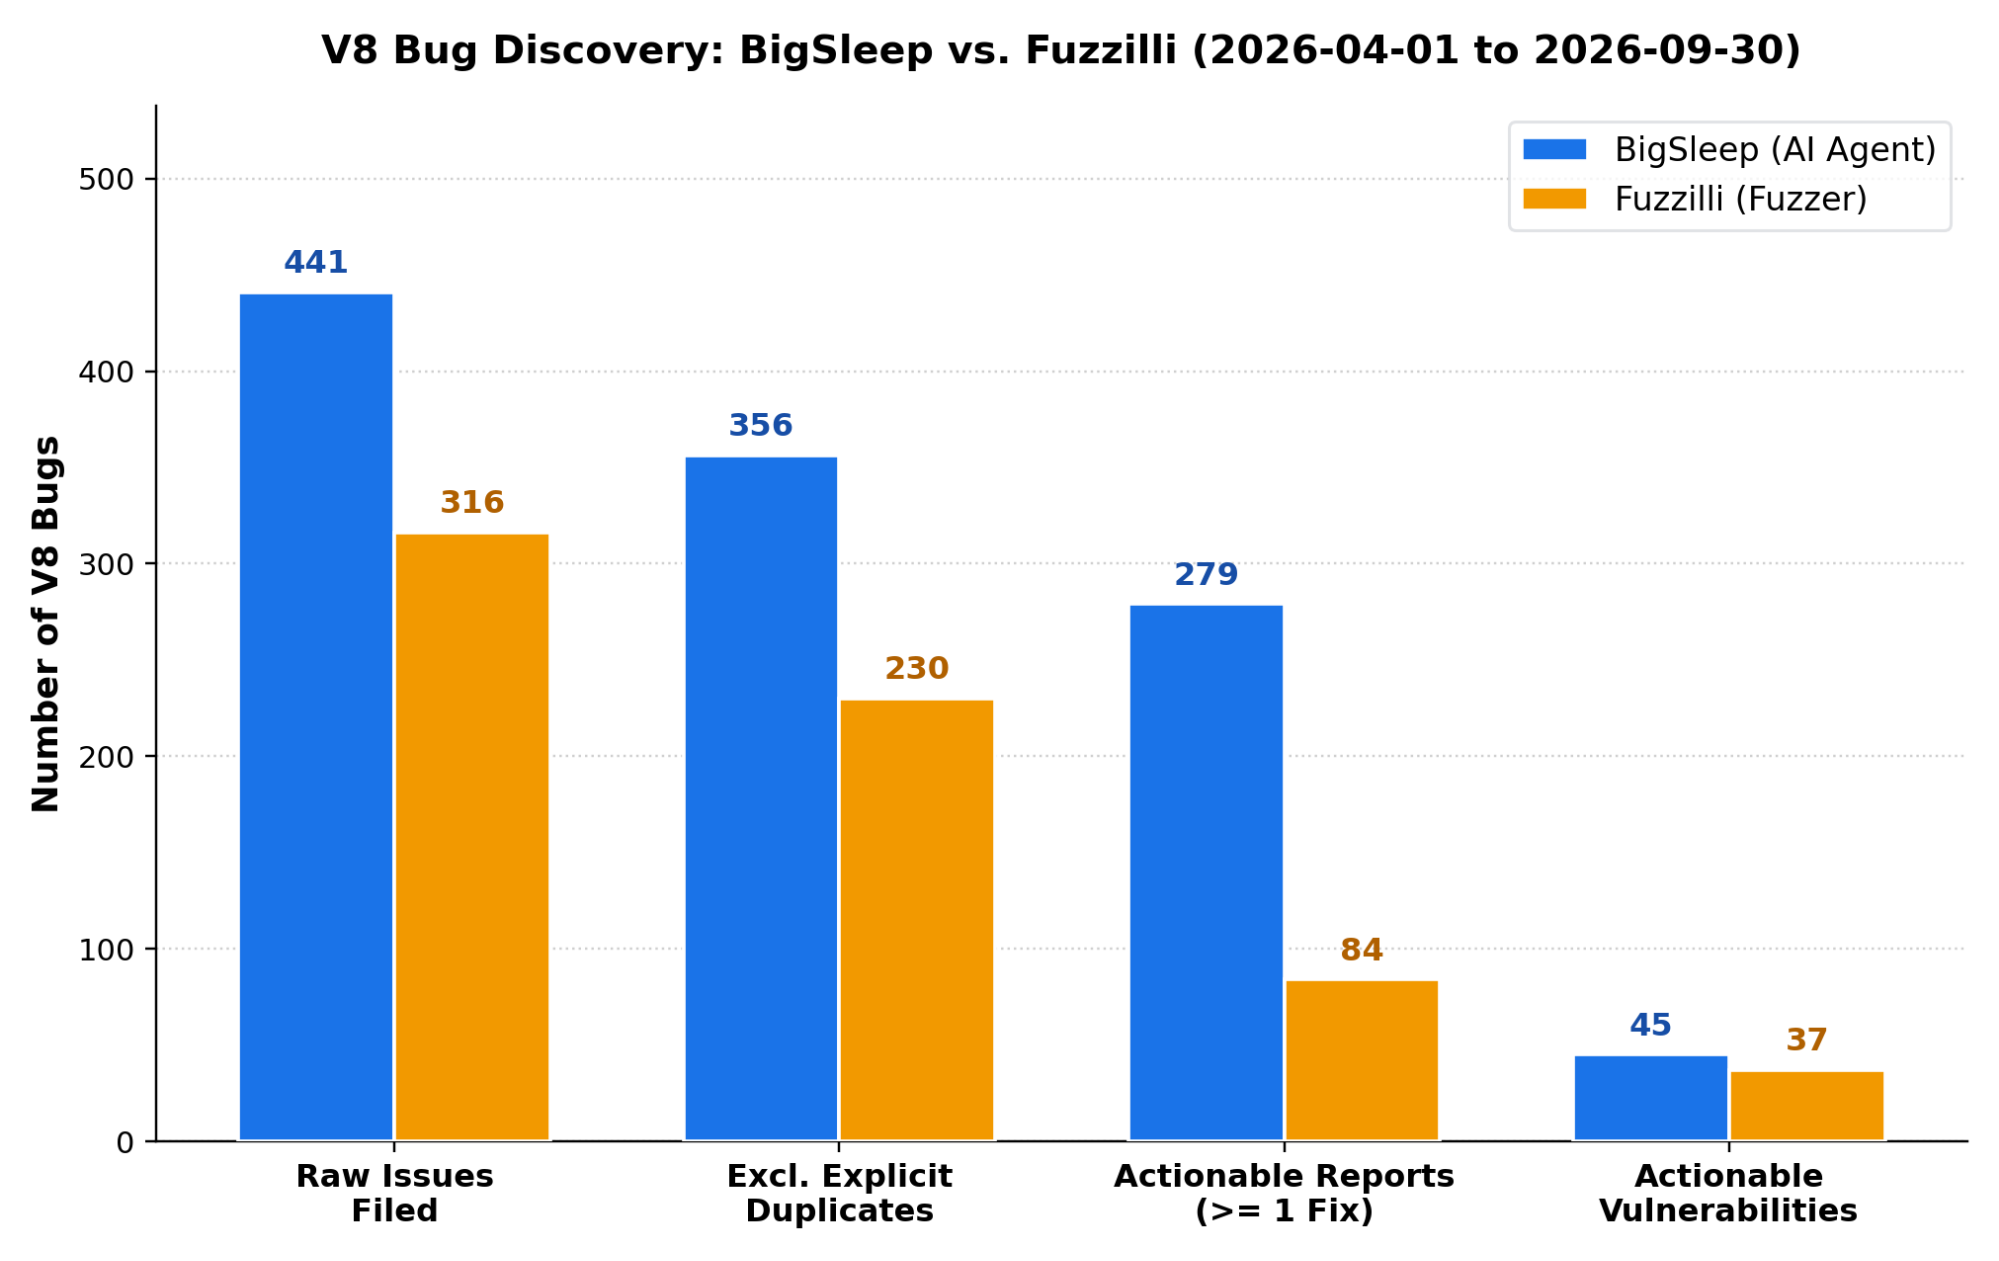
거기에 따르면, 버그 보고서의 원본 수치는 다음과 같습니다:
- Fuzzilli: 316
- BigSleep: 441
BigSleep이 약간 우세합니다. 하지만 여기에는 모든 유형의 버그가 포함되어 있으며, BigSleep은 초기에도 V8에서 많은 구성 및 통합 문제를 발견했습니다. 예를 들어 crbug.com/503869331 같은 곳에서는 안전 플래그 차단 메커니즘(unsafe flag blocking mechanism)이 아직 제대로 작동하지 않았습니다. 이것들은 합법적인 문제이지만, 실질적인 보안 영향도가 적기 때문에 우리의 비교에는 덜 관련성이 있습니다. 이러한 문제를 제거하는 쉬운 방법 중 하나는 결과를 type:vulnerability로 제한하여 취약점만 구체적으로 살펴보는 것입니다.
[취약점 전용 데이터]
- Fuzzilli: 178
- BigSleep: 95
갑자기 퍼저(fuzzer)들이 명확하게 우세한가요? 그렇지 않습니다. 여전히 중복되거나 조치할 수 없는 보고서들(예: WAI로 종결된 버그)과 같은 데이터상의 몇 가지 문제가 있습니다. 처음에는 이것을 수정하는 것이 간단해 보입니다. 단순히 status:(fixed | verified)와 같은 추가 제약 조건을 포함하면 됩니다.
하지만 아쉽게도 상황은 조금 더 복잡합니다. 예를 들어 Fuzzilli 버그 crbug.com/511935486을 살펴보겠습니다. 이 버그에 대한 이벤트는 기본적으로 다음과 같습니다:
- 해당 버그가 5월 11일에 Clusterfuzz에 의해 제기되었고 엔지니어에게 할당됨
- 같은 날 나중에 테스트 케이스가 더 이상 재현되지 않아 Clusterfuzz에 의해 해당 버그가 종결됨
이러한 이유로 이 버그는 개발자 상호작용 기록이 전혀 없었습니다. 가장 가능성이 높은 것은 이 버그가 다른 버그(crbug.com/511210507)의 중복이었지만, Clusterfuzz가 충돌 시그니처(스택 트레이스에서 파생됨)가 약간 다르다고 인식하지 못했다는 것입니다. 해당 버그에 수정 사항이 적용되자 테스트 케이스가 Clusterfuzz에서 재현되지 않아 이슈가 닫혔습니다.
우리가 할 수 있는 최선의 방법은 '조치 가능한(actionable)' 버그를 살펴보는 것일 수 있습니다. 이는 중복으로 표시되지 않았고 WAI로 지정되지 않았으며 그리고 최소한 하나의 수정 커밋이 참조된 버그를 의미합니다. 그런 다음, Type-Vuln만 살펴보면 이러한 버그들은 '조치 가능'했음에도 불구하고 관련성이 낮은 BigSleep 버그들을 많이 걸러냅니다. 그 결과 최종적인 그림은 다음과 같습니다:
따라서 취약점 측면에서 볼 때, 현재는 대략 동률이며 (BigSleep이 약간 우세) 45개 대 37개입니다.
이는 자연스럽게 비용에 대한 질문을 제기합니다. 두 접근 방식 각각은 얼마나 비싼지, 그리고 그것이 버그당 비용(cost-per-bug) 측면에서 무엇을 의미하는가? 불행하게도 연구의 이 단계에서는 비교하기 어렵습니다. Clusterfuzz를 더 효율적으로 만드는 데 노력이 기울여진 반면, BigSleep에는 유사한 노력이 투입되지 않았으며 두 시스템 모두 최적의 버그당 비용 비율에 맞춰져 있지는 않습니다.
파트 2: 중복성(Overlap)
다음 질문은 이 접근 방식들이 서로 얼마나 많이 겹치는가입니다. 이를 위해 저희는 두 가지 방식을 시도합니다. 첫째, 두 시스템 모두에서 발견된 버그를 식별하려고 노력하여 버그 트래커에서 답을 찾으려고 합니다. 다음으로, BigSleep이 오래된 Fuzzilli 버그들을 다시 발견하도록 하는 전용 실험을 실행합니다.
버그 트래커 중복성(Bugtracker Overlap)
기본 아이디어는 두 시스템 모두에 의해 발견된 버그가 무엇인지 확인하는 것이므로, 사실상 중복 버그 보고서를 찾는 것입니다. 파트 1과 유사하게, 어느 정도 정확한 그림을 얻으려면 몇 가지 단계를 거쳐야 합니다:
먼저, 한 시스템이 보고한 버그가 다른 시스템에 의해 중복 제거(deduplicated)되어 등록된 경우를 찾습니다. 예를 들어, crbug.com/522410841은 crbug.com/522860268의 중복입니다. 이는 명확한 중첩 영역입니다.
다음으로, 관련 수정 사항이 0개인 경우가 많은 ‘조치 불가능한(unactionable)’ 보고서들 중 상당수가 종종 중복이라는 점을 고려해야 합니다. 이러한 보고서들의 경우, 해당 버그를 수정한 커밋(commit)을 찾아보고, 그 커밋과 관련된 버그를 확인하여 이 두 버그를 중복으로 간주합니다. 이는 여러 경로의 관계일 수 있습니다: BigSleep에 의해 발견된 bug X와 Fuzzilli에 의해 발견된 bug Y가 다른 사람/무언가에 의해 보고된 bug Z의 중복일 수 있습니다. 이런 경우에도 해당 버그는 여전히 중첩 영역으로 계산됩니다.
그다음, 많은 중복 건이 Clusterfuzz 단계에서 이미 중복 제거되었기 때문에(Fuzzilli와 BigSleep 모두 기본적인 분류 및 버그 등록을 위해 Clusterfuzz에 의존하므로) 버그 추적기(bugtracker)에 항목으로 기록되지 않는다는 점을 인지해야 합니다. 따라서 더 많은 중복 건을 찾기 위해 Clusterfuzz의 기본 데이터베이스를 쿼리해야 합니다.
마지막으로, 동일한 CL(Change List)로 수정된 별개의 버그들을 어떻게 처리할지 결정해야 합니다. 예를 들어, crrev.com/c/7965120에 의해 수정된 네 개의 버그가 있습니다. 비록 이것이 개별적인 버그일 수 있지만, 중복일 가능성이 더 높다고 판단되므로(이 경우처럼), 저희는 이를 중복으로 계산합니다.
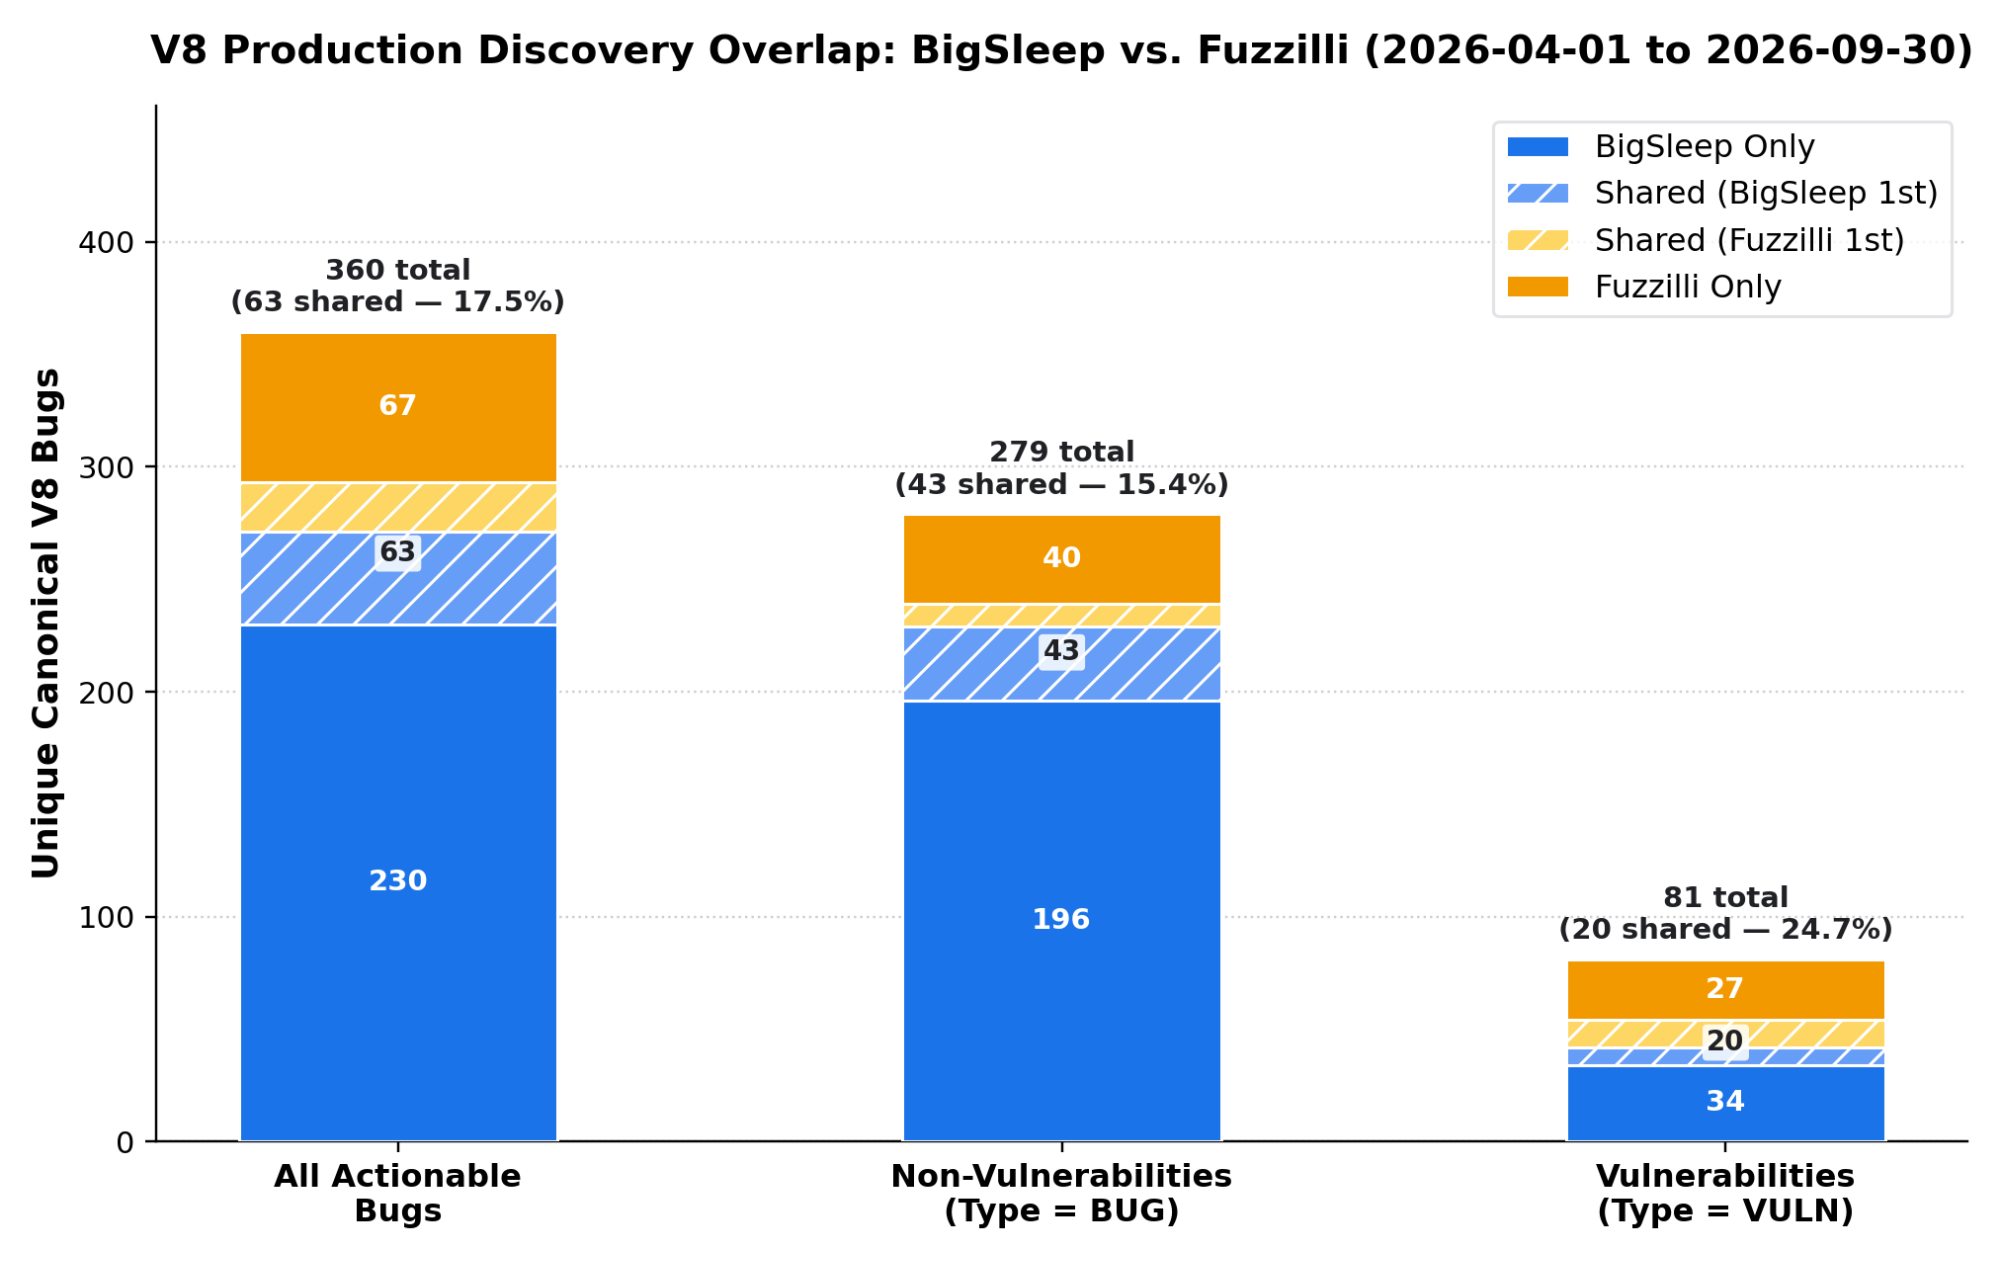
위와 같은 다양한 유형의 중복 제거 과정을 거쳐 최종 그림을 얻게 됩니다:
다시 한번, 오직 조치 가능한 취약점 보고서들(가장 신뢰할 수 있는 측정 기준일 가능성이 높음)만 살펴보면, 약 25%(총 81개 중 20개)의 중첩 영역이 확인되며, 이 중 약간의 다수가 Fuzzilli에 의해 먼저 발견되고 나중에 BigSleep에 의해 발견된 것으로 나타납니다.
Overlap Experiment
중첩 정도를 측정하는 두 번째 방법은 한 시스템이 과거에 발견한 버그를 다른 시스템을 사용하여 재발견하려는 전용 실험을 실행하는 것입니다. 구체적으로, 여기서는 가능한 한 프로덕션 구성(production configuration)과 유사한 BigSleep 설정을 사용하여 오래된 Fuzzilli 버그를 재발견하려고 시도합니다. 각 버그에 대해 해당 버그를 (아마도) 유발했을 것으로 추정되는 커밋을 수집하고, 에이전트에게 프로덕션 CI 환경(CI environment)에서와 동일하게 해당 변경 사항들을 검토하도록 요청합니다. 다른 방향, 즉 Fuzzilli를 사용하여 과거 BigSleep 버그를 재발견하는 것은 퍼저(fuzzer)가 유사한 “시작점(starting point)”을 쉽게 제공받기 어렵기 때문에 설정하기가 더 어렵다는 점에 유의해야 합니다. 게다가 이 버그들 중 다수에는 이미 이러한 실험의 결과가 알려져 있습니다. “역사적” BigSleep 버그(예: 2025년의 버그)의 대다수는 Fuzzilli와 같은 퍼저가 취약한 빌드를 몇 달, 때로는 몇 년 동안 퍼징(fuzzing)한 후에 발견되었습니다. 따라서 이들은 실험에서 재발견되지 않을 가능성이 가장 높습니다 (Fuzzilli가 새로운 언어 기능을 지원하도록 업데이트된 몇 가지 경우를 제외하고). 마찬가지로 프로덕션 환경에서는 BigSleep이 크래시를 1~2일의 지연 시간으로만 보고합니다 (현재 하루에 한 번 실행되기 때문입니다). 따라서 퍼저들 역시 그곳에서 선행적인 우위를 점하게 됩니다.
더 자세한 내용은 다음과 같이 실험이 설정되었습니다:
-
버그 추적기(bug tracker)의 인기 목록을 쿼리하여 역사적인 Fuzzilli 버그 목록(2023년 초부터 2026년 중반까지)으로 시작합니다. 이를 통해 약 1,150개의 원시 버그를 얻습니다.
-
이 목록을 type:vulnerability로만 제한합니다. 이는 우리가 가장 중요하게 생각하는 버그 유형이며 위에서 언급된 “노이즈”를 제거할 것입니다. 결과적으로 약 600개의 취약점(vulnerabilities)이 남게 됩니다.
-
다음으로, 이 목록을 에이전트가 사용하는 환경에서 재현되는 버그로 필터링합니다. 여기에는 두 가지 부분이 포함됩니다:
크롬의 공개 빌드 인프라에서 제공하는 d8 셸의 x64 디버그+asan 빌드에서 재현되는 버그들입니다. 이는 많은 버그가 특수한 빌드 환경(예: 아키텍처별이거나 특정 컴파일 시간 기능이 필요한 경우)에서만 재현되기 때문에 중요합니다.
특수 플래그 없이도 재현 가능한 버그들입니다. 여기서 문제는 퍼저(fuzzer)들이 종종 커스텀 플래그를 설정한다는 것입니다. 이는 개발 중인 기능을 활성화하기 위함일 수도 있고(예: crbug.com/361123483의 --experimental-wasm-jspi), 특정 유형의 버그 발견을 용이하게 하는 다른 퍼징 모드를 켜기 위함일 수도 있습니다(예: crbug.com/362784006의 --deopt-every-n-times). 하지만 우리는 에이전트가 역사적인 V8 빌드에 임의의 플래그를 설정하도록 할 수 없습니다. 왜냐하면 이 빌드들은 “안전한 플래그 전용(safe-flags only)” 모드를 지원하지 않아 많은 오탐지 크래시(false-positive crashes)를 유발할 수 있기 때문이며, 또한 주어진 과제에 어떤 플래그를 사용해야 하는지 에이전트에게 알려주는 것은 힌트가 될 것이므로 원치 않기 때문입니다. 따라서 단순성을 위해 우리는 표준 플래그 세트(--fuzzing, --jit-fuzzing, --expose-gc)로 재현 가능한 버그로 제한하고, 에이전트가 이들만 설정하도록 허용합니다.
결과적으로 132개의 역사적 버그를 얻게 되었습니다.
이제 우리는 위에서 수행했던 것과 유사하게 일부 중복 제거(deduplication) 작업을 수행하여 암묵적인 중복을 식별하고 이를 제거했습니다. 이 과정을 거쳐 최종적으로 112개의 버그가 남았습니다.
현실적인 비교를 위해, 우리는 이 버그들을 실제 BigSleep 파이프라인에서 사용되는 것과 유사한 “코드 리뷰 과제(code review challenges)”로 변환합니다. 이를 위해 bisection(이분 탐색) 등을 기반으로 해당 버그를 유발했을 가능성이 있는 커밋을 식별하려고 시도합니다. 우리는 이 과정이 BigSleep과의 비교에 두 가지 이유로 편향을 가져온다는 점을 지적합니다:
우리는 때때로 문제의 버그와 관련 없는 잘못된 커밋을 식별할 수 있으며, 이는 과제를 더 어렵거나 심지어 불가능하게 만듭니다.