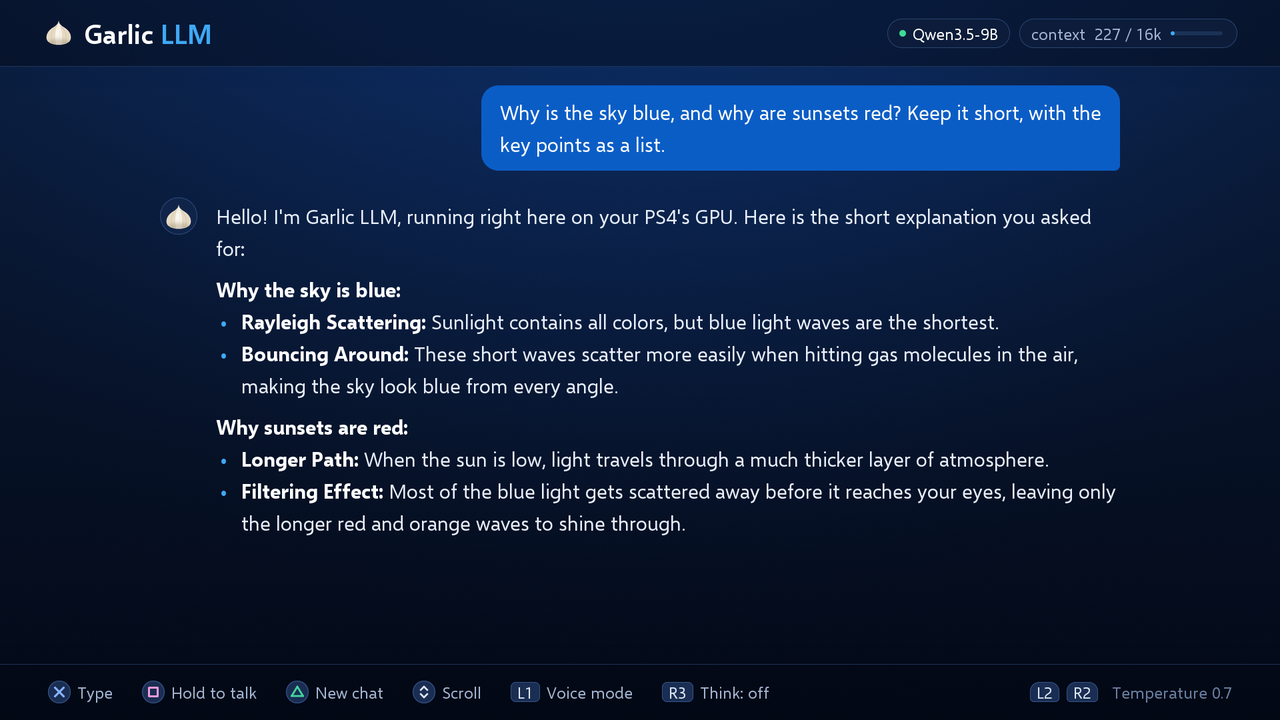
Leonardo Alegría 개발자의 오픈 소스 프로젝트인 Garlic LLM은 탈옥된 PS4가 콘솔의 2013년형 GPU를 이용해 90억 매개변수(parameter)를 가진 Qwen3.5-9B AI 모델을 오프라인으로 구동할 수 있게 합니다. 이 앱은 GPU와 직접 통신하며, 모델은 콘솔 메모리에 맞게 약 4.5GiB로 축소되어 초당 31~39 토큰(tokens)으로 작동합니다.
이 프로젝트는 GPU가 직접 읽는 메모리 이름에서 따왔으며, 그 형제 메모리는 “Onion”입니다. 이 시스템은 해킹된 콘솔을 위한 홈브루 활성화 도구인 GoldHEN이 설치된 PS4를 기반으로 합니다. Garlic LLM은 Hugging Face에서 이용 가능한 무료 단일 다운로드 파일(5.66GB)이며, PS4의 패키지 설치기(Package Installer)를 통해 설치할 수 있습니다. 작동을 위해서는 약 6GB의 여유 공간이 필요하며, 만약 패키지를 먼저 콘솔 내부 디스크로 복사할 경우 12GB가 필요합니다. 개발자는 펌웨어 11.52 버전의 베이스/슬림 PS4에서 테스트했습니다.
Garlic LLM chat screen on a PS4 showing a bulleted answer on why the sky is blue and sunsets are red
(이미지 출처: Leonardo Alegría/Garlic LLM)
이 시스템은 Chatterbox 음성 모델을 통해 7개 언어로 음성 응답이 가능한 음성 대화 기능도 갖추고 있으며, 이 채팅 모델은 초당 약 22 토큰으로 작동합니다. 또한, 컨트롤러 버튼을 누르고 있는 동안에는 Nvidia의 Parakeet TDT 0.6B v3 음성-텍스트 변환(speech-to-text) 모델을 이용해 받아쓰기(dictation) 기능도 사용할 수 있으며, 이 모델은 유럽 언어 25개국을 지원합니다. Parakeet 모델은 Meetily나 Hex와 같은 로컬 전사 및 받아쓰기 앱에도 동력을 공급합니다. 주력 모델은 Alibaba의 소형 오픈 웨이트(open-weight) Qwen3.5-9B이며, 이는 텍스트 채팅에서 주장된 초당 31~39 토큰으로 콘솔에서 사용 가능합니다 (프롬프트 및 테스트 방법은 제공되지 않음).
가장 근접한 비교 대상은 PS5LM fork입니다. 이 버전은 llama.cpp를 PS5의 네이티브 앱으로 구동하며, RADV 드라이버 포트인 PS5_Vulkan을 통해 콘솔의 AMD GPU에 접근합니다. 오픈 소스 프로그램인 llama.cpp는 언어 모델(language models)을 로컬에서 실행하는 데 널리 사용되는 프로그램이며, RADV는 AMD GPU가 그래픽 및 컴퓨팅 API인 Vulkan을 구동할 수 있게 해주는 오픈 소스 드라이버입니다. PS4에는 홈브루(homebrew)를 위한 이러한 종류의 드라이버 계층이 없습니다. Garlic LLM은 llama.cpp나 Vulkan 포트를 사용하지 않는 것으로 보입니다.
모델의 연산, 예를 들어 4비트 가중치에 대한 행렬 곱셈(matrix multiplies)은 OpenCL C로 작성된 컴퓨트 커널이며 AMD의 Graphics Core Next (GCN) 아키텍처를 위해 LLVM으로 컴파일됩니다. 가중치는 'Garlic' 메모리에 유지되는 동안, CPU 측에서는 순수 C 언어로 토크나이저(tokenizer), 인터페이스, 텍스트 렌더링 및 오디오 처리를 담당합니다. 파이프라인은 프롬프트에서 CPU 토크나이저로 실행된 후, 각 토큰마다 PM4 명령어 버퍼(명령어 버퍼는 그래픽 드라이버가 일반적으로 생성하는 저수준 명령어로, 여기서는 앱 스스로 구축함)와 GCN 커널을 거쳐 토큰이 표시되거나 음성으로 출력됩니다. 이 모든 과정은 오픈 소스 OpenOrbis PS4 툴체인(toolchain)으로 구축되었습니다.
당장 궁금한 점은 CPU와 GPU가 공유하는 콘솔의 8GB 메모리에 어떻게 90억 개의 매개변수(parameter) 모델을 담아낼 수 있느냐는 것입니다. 가중치당 8비트라면 매개변수 하나당 1바이트가 필요하므로 최소 9GB가 필요하며, 일반적으로 전체적으로 그 이상이 요구됩니다. 답변의 일부는 4비트(
이 조합을 사용하면 약 4.5GiB가 되며, 만약 모두 4비트였다면 약 4.9GiB가 될 것입니다. 어텐션(attention), 또는 KV 캐시도 4비트이며, 이는 모델의 네이티브 256K와 비교하여 16K 토큰 컨텍스트를 수용할 수 있게 합니다. Parakeet 받아쓰기 모델은 0.33GiB를 추가하고 Chatterbox 음성 모델은 각각 0.29GiB와 0.09GiB를 더해, 총합 5.23GiB(또는 5.62GB)가 되며, 이는 패키지 크기인 5.66GB에 근접합니다.
다음 질문은 성능입니다. Qwen3.5는 다중 토큰 예측(Multi-Token Prediction, MTP) 헤드를 갖추고 있으며, Garlic LLM은 이를 사용하여 최대 두 개의 토큰을 미리 작성하고 전체 모델이 검증합니다. 이는 모델이 훈련된 방식과 일치하며, Alibaba의 모델 카드에 있는 vLLM 지침은 두 개의 추측 토큰(speculative tokens)을 사용합니다. 이 프로젝트는 이를 통해 2013년 하드웨어에서도 채팅 속도를 높였다고 평가합니다.
이 설정으로 코드를 생성할 때도 최대 초당 43 토큰으로 더 빠르게 나옵니다. 또한 기본 온도(default temperature), 즉 모델 가변성(model variability)이 0.7로 상세하게 설명되어 있습니다. Alibaba는 사고 기능(thinking)을 끄고 일반 작업을 할 때는 0.7, 켜고 할 때는 1.0을 권장하지만, 데모 비디오에서는 0을 사용했기 때문에 예측 가능합니다. 보고된 성능 범위의 중간인 초당 35 토큰 속도에서는 300토큰 답변이 9초 미만으로 완료됩니다. 비교하자면, PS5는 세 배 더 큰 Qwen3.8-27B를 약 초당 20 토큰으로 실행했으며, 더 작은 Gemma 4 E4B와 Llama 3.2 3B는 각각 61 및 124로, 잠재적으로 더 빠릅니다.
PS4 Pro는 "아직 테스트되지 않았습니다"가 명시되어 있지만, 개발자는 GitHub에서 사용자 보고서를 요청하고 있습니다. 이 앱은 PS4의 GPU 및 시스템 소프트웨어에 맞춰 특별히 작성되었기 때문에 PS5에서는 지원되지 않습니다. 앱 자체에는 익스플로잇(exploit)이 포함되어 있지 않지만, GoldHEN 설치는 사용자의 책임 하에 이루어집니다.