임베딩(Embeddings)의 다양한 역할과 이해
요약
본 글은 현대 AI 시스템에서 임베딩이 수행하는 다양한 역할을 심층적으로 분석하고, 토큰/컨텍스트/문서 임베딩의 차이를 설명합니다. 특히 단순한 벡터 크기 이상의 의미론적 속성을 갖추려면 대조 학습과 같은 정교한 훈련 전략이 필수적임을 강조하며, RAG 시스템 구현 시 고려해야 할 기술적 세부 사항들을 정리했습니다.
핵심 포인트
- 임베딩은 단순히 차원만 큰 것이 아니라 특정 목적을 위해 학습된 유용한 기하학이다.
- 토큰 임베딩, 컨텍스트 임베딩, 문서 임베딩은 서로 다른 개념으로 이해해야 한다.
- 유효한 검색 시스템을 위해서는 대조 학습과 하드 네거티브 같은 훈련 전략이 중요하다.
- 임베딩 모델 변경 시 코사인 유사도와 내적의 관계 및 인덱스 무효화 가능성을 고려해야 한다.
현대 AI에서 임베딩은 어디에나 있지만, '임베딩'이라는 단어는 매우 다양한 역할을 수행하고 있습니다.
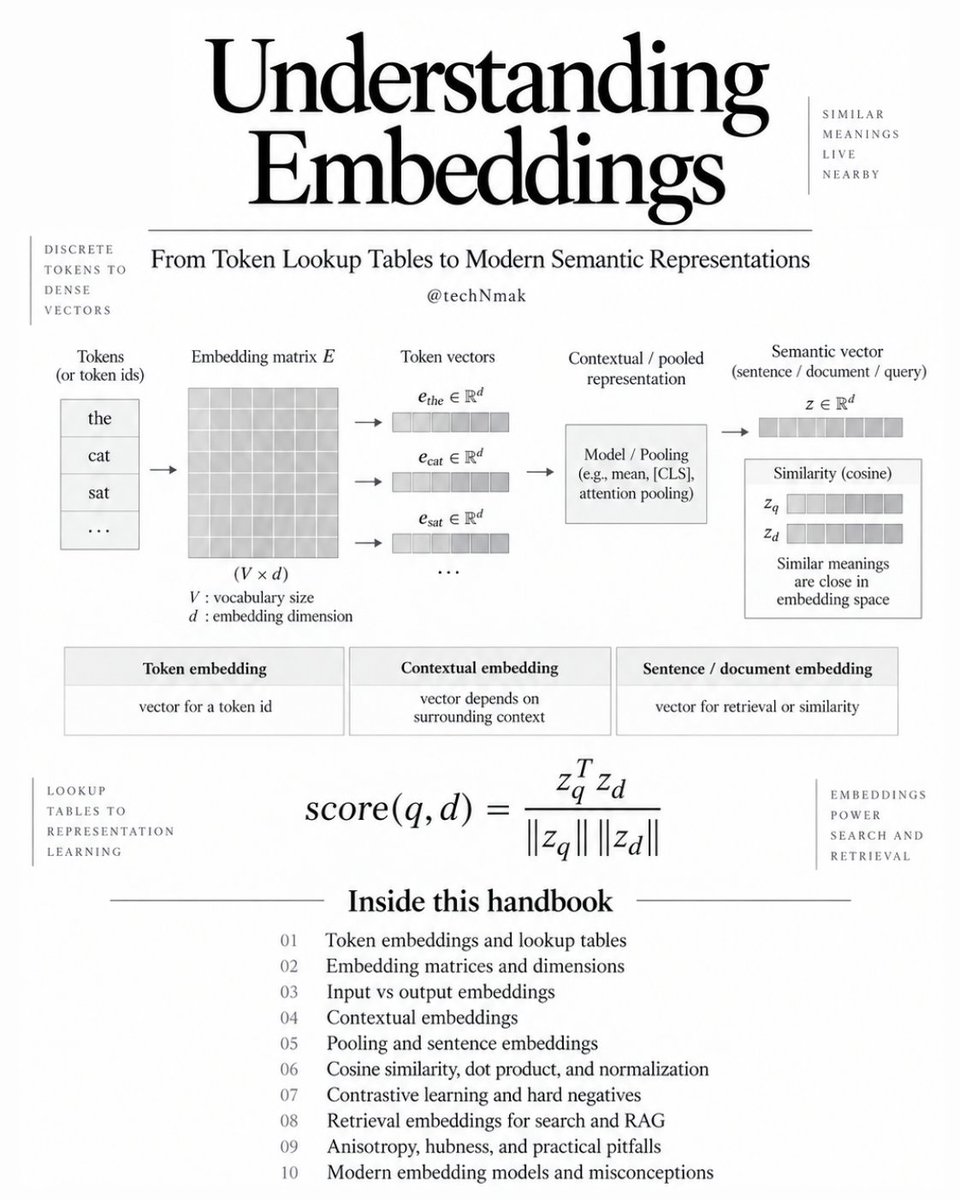
토큰 임베딩(token embedding)은 어휘(vocabulary) 행렬 내의 학습된 한 줄입니다. 컨텍스트 임베딩(contextual embedding)은 주변 시퀀스에 따라 값이 결정되는 은닉 상태 벡터(hidden-state vector)입니다. 문장 또는 문서 임베딩(sentence or document embedding)은 보통 추가적인 단계, 즉 가변 길이 표현을 하나의 고정 크기 벡터로 변환하는 풀링(pooling)이나 모델별 리드아웃(model-specific readout)이 필요합니다. 이들은 관련 있는 개념들이지만 서로 대체할 수만은 없습니다.
지오메트리(geometry) 역시 학습됩니다. 단순히 768차원 또는 1,024차원을 가졌다는 이유만으로 벡터에 본질적인 의미론적(semantic) 속성이 있는 것은 아닙니다. 유용한 쌍들이 높은 점수를 받고 관련 없는 예시들이 분리되도록 공간을 형성하는 것이 학습 목표여야 합니다. 이것이 현대 검색 시스템에서 대조 학습(contrastive training), 하드 네거티브(hard negatives), 풀링 전략, 정규화(normalization), 그리고 유사도 함수가 매우 중요한 이유입니다.
이는 또한 처음에는 무해해 보이는 여러 프로덕션 버그를 설명하기도 합니다. 코사인 유사도(Cosine similarity)와 내적(dot product)은 일반적으로 같지 않지만, 단위 정규화된 벡터의 경우 일치합니다. 임베딩 모델을 변경하더라도 차원성을 유지하는 것만으로는 좌표계를 보존하지 못합니다. 쿼리/문서 접두사(query/document prefixes)를 무시하면 비대칭적으로 학습된 모델의 결과가 바뀔 수 있습니다. 전처리나 풀링을 변경하는 것은 모든 벡터가 예상되는 형태를 가지고 있더라도 기존 인덱스를 무효화할 수 있습니다.
저는 원리부터 임베딩에 대한 기술 핸드북을 정리했습니다. 여기에는 토큰 조회 테이블(token lookup tables), 컨텍스트 표현, 풀링, 코사인/내적/L2 지오메트리, 대조 학습, 밀집 검색(dense retrieval), 하드 네거티브, 마트로시카 표현(Matryoshka representations), 다국어 및 멀티모달 임베딩, 그리고 이 벡터들이 검색과 RAG에 사용될 때 중요한 구현 세부 사항들이 포함되어 있습니다.
제가 글을 쓰는 내내 계속 되돌아온 정신적 모델은 간단합니다. 즉, 임베딩(embedding)이란 특정 목적을 위해 학습된 유용한 기하학입니다. 하나를 이해하려면 무엇이 매핑되었는지, 벡터가 어떻게 생성되었는지, 어떤 목표가 공간을 형성했는지, 그리고 그 벡터들이 어떻게 비교되는지 알아야 합니다.
핸드북은 여기에 공유합니다:
AI 자동 생성 콘텐츠
본 콘텐츠는 X 토픽: RAG의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기