
의도와 신뢰성 연결하기: 프로덕션 AI를 위한 협업 평가 프레임워크
요약
LLM 애플리케이션은 본질적으로 비결정론적 확률론적 시스템이므로, 전통적인 결정론적 테스트 방식으로는 신뢰성 확보가 어렵습니다. 이 글은 Eval 기반 개발(Eval-Driven Development) 패러다임을 제시하며, 평가 스위트(Evals)를 공유 사양 언어로 활용해야 한다고 주장합니다. 엔터프라이즈급 시스템은 구조적, 의미론적, 모델 기반의 세 가지 단언 계층을 통해 신뢰성을 확보할 수 있습니다.
핵심 포인트
- LLM 애플리케이션은 비결정론적 확률론적 시스템으로 작동한다.
- 전통적인 테스트 대신 Eval 기반 개발(Eval-Driven Development)로 전환해야 한다.
- Evals는 공유 사양 언어 역할을 하며, 실행 가능한 벤치마크를 정의한다.
- 신뢰성 확보를 위해 구조적, 의미론적, 모델 단언 등 다층적 평가가 필수다.
1. 패러다임 전환: 결정론적 시스템 대 확률론적 시스템
전통적인 소프트웨어 엔지니어링은 결정론적(deterministic) 보장에 의존합니다. 애플리케이션 프로그래밍 인터페이스, 데이터베이스 트랜잭션 또는 상태 머신은 예측 가능한 경로를 따라 성공하거나 실패합니다. 입력이 유효성 검사를 통과하면 시스템은 매번 일관된 출력을 보장합니다.
대규모 언어 모델(LLM) 애플리케이션과 에이전트 워크플로우는 근본적으로 다른 물리 법칙 하에서 작동합니다. 이들은 비결정론적(nondeterministic), 확률론적 시스템입니다. 동일한 사용자 프롬프트라도 컨텍스트 윈도우 상태, 온도 설정 및 모델 샘플링 역학에 따라 다양한 추론 궤적, 도구 호출 페이로드 및 출력 구조를 생성할 수 있습니다.
엔지니어링 팀이 확률론적 시스템을 레거시 테스트 패러다임에 강제로 맞추려고 할 때, 두 가지 심각한 실패 모드가 발생합니다:
취약한 경직성 (Fragile Rigidity): 모델이 자연스럽게 구문을 변경할 때마다 애플리케이션이 충돌하게 만드는 과도하게 엄격한 정규 표현식이나 하드코딩된 파싱 검사 작성.
통제되지 않는 분산 (Ungoverned Variance): 제약 없는 모델 출력을 프로덕션에 허용하여 예상치 못한 도구 실행 오류, 환각(hallucinated) 컨텍스트 또는 데이터 무결성 손상을 초래하는 경우.
탄력적인 AI 시스템을 구축하려면 정적 수락 기준을 넘어 **Eval 기반 개발 (Eval-Driven Development)**로 나아가야 합니다. 이 패러다임 하에서 시스템은 통계적 경계, 지속적인 평가 엔진 및 우아한 상태 폴백(graceful state fallbacks)을 통해 관리됩니다.
2. 공유 사양 언어로서의 Evals
비결정론적 아키텍처에서는 평가 스위트(Evaluation suite)가 전통적인 정적 요구사항 문서를 대체합니다. 시스템이 무엇을 해야 하는지 산문으로 설명하는 대신, Evals는 실제 세계의 입력에 대해 시스템 성능을 측정하는 실행 가능한 벤치마크를 정의합니다.
엔터프라이즈급 평가 파이프라인은 세 가지 별개의 단언 계층(assertion layers)에 의존합니다:
결정론적 단언(Deterministic Assertions): 출력이 정확한 타입 스키마, JSON 키, 필수 도구 호출 매개변수, 유효 HTTP 응답 코드를 준수하는지 검증하는 구조적 게이트키핑입니다.의미론적 단언(Semantic Assertions): 벡터 임베딩 유사성, 검색 증강 생성(RAG) 청크 관련성, 컨텍스트 중첩 점수 등을 측정하는 거리 기반 평가로, 검색된 정보가 모델 생성을 엄격하게 근거화하도록 보장합니다.자동화된 심사관으로서의 모델 단언(Automated Model as a Judge Assertions): 미세 조정된 평가 모델이나 표준화된 점수 산출 파이프라인을 사용하여, 지침 준수, 톤 일관성, 도메인 정밀도, 안전 정책 등 특정 기준에 따라 출력을 평가하는 미묘한 품질 평가입니다.
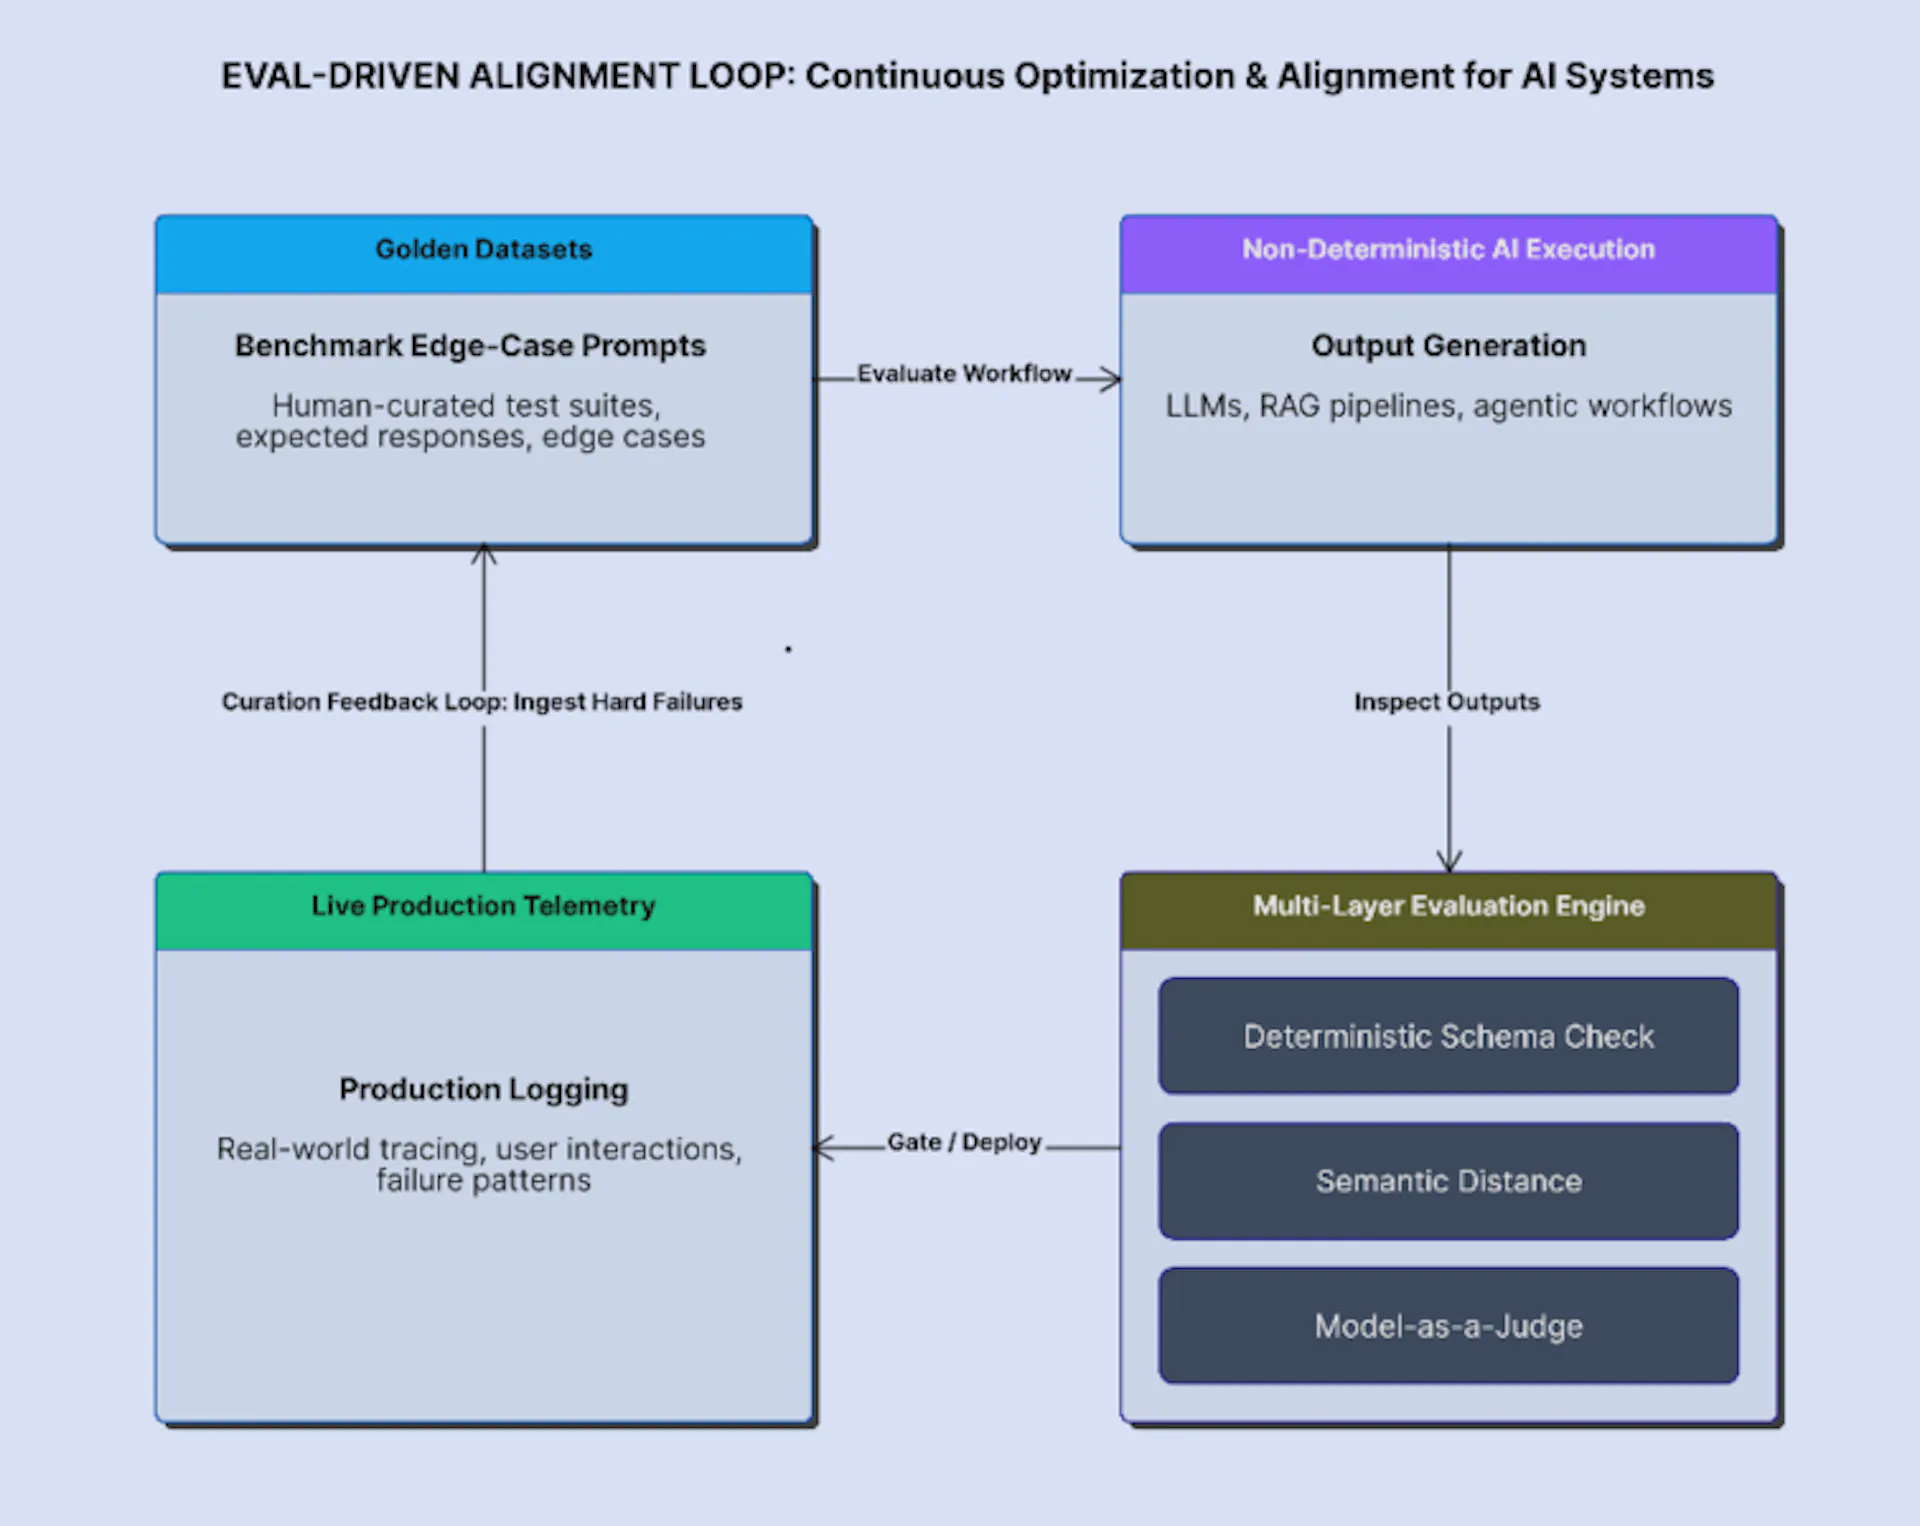
대표적인 사용자 작업, 적대적 프롬프트(adversarial prompts), 엣지 케이스(edge cases), 과거 실패 패턴을 포함하는 골든 데이터셋(golden datasets)을 큐레이션함으로써, 엔지니어링 팀은 코드 업데이트를 배포하거나 기본 모델 아키텍처를 교체하기 전에 정량화 가능한 품질 기준선(baseline)을 확립합니다.
3. 우아한 시스템 복원력 및 신뢰도 라우팅 (Graceful System Resilience and Confidence Routing)
확률적 애플리케이션에서의 높은 신뢰성은 분산을 완전히 제거하는 것이 아니라, 모델의 확실성(certainty)에 따라 작업을 동적으로 라우팅함으로써 달성됩니다.
에이전트가 사용자 요청을 처리할 때, 시스템은 출력 로그 확률(output log probabilities), 스키마 유효성 검사 성공 여부, 컨텍스트 검색 점수와 같은 신뢰도 지표를 평가합니다. 이 신뢰도 평가를 기반으로, 요청은 적절한 실행 경로를 통해 안내됩니다:
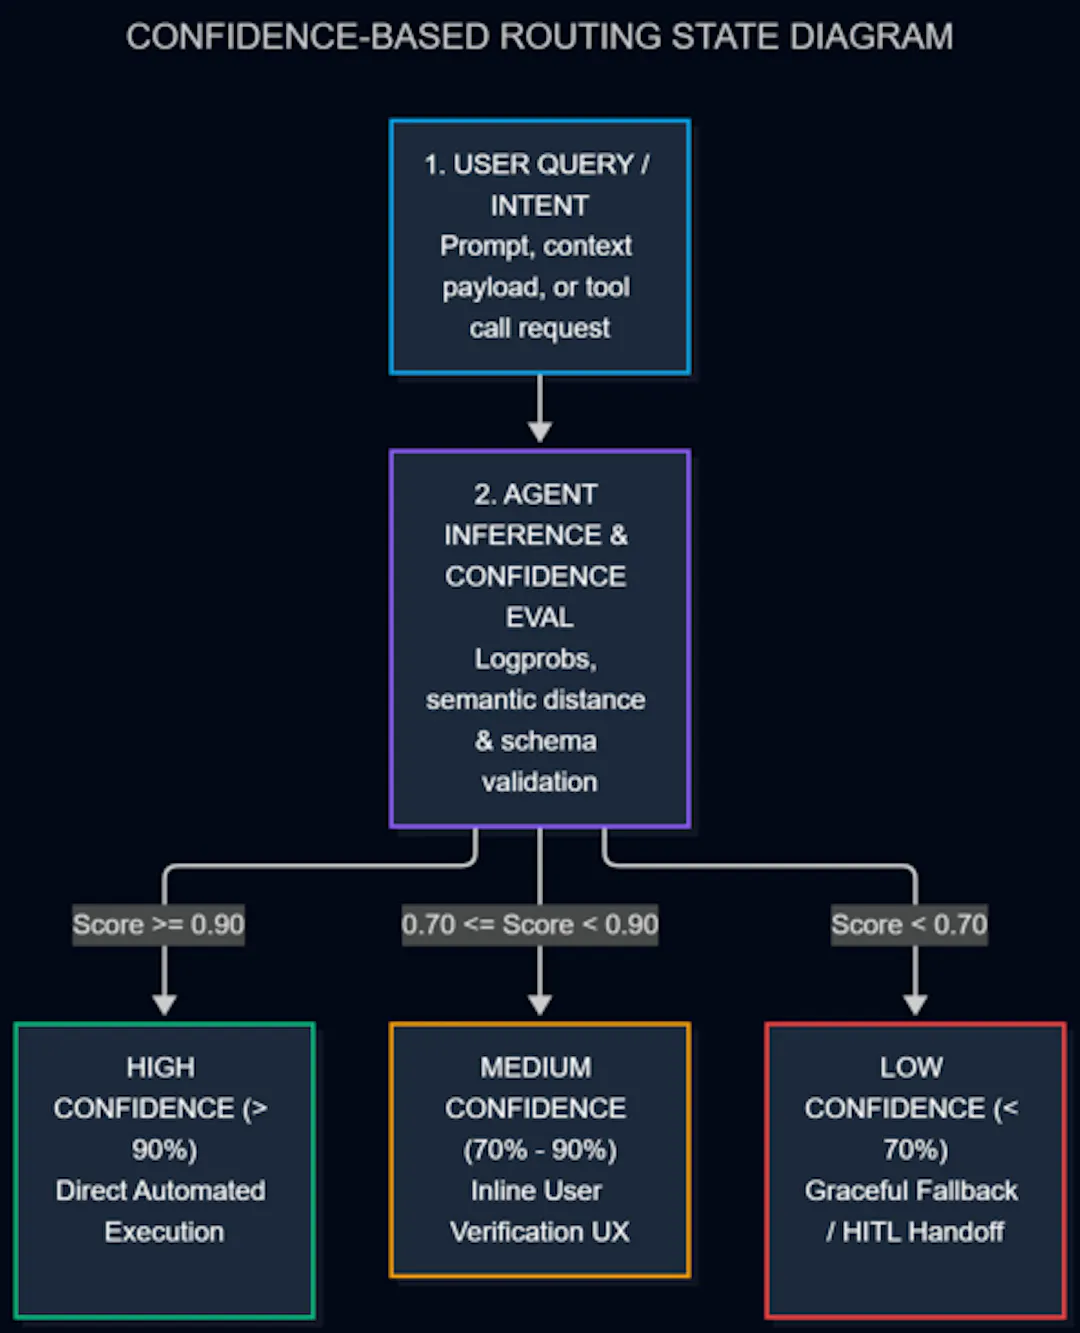
높은 신뢰도(90% 초과): 직접 자동 실행(Direct Automated Execution). 에이전트는 도구 호출을 자율적으로 실행하고 응답을 사용자에게 직접 렌더링합니다.
중간 신뢰도(70%~90%): 인라인 사용자 검증(Inline User Verification). 시스템은 조치를 취하기 전에, 예를 들어 데이터베이스 변경 이전에 핵심 매개변수를 확인하도록 사용자에게 요청하거나 명시적인 선택지를 제시합니다.
낮은 신뢰도 (70% 미만): 우아한 폴백 및 인간 운영자 인계. 에이전트는 직접 실행을 중단하고, 결정론적 안전 상태로 폴백하거나, 명확히 하는 질문을 하거나, 작업을 인간 운영자에게 에스컬레이션(escalate)합니다.
4. 운영 텔레메트리 및 단위 경제학 (Operational Telemetry and Unit Economics)
프로덕션 환경에서 비결정론적(nondeterministic) 시스템을 관리하려면 표준 서버 응답 시간 및 오류율을 넘어선 운영 지표를 추적해야 합니다.
핵심 시스템 텔레메트리 (Critical System Telemetry)
컨텍스트 창 활용 및 비대화 (Bloat): 컨텍스트 저하(context degradation)를 감지하고 불필요한 컴퓨팅 오버헤드를 방지하기 위해 다중 턴 에이전트 실행 체인 전반의 토큰 확장을 추적합니다.
도구 호출 실패율 (Tool Invocation Failure Rate): 에이전트가 유효하지 않은 도구를 선택하거나, 잘못된 형식의 API 인수를 생성하거나, 재귀적 도구 호출 루프에 진입하는 빈도를 모니터링합니다.
단계별 지연 시간 프로파일링 (Step Latency Profiling): 전체 요청 시간을 모델 추론 지연 시간(model inference latency), 벡터 데이터베이스 전반의 검색 지연 시간(retrieval latency), 외부 도구 실행 지연 시간으로 세분화합니다.
단위 경제학을 위한 적응형 모델 라우팅 (Adaptive Model Routing for Unit Economics)
제품의 단위 경제학을 확장 가능하게 유지하려면, 작업 부하의 복잡성을 적절히 할당하는 동적 라우팅 계층(dynamic routing layers)을 시스템 아키텍처에 통합해야 합니다:
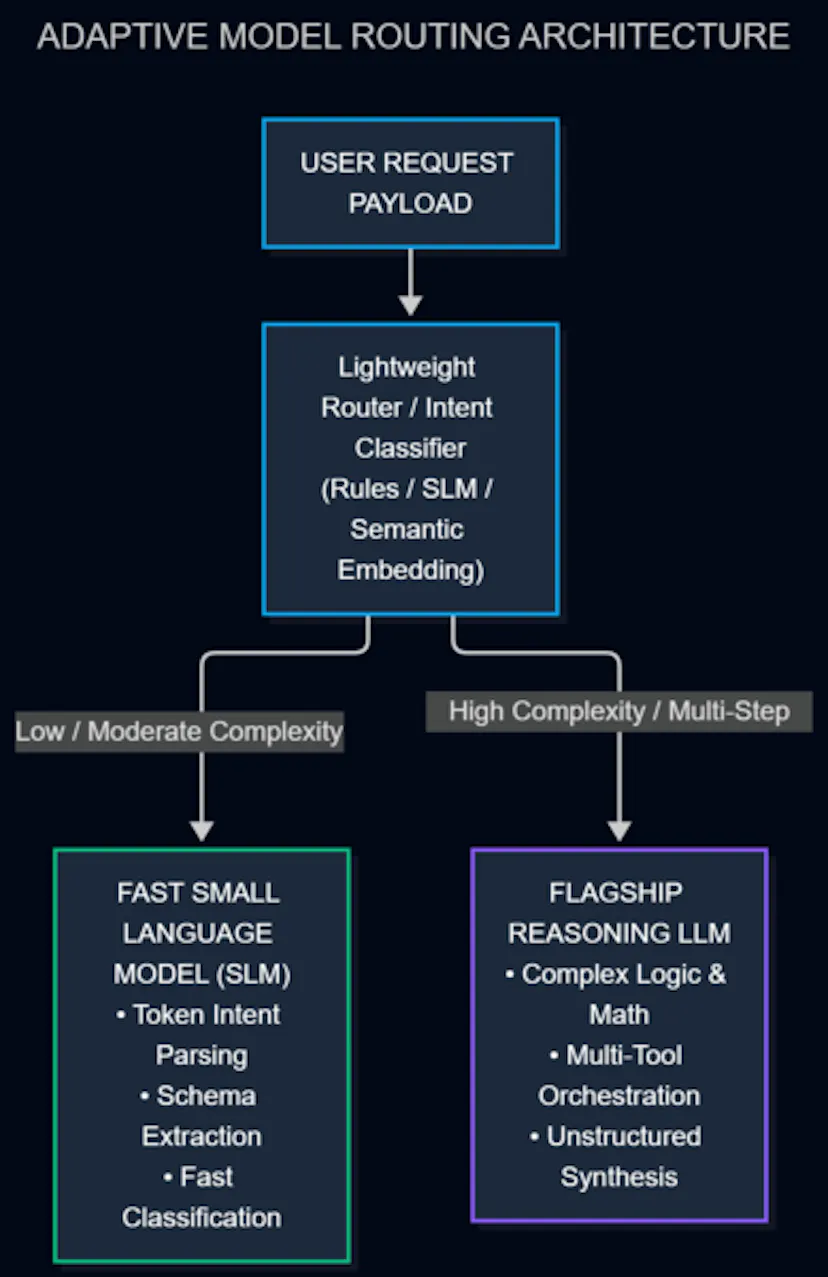
의도 분류나 스키마 추출과 같은 일상적이고 단일 목적의 작업은 빠른 소형 언어 모델(Small Language Models)에 할당하고, 더 크고 매개변수가 많은 플래그십 모델을 복잡한 다단계 추론(multistep reasoning)에 보존합니다. 이를 통해 사용자 세션당 토큰 비용을 제어하면서 엄격한 지연 시간 예산(latency budgets)을 유지할 수 있습니다.
운영 측면 | 결정론적 소프트웨어 엔지니어링 | 확률적 AI 시스템 아키텍처 |
주요 수용 기준 | 이진 단위 테스트 통과율 (예상 100%) | 다층 평가 점수 (% 정확도(Accuracy), 정밀도(Precision), F1) |
입력 유효성 검사 및 가드레일 | 엄격한 타입 스펙, RegEx 및 스키마 검증 | 스키마 준수 여부, 의미적 거리 및 벡터 접지(Vector Grounding) |
오류 및 폴백 관리 | 예외 발생 및 HTTP 오류 코드 (4xx / 5xx) | 신뢰도 임계값 라우팅, 인간 개입(Human in the Loop) 및 상태 폴백 |
자원 및 컴퓨팅 최적화 | CPU/RAM 효율성 및 데이터베이스 쿼리 인덱스 | 토큰 소비율, 컨텍스트 압축 및 단계 지연 시간(Step Latency) |
프로덕션 건전성 및 관측 가능성 | 서버 가동 시간, 트래픽 RPS 및 오류 로그 급증 | 지속적 평가 드리프트(Continuous Eval Drift), 환각 지수(Hallucination Index) 및 도구 실패율 (Tool Failure Rate) |
시스템 진화 및 반복 | 버전 관리 코드 배포 및 리팩토링 | 골든 데이터셋 큐레이션, 파인튜닝 및 회귀 평가(Regression Evals) |
시스템 신뢰성을 공유된 관행으로 만들기
프로덕션 수준의 AI 애플리케이션을 구축하는 것은 의도적인 사용자 경험 설계와 견고한 시스템 엔지니어링 사이의 격차를 해소하는 것을 필요로 합니다. 평가 주도 개발(Eval-Driven Development)을 공유 사양 언어로 확립함으로써, 엔지니어링 및 제품 팀은 추측 대신 정량적 벤치마크를 사용합니다.
구조화된 평가 계층, 신뢰도 기반 폴백 라우팅, 그리고 적응형 운영 원격 측정(telemetry)을 채택하는 것은 확률적 모델 실행을 통제되고 확장 가능한 엔지니어링 규율로 전환시킵니다. 이러한 아키텍처 진화를 수용함으로써 팀은 측정 가능하고 프로덕션 등급의 신뢰성을 갖춘 야심 찬 AI 워크플로우를 배포할 수 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Hacker Noon AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기