쇠렌 키르케고르는 삶은 오직 뒤를 돌아보며 이해할 수 있지만, 앞으로 나아가며 살아야 한다고 썼습니다. 우리는 AI 에이전트를 위한 메모리를 설계하면서 유사한 어려움에 직면했습니다.
인간으로서 우리는 살아가는 동안 끊임없이 기억을 인코딩합니다. 이 과정에서 해마(hippocampus)가 중심적인 역할을 하며, 순간의 경험들을 포착하여 기억들이 빠르게 형성되고 즉시 이용 가능하게 만듭니다. 하지만 그중 일부 경험만이 장기 지식으로 통합됩니다.
이러한 통합 작업의 상당 부분은 우리의 뇌가 오프라인 상태일 때 발생하는 것으로 보입니다. 우리가 잠을 자거나 조용히 휴식을 취하는 동안, 해마는 최근의 경험들을 재현합니다(replays). 이는 그 경험들을 점진적으로 정제하고 신피질(neocortex)—우리가 지식이라고 생각하는 대부분을 저장하는 뇌의 부분—에 통합시키는 것으로 여겨집니다.
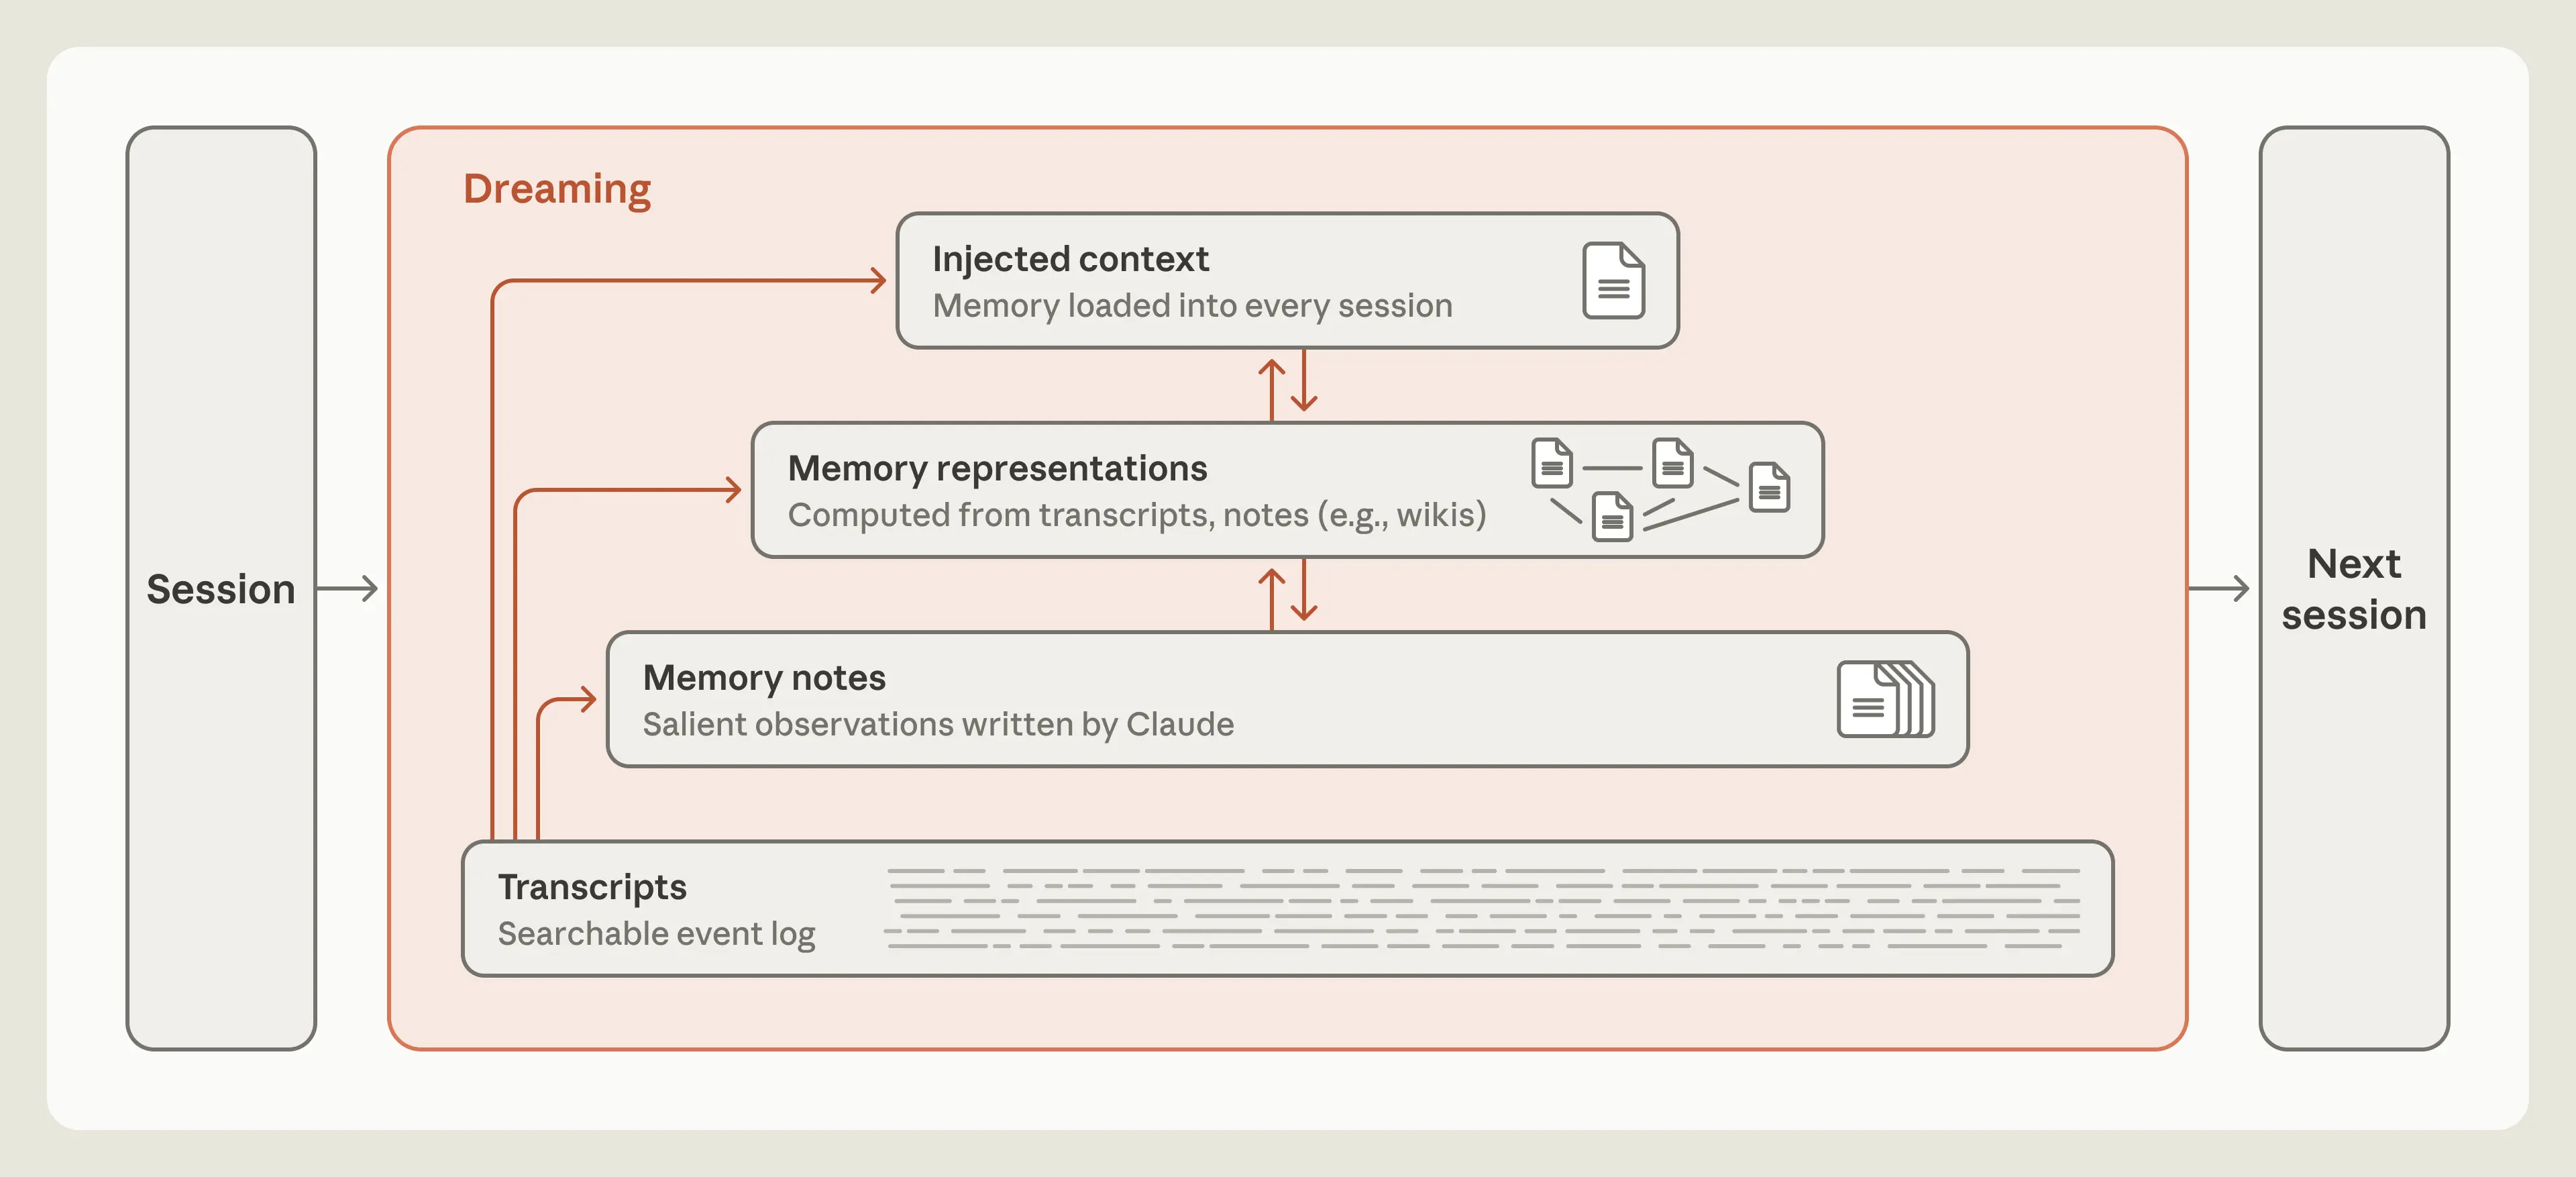
에이전트 메모리 역시 유사한 분업 구조를 사용할 수 있습니다. 에이전트는 자신의 작업 상당 부분을 로그나 기록으로 포착합니다. Letta와 UC Berkeley의 연구원들은 모델들이 상호작용 사이의 유휴 시간을 활용하여 기존 컨텍스트를 재구성하는 방법으로 '수면 시간 컴퓨팅(sleep-time compute)'을 제안했습니다. 동일한 아이디어는 에이전트가 로그를 반추하여 실수를 수정하거나 새로운 노트 및 표현을 생성함으로써 메모리를 조직화하는 데 도움을 줄 수 있습니다. 이 과정은 종종 *꿈꾸기(dreaming)*라고 불립니다(그림 1).
우리는 꿈꾸기가 Claude에게 효과적인 메모리를 제공하는 유용한 도구임을 발견했습니다. 본 게시물에서는 우리가 에이전트 메모리에 대해 어떻게 생각하게 되었는지 공유하고, 꿈꾸기의 사용을 포함하여 에이전트 메모리를 탐색하기 위해 사용한 여러 평가들과 각 구성 요소가 메모리 조직화에 기여하는 바를 설명합니다.
Diagram of a memory hierarchy between one session and the next. From bottom to top: transcripts (a searchable event log), memory notes written by Claude, memory representations such as wikis, and injected context loaded into every session. Inside a box labeled “Dreaming,” arrows run from transcripts up to each layer, and in both directions between neighboring upper layers.
메모 노트
에이전트 메모리(agent memory)란 Claude가 사용자 상호작용 및 할당된 작업을 포함한 경험을 통해 얻고, 세션 간에 유지하며 나중에 읽을 수 있는 컨텍스트로 저장하는 지식을 의미합니다. 이는 모델이 학습하거나 컨텍스트를 관리할 수 있는 다른 방식들, 예를 들어 weights (훈련 중에 설정되는 내부 매개변수)의 변경, in-context learning (단일 대화 내에서 얻는 지식), 그리고 compaction (Claude가 이전 발언을 요약하여 새로운 컨텍스트 창에서 계속 작업할 수 있도록 대체하는 요약본) 등을 제외합니다.
인간의 뇌에서는 경험 전, 중 또는 후에 방출되는 화학 신호가 기억을 중요하다고 표시할 수 있습니다. 표시된 기억은 오프라인 기간 동안 표시되지 않은 기억보다 더 자주 재현(replayed)되는 경향이 있습니다. 이 과정은 replay라고 불리며, 이를 장기 기억에 안정화하고 통합하는 데 도움을 줍니다.
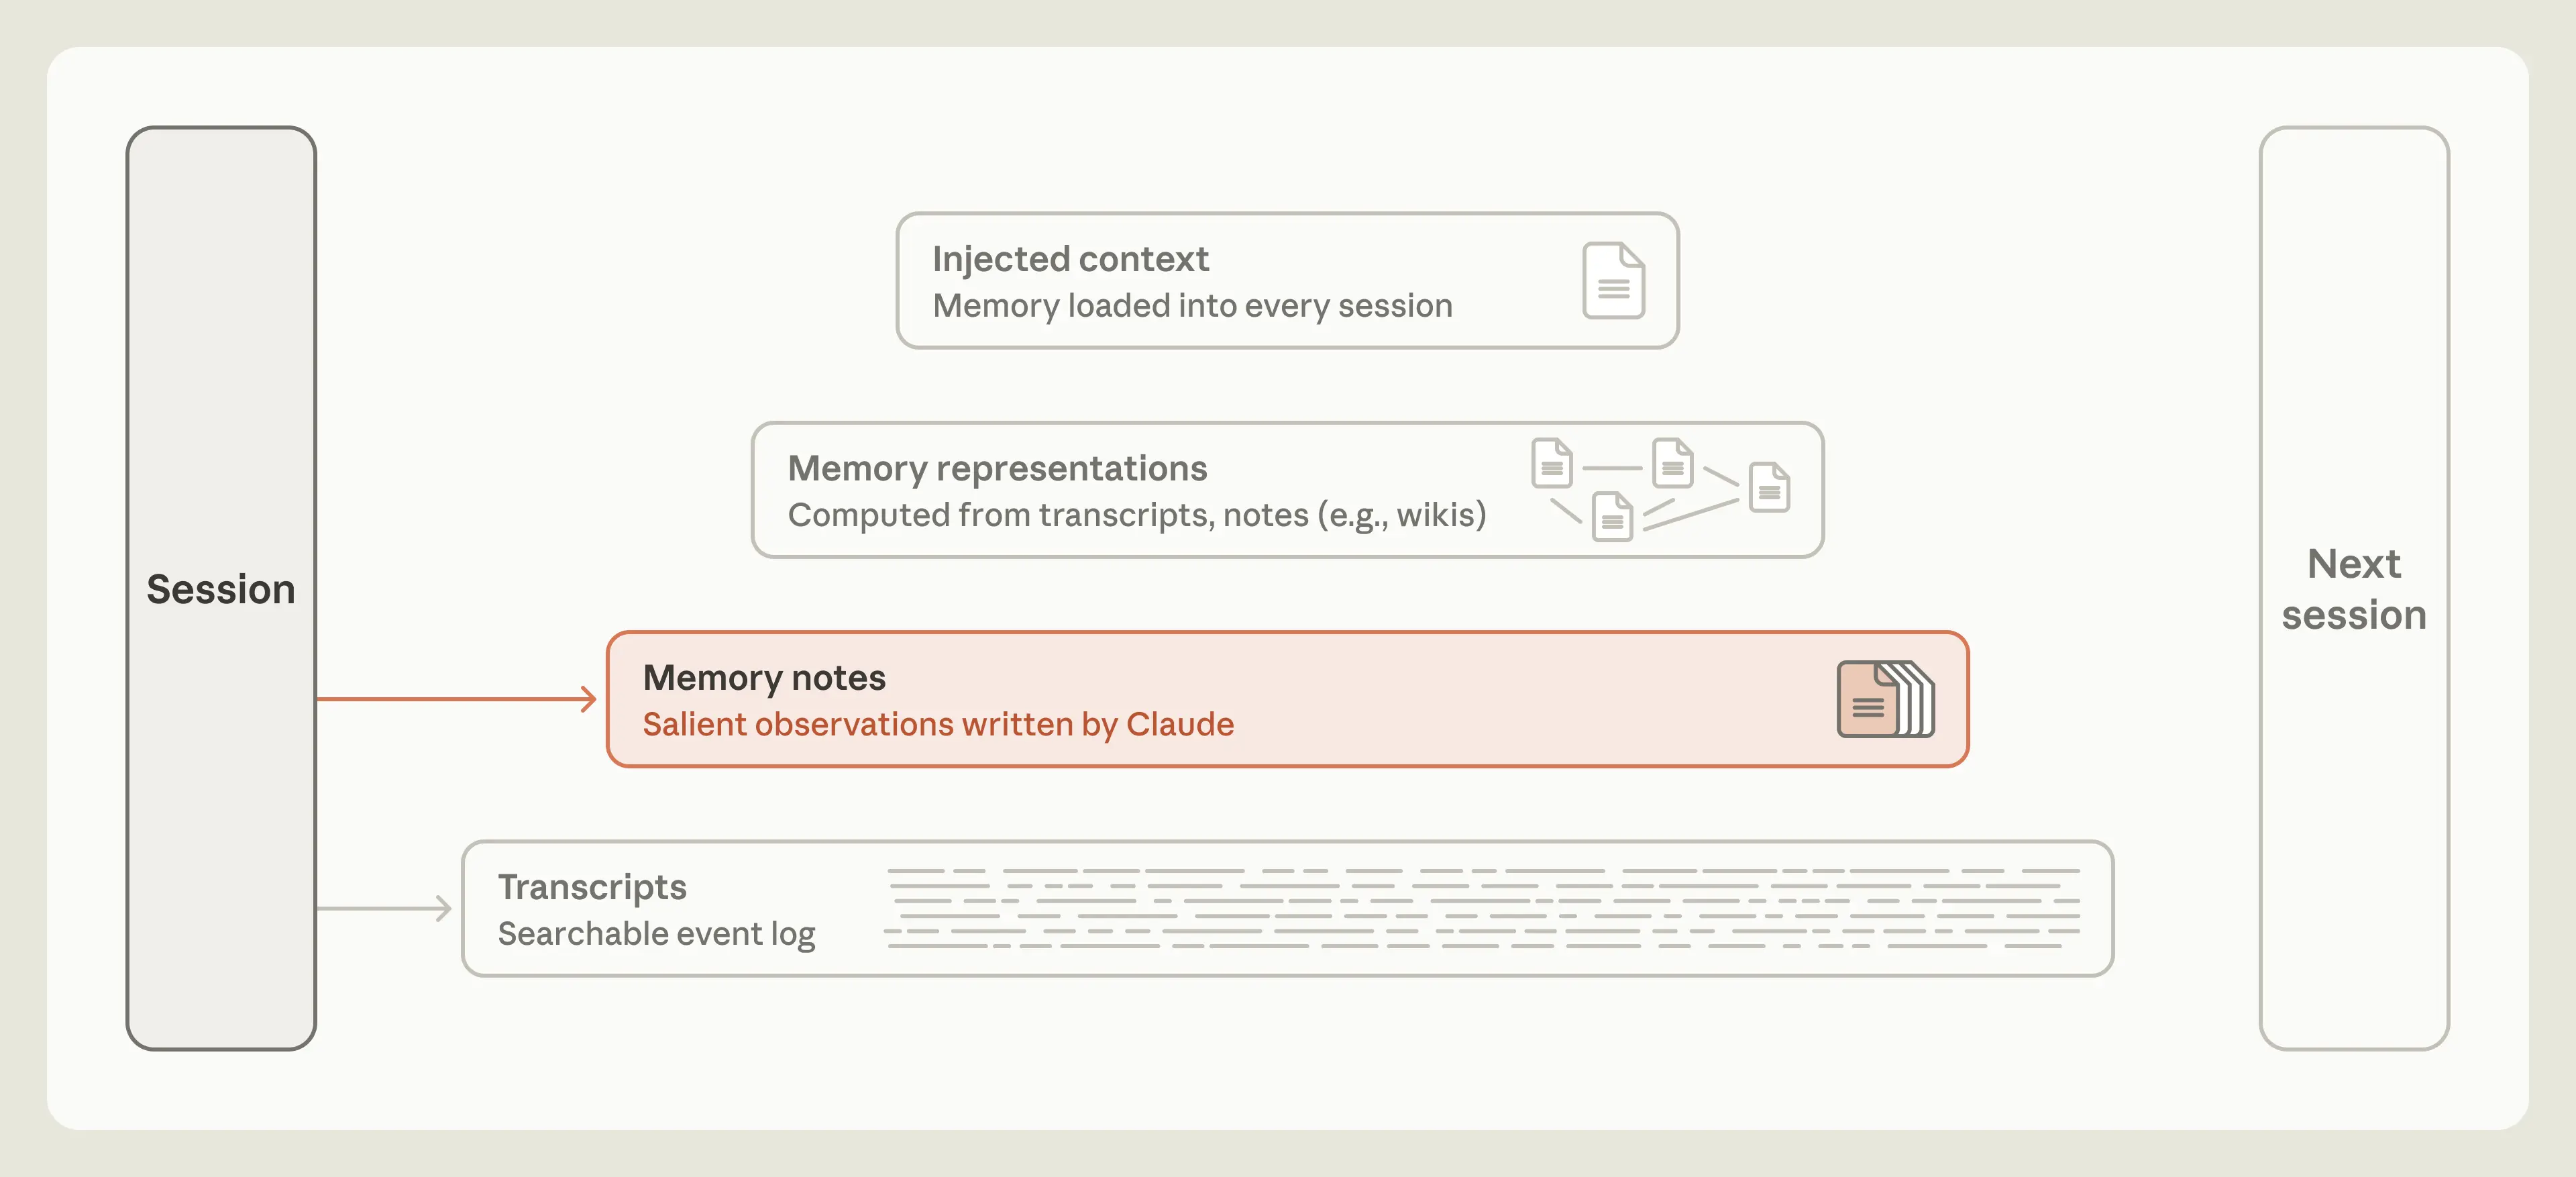
마찬가지로, Claude는 세션 로그에서 중요한 사건(salient events)이 발생하는 즉시 이를 태그하여 나중에 찾기 쉽게 하거나, 메모 노트 폴더와 같은 메모리 저장소에 기록할 수 있습니다 (그림 2). 하지만 다음에 무엇이 올지 알기도 전에, 현재 순간에 무엇이 중요한지 어떻게 알 수 있을까요?
The same memory hierarchy, with the memory notes layer highlighted. An arrow runs from the session directly to the memory notes, described as salient observations written by Claude.
메모리는 미래에 필요할 것을 예측하는 것일 수 있다
메모리는 때때로 예측입니다. 규칙을 작성함으로써 에이전트는 자신이 설명하는 패턴이 다시 관련성이 있을 것이라고 예측합니다. 예를 들어, 검증된 사실을 기록하는 것은 미래 세션의 에이전트가 그 사실을 재차 확인하지 않고 의존하기를 바라는 예측과 같습니다. 시간이 지남에 따라 Claude는 이러한 종류의 예측을 하는 데 훨씬 더 능숙해졌습니다.
장기 호라이즌(long-horizon) 작업을 처리하기 위해 메모리를 사용하는 에이전트의 능력을 측정하는 벤치마크인 Continual Learning Bench (CL-Bench) 1.0의 과제를 고려해 봅시다. 한 특정 과제는 Claude에게 데이터베이스에서 정보를 찾아 일련의 질문에 답하도록 요청합니다. Claude가 답변을 제공한 후, 올바른 해결책을 전달받고 미래 질문에 답변하는 데 도움이 되는 메모리를 작성할 수 있습니다.
메모리는 여기서 학습 루프(learning loop)를 지원할 수 있습니다. Claude가 질문에 틀리면, 그 실패를 기록하고, 무엇이 잘못되었는지에 대한 가설을 세우고, 그 가설들을 테스트하며, 발견한 것을 미래에 어떻게 답변해야 하는지에 대한 규칙으로 바꿀 수 있습니다.
우리는 Claude Managed Agents를 사용하여 CL-Bench 1.0 작업을 수행했습니다. Claude는 각 질문을 새로운 세션에서 시작했지만, 한 가지 예외가 있었습니다. 바로 이전 세션부터 지속되는 메모리 디렉토리에서 파일을 검색할 수 있었다는 점입니다.
다양한 모델들은 자신만의 학습 루프를 만드는 데 있어 다른 수준의 성공을 달성했습니다. Claude Sonnet 4.6은 답변이 틀린 이유에 대한 가설을 생성하는 단계까지 나아갔습니다. 그 메모리 디렉토리에는 여러 개의 테스트되지 않은 추측들을 나열한 파일들이 산재해 있었습니다.
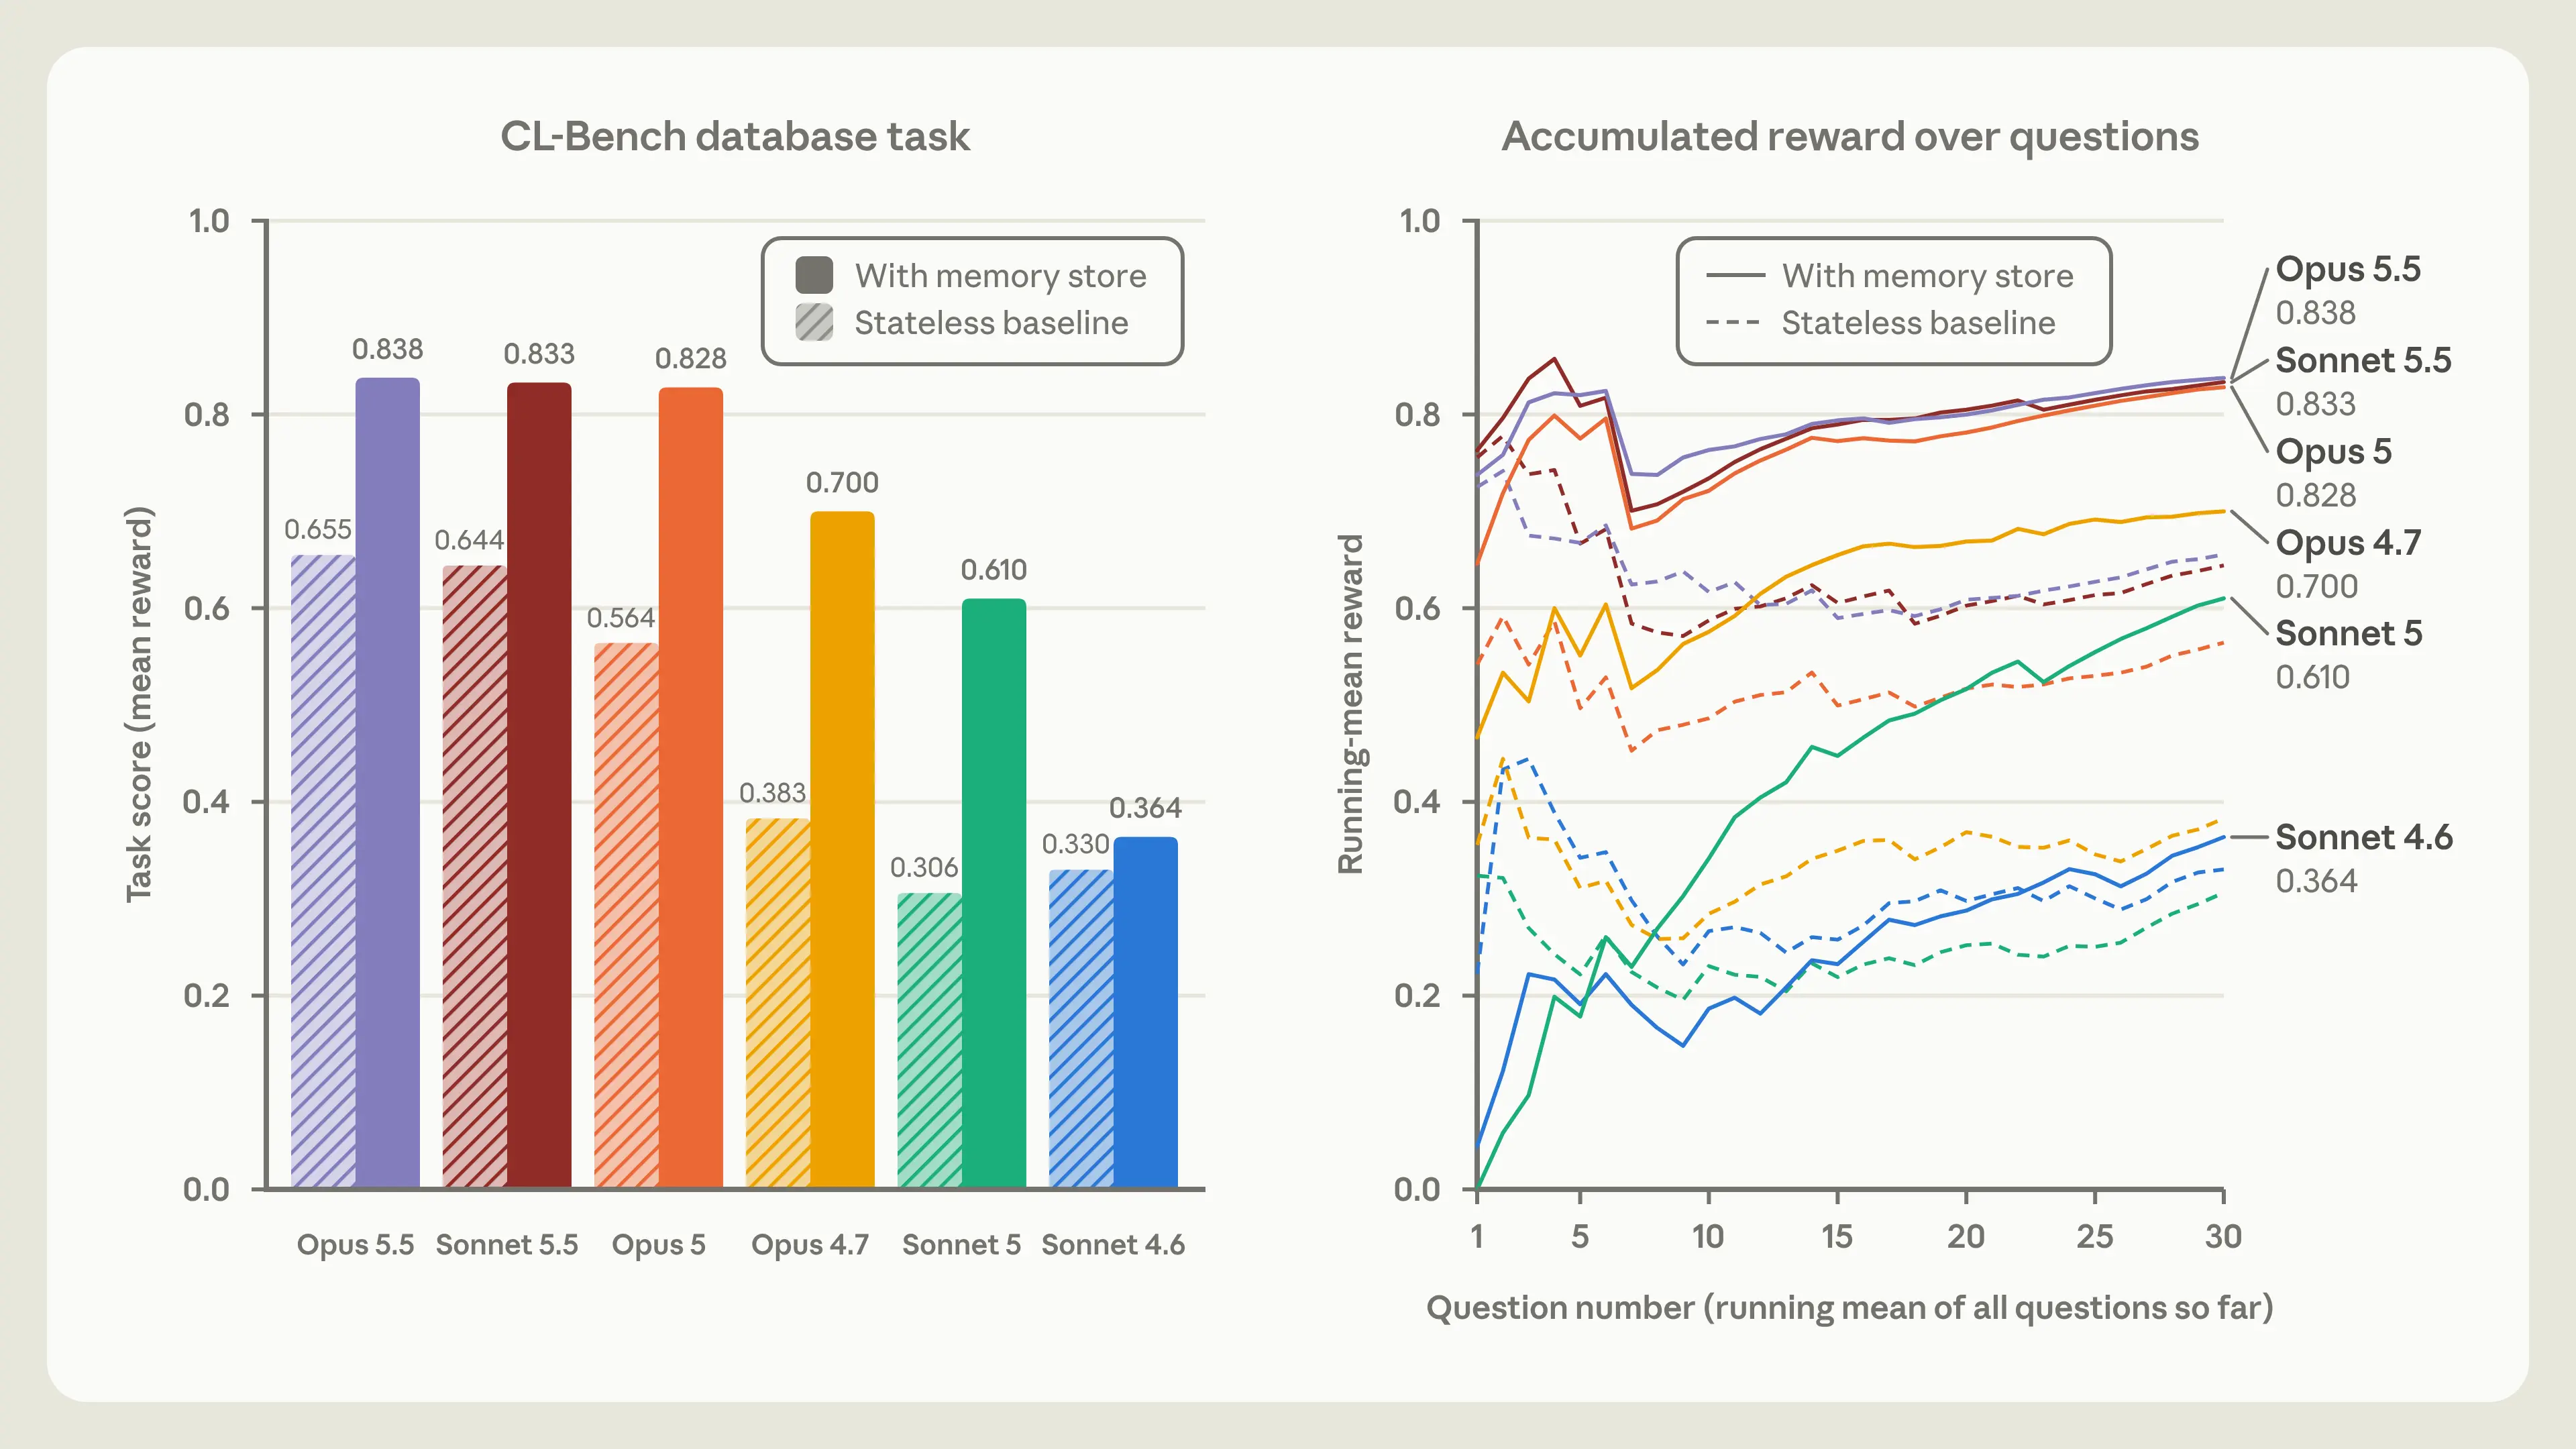
Left: bar chart of mean reward on the CL-Bench database task, stateless baseline versus memory store. Opus 5.5: 0.655, 0.838. Sonnet 5.5: 0.644, 0.833. Opus 5: 0.564, 0.828. Opus 4.7: 0.383, 0.700. Sonnet 5: 0.306, 0.610. Sonnet 4.6: 0.330, 0.364. Right: line chart of running-mean reward over 30 questions for the same models, with and without memory.
Claude Opus 4.7은 자신의 메모들을 단일 참조 문서로 통합하고, 어떤 사실을 확인했는지, 그리고 어떤 것이 아직 확정되지 않았는지를 표시하기 시작했습니다. Claude Sonnet 5는 채점관(grader)이 확인한 후 각 답변을 '확인됨'으로 표시했고, 틀리게 답변했을 때는 수정 사항을 작성했습니다.
Claude Opus 5는 이 모델들 중 처음으로 루프를 완성했습니다(close the loop). 그 항목들 대부분은 규칙(그리고 어떻게 그 규칙이 사실인지 알게 되었는지), 이전 질문에 대한 답변, 그리고 과정에서 발견한 함정들에 대한 명확한 경고를 포함하고 있었습니다 (그림 3).
Opus 5와 마찬가지로 Claude Opus 5.5와 Claude Sonnet 5.5 모두 루프를 완성했으며, 메모리를 사용하여 미래 질문에 가장 잘 답변하는 방법에 대한 검증된 규칙을 포착했습니다. 메모리가 있는 경우 두 모델 모두 Opus 5와 비슷한 점수를 받았지만, 메모리 없이 기준 성능(baseline performance)만 놓고 보면 약간 더 높았습니다.
Claude는 중요도를 판단하는 법을 배웠습니다 (Claude has learned to judge salience)
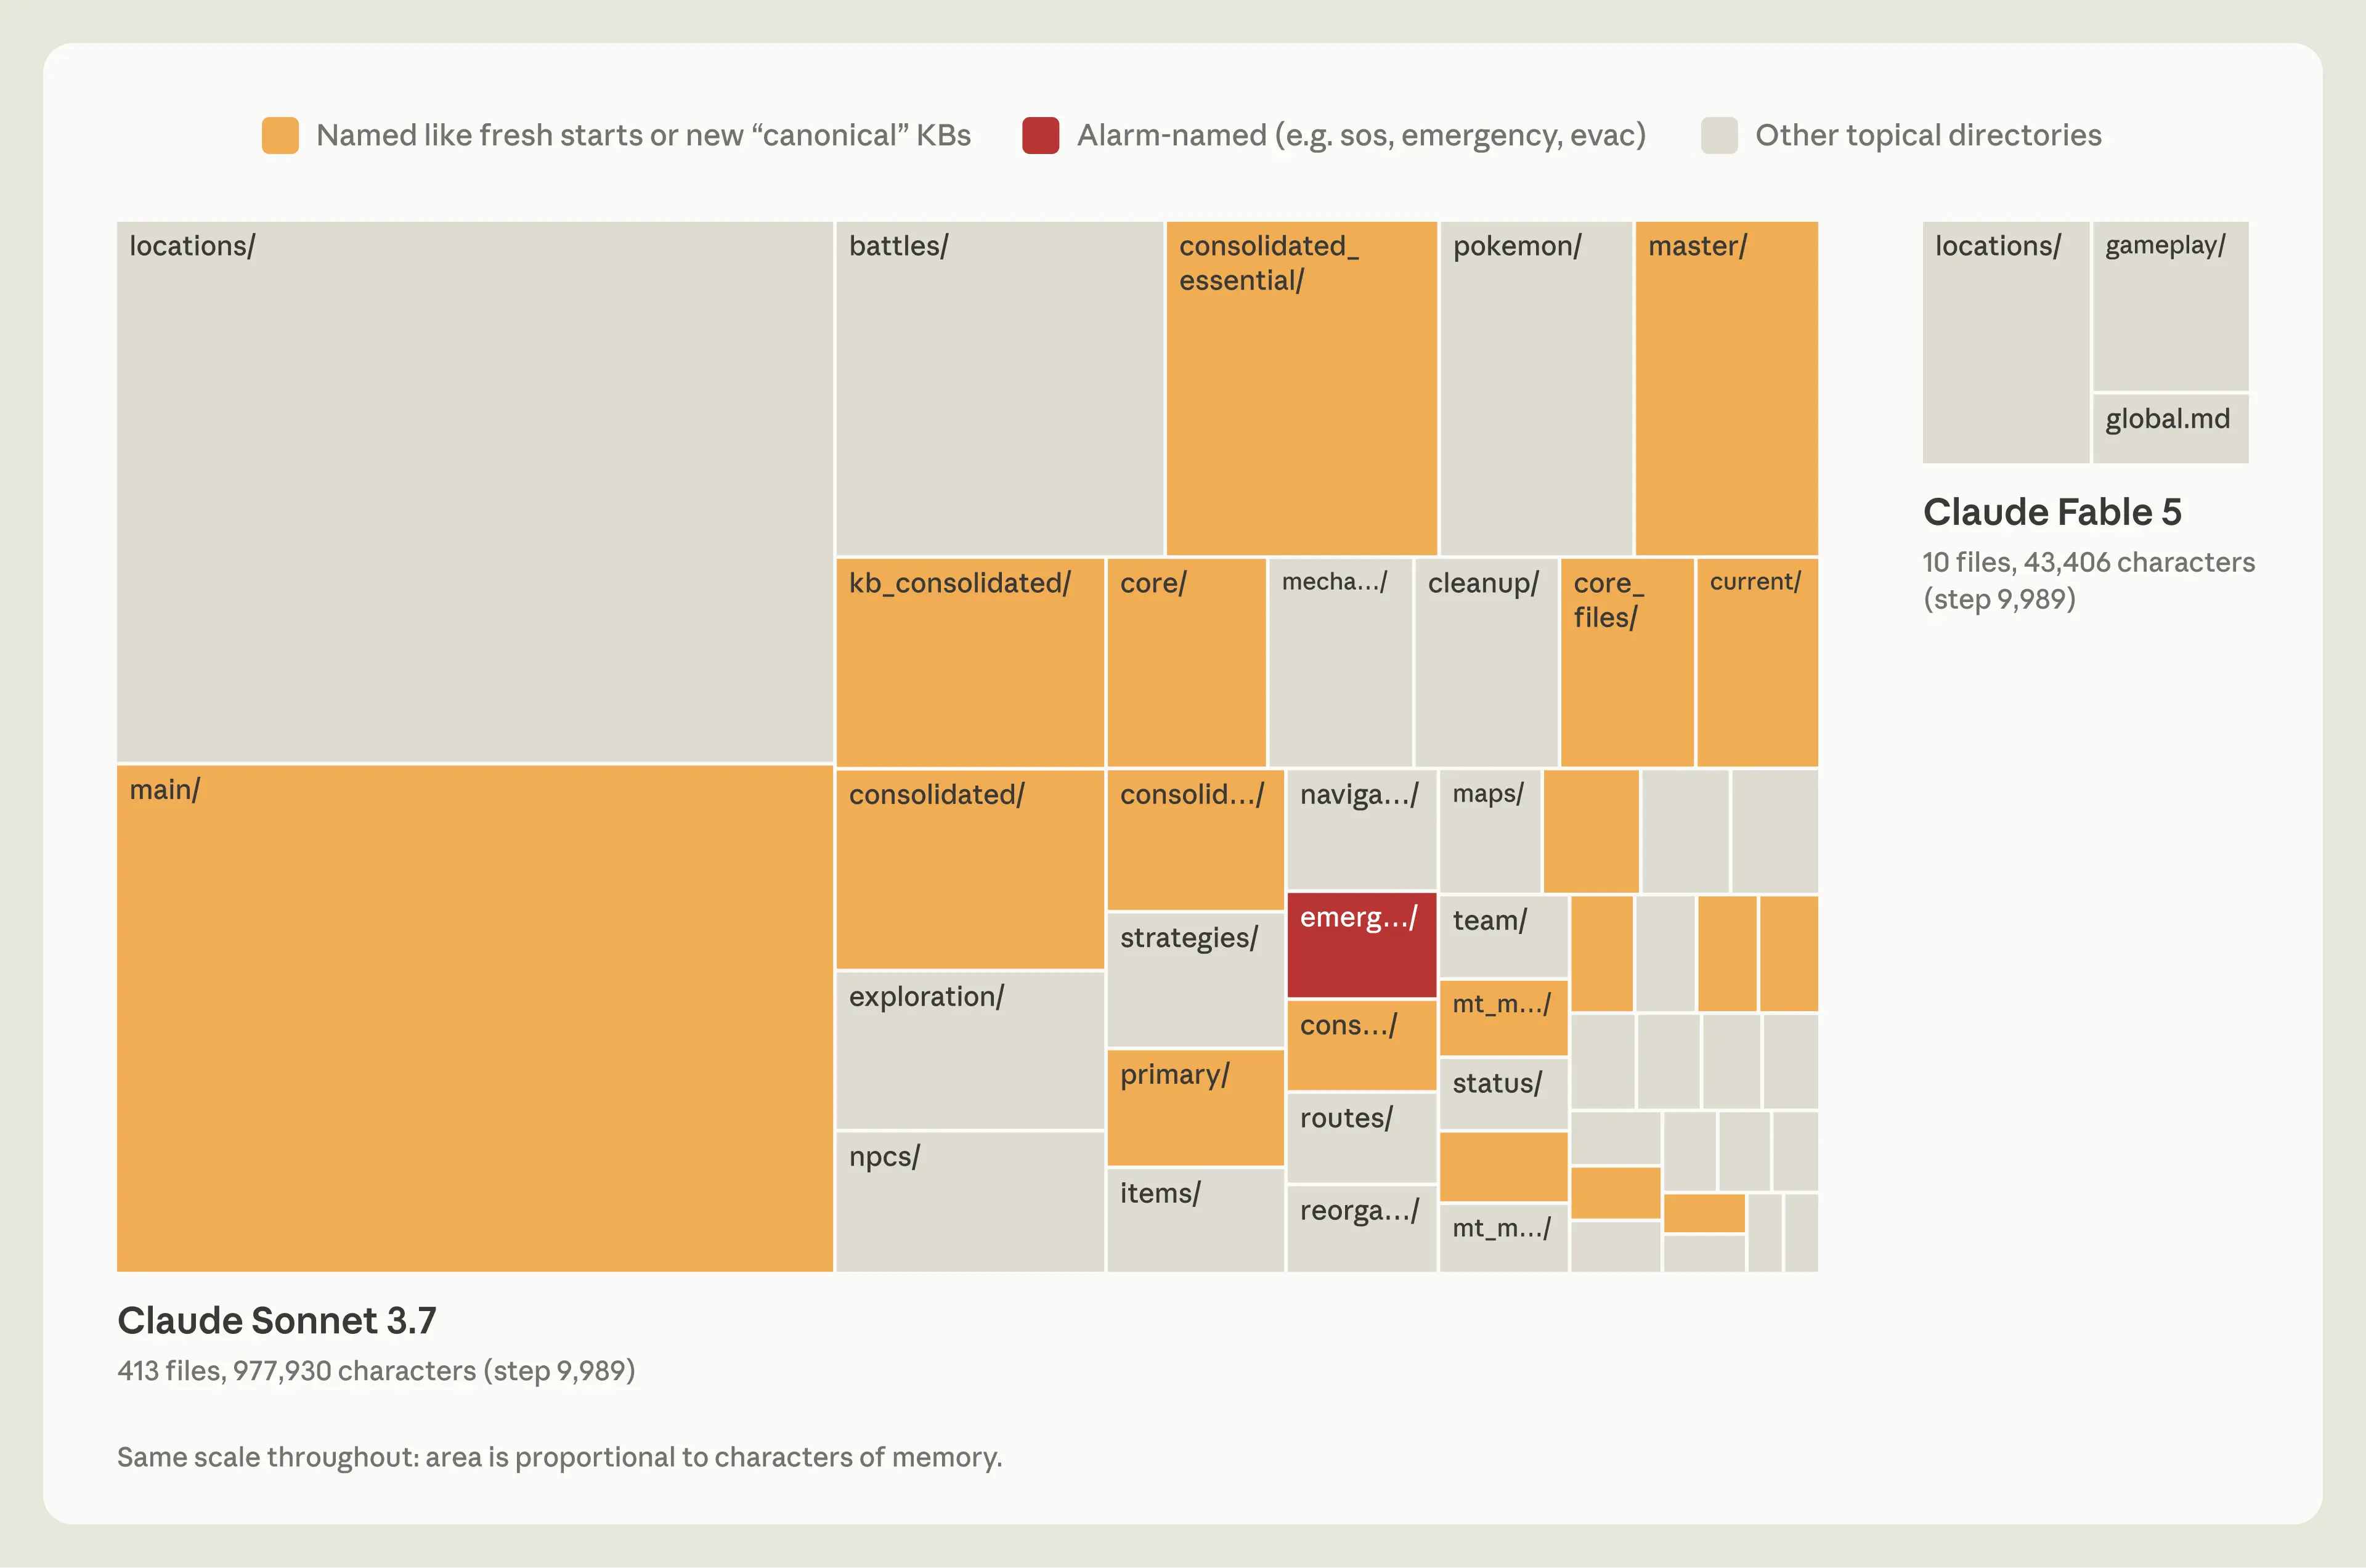
우리는 또한 Claude가 복잡한 장기 지평(long-horizon) 작업을 탐색하도록 도전하는 게임인 *포켓몬 레드 (Pokémon Red)*를 플레이하는 능력을 평가하여, 메모리에 무엇을 저장할지에 대한 Claude의 판단력을 테스트했습니다. 각 실행 시작 시, 우리는 각 모델에게 게임을 하는 동안 읽고 쓸 수 있는 메모리 파일 폴더를 제공했습니다 (그림 4).
우리는 Claude Sonnet 3.7과 Claude Fable 5의 각각 한 번 실행에서 얻은 메모리 폴더들을 비교했습니다. 두 모델 모두 게임 진행 단계가 약 10,000 스텝에 도달했을 때의 기록입니다. 우리가 발견한 핵심적인 차이점은 각 모델이 무엇을 기억할 가치가 있다고 판단했는지였습니다. Sonnet 3.7은 모든 것이 중요할 수 있다고 가정하고 무차별적으로 메모리에 기록했습니다. 그 메모리 폴더에는 만남에 대한 아카이브가 담겨 있었는데, 종종 싸운 전투마다, 발견한 아이템마다, 만난 비플레이어 캐릭터(NPC)마다 별도의 파일이 존재했습니다. 궁극적으로 Sonnet 3.7은 총 225개의 폴더에 걸쳐 413개의 메모리 파일을 작성했으며 배지 1개를 획득했습니다 (배지는 플레이어가 게임을 진행하며 달성한 진척도를 표시합니다).
반면, Fable 5는 두 개의 폴더에 9개의 파일과 global.md라는 단일 최상위 파일을 추가로 작성했고, 배지 4개를 획득했습니다.
Two treemaps of Pokémon memory directories at the same scale, where area shows characters of memory. Claude Sonnet 3.7’s is large and crowded, with 413 files and 977,930 characters across folders such as locations, main, battles, and several “consolidated” folders. Claude Fable 5’s is small, with 10 files and 43,406 characters in locations, gameplay, and global.md.
Sonnet 3.7의 접근 방식은 주로 포켓몬의 게임 상태가 끊임없이 변화한다는 점에서 문제가 되었습니다. Sonnet 3.7의 상세한 기록은 지속적으로 구식이 되어갔습니다. 그 결과, Claude가 진행됨에 따라 게임을 플레이하는 것보다 메모리를 뒤져보는 데 더 많은 시간과 자원을 할애해야 했습니다. 예를 들어, 약 10,000 스텝이 되었을 때 Sonnet 3.7은 “마스터” 메모리 파일의 네 번째 폴더를 시작했습니다. 이후 17스텝 동안 6개의 파일을 생성하고 9개를 삭제했으며, 게임 자체에서는 어떠한 행동도 취하지 않았습니다.
Fable 5의 접근 방식은 게임이 명시적으로 알려주지 않은 것에 메모리를 사용했습니다. Sonnet 3.7이 메모리에 기록했던 정보들 중 일부—예를 들어 플레이어가 가진 돈이나 지도상의 위치 같은 것—는 매 턴 화면에서 읽을 수 있기 때문에 저장하는 것이 불필요합니다. 이와 대조적으로, 전략, 계획, 그리고 테스트된 규칙에 대한 메모리 파일은 Claude가 직접 추론해내지 않으면 존재하지 않으며, Claude가 기록하지 않으면 사라집니다.
Fable 5는 이에 맞춰 메모리를 구성했습니다. 그 global.md 파일은 현재 목표, 체육관 공략을 위한 미리 작성된 계획(배지를 얻는 도전 과제), 그리고 메모리 사용에 대한 모델 자체의 규칙 등을 담고 있는 대시보드 역할을 했습니다. locations 폴더에는 특정 경로를 탐색하기 위한 계획이 담겨 있었고, gameplay
폴더는 게임 작동 방식에 대해 학습한 내용을 바탕으로 전략을 담고 있었습니다. 예를 들어, Magikarp(잡기 가장 쉬운 포켓몬 중 하나)를 잡는 데 연속으로 7개의 Poké Ball이 실패하자 Claude는 "만약 3개 이상의 공이 연속으로 실패하면 타이밍을 변경하세요 (메뉴 단계 사이에 추가 '대기' 키 입력을 삽입) - 이렇게 하자마자 잡기가 성공했습니다."라고 작성했습니다.
훨씬 작은 메모리 폴더를 사용한 Fable 5는 Sonnet 3.7보다 게임에서 훨씬 더 많이 진행했습니다. Opus 5.5도 유사한 접근 방식을 취했는데, 현재 목표와 다음 단계를 추적하는 작은 메모 노트 폴더를 유지하고, 플레이하면서 이를 재작성하여 게임을 클리어했습니다.
Claude에게 메모 작성 지침 제공하기 (Steering Claude to write memory)
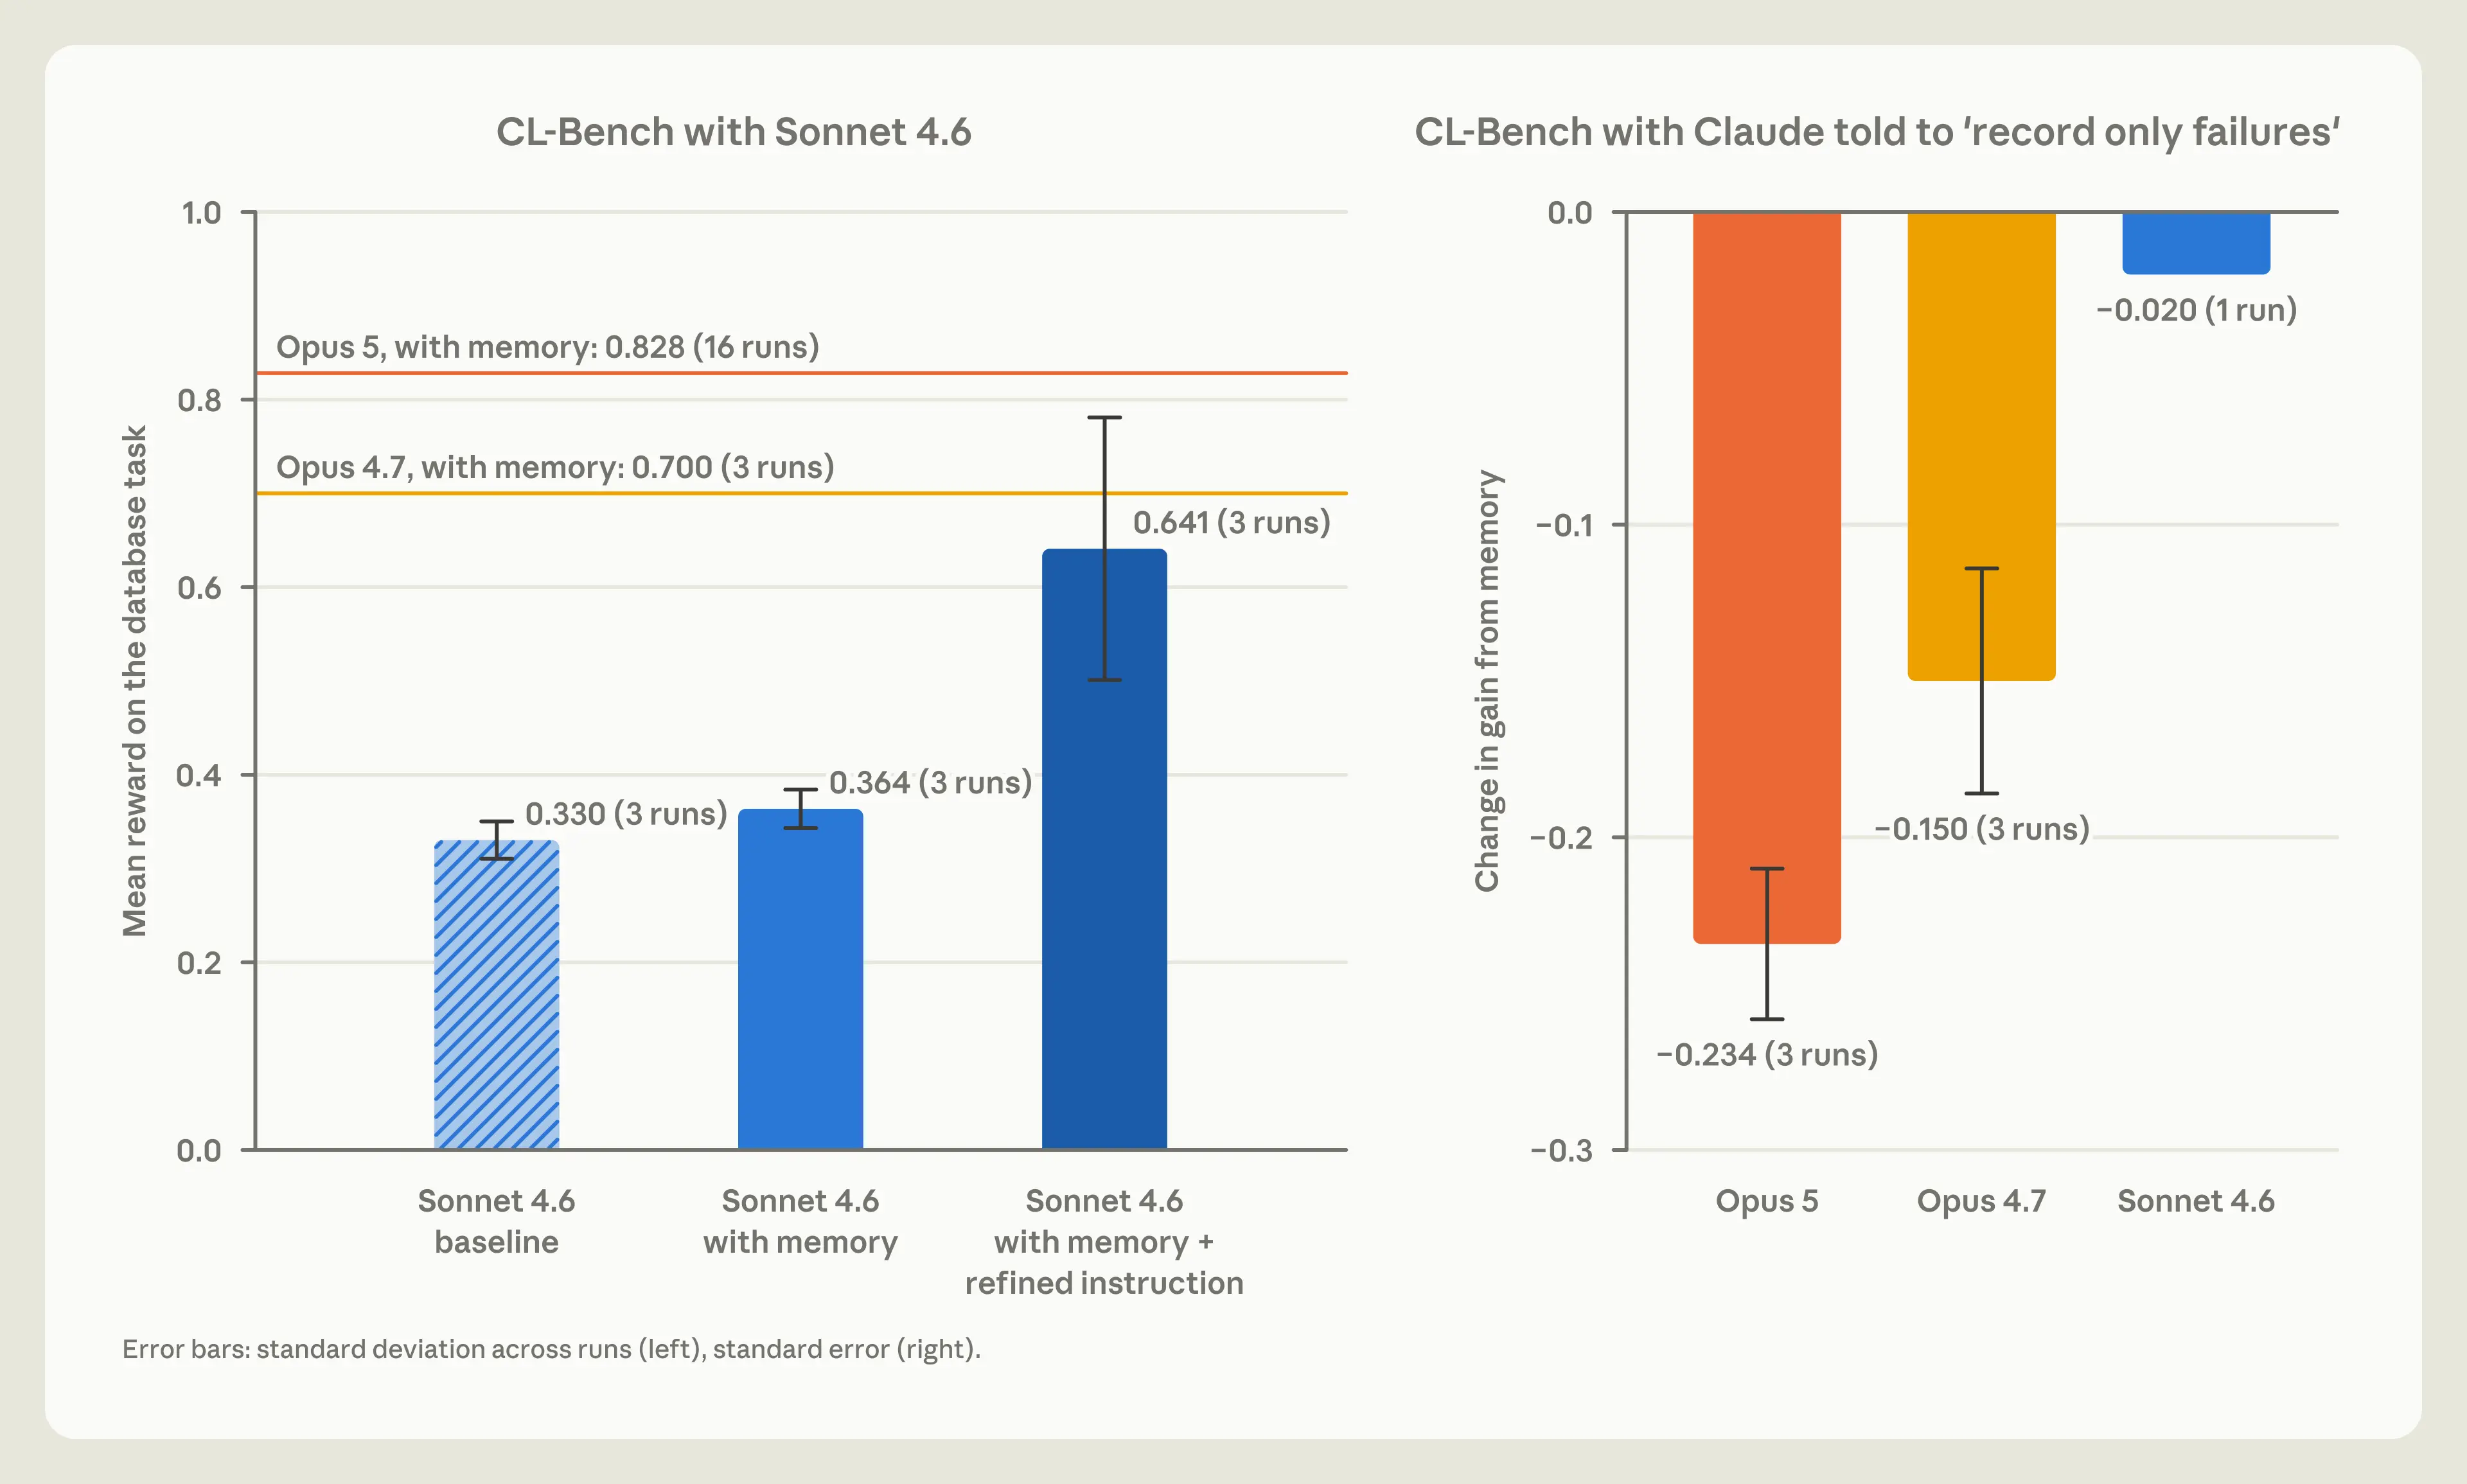
우리는 Claude에게 메모가 무엇을 위한 것인지 알려주는 것이 도움이 되지만, 어떻게 사용해야 하는지까지 알려줄 필요는 없다는 것을 발견했습니다. CL-Bench에서 우리는 단순히 Claude에게 메모 폴더가 이용 가능하다는 사실만을 알려주었습니다. 이 일반적인 지침만으로도 Opus 4.7과 Opus 5가 메모를 효과적으로 사용하는 데 충분했으며, 두 모델 모두 눈에 띄는 성능 향상을 보였습니다 (그림 3).
또한 우리는 모델들에게 메모에 무엇을 작성해야 하는지에 대한 특정 규칙(테스트당 하나의 규칙)을 제공하는 것도 테스트했습니다. 우리는 각 모델이 특정 규칙과 함께 메모를 사용했을 때 얻는 이득과 그렇지 않았을 때의 이득을 비교했습니다. "실패만 기록하라"는 규칙을 설정했을 때, Opus 5와 Opus 4.7 모두 메모가 주었던 성능 향상의 상당 부분을 잃었습니다 (그림 5, 오른쪽). 더 강력한 모델들의 경우, 미리 고정된 규칙을 설정하는 것보다 중요도(salience)를 판단할 자유를 주는 것이 더 효과적이었으며, 이러한 규칙은 오히려 성능을 약화시킬 수도 있었습니다.
Left: bar chart of Sonnet 4.6’s mean reward on the CL-Bench database task: 0.330 at baseline, 0.364 with memory, and 0.641 with memory and refined instruction. Reference lines mark Opus 4.7 with memory at 0.700 and Opus 5 with memory at 0.828. Right: change in memory gain when told to record only failures: Opus 5, −0.234; Opus 4.7, −0.150; Sonnet 4.6, −0.020.
또한 우리는 지침 제공(steering)이 구형 모델들에게 가장 큰 도움이 된다는 것을 알아차렸습니다. 예를 들어, Sonnet 4.6은 종종 메모 디렉토리의 파일을 읽지 못했고, 답변이 틀린 이유에 대한 자신의 가설을 테스트하는 데 실패했습니다.
이 경우, 답변하기 전에 메모리 파일을 읽고—그리고 명시적으로 가설을 테스트하도록—Claude에게 프롬프트를 제공하자 벤치마크 점수가 거의 두 배가 되었습니다(Figure 5, 왼쪽). Sonnet 5는 이를 스스로 수행합니다. 요청받지 않았음에도 불구하고, 답변하기 전에 메모리를 10번 중 9번 읽었습니다. 비교하자면, Sonnet 4.6은 이보다 절반도 적게 수행했습니다.
최신 Claude 모델을 사용할 때는 일반적으로 사용자가 요청하거나 무언가 기억할 가치가 명확한 경우에 메모리 노트를 생성하도록 간단한 지침을 제공하며, 그 판단은 Claude에게 맡깁니다.
꿈꾸기(Dreaming)는 메모리를 수정할 수 있다
Claude가 세션 중 중요하다고 판단되는 것을 기반으로 메모리에 기록하기 때문에, 처음부터 잘못되었거나 환경이 변함에 따라 흐릿해지는 노트는 나중에 다른 세션에서 Claude에 의해 읽히고 신뢰될 수 있습니다.