
새로운 Linux 기술, RAM 내 메모리를 압축하여 452배의 속도 향상을 제공하는 새로운 CRAM 방식
요약
CRAM은 기존 Linux의 스왑 계층(swap-layer) 방식인 ZRAM을 우회하여 메모리 압축에 대한 새로운 접근 방식을 제시합니다. 이는 폴트 처리와 스왑 동작에서 오는 성능 저하를 해결하고, 순수하게 메모리 내에서 고성능 압축을 가능하게 합니다. CRAM은 사설 NUMA 노드 및 Linux의 기존 메모리 관리 메커니즘을 활용하여 읽기(reads) 작업에서 급진적으로 높은 성능 향상을 제공하는 것이 핵심입니다.
핵심 포인트
- ZRAM과 달리 스왑 계층을 우회하여 순수 메모리 압축 구현.
- 폴트 처리와 스왑 동작으로 인한 성능 저하 문제를 해결함.
- 사설 NUMA 노드 및 Linux의 메모리 의미론 활용이 특징.
- 데이터의 압축 가능성 변화에 따른 복잡한 메모리 관리 메커니즘을 가짐.
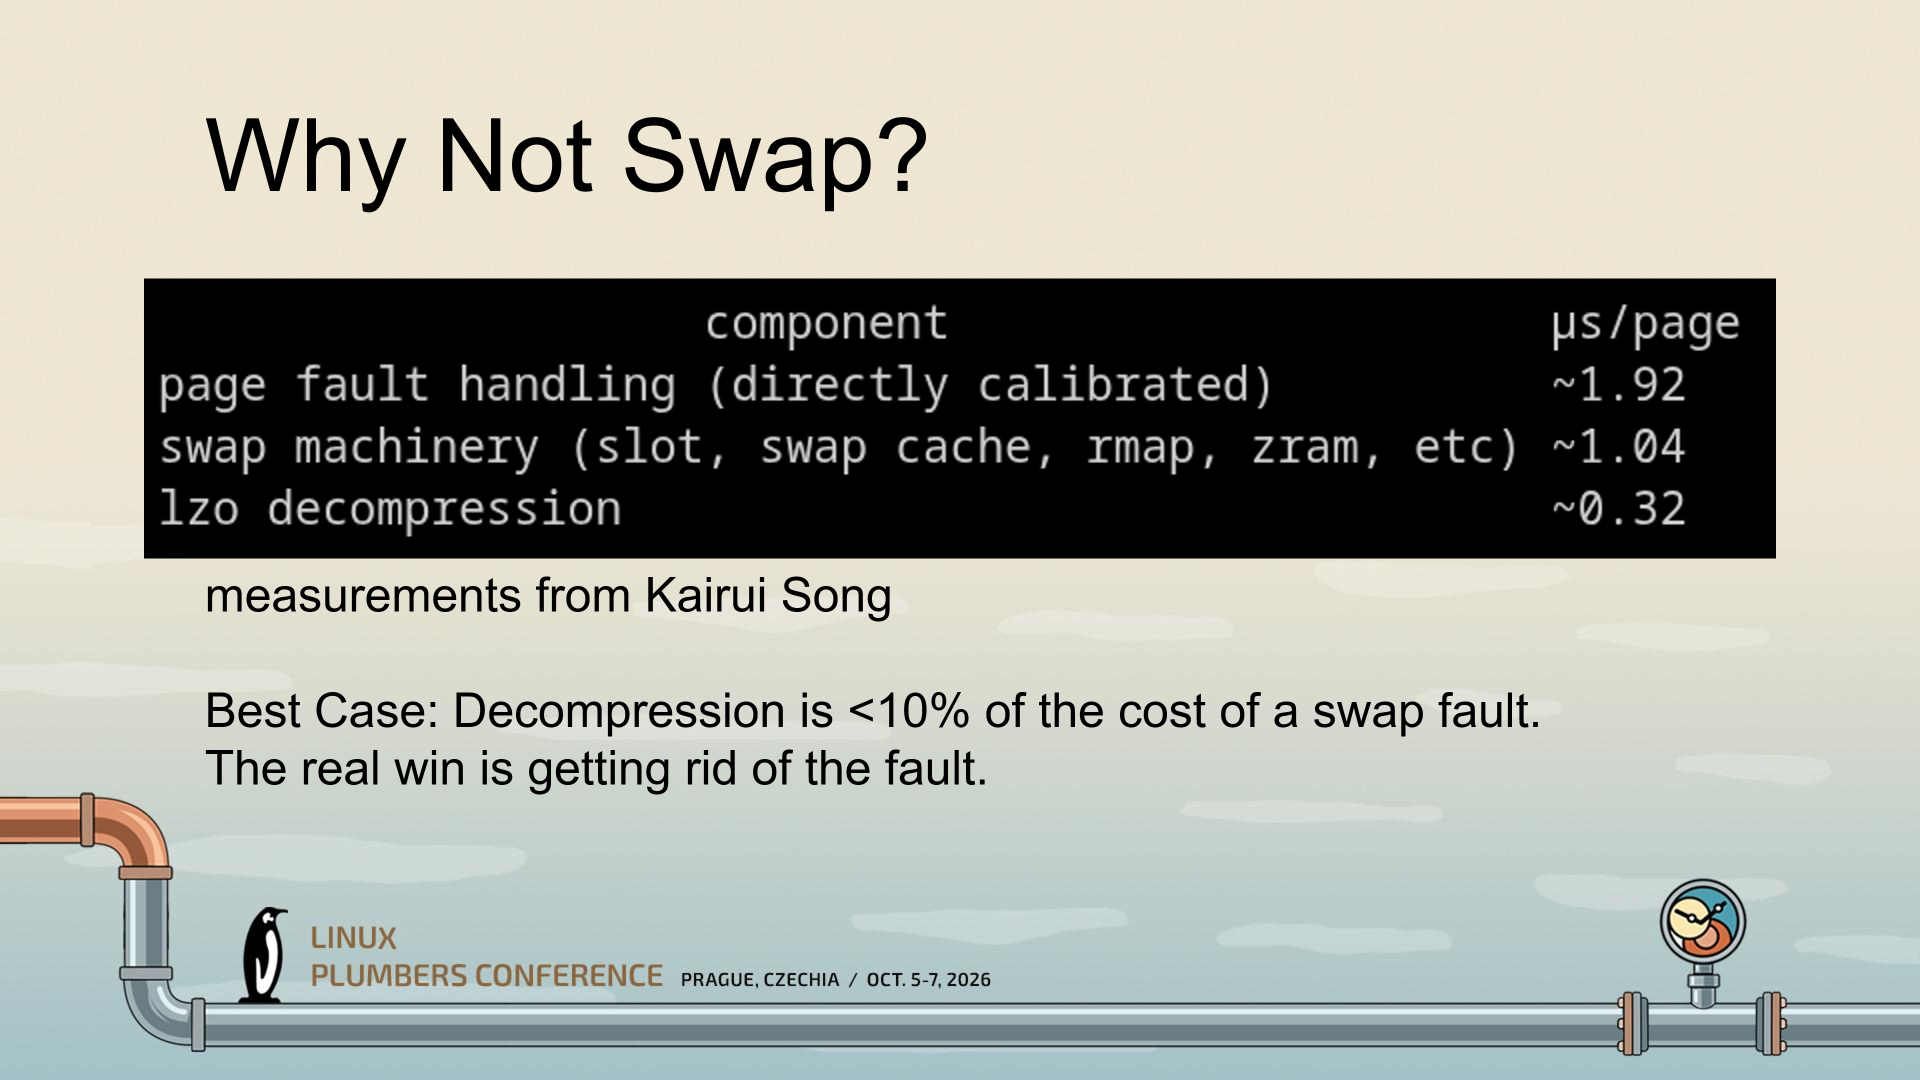
CRAM이라는 새로운 압축 모델은 스왑을 완전히 우회하고 압축된 데이터를 메모리에 유지함으로써 압축에 대한 다른 경로를 제공하며, ZRAM보다 최대 452배 높은 성능을 제공합니다. 제가 1990년대에 어렸을 때 이 아이디어가 너무 간단하게 느껴졌던 적이 있습니다. PKZIP으로 파일을 압축할 수 있으니, 왜 RAM에도 그렇게 할 수 없냐는 것이었습니다. 실제로 저 혼자만의 천재적인 발상은 아니었고, 다른 많은 사람들도 같은 생각을 했기 때문에 메모리 압축은 오랫동안 대부분의 운영체제 기능이 되어 왔습니다. Linux에서 가장 인기 있는 옵션은 zswap과 ZRAM이지만, 이 두 가지 옵션 모두 근본적으로 스왑 계층(swap-layer) 기능입니다. CRAM은 성능을 엄청나게 끌어올린다고 주장하는 새로운 접근 방식입니다.
(Image credit: Gregory Price/Meta)
CRAM은 Meta의 Gregory Price와 그의 팀에 의해 개념화되었습니다. CRAM 개발을 촉발한 것으로 보이는 핵심적인 깨달음은 압축된 메모리 성능 저하의 가장 큰 부분이 압축 자체가 아니라는 것입니다. 그 부분은 아주 미미합니다. 아닙니다, 가장 큰 문제는 명백히 폴트(fault) 자체와 스왑 동작에서 비롯되는 것 같습니다. 그래서 생각은 'zram을 하되, 스왑으로 하는 것이 아니라 완전히 메모리 내에서만 하면 어떨까?'였던 것 같습니다.
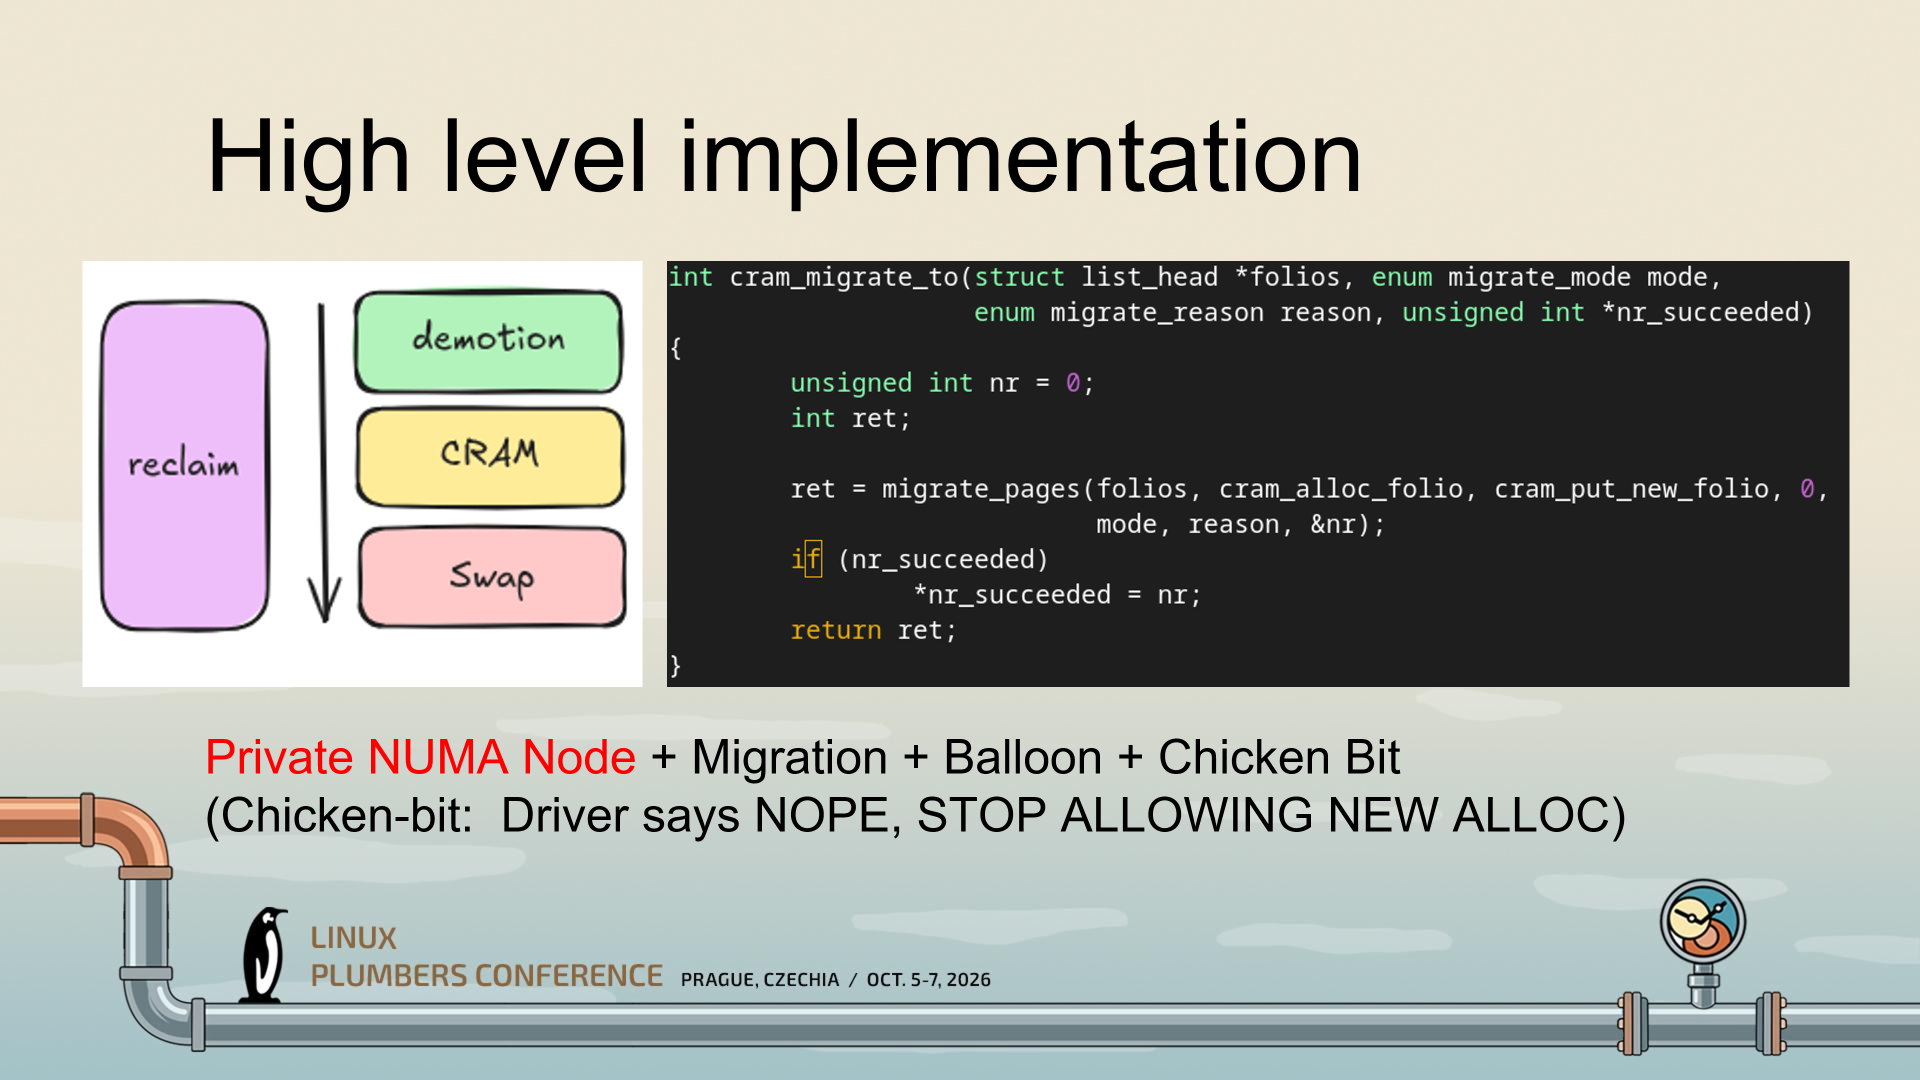
이것은 엄청나게 복잡한 프로젝트를 지나치게 단순화한 것이지만, CRAM이 하는 것은 Linux가 이미 가지고 있는 메커니즘을 활용하여 특히 읽기(reads)에서 급진적으로 높은 성능의 압축 메모리를 가능하게 하는 것으로 보입니다. 이는 블록 장치처럼 흉내 내는 대신 사설 NUMA 노드(본질적으로 유령 CPU)를 사용하며, 이로 인해 Linux가 마이그레이션(migration)과 벌룬잉(ballooning)을 포함한 모든 메모리 의미론(memory semantics)을 사용하여 CRAM을 관리할 수 있게 합니다.
(Image credit: Gregory Price/Meta)
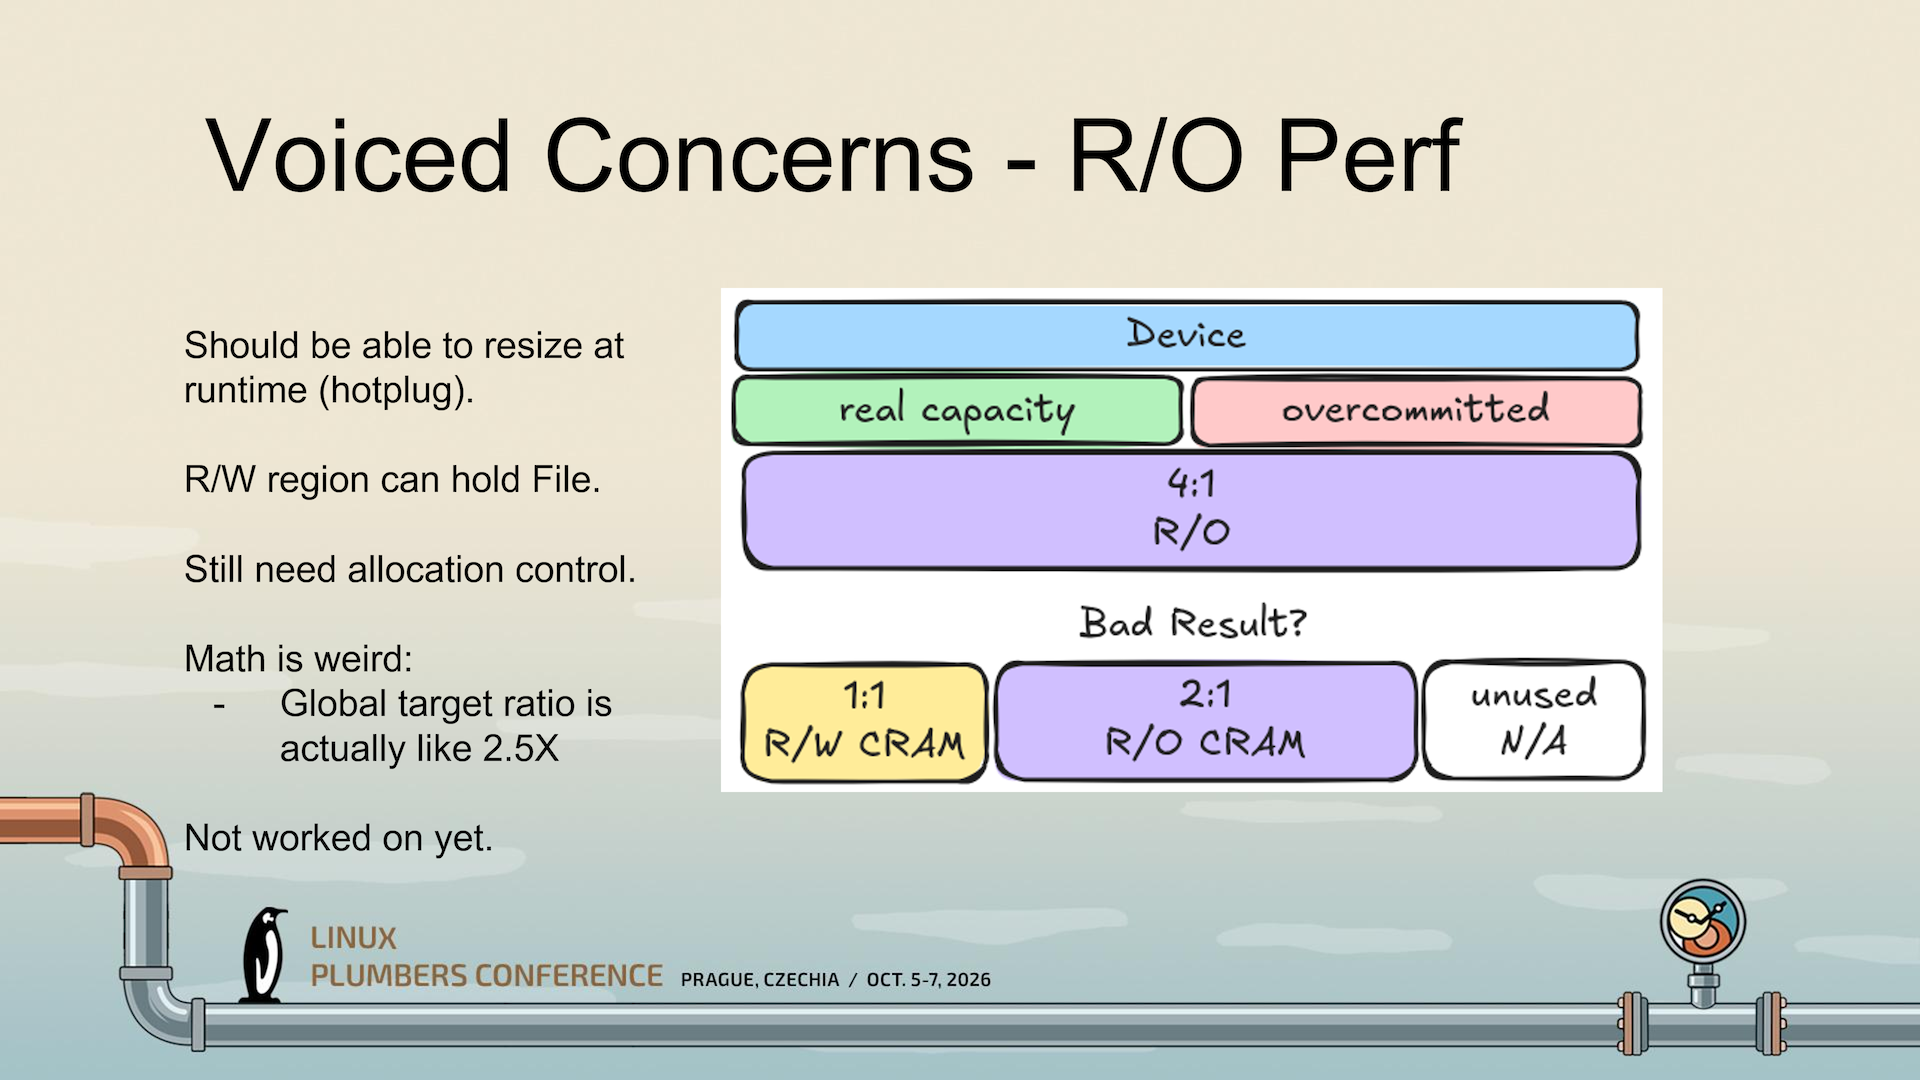
핵심적인 부분은 'Chicken Bit'인데, 이는 Linux에게 메모리 할당을 관리하는 동안 CRAM 사용을 중단해야 한다고 알려줍니다. 보시다시피, 압축된 메모리는 간단해 보이지만 실제로 생각해보면 복잡합니다. 무엇을 압축하느냐에 따라 데이터의 [압축 가능성(Compressibility of data)]이 엄청나게 달라지기 때문입니다. 아무리 큰 0의 더미(완벽하게 압축 가능함)부터 이미 압축된 데이터(비압축 가능함)까지 다양합니다. 이런 상황에서, 일부가 압축되어 있을 때 '논리적' RAM 용량이 얼마나 되는지 어떻게 알 수 있을까요? 그리고 언제 부족해질지 어떻게 알 수 있을까요?
(이미지 출처: Gregory Price/Meta)
CRAM은 아직 이 문제를 완전히 해결하지 못한 것 같습니다. 제가 참고하는 슬라이드 자료를 보면, 이는 미해결 문제이자 지속적인 연구 영역으로 제시됩니다. 하지만 Chicken Bit은 쓰기 작업이 CRAM의 할당 능력을 초과할 때 발생하는 연쇄 장애(발표에서는 화려하게 '독소 폭풍(poison storm)'이라고 불림)를 최소한 막을 수 있는 방법 중 하나입니다.
(이미지 출처: Gregory Price/Meta)
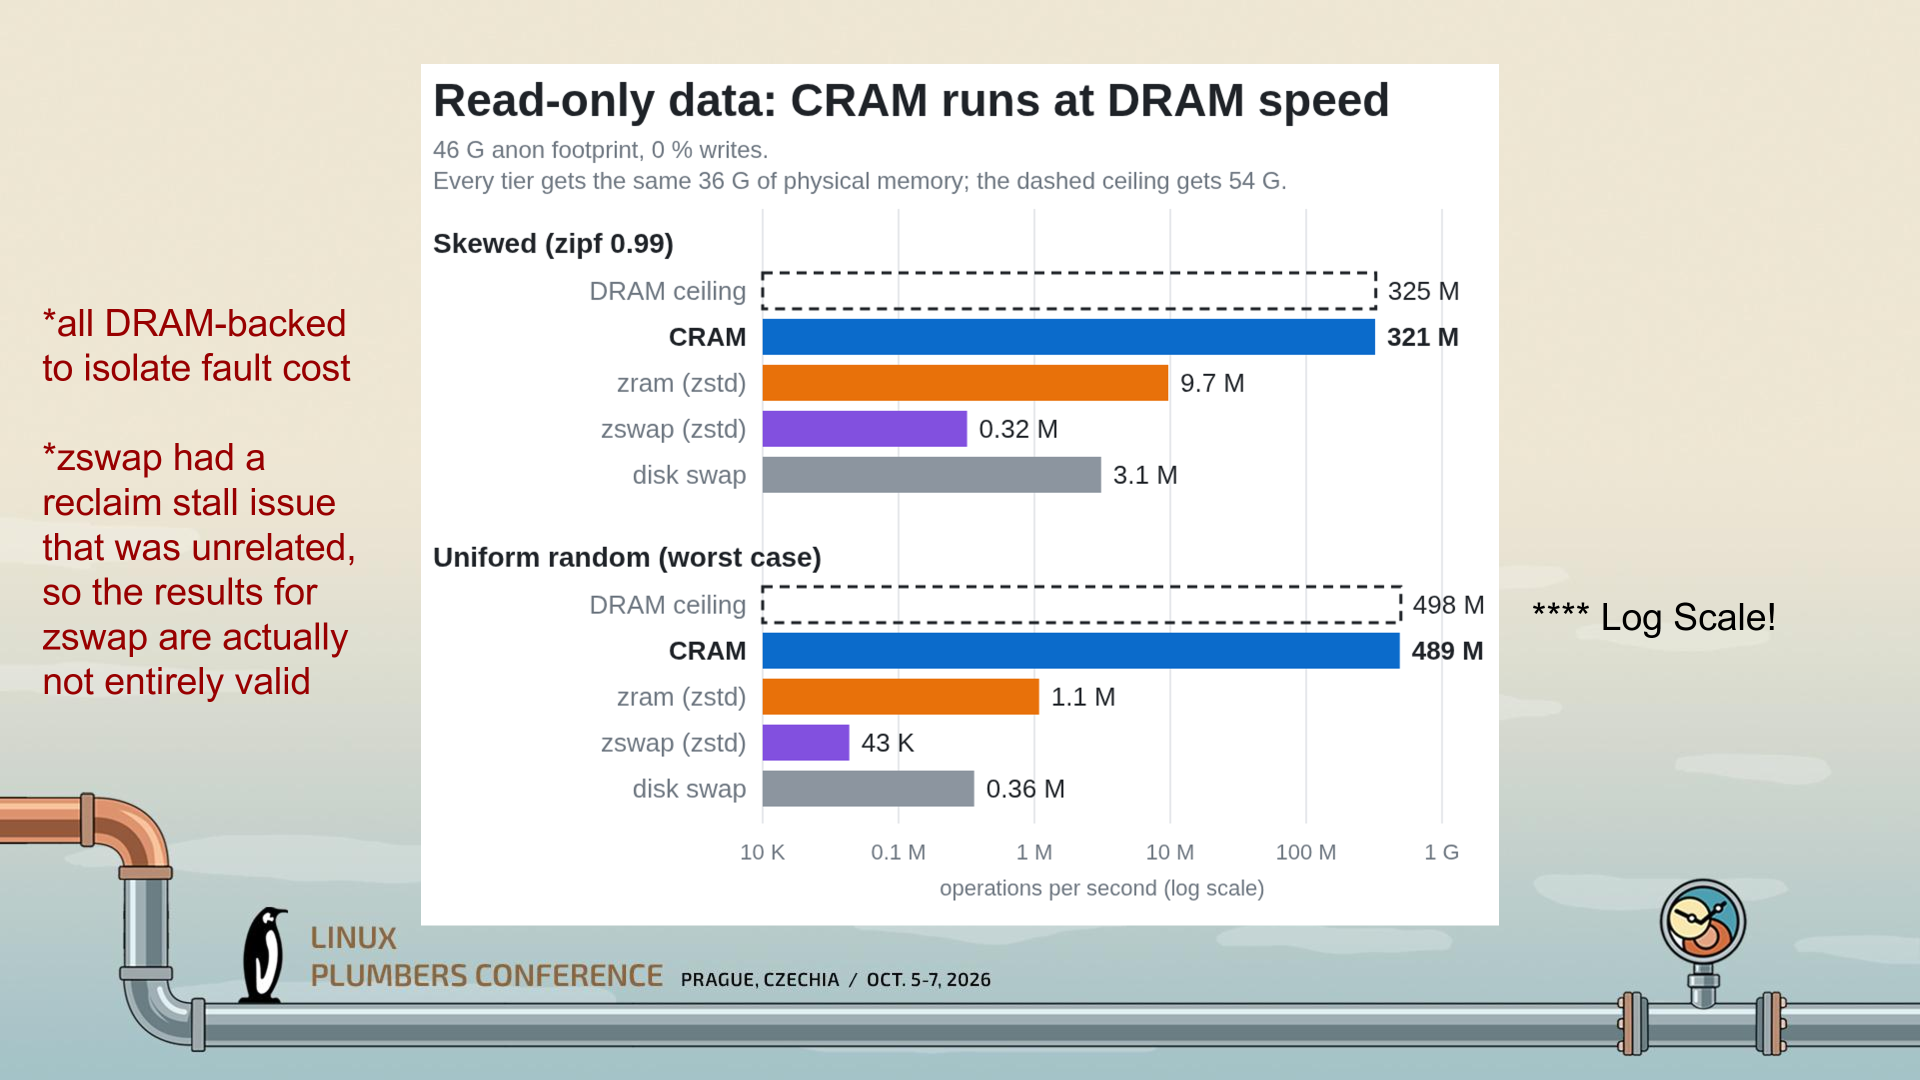
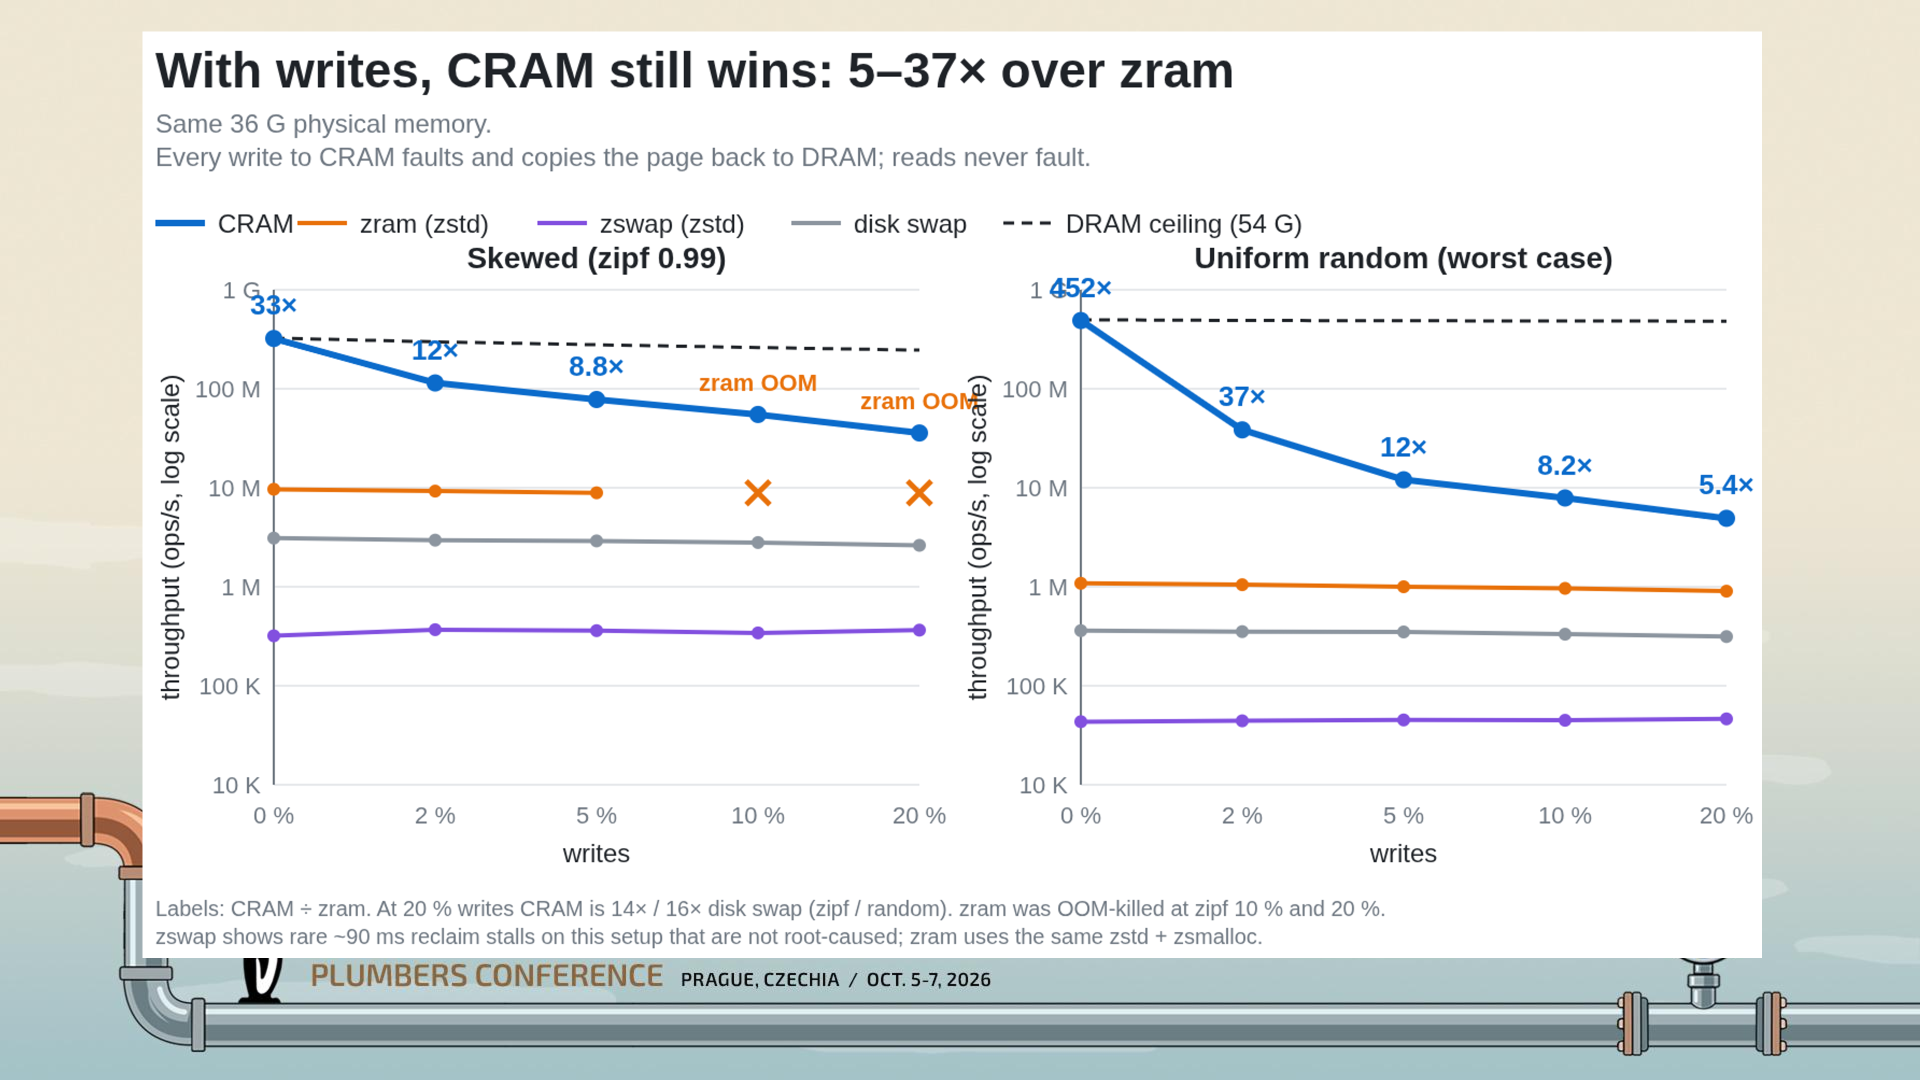
CRAM은 RAM에 저장되고 RAM처럼 취급되기 때문에, [전체 캐시 라인/바이트 접근(full cacheline/byte access)]이 가능하여 읽기 전용 방식으로 적은 지연 시간으로 접근할 수 있습니다. 단지 하드웨어 오프로드 압축 비용만 발생합니다. 그 결과 CRAM은 발표자료에서 언급했듯이 'DRAM 속도로 작동'합니다. 그래프가 이미 인상적이지만, 이는 로그 스케일입니다. 최악의 경우 CRAM은 초당 4억 8,900만 번의 연산을 수행하는 반면 ZRAM은 110만 번에 불과하여 비교하기 어려울 정도입니다.
(이미지 출처: Gregory Price/Meta)
쓰기(writes)를 활성화하더라도 CRAM은 여전히 ZRAM보다 훨씬 빠릅니다. 20%의 쓰기가 테스트된 최악의 경우에도 5.4배 빠르죠. 이는 읽기 전용(read-only)인 452배 사례와 비교하면 큰 하락이지만, 맥락을 유지해 주십시오. 5.4배 속도 향상 자체는 여전히 엄청난 성능입니다. 쓰기가 관련될 때 발생하는 막대한 성능 저하의 원인은 페이지 폴트(page fault)가 발생하고 folio를 원래 NUMA 도메인으로 마이그레이션해야 하는 필요성 때문인데, 이는 압축된 데이터에 직접 쓸 수 없기 때문에 모든 것을 손상시키게 됩니다.
CRAM에 대한 제 설명이 완전히 정확하지 않을 수도 있습니다. 저는 프라하에서 열린 Linux Plumbers' Conference에 참석하여 발표를 직접 들은 것이 아니므로, 세션 정보 사이트(h/t to Phoronix for the spot)에서 이용 가능한 슬라이드를 바탕으로 작업하고 있습니다. 하지만 Price가 전달하려는 요점은 파악한 것 같습니다.
여기서 명백한 목표(Meta Platforms 출신이라는 점을 감안할 때)는 대형 Linux 서버이지만, ZRAM과 Zswap은 Steam Deck처럼 제약이 많은 기기에서도 리눅스 생태계 전반에 걸쳐 사용됩니다(https://www.tomshardware.com/video-games/handheld-gaming/steam-deck-oled). 많은 배포판이 기본적으로 이 중 하나를 활성화합니다. CRAM은 이러한 기기들 중 일부에 상당한 속도 향상을 제공할 수 있을 것 같으니, 남은 구현 질문들이 답변된다면 커널에 통합되기를 바랍니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기