
메모리가 예전엔 얼마나 저렴했는지 잊으셨을 겁니다. 이제는 그렇지 않습니다
요약
Hot Chips 2026 컨퍼런스에서 메모리 시장 현황이 논의되었으며, DRAM, HBM, 플래시 등 모든 스토리지 가격이 급등하고 있음이 강조되었습니다. 이러한 호황은 하이퍼스케일러와 클라우드 빌더들이 강력한 GenAI 모델 훈련 및 추론 작업을 위해 막대한 컴퓨팅 자원을 확보하려는 수요 충격에 기인합니다.
핵심 포인트
- GenAI의 발전으로 HBM, DRAM, 플래시 등 모든 메모리/스토리지 가격이 급등하고 있습니다.
- 주요 수요 동력은 하이퍼스케일러와 클라우드 빌더들의 AI 인프라 구축입니다.
- 기술 거대 기업들이 막대한 자본을 투입하며 스토리지 시장의 호황을 주도하고 있습니다.
- AI를 활용하되 직접적인 대규모 투자나 이윤 창출 계획이 없는 기업은 상대적으로 주목도가 낮습니다.
STORE
메모리가 예전엔 얼마나 저렴했는지 잊으셨을 겁니다. 이제는 그렇지 않습니다
Hot Chips 2026 컨퍼런스는 일요일에 반나절 분량의 튜토리얼 세션으로 시작되었고, 반도체 시장 조사 회사인 Objective Analysis의 총괄 디렉터 Jim Handy가 DRAM, HBM, 플래시 시장 현황을 설명하며 메모리 튜토리얼을 진행했습니다. 이는 이후 고대역폭 메모리(HBM)와 고대역폭 플래시(high bandwidth flash)에 대한 발표를 위한 무대를 마련해 주었습니다.
Micron Technology, Samsung, SK Hynix, d-Matrix 및 Meta Platforms, Oxmiq Labs 등으로부터의 모든 기술 발표는 개별적으로 다룰 것이지만, Handy처럼 저는 DRAM과 플래시에서 일어나고 있는 절대적으로 천문학적인 가격 수준에 대해 기준을 맞추는 것이 중요하다고 생각합니다. 왜냐하면 우리는 막대한 수요 충격이 공급 부족이라는 것과 정면으로 부딪히고 있기 때문입니다.
주요 원인은 하이퍼스케일러(hyperscalers)와 클라우드 빌더들이며, 이들은 점점 더 강력한 GenAI 모델을 훈련할 플랫폼이자, 이러한 모델이 프로덕션 환경에서 실행될 때 많은 추론(inference) 작업이 이루어질 곳이 되기를 열망하고 있습니다. 이것이 HBM과 GPU/XPU의 호황은 물론, 부수적인 DRAM 및 플래시의 호황을 이끌고 있습니다. 또한 에이전틱 AI(agentic AI)의 부상은 엄청난 양의 CPU뿐만 아니라, 이를 유용하게 만들기 위해 어느 정도의 DRAM과 플래시를 필요로 합니다. 이는 우리가 에이전트에게 부여하는 작업을 수행하기 위해 생성된, 어쩌면 형편없는 Python 코드 묶음(scads of possibly crappy Python code)을 테스트할 수 있는 샌드박스를 만들거나, 애플리케이션이 현대화되거나 우주적 에테르(Ethernet)에서 완전히 새로 만들어질 때의 코드를 포함합니다.
다음은 Handy가 2021년 초부터 올해 2분기까지 조사한 지출 현황입니다:
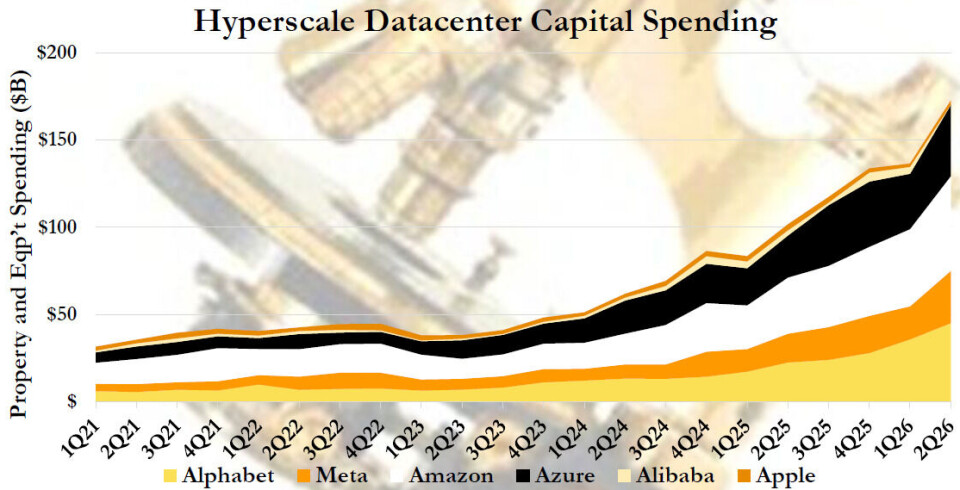
이 차트에서 흥미로운 점은 중국 최대의 하이퍼스케일러이자 클라우드 사업을 영위하는 Alibaba가 미국 빅 4 기술 거대 기업들의 막대한 지출 규모에 비하면 거의 눈에 띄지 않는다는 것입니다. 순서대로 말하자면, Amazon Web Services, Google(Alphabet이 실제로 투자하는 것은 검색 엔진, 광고, 그리고 클라우드 부문입니다), Microsoft Azure, Meta Platforms가 그렇습니다. AI를 사용하지만 직접 만들지는 않는 Apple은 거의 한 줄에 불과하며, 사실 2026년의 AI 자본 투자는 이전 5년간보다 적습니다.
제 말은, 만약 이윤을 내면서 AI를 판매할 수 있고 자본 투자까지 할 필요가 없다면 나아가라, 존재하라, 실행하라는 것입니다.
하이퍼스케일러와 클라우드 빌더들의 수요, 그리고 기업, 정부, 학계로부터의 새로운 라운드 투자가 들어오면서, 이들은 GenAI 시스템을 위한 효율적인 백 오피스(back office), 웹 인프라, 데이터 분석 컴퓨팅을 확보하려 합니다. 그 결과, 하드 디스크 드라이브(HDD)에 이르기까지 모든 종류의 스토리지 가격이 급등하고 있습니다. 기술 거대 기업들이 거의 콜드 스토리지(cold storage)로 소비하는 이 영역에서 말이죠. 그래서 메모리와 플래시를 만드는 빅 5 업체들은 마치 도둑처럼 돈을 벌고 있는 것을 Handy가 집계한 매출액에서 볼 수 있습니다:
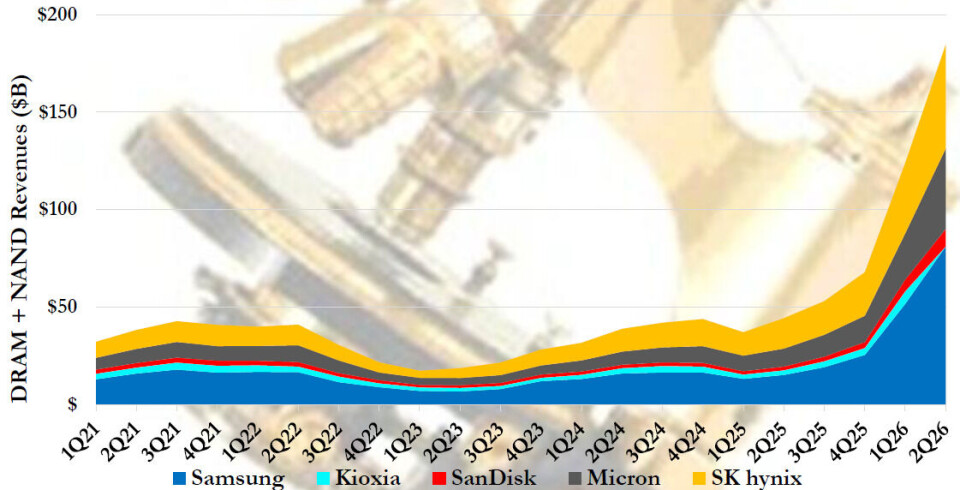
2022년 후반과 2023년 초의 메모리 및 플래시 급락세를 보십시오. 이때는 역설적으로 GenAI가 막 시작되던 시기였습니다. 만약 GenAI 붐이 계속된다면—그리고 제가 본 모든 예측은 적어도 2030년까지 성장하고 그 이후에도 부족 현상이 지속될 것이라고 보여줍니다—그렇다면 매출액이 선형적인 비율로 계속 증가할 것이라고 믿을 이유가 없습니다.
핸디(Handy)는 조립된 '핫 칩스(Hot Chips)' 청중에게 플래시, DRAM, HBM을 언급하며 설명했습니다. “이 모든 것이 같은 제조 라인에서 만들어집니다. 그래서 이것 때문에 DDR 가격이 미쳐 날뛰고, 모든 NAND 플래시 가격도 미쳐 날뛰며, 엄청난 매출이 발생합니다. 이 엄청난 매출은 사실상 이 제품들이 상품(commodity)이기 때문에 발생하는 것입니다. 기본적으로 ABC 공급업체로부터 NAND 플래시를 구매할 수 있고 전환이 매우 쉽습니다. 이것이 바로 상품이라는 의미입니다. 당신은 제조사에 크게 신경 쓰지 않고, 주로 어떤 가격을 받을 수 있는지에만 관심이 있습니다. 하지만 이는 또한 제조사들이 부족 현상이 있을 때 당신에게 신경 쓰지 않는다는 것을 의미합니다. 그리고 그들은 '좋아, 우리는 이 회사와 한동안 거래했지만, 제때 대금을 지불하지 않았고, 어쨌든 저쪽에 있는 그 사람에게서 더 높은 가격을 받을 수 있으니'라고 말할 수 있고, 그래서 그들은 더 높은 가격을 받으러 가고, 그리하여 현물 시장에서 약 7배 정도 오른 이런 가격들이 생겨납니다. 이것이 아주 좋은 지표는 아니지만 측정하기 쉬운 지표라 여기에 적었습니다.”
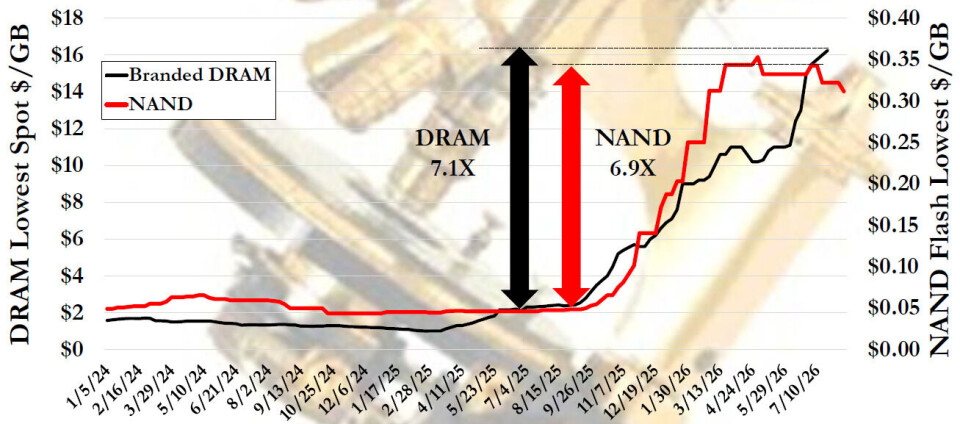
패키지에 메모리가 통합된 시스템이나 칩을 만드는 모든 사람들은 (HBM이든 LPDDR5X DRAM이든) 자신들만의 거래와 가격 및 물량 약속을 합니다. 어떤 회사들은 이러한 요인에 따라 현물 시장보다 더 잘하고, 어떤 회사들은 더 못합니다.
예를 들어, 수년간 딥러닝 시대와 AI 붐 초기에 HBM 메모리의 최대 물량 구매자였던 Nvidia는 HBM의 가격을 상당 부분 통제해 왔습니다. (2024년 2월 기사 He Who Can Pay Top Dollar For HBM Memory Controls AI Training에서 더 자세한 내용을 확인할 수 있습니다.) 하지만 이제 Broadcom은 자체 XPU 사업 덕분에 Nvidia와 AMD 다음으로 세 번째로 큰 HBM 메모리 구매자가 되었으며, 무수히 많은 AI 하드웨어 스타트업을 대신하여 HBM 용량을 확보할 재정적 역량을 갖추게 되었습니다. 이들 스타트업은 Broadcom이나 Marvell 같은 회사들의 도움 없이는 칩 식각(etching)과 패키징을 할 수 없을 것입니다.
따라서, 모든 GPU 부품이 이미 2026년 물량으로 매진되었고 부품 배분이 2027년 말까지 이루어질 것이 거의 확실한 상황에서, Nvidia는 내년에 'Grace-Blackwell' 및 'Vera-Rubin' NVL72 시스템을 구매하는 고객들에게 15%의 가격 인상이 있을 것이라고 경고했습니다. 이는 블룸버그 보도에 따른 것입니다. 저는 Nvidia가 계약서에 유연한 가격 책정 조항을 마련하여 상승하는 HBM, DRAM, 플래시 비용을 ODM 및 OEM 고객에게 전가하고, 이들이 다시 실제 시스템 구매자들에게 전가할 수 있도록 했을 것이라고 추측합니다. 저는 가격 인상 폭이 더 높지 않은 것에 놀랍니다.
Nvidia의 사업은 다른 모든 GPU 및 XPU 제조사와 마찬가지로 확보할 수 있는 HBM 메모리의 양만큼만 성장할 수 있습니다. 그리고 만약 메모리 제조업체와 Nvidia가 반독점 소송에 휘말리는 것을 원치 않는다면, Nvidia는 경쟁사들이 용량을 확보할 수 있도록 보장해야 합니다. 일반적으로 말해, 85%의 매출 또는 출하 시장 점유율 이상이 미국 법무부(US Department of Justice)에서 독점 기업으로 간주하는 역사적 기준이었지만, 요즘에는 어떤 순간에 트럼프 대통령이 당신의 사업에 대해 어떻게 생각하는지가 정말 중요한 것 같습니다.
업계가 해야 할 일은 가속기(accelerators)를 가속화할 방법을 찾아내는 것이며, 우리는 KV 캐시용 외부 플래시 기반 DPU 구동 스토리지 계층뿐만 아니라 HBM 베이스 다이에 컴퓨팅을 추가하고 메모리 서브시스템에 컴퓨팅을 추가하는 것을 목격하고 있습니다. 이를 소위 Processing In Memory (PIM)라고 부르며, 저희 The Next Platform에서 여러 번 다루었습니다. Handy 역시 통신 채널의 대역폭 요구 사항은 두 개의 컴퓨팅 장치를 연결하는 양쪽 끝단의 지능(intelligencer)에 반비례한다고 말하며 동의했습니다.
Handy는 개회사 기조연설에서 “메모리 벽(memory wall)을 넘어서는 방식으로는, 아마도 더 스마트한 메모리 칩으로 향하게 될 것이고, 이는 프로세서가 보내야 하는 트래픽 양을 줄일 것입니다”라고 말했습니다. “그것은 프로세서가 메모리에 일종의 정렬(sort) 작업을 지시하고, 메모리가 스스로 정렬을 수행한 다음 ‘완료’라고 알려주고, 그러면 프로세서가 가장 위에 있는 것을 물어보고 바이트 하나만 돌아오고, 그게 작업이 끝나는 것입니다. 만약 메모리 칩 내부에 스마트 기능이 없다면 엄청난 양의 통신이 필요했을 것입니다. 따라서 저는 AI가 모든 곳에 스며들 것이라고 예상합니다. AI는 마이크로컨트롤러에서도 수행될 수 있으며, 사람들은 ‘어? 여기서는 작동하는 것 같은데. 저기서도 시도해보자’라고 말하며 작업하고 있는 새로운 사고방식이 있다고 생각합니다. 이전에는 사람들이 이런 일을 하지 않았습니다. 받아들일 준비가 되어 있지 않았고, 그래서 저는 모든 엔드포인트에서 AI가 사용되는 것을 예상합니다. 통신 채널에서도 볼 수 있을 것이며, 결국 눈에 보이지 않는 지점에 도달할 것입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기