
데이터 센터용 Nvidia의 Vera CPU 벤치마킹 — 독립형 Vera를 Granite Rapids-AP 및 EPYC Turin과 비교 테스트
요약
Nvidia의 Vera CPU는 에이전트 기반 AI 워크플로우에 초점을 맞춰 설계된 차세대 데이터 센터용 프로세서입니다. 이 칩은 높은 메모리 대역폭과 고속 C2C 인터커넥트를 통해 복잡한 에이전트 환경에서 강력한 성능을 보여줍니다. 또한, 범용 서버 작업에서도 AMD 및 Intel의 경쟁 제품들과 견줄 만하거나 능가하는 유능함을 입증했습니다.
핵심 포인트
- Vera는 에이전트 기반 워크플로우에서 높은 유용성을 보임.
- 고속 C2C 인터커넥트와 대규모 메모리 대역폭을 제공함.
- 범용 서버 작업에서도 경쟁사 대비 강력한 성능을 입증함.
- Armv9.2-A 아키텍처 기반의 88코어 CPU임.
Nvidia의 Vera CPU는 회사가 수년간 주도해 온 AI 인프라 구축 과정에서 중요한 다음 단계입니다. 이 제품은 에이전트 기반(agentic) AI 워크플로우로의 전환이 데이터 센터 CPU에 전례 없는 수요를 창출하는 시점에 출시되었으며, 적어도 Nvidia의 마케팅 자료에 따르면 바로 이 순간을 위해 특별히 설계되었습니다. 비록 6개월 전에 발생한 수요 변화에 맞춰 CPU가 개발되었다는 생각은 무리가 있을 수 있지만, 아래의 벤치마크 결과에서 볼 수 있듯이, Vera에 대한 Nvidia의 주장은 공허한 말이 아닙니다.
현재 우리가 다루고 있는 워크로드(지금까지 CPU에 초점을 맞춘 표준화된 종단 간 에이전트 기반 벤치마크는 없습니다)를 바탕으로 할 때, Vera는 에이전트 기반 워크플로우에서 유용성을 보여주는 강력한 지표들을 가지고 있습니다. 예를 들어, AI 소프트웨어 생태계의 많은 부분을 차지하는 Python에서 최고 수준의 성능을 제공합니다.
또한 소켓 레벨과 시스템 레벨 모두에서 높은 메모리 대역폭(memory bandwidth)을 보여주며, Vera 칩 간의 고속 C2C 인터커넥트가 이를 뒷받침합니다. 에이전트들이 대규모 데이터베이스를 쿼리할 수 있는 논쟁적인 에이전트 환경에서는 이러한 대역폭이 매우 중요합니다.
특화된 기능(Specialization)은 한 가지 측면일 뿐이지만, Vera는 맞춤형 Arm 칩이 데이터 센터에 침투하고 AMD와 Intel의 기존 x86 칩들이 여전히 강력한 기반과 시스템을 사용하는 광범위한 고객층을 보유하고 있는 치열하게 경쟁하는 서버 시장에 진입합니다. Vera가 어떤 성능을 보이든, 이는 결코 작은 시도가 아닙니다.
Vera에 대해 놀라운 점은 이 에이전트 관련 워크로드에서 좋은 성능을 보인다는 사실 자체가 아니라, 범용 서버 워크로드에서도 유능한 성능을 제공한다는 것입니다. 종종 비교 대상인 AMD Turin 및 Intel Granite Rapids-AP 칩과 견줄 만하거나 능가하는 성능을 보여줍니다. 프론트엔드(frontend) 워크로드를 볼 때는 코어 밀도(core density)를 갖춘 x86 CPU가 종종 우위를 점하지만, Vera는 그 밀도를 포기하는 대신 데이터가 풍부한 백엔드(backend) 작업에서 강력한 성능을 제공합니다.
Nvidia Vera 사양
| 항목 | 사양 |
|---|---|
| 코어 / 스레드 | 88 / 176 |
| L2 캐시 | 코어당 2 MB |
| L3 캐시 | CPU당 164 MB |
| 메모리 | 최대 1.5 TB SOCAMM2 LPPDDR5X |
| 메모리 속도 | 최대 9600 MT/s |
| 메모리 대역폭 | 최대 1.2 TB/s (총합), 14 GB/s (코어당) |
| PCIe | 88 PCIe 6.4 레인 (CPU 전용), 96 PCIe 6.4 레인 (Vera Rubin), x2까지 분기, CXL 3.1 |
| 구성 가능 TDP | 250W - 450W |
엔비디아의 첫 번째 커스텀 코어인 Olympus는 인상적인 성능을 보여주었으며, 기성품 Arm 코어 설계를 사용했던 Grace 대비 거의 모든 측면에서 현저한 개선을 이루었습니다. 이 88코어 CPU는 엔비디아의 “공간 다중 스레딩(spatial multithreading)”을 통해 코어당 두 개의 스레드를 포함하며 Armv9.2-A 아키텍처를 기반으로 구축되었습니다.
이 칩은 Arm의 AGI와 유사한 10와이드 디코드(decode)를 특징으로 하며, 엔비디아의 2세대 확장 가능 일관성 패브릭(Scalable Coherency Fabric, SCF)도 갖추고 있습니다. SCF와 Olympus 코어에 대한 자세한 내용은 저희의 Vera 심층 분석에서 읽을 수 있지만, SCF는 Vera 성능에 매우 중요합니다. 이는 다이(die) 전체에 걸쳐 L3 캐시를 분산시키며, 최대 3.4 TB/s의 대역폭을 제공하는 메쉬 구조입니다.
Vera는 또한 높은 메모리 대역폭을 자랑합니다. 교체 가능한 SOCAMM2 LPDDR5X를 9600 MT/s로 활용하여 최대 1.2 TB/s의 총 메모리 대역폭, 즉 코어당 약 14 GB/s를 제공하며, 이는 AMD의 고밀도 Turin 설계보다 두 배 이상 높은 수치입니다.
하지만 우리는 Vera의 속도와 성능에 대해 많은 이야기를 들어왔습니다. 이제 현대 AI 데이터 센터에서 Vera가 어떤 역할을 하는지 이해하고, AMD의 Venice 및 Intel의 Diamond Rapids가 출시되기 전에 x86 경쟁 제품들과 비교하여 벤치마크를 통해 그 성능을 확인해 볼 때입니다.
테스트 플랫폼
|
| 테스트 플랫폼 | 메모리 | 테스트된 프로세서 |
|---|---|---|
| 2P Nvidia MGX Vera 레퍼런스 플랫폼 | 16 x 96 GB (1.5 TB) Samsung LPDDR5-9600 ECC SOCAMM2 | Nvidia Vera |
| 2P Supermicro SYS-222HA | 24 x 64GB (1.5 TB) Micron DDR5-8800 ECC MRDIMM | Intel Xeon 6980P |
| 2P AMD Volcano 레퍼런스 플랫폼 | 24 x 64 GB (1.5 TB) SK hynix DDR5-6000 ECC RDIMM | AMD EPYC 9965, EPYC 9755 |
에이전트형 AI에서 CPU의 역할 이해하기
에이전트형 AI(agentic AI)라는 빠르게 변화하는 세계에서 어느 지점에 있느냐에 따라, 여러분은 '에이전트형 CPU'가 정확히 무엇인지 다른 정의를 가지고 있을 수 있습니다. 에이전트형 CPU의 중요성이 커짐에 따라, 이러한 유형의 워크로드를 구동하는 데 필요한 CPU의 작동 원리에 대한 이해는 주로 AMD와 Nvidia라는 두 회사에 의해 정의되어 왔습니다. 이들이 병렬성(concurrency)과 에이전트들의 다양한 작업에 대해 제시한 지점들은 물론 옳지만, 현재 우리가 목격하고 있는 에이전트 플랫폼의 배포 방식을 통해 그 정의를 도출하는 것이 유용합니다.
여기서 한 걸음 물러나 실제 에이전트 워크플로우(agentic workflows)가 작동하는 모습을 살펴봄으로써 CPU가 이 체인에서 어떻게 자리 잡는지 더 잘 이해할 수 있습니다. Meta Muse와 OpenAI Dots를 통해 보았듯이, 클라우드에서 컴퓨팅 자원의 일부를 제공하는 영속적인 에이전트(persistent agent)라는 종류가 존재합니다. 이러한 CPU 전용 랙은 추론 서버(inference servers)와 통신하여 모델을 실제로 실행하지만, 그 워크로드는 동시성(concurrency)에 의해 정의됩니다. 중요한 것은 개별 샌드박스(sandbox)의 성능이 아니라, 칩이 완전히 로드되었을 때 각 샌드박스가 어떻게 작동하는가입니다.
동시성은 Nvidia나 AMD 같은 기업들이 설명한 일부 워크로드에 중요한 맥락을 제공합니다. 코드 컴파일이나 대규모 데이터베이스 쿼리와 같이 더 까다로운 도구 호출(tool calls)도 있지만, 파일을 읽고/쓰거나, 코드 테스트를 실행하거나, 헤드리스 브라우저(headless browser)에서 온라인으로 접속하는 것은 고립된 상태에서는 CPU에 큰 부담을 주는 작업이 아닙니다. 하지만 칩이 잠재적으로 수천 개의 이러한 도구 호출을 처리할 때는 사소한 이점들이 쌓이기 시작합니다. 그리고 CPU 토폴로지(CPU topology)는 에이전트 세션이 증가함에 따라 성능이 어떻게 유지되는지에 더 큰 역할을 합니다.
이것은 높은 동시성에서도 성능을 유지할 수 있는 에이전트형 CPU의 주요 원칙 중 하나입니다. 다른 하나는 가변성(variability)인데, 이는 CPU뿐만 아니라 사용 가능한 더 광범위한 인프라와 관련됩니다. Google Cloud의 AI 및 컴퓨팅 인프라 담당 VP/GM인 Mark Lohmeyer는 _Tom’s Hardware_에 에이전트를 이용해 휴가를 계획하는 예시를 설명했습니다. AI를 사용하여 휴가를 계획하는 것은 예시로는 다소 진부할 수 있지만, Lohmeyer는 하이퍼스케일러(hyperscaler) 관점에서 에이전트 워크로드의 고유한 어려움에 대해 조명합니다.
예시에서 Lohmeyer는 한 달에 걸쳐 휴가를 계획하는 과정을 설명했는데, 이 과정에서 에이전트에게 갑자기 많은 작업을 요청하지만 다음 주까지 다시 프롬프트를 보내지 않을 수도 있다고 했습니다. Lohmeyer는 “실제 기본 컴퓨팅 자원의 사용은 기본적으로 간헐적(bursts)으로 발생합니다. 처음에 한 시간 정도 버스트가 일어나고 사라졌다가, 며칠 후 다른 목적으로 또다시 버스트가 일어나고 사라집니다”라고 말했습니다. 그는 “이것들은 매우 장시간 실행되는 워크로드이며, 효과적으로는 장시간이지만 기본적으로는 유휴 상태인 경우가 많습니다”라고 덧붙였습니다.
에이전트 기반 작업은 온디맨드(on-demand)로 많은 전력을 요구합니다. 이러한 간헐적 작업이 서버에서 하드웨어 경합(hardware contention)과 올바르게 정렬되지 않으면 모든 사용자의 세션이 느려질 수 있기 때문입니다. 이는 CPU가 수행하는 작업의 유형에도 영향을 미치는데, 여기에는 무거운 코드 컴파일, 그래프 순회(graph traversal), 대규모 데이터베이스 쿼리 등이 포함될 수 있습니다. 이러한 작업을 여러 에이전트에 걸쳐 확장하고, 각 에이전트가 서로 깔끔하게 정렬되지 않은 독립적인 루프를 가지고 있다면, 에이전트 기반 AI를 위한 CPU 문제가 명확해집니다.
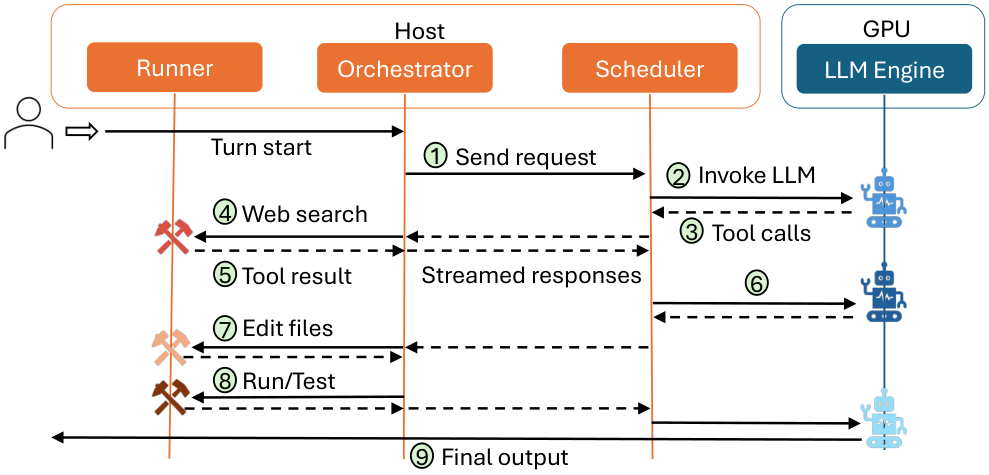
(이미지 출처: The University of Texas at Austin)
The University of Texas at Austin과 Microsoft Azure의 연구원들이 작성한 2026년 8월 논문, 『에이전트 기반 AI 워크플로우의 아키텍처적 함의(Architectural Implications of Agentic AI Workflows)』는 에이전트 흐름에서 CPU가 수행하는 세 가지 작업을 설명합니다. CPU가 단발성(one-shot) 스타일의 LLM 질의에서 작동하는 스케줄러 외에도, 에이전트 상태 및 통신을 유지하는 오케스트레이터 역할을 하며, 도구를 호출하고 에이전트 로직을 실행하는 러너 역할(종종 Python 사용)도 수행합니다.
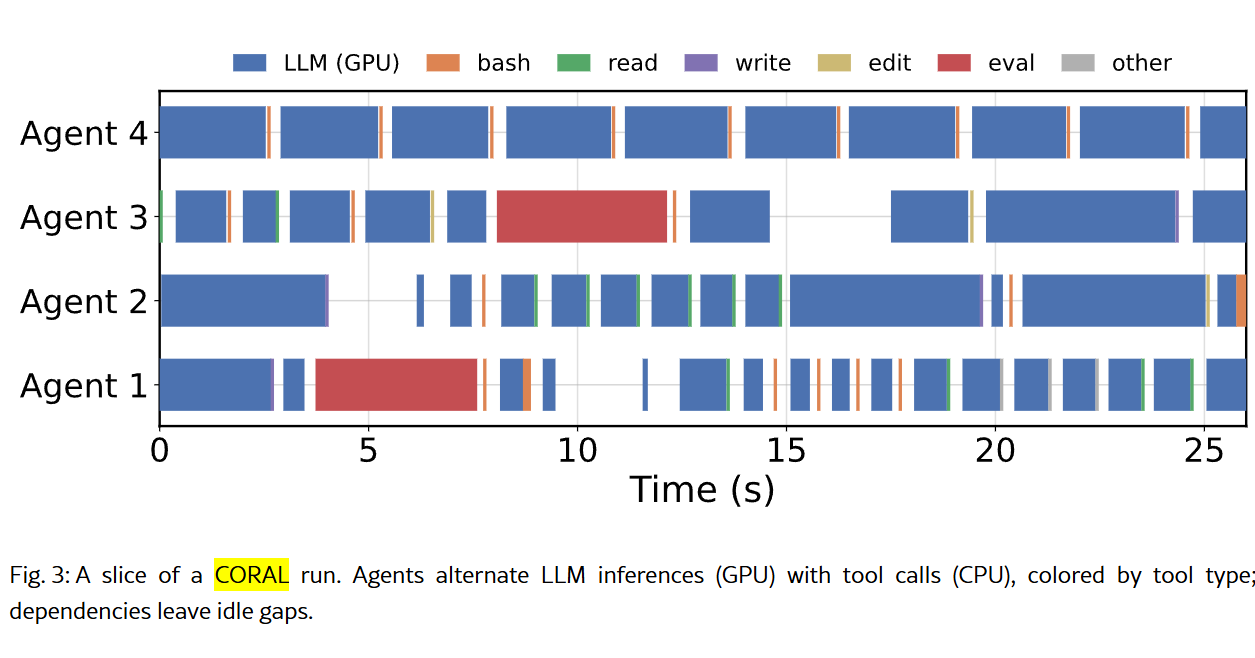
(이미지 출처: The University of Texas at Austin)
논문은 또한 여러 에이전트가 동시에 실행될 때 발생할 수 있는 이러한 경합(contention)을 보여줍니다. 이들은 GPU로 요청을 전달하고, 응답을 받고, 행동하며, 다시 요청을 되돌려 보냅니다. 우리는 30분도 안 되는 시간 동안 네 개의 에이전트 단면을 살펴보고 있으며, 작은 CPU 기반 작업들이 어떻게 정렬될 수 있는지, 그리고 GPU 사용 시간 사이에 지연(hangs)을 만들 수 있는지 이미 알 수 있습니다.
Nvidia는 Vera가 에이전트형 CPU(agentic CPU)임을 분명히 했지만, 에이전트 루프의 성능을 정의하는 것은 아직 진행 중인 작업입니다. Lohmeyer는 “업계는 전통적인 워크로드를 벤치마킹할 수 있는 상당히 좋은 방법을 구축했습니다”라고 말했습니다. “저는 이것이 이제 GPU와 추론(inference)용 TPU에도 일어나고 있다고 생각합니다. 우리는 아마도 아직 등장하고 있을 에이전트 워크로드에 대해서도 같은 종류의 산업 수준 벤치마크가 필요할 것이라고 생각합니다.”
전체 에이전트 루프를 살펴보는 표준화된 벤치마크는 아직 없습니다. 저희는 자체 내부 테스트를 진행 중이며 곧 데이터를 확보할 수 있기를 희망하고 있고, Modal과 같은 회사들로부터 일부 공급업체 수준의 벤치마킹을 보았지만, 광범위한 업계에서는 아직 SPEC이나 TPC와 같은 형태의 엔드투엔드(end-to-end) 에이전트 루프에 대한 벤치마크 세트를 제시하지 못했습니다.
이러한 테스트가 아직 이용 가능하지 않더라도, 우리는 여전히 에이전트 워크플로우의 관점에서 CPU 성능을 살펴볼 수 있으며, 이는 에이전트 루프에 중요한 성능 측면들을 우선시합니다. 또한 코딩 에이전트를 위한 코드 컴파일(code compilation)이나 검색 에이전트를 위한 데이터베이스 성능 등 에이전트의 일반적인 워크플로우도 살펴볼 수 있습니다. 에이전트들이 통신하는 데 사용하는 대용량 JSON 파일을 이 CPU들이 어떻게 파싱하는지 평가하기 위해 simdjson 라이브러리를 통한 JSON 파싱(JSON parsing)과 같은 것들을 살펴볼 수 있습니다. 그리고 Python 성능을 통해 AI 생태계의 많은 기반을 살펴볼 수도 있습니다.
이것이 저희가 수행하는 벤치마킹의 초점입니다. 즉, 잘 알려진 벤치마크를 통해 AMD와 Intel의 x86 경쟁 제품들 사이에서 Vera가 어느 위치에 있는지 파악하는 것입니다. 향후 테스트 절차가 확정되면 완전한 에이전트 루프(agentic loops)를 평가하기 위해 추가적인 테스트 기회를 가질 수 있기를 바랍니다.
비록 저희가 여기에서 에이전트 관점(agentic lens)을 통해 성능을 평가하고 있지만, Nvidia는 저희가 수행할 수 있는 테스트에 제한을 두지 않았고 어떤 조건도 부과하지 않았습니다. 테스트 목적으로 이중 소켓 Vera 시스템에 대한 원격 액세스를 제공해 준 Nvidia에게 감사드리지만, 플랫폼이 예상대로 작동하는지 확인하기 위한 구성 점검 외에는, 저희가 원하는 테스트를 실행할 수 있었습니다. 여기에는 에이전트 워크플로우(agentic workflows)에 적용 가능한 여러 테스트뿐만 아니라, Java, 암호화(cryptography), 압축(compression), 렌더링 성능을 포함하는 일반 서버 CPU 벤치마킹 스위트의 테스트도 포함됩니다.
독자들을 위한 부드러운 상기
서버는 클라이언트 PC와 다릅니다. 서버에는 하드웨어에 대한 접근성이 더 높고, 훨씬 지능적인 운영 체제(operators)를 갖추고 있으며, 최소한 특정 워크로드에 고유하거나 최대화할 경우 해당 워크로드에 매우 미세 조정되고 최적화된 소프트웨어 스택을 가지고 있습니다. 클라이언트 CPU의 경우, AMD X3D 칩이 게이밍에 가장 좋다고 말하거나, Intel의 최신 플래그십 제품이 최고 싱글 스레드 성능을 제공한다고 말할 수 있습니다. 하지만 서버는 사용 사례(use cases)에 훨씬 더 많이 의존합니다.
일반적인 리뷰에서는 "Z 목적에는 X가 Y보다 낫다"고 말하고 데이터를 통해 이를 뒷받침합니다. 여기서는 그러한 논평이 더 절제되어 있습니다. 현실은 하이퍼스케일러(hyperscalers)들이 어떤 목적에도 맞출 수 있는 다양한 하드웨어로 대규모 플릿을 유지하며, 기업들은 운영에 가장 적합할 뿐만 아니라 TCO(총 소유 비용)와 해당 비즈니스에 특화된 최소 12가지 이상의 다른 변수들을 고려하여 하드웨어를 선택해야 한다는 것입니다.
Nvidia Vera SPEC CPU 2026 추정치
AI 자동 생성 콘텐츠
본 콘텐츠는 Tom's Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기