최대 내적 검색(Maximum Inner Product Search, MIPS)은 추천 시스템, 검색, 그리고 검색 증강 생성(Retrieval-Augmented Generation, RAG)의 핵심에 자리 잡고 있습니다. 주어진 쿼리 벡터를 가지고, MIPS 시스템은 수백만 개의 후보 키 벡터가 담긴 데이터베이스 내에서 쿼리와 가장 잘 일치하는 것을 검색합니다. 그런 다음 그 최고 일치 키와 연관된 원래 데이터 포인트를 사용하여 쿼리를 처리합니다. RAG의 경우, 질문에 답변하기에 가장 적합한 문서를 일반적으로 쿼리 앞에 붙여서 사용합니다.
키의 수가 수백만 개로 늘어나고 벡터 차원이 수천에 달하면서, 모든 키와 쿼리를 비교하는 포괄적인 검색(exhaustive comparison)의 계산 비용은 급격히 증가합니다. 클러스터링과 양자화(quantization)를 사용하여 정확도를 속도와 교환하려는 수많은 근사 방법들이 제안되었습니다. 이러한 기준선(baseline) 방법들은 우아한 인덱싱 구조를 구축하기 위해 키 세트의 속성에 초점을 맞추지만, 그 기하학적 논증은 쿼리 세트 자체도 키에서 발견되는 것과 유사할 것이라고 느슨하게 가정하거나, 아예 쿼리가 어떤 모습일지에 대한 고려 사항을 우회합니다. 이는 두 가지 측면에서 문제가 될 수 있습니다. 첫째, 중요한 RAG의 경우, 쿼리는 짧은 사용자 생성 질문에서 발생하는 반면, 키는 길고 정보가 풍부하며 선별된 형태의 텍스트를 나타내므로, 키와 쿼리가 실질적으로 매우 다릅니다. 또한, 대부분의 프로덕션에 배포되는 MIPS 사용 사례들은 안정적이고 잘 특성화된 쿼리 분포를 가진 기존 사용자 기반을 목표로 합니다. 이는 일반적이며 쿼리에 구애받지 않는 방법들이 활용하지 못하는 신호입니다. 모든 가능한 입력에 대해 좋은 성능을 목표로 하기보다는, 예상되는 입력 소스에 가장 적합한 방법을 만드는 것이 현대 머신러닝의 핵심 원칙 중 하나이며, 컴퓨팅 자원을 보다 효율적으로 재배치하는 데 도움을 줍니다.
ICML 2026에서 발표된 논문인 "Amortizing Maximum Inner Product Search with Learned Support Functions"에서 Apple의 연구원들은 고정된 키 데이터베이스를 위해 작은 신경망(NNs)을 한 번, 오프라인으로 훈련시킵니다. 이 NN은 쿼리를 가장 적합한 일치 항목으로 더 빠르게 라우팅하는 방법을 학습합니다. 이들의 접근 방식은 전형적인 쿼리가 어떻게 매칭되는지 이해하기 위한 초기 상각 비용(amortization cost)을 지불하는 대신, 이러한 작은 NNs를 통해 추론 시간(inference time)에 더 빠르고 정확한 검색을 얻습니다.
MIPS의 근본 원칙은 키 세트의 기하학적 구조를 활용하여 검색 속도를 높이는 것입니다. 일반적인 MIPS 시스템은 키 세트를 k개의 클러스터로 분할하며 (k는 일반적으로 전체 키 개수 n보다 훨씬 작습니다), 각 클러스터에 대한 대표 중심점(centroid)을 추적합니다. 새로운 쿼리를 수신하면, 시스템은 이를 이 k개의 중심점과 비교합니다. 그런 다음 해당 쿼리는 가장 가까운 대표 중심점이 속한 클러스터로 라우팅된 후, 그 클러스터에 저장된 모든 키와 철저하게(exhaustively) 비교됩니다. 데이터베이스가 n개의 키와 k개의 균등하게 분포된 클러스터를 가지고 있다면, 두 번째 단계에서 고려되는 유효 키 개수는 n/k의 순서에 있습니다. 이는 단순한 전체 비교 방식(naive exhaustive approach)에서 수행되는 n번의 비교와 비교했을 때 k배의 속도 향상을 의미합니다. 불행하게도, 이 라우팅 메커니즘은 중심점 라우팅이 정확한 접근 방식이 아니기 때문에 오류를 초래할 수 있으며, 이는 아래 그림 1에 설명되어 있습니다.
MIPS가 머신러닝 관점에서 흥미로운 이유는 이 모델이 이전에는 크게 간과되었던 수학적 구조에 기반하고 있기 때문입니다. 즉, 쿼리를 주어진 집합 내의 모든 키와 가장 큰 내적(inner product)으로 매핑하는 함수는 볼록 해석학(convex analysis)에서 잘 연구된 대상인 해당 집합의 지지 함수(support function)입니다. 이 함수는 두 가지 중요한 속성을 가집니다. 첫째, 볼록(convex)하기 때문에 입력 볼록 신경망(input convex neural networks, ICNNs)이라는 특정 목적을 위해 설계된 신경망 클래스로 근사할 수 있습니다. 둘째, 임의의 쿼리에서 해당 지지 함수의 기울기(gradient)는 가장 잘 일치하는 키 자체를 반환합니다.
이 연구의 광범위한 아이디어는 훨씬 낮은 계산 비용으로 정답 지지 함수(또는 그 기울기 자체)를 모방할 수 있는 신경망을 학습하는 것입니다. 이는 회귀(regression)라고 알려진 고전적인 ML 기법을 통해 달성될 수 있습니다. 즉, 입력 벡터(사용자 쿼리)를 샘플링하여 생성하고 이를 MIPS가 생성한 관련 출력 신호(최적 점수 또는 최적 키 벡터 자체)와 쌍으로 묶어 대규모의 훈련 예제를 미리 계산하기만 하면 됩니다. 이후 필요한 것은 주어진 입력을 바탕으로 출력을 재현하도록 적절하게 매개변수화된 신경망을 훈련시키는 것입니다.
위에서 설명한 수학적 접근 방식에 따라 회귀 문제가 완벽하게 해결된다면, 지지 함수를 모방하도록 훈련된 동일한 신경망이 기울기 평가(자동 미분/automatic differentiation)를 통해 최적 키도 출력할 수 있습니다. 하지만 실제로는 이 두 가지 작업을 위해 별도의 전문화된 네트워크를 훈련하는 것이 가장 효과적임을 관찰했습니다.
SupportNet 신경망 아키텍처는 (느슨하게 제약된) ICNN을 사용하여 지지 함수를 직접 학습할 수 있습니다. 이 접근법은 수학적으로 원칙적이며 문제의 볼록 구조와 일치합니다. 우리는 이 방법이 데이터 클러스터당 하나의 지지 함수를 계산하는 데 사용될 때 라우팅 품질 개선에 탁월함을 발견했습니다.
KeyNet 모델은 쿼리를 입력받았을 때 가장 잘 맞는 키 벡터를 직접 출력하도록 학습합니다. 균질 함수에 대한 오일러의 정리(Euler’s theorem for homogeneous functions)에서 파생된 일관성 손실(consistency loss)은 명시적으로 볼록성(convexity)이 강제되지 않더라도, 그 예측을 근본적인 지지 함수(support function)에 기하학적으로 기반하게 유지합니다.
두 모델 모두 관련 쿼리 분포에서 추출된 예시로 훈련됩니다. 각 샘플링된 쿼리에 대해, 참값 최적 일치(ground-truth best match)는 전체 탐색(exhaustive search)을 통해 한 번 계산되어 저장되며, 이는 실제로 중요한 쿼리들의 분포에 대한 MIPS 해 공간(MIPS solution landscape)을 포착하는 지도 학습 데이터셋을 생성합니다.
그림 1에서 볼 수 있듯이, 더 큰 규모를 처리하는 가장 간단한 방법은 키들을 클러스터로 분할하고, 쿼리를 각 클러스터의 중심점(centroid)과 비교하며, 이 k 점수를 기반으로 가장 유망한 클러스터로 쿼리를 라우팅하는 것입니다. 이는 저렴하지만 거친 규칙을 제공하지만, 중심점만으로는 해당 클러스터의 분포를 설명할 수 없기 때문에 실수가 발생하기 쉽습니다. 실제로, 어떤 클러스터는 자신의 중심점에서 멀리 떨어져 있지만 쿼리에 가까운 키를 포함할 수 있으며, 쿼리가 그러한 이상치(outlier) 근처에 있을 때, 중심점 라우팅은 해당 클러스터의 점수를 낮게 매기고 건너뛰어 실제 최적 일치를 놓칠 수 있습니다.
만약 각 클러스터의 지지 함수에 접근할 수 있다면, 대신 정확한 라우팅(exact routing)을 수행할 수 있습니다. 이는 각 지지 함수가 해당 클러스터 내의 어떤 키가 쿼리와 얼마나 큰 점수로 일치할 수 있는지 정확하게 정량화하기 때문입니다. 이는 그림 2에서 설명되는데, 여기서는 임베딩 공간에서 변화하는 쿼리에 대해 네 개의 클러스터 각각의 지지 함수가 플롯되어 있습니다.
이러한 이론적 통찰에 기대어, 우리는 k개의 지원 함수(support functions)를 훈련된 SupportNet과 공동으로 학습시키고, 이 SupportNet은 한 번에 k개의 점수(k scores)를 출력할 수 있도록 제안합니다. 그런 다음 우리는 이 k개 점수 중 가장 큰 값을 사용하여 새로운 모든 질의어(query)를 라우팅하는 데 사용할 수 있습니다. SupportNet 모델은 단순히 중심점(centroid)과 비교하는 것보다 더 유용한 질문에 답할 수 있습니다: “이 클러스터 내에서 이 질의어에 가장 좋은 키는 무엇인가?” SupportNets는 고전적인 머신러닝 방식, 즉 회귀(regression)로 훈련됩니다. 우리는 분포(일반적으로 텍스트 질의어 임베딩)에서 추출된 샘플 질의어를 생성하고, 해당 질의어들에 대한 정답 지원 함수(ground-truth support functions)를 계산한 다음, 이 값들을 복제하도록 신경망을 훈련시킵니다.
우리는 Natural Questions 데이터셋으로 클러스터링된 128개 클러스터에 대해 크기가 증가하는 SupportNets(XS, S, M, L → 데이터베이스 크기의 1%, 5%, 10%, 20%)를 훈련시켰습니다. Natural Questions는 일반 지식 질문을 대규모 문서 데이터베이스의 구절과 연결하는 검색 벤치마크이며, 우리의 설정에서는 약 260만 개의 고유한 구절(passages)이 포함됩니다.
아래 Figure 4는 다양한 비용 개념에 따른 재현율(recall) 측면에서의 검색 성능을 보여줍니다. 라우팅 재현율은 질의어의 실제 파티션, 즉 정확히 가장 좋은 키를 보유하고 있는 파티션이 라우터가 탐색하기로 선택한 파티션 내에 속하는 질의어의 비율입니다. 두 플롯 모두에서, 질의어와 일치하는 상위-s개 클러스터에 대해 완전 검색(exhaustive search)을 수행하며, 여기서 s는 2의 거듭제곱(1, 2, 4, 8, …, 128)으로 증가합니다. 당연히 모든 방법은 128개 클러스터를 조사할 때 재현율 1에 도달합니다.
첫 번째 표를 보면, 고정된 검색 성능을 달성하는 데 있어 학습된 라우터가 중심점 라우팅보다 낮은 지연 시간(latency)으로 이를 달성함을 알 수 있습니다. 작은 SupportNet 모델은 중심점 라우팅보다 약 1.9배 빠른 속도(3.36 ms 대비 1.74 ms)로 95%의 라우팅 재현율에 도달하며, 큰 모델에서는 그 이득이 더욱 커져 1.74 ms 만에 97%를 달성합니다. 이 플롯은 단순히 중심점과 비교하는 것이 아니라, 작은 신경망(NNs)을 실행하는 데 발생하는 추가적인 연산 비용까지 명시적으로 반영했습니다.
두 번째 탭의 플롯은 라우팅 품질에만 초점을 맞추고, 신경망(NN) 실행으로 발생하는 오버헤드는 무시합니다. 탐색된 클러스터 예산이 고정되어 있을 때, 이들은 더 자주 올바른 파티션을 찾습니다: 데이터베이스의 단 5%만 스캔해도 학습된 라우터는 실제 파티션을 약 90–93%의 시간 동안 복구하며—중간 크기(M)의 경우 최대 92.6%에 달합니다—이는 센트로이드 기준선(centroid baseline)의 87.5%와 비교됩니다.
SupportNet 라우터 크기 계열 (SupportNet Router Size Family)
SupportNet 라우팅은 기존 역색인 파일 인덱스(Inverted File Index, IVF) 시스템에서 발견되는 단순한 센트로이드 기반 라우팅을 대체합니다. KeyNet을 사용하면 IVF 시스템 자체를 그대로 유지하고 수정된 버전의 쿼리만 공급할 수도 있습니다. 이 시나리오에서 KeyNet은 표준 근사 검색 인덱스(approximate search index) 앞에 “쿼리 재작성기 (query rewriter)” 역할을 자연스럽게 수행합니다: 임베딩 공간에서 최적의 일치 항목이 있을 가능성이 높은 위치를 예측한 다음, 원래 쿼리를 시작하는 대신 가장 좋아하는 IVF 시스템에 그곳을 찾아보라고 요청하는 것입니다. IVF 인덱스는 고도로 최적화되어 있기 때문에 KeyNet의 도움을 받을 때 결과를 더 빠르게 찾을 수 있습니다. 또한 우리는 회귀(regression)를 사용하여 KeyNets를 훈련시키는데, 이는 그림 5에서 요약된 바와 같습니다: 샘플 쿼리는 그들의 실제 정답 키(ground-truth, best-matching key)와 매칭되며, KeyNet 신경망은 이러한 연관성을 재현하도록 훈련됩니다.
우리는 크기가 증가하는 KeyNet(XS, S, M, L → 데이터베이스 크기의 1%, 5%, 10%, 20%)을 평가했으며, 아래 Figure 6에서 이러한 다양한 크기에 대한 재현율–비용 트레이드오프(recall–cost tradeoffs)를 보여줍니다. 첫 번째 탭에서는 검색 예산이 벽시계 지연 시간(wall-clock latency)입니다. 99%의 재현율에 도달하는 데 가장 큰 모델을 사용했을 때 최대 약 8배 적은 시간이 소요됩니다 (원문 질의 대비 0.23 ms vs 1.8 ms). 이전과 마찬가지로, 두 번째 탭에서는 원본 질의를 KeyNet 변환으로 대체함으로써 제공되는 “품질” 향상에만 초점을 맞춥니다. x축은 인덱스가 실제로 스캔하는 데이터베이스의 분율입니다. 데이터베이스의 단지 0.001%만 스캔해도, KeyNet 매핑된 질의는 원문 질의 대비 89–97%의 시간 동안 실제 키를 검색하며 — 가장 큰 모델(L)의 경우 최대 96.7%에 달합니다 — 이는 원문 질의 대비 수치입니다. 또한, 99% 재현율에 도달하는 데 필요한 키 수는 최대 약 11배 적습니다 (원문 대비 0.009% vs 0.10%). 동일한 비용으로 더 나은 재현율을 얻거나, 혹은 같은 재현율을 훨씬 적은 자원으로 달성할 수 있습니다.
KeyNet 검색기 크기군(KeyNet Searcher Size Family)
이 섹션에서는 이전에 논의된 것과 동일한 Natural Questions 데이터셋에서 얻은 예시들을 FAISS IVF 인덱스를 통해 제공합니다. 이는 우리가 연구한 여러 데이터셋 중 하나이며, 그 추세는 모든 데이터셋에 걸쳐 일관적입니다. KeyNet이 예측한 키로 인덱스에 질의하는 것이 전체 검색 예산 범위에 걸쳐 원본 질문으로 질의하는 것보다 지속적으로 우수함을 보여줍니다.
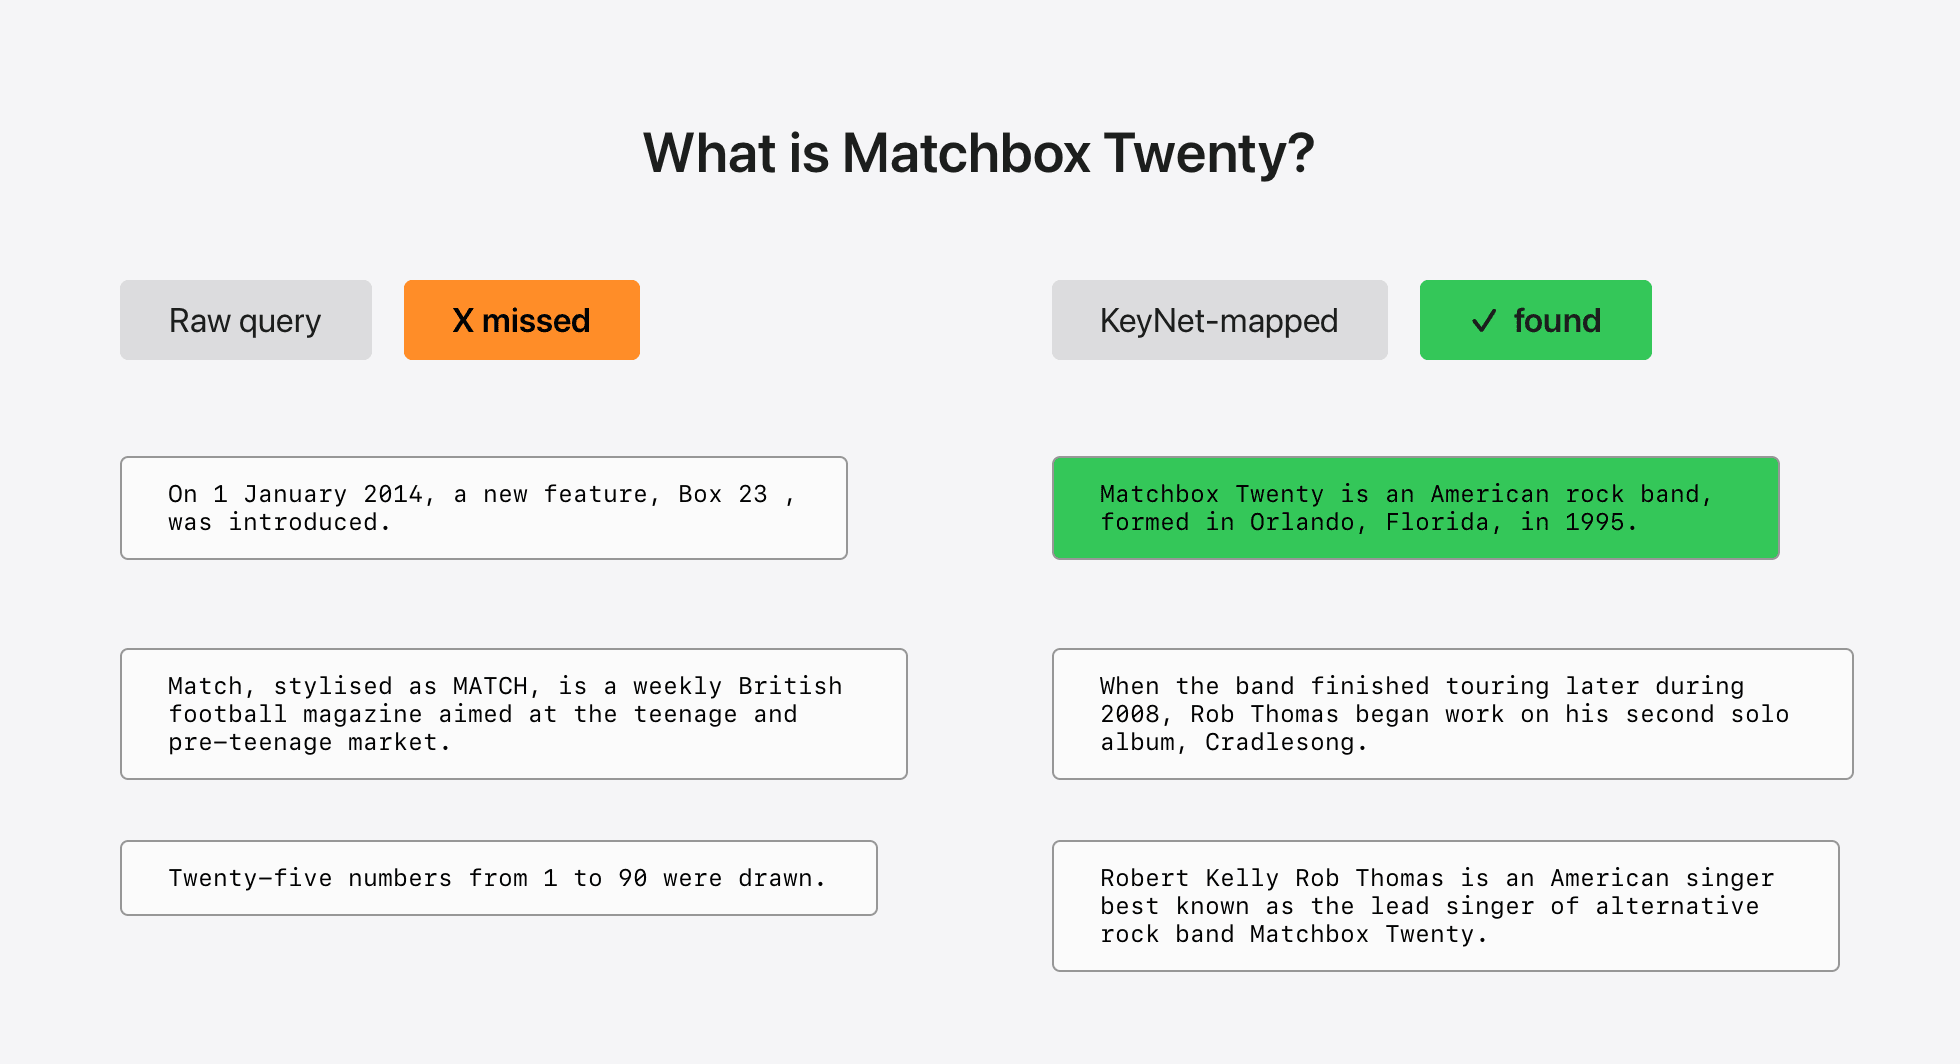
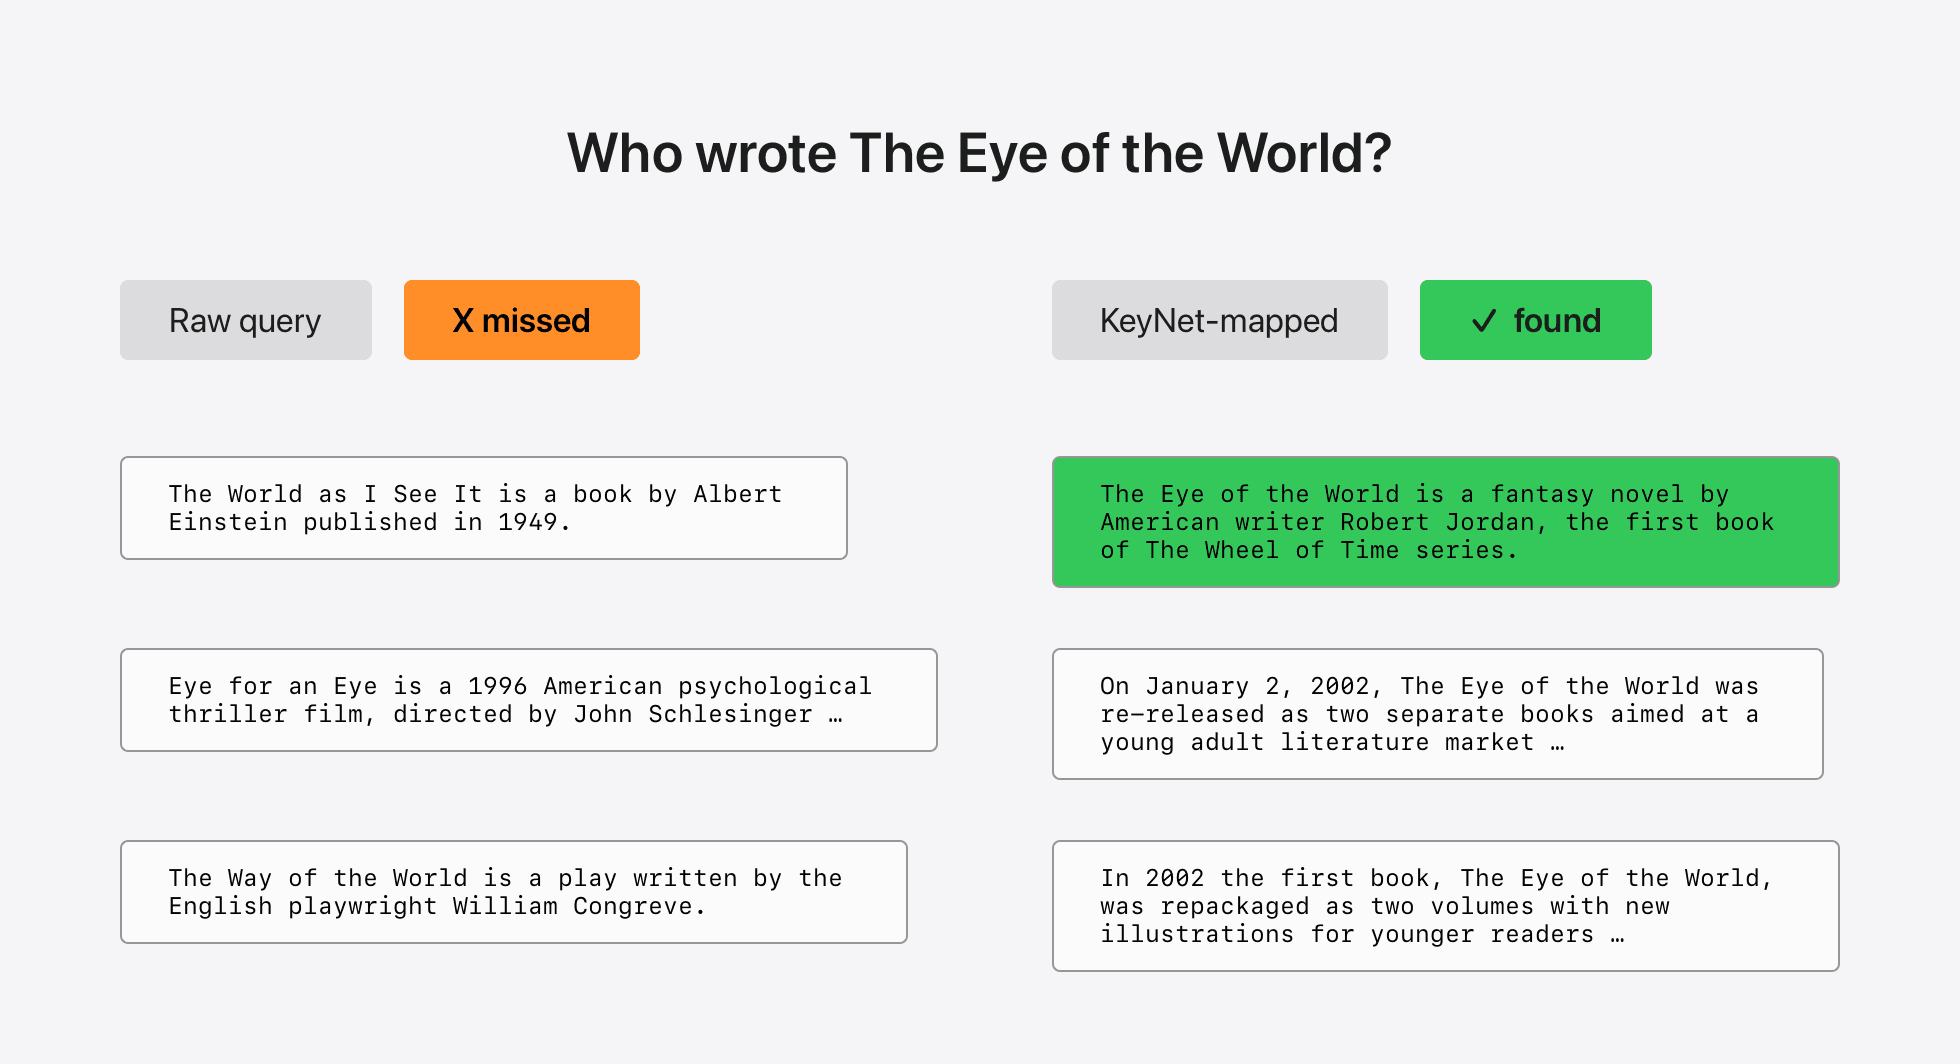
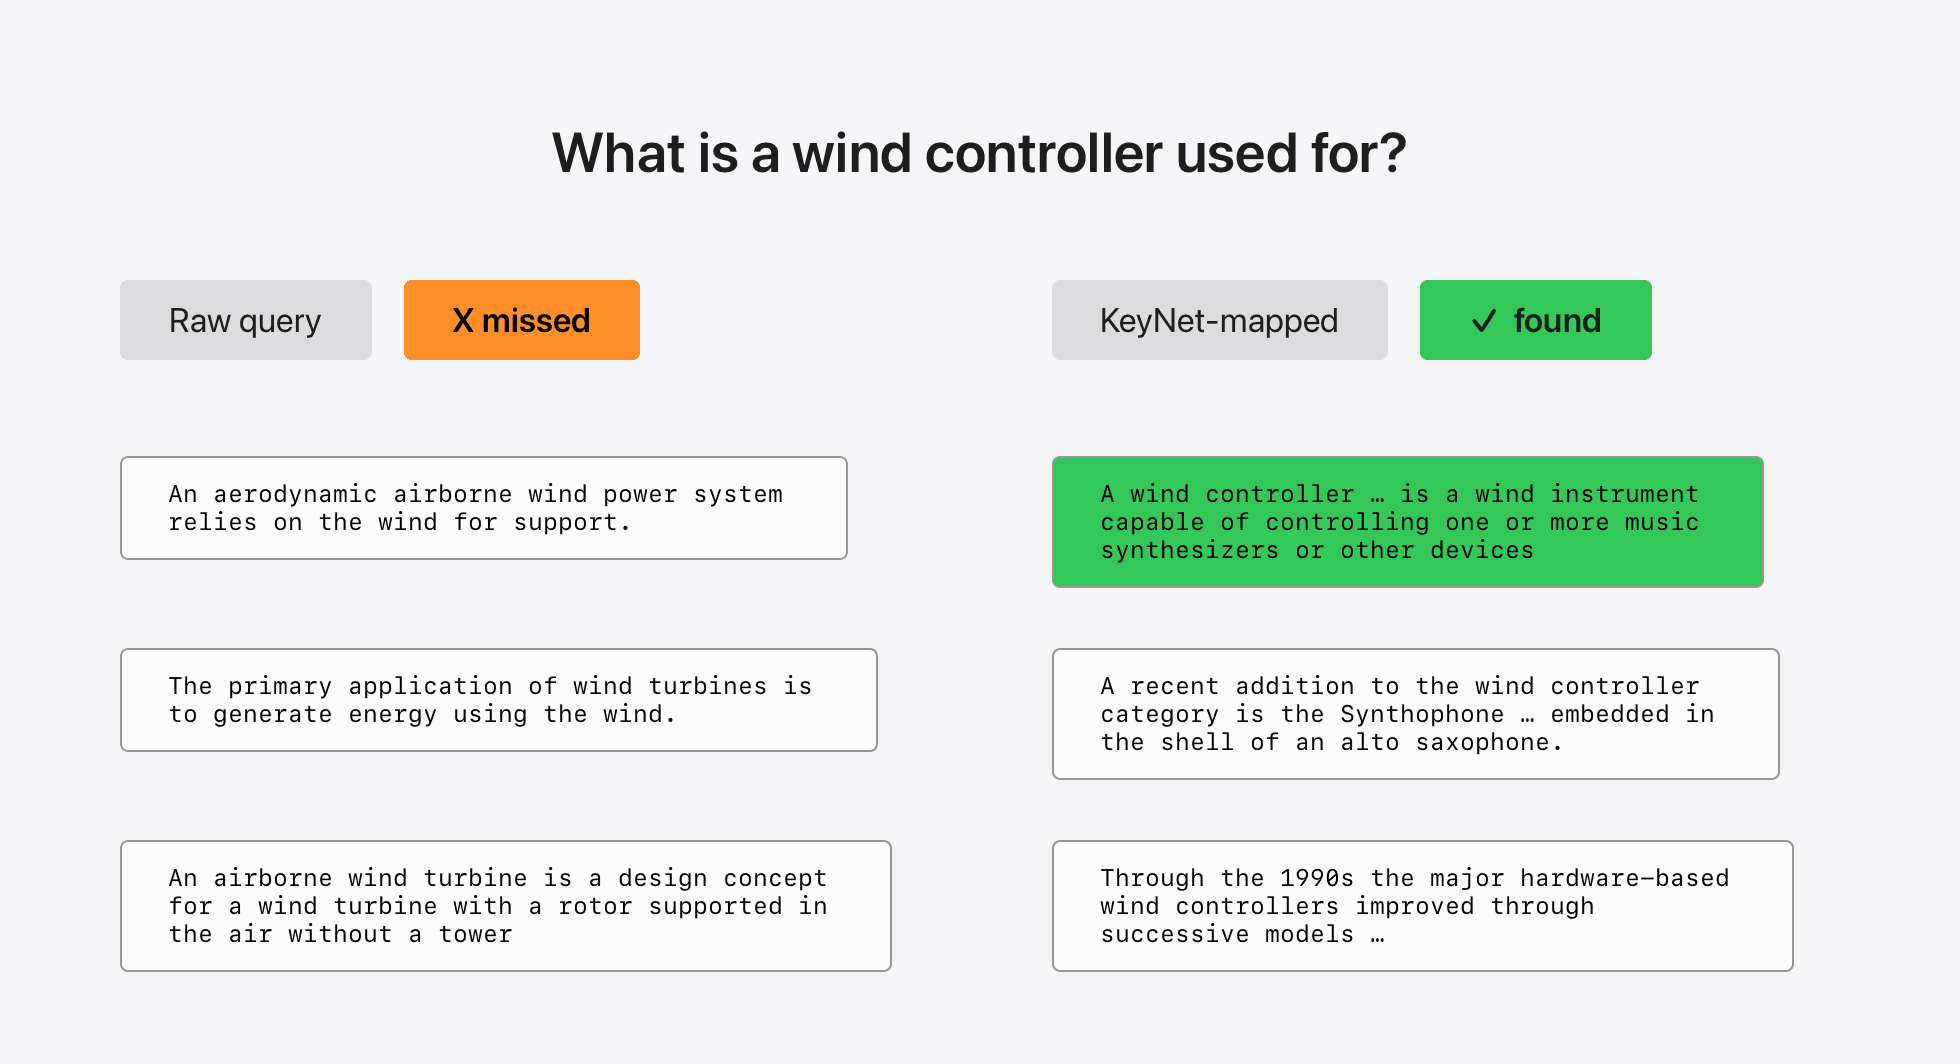
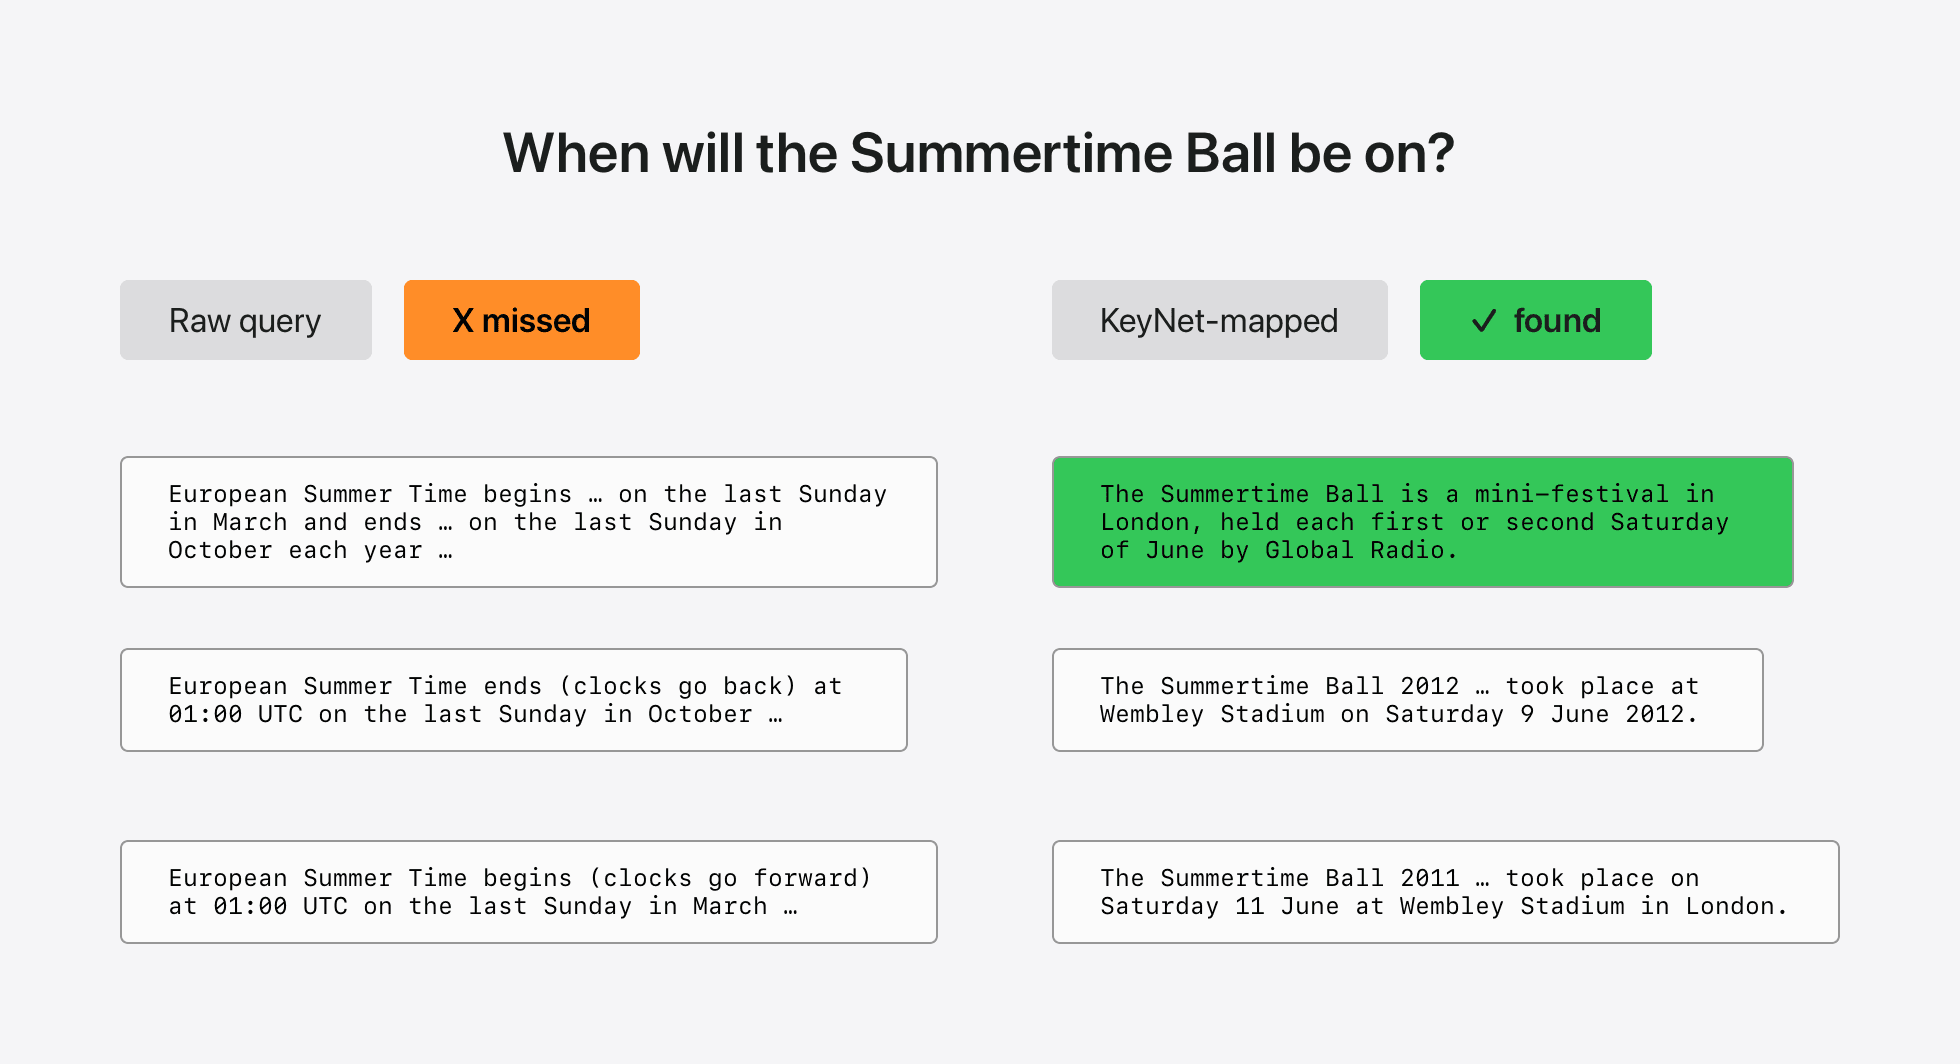
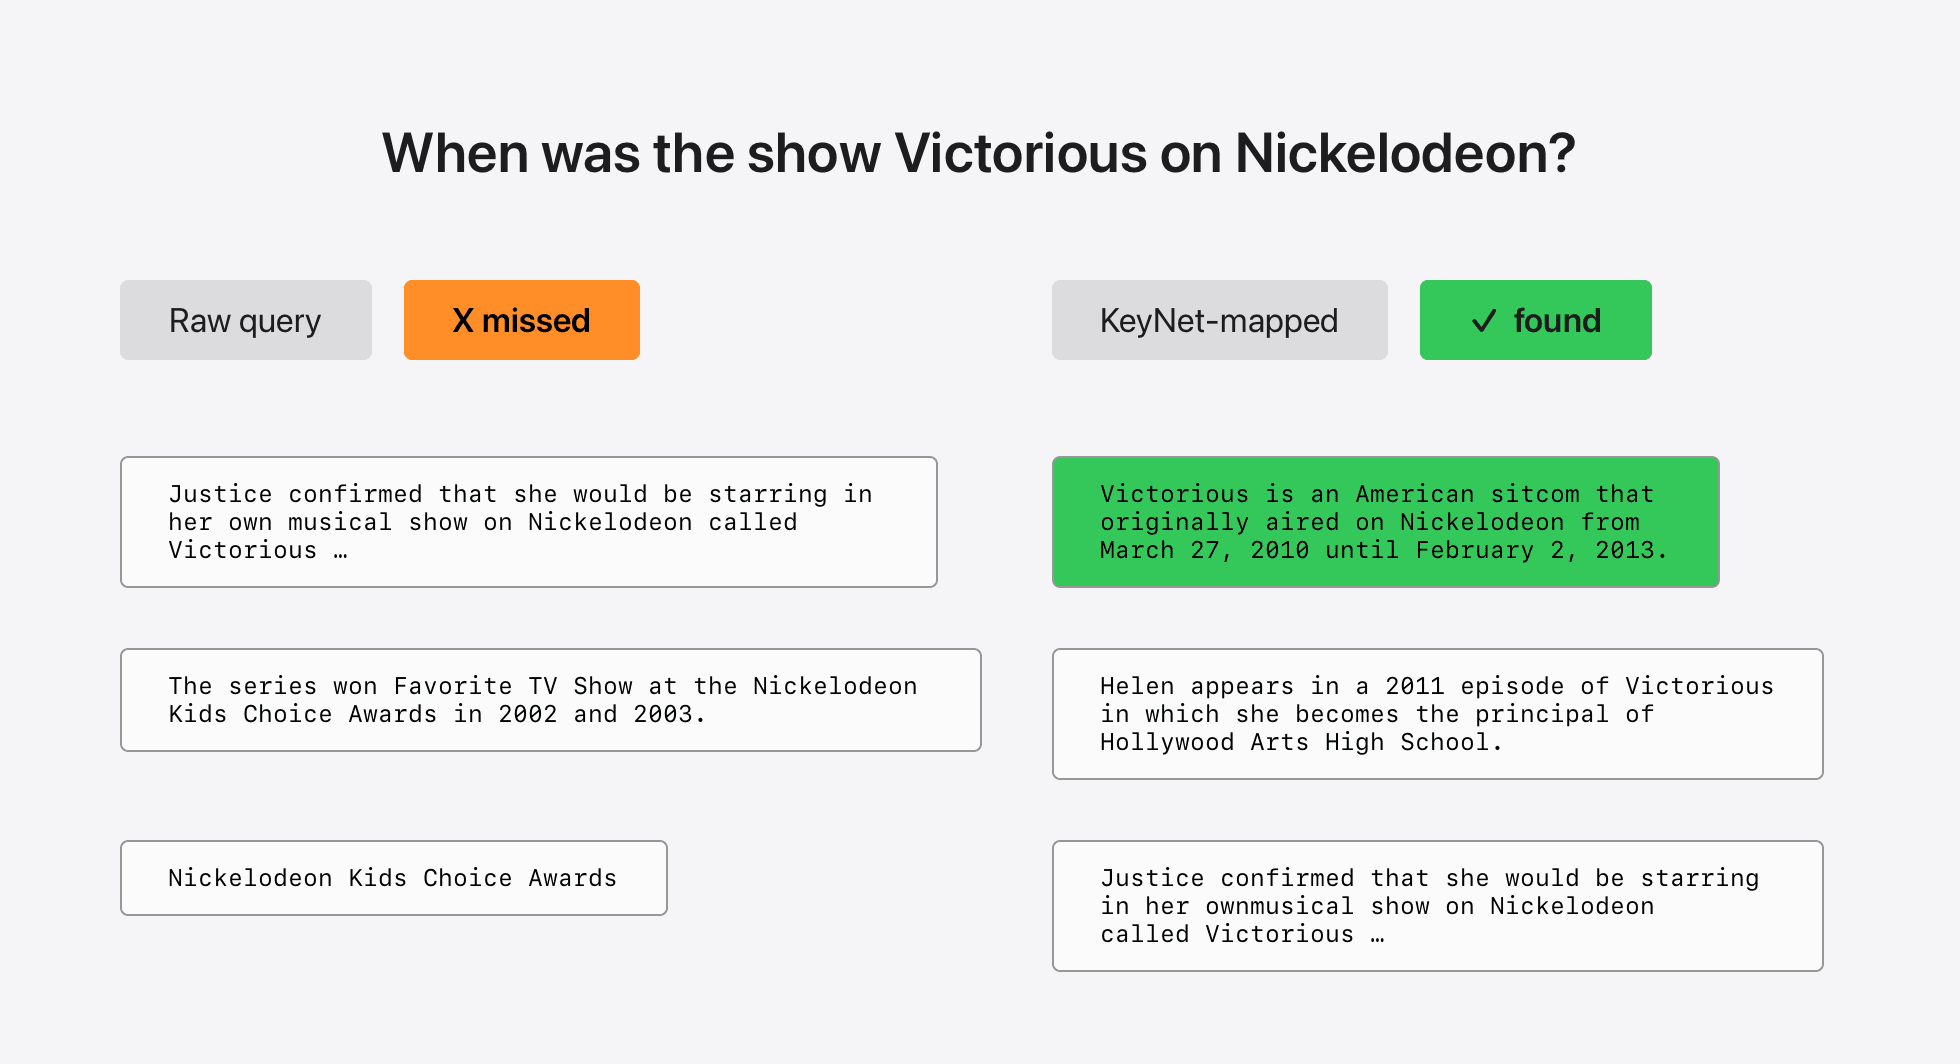
구체적으로, 아래 Figure 7은 다섯 가지 Natural Questions 예시를 보여주며, 이는 원문 질의 대비 KeyNet 매핑된 질의의 상위 3개 검색 결과입니다.
Figure 7: Top-3 hits for the raw query versus the KeyNet-mapped query: 'What is Matchbox Twenty?'
Figure 7: Top-3 hits for the raw query versus the KeyNet-mapped query: 'Who wrote The Eye of the World?'
Figure 7: Top-3 hits for the raw query versus the KeyNet-mapped query: 'What is a wind controller used for?'
Figure 7: Top-3 hits for the raw query versus the KeyNet-mapped query: 'When will the Summertime Ball be on?'
Figure 7: Top-3 hits for the raw query versus the KeyNet-mapped query: 'When was the show Victorious on Nickelodeon?'